

Skya er som en magisk kiste — du spørger, hvad du har brug for, og ressourcerne dukker op fra ingenting. Virtuelle maskiner, databaser, netværk — alt dette tilhører kun dig. Der findes andre cloud-tenanter, men i dit univers er du den enevældige hersker. Du er sikker på, at du altid vil få de krævede ressourcer, du tager ikke hensyn til andre, og du bestemmer selv, hvordan netværket skal være. Hvordan fungerer denne magi, der får skyen til elastisk at tildele ressourcer og fuldstændigt isolere tenantene fra hinanden?
AWS-skyen er et mega-superkomplekst system, der har udviklet sig evolutionært siden 2006. En del af denne udvikling så Vasily Pantiukhin — arkitekt for Amazon Web Services. Som arkitekt ser han ikke kun slutresultatet, men også de udfordringer, AWS overvinder. Jo mere forståelse man har for systemets funktion, jo mere tillid får man. Derfor vil Vasily dele hemmelighederne bag AWS-cloudtjenesterne. Under overskriften kan du læse om opbygningen af de fysiske AWS-servere, elastisk skalerbarhed for databaser, den tilpassede Amazon-database og metoder til at øge ydeevnen for virtuelle maskiner samtidig med, at deres omkostninger reduceres. Kendskab til Amazons arkitekturtilgange vil hjælpe dig med at bruge AWS-tjenesterne mere effektivt og måske give nye idéer til at udvikle dine egne løsninger.
Om oplægsholderen: Vasily Pantyukhin () begyndte som Unix-administrator i .ru-virksomheder, arbejdede 6 år med store maskiner fra Sun Microsystems, og i 11 år prædikede han datacenteret i EMC. Han er naturligt blevet til private skyer, og i 2017 gik han ind i det offentlige. Nu hjælper han med tekniske råd til at leve og udvikle sig i AWS-skyen.
Ansvarsfraskrivelse: alt nedenfor er Vasily's personlige mening, og den kan ikke nødvendigvis være i overensstemmelse med Amazon Web Services' position. af foredraget, på baggrund af hvilket artiklen er skrevet, er tilgængelig på vores YouTube-kanal.
Hvorfor fortæller jeg om Amazon's opbygning
Min første bil havde en "gearspak" — med manuel gearkasse. Det var fantastisk på grund af følelsen af, at jeg kunne styre bilen og have fuld kontrol over den. Jeg kunne også lide, at jeg i det mindste omtrent forstod, hvordan den fungerede. Selvfølgelig forestillede jeg mig konstruktionen af gearkassen ret primitivt — omtrent som gearkassen på en cykel.
Alt var fantastisk, undtagen én ting — at sidde i trafik. Man sidder der og laver ikke noget, men skifter konstant gear, trykker på koblingen, gas, bremse — det gør en rigtig træt. Problemet med trafik blev delvist løst, da vi fik en bil med automatgear. Bag rattet fik jeg tid til at tænke på noget, lytte til lydbøger.
Der opstod også et mysterium i mit liv, fordi jeg helt sluttede med at forstå, hvordan min bil fungerer. Moderne biler er komplekse apparater. Bilen tilpasser sig samtidig til dusinvis af forskellige parametre: gaspåvirkning, bremser, kørestil, vejens kvalitet. Jeg forstår ikke længere, hvordan det virker.
Da jeg begyndte at arbejde med Amazon Cloud, var det også et mysterium for mig. Men dette mysterium er på et højere plan, fordi der i bilen er én chauffør, mens der i AWS er millioner. Alle brugere styrer samtidig, trykker på gas og bremse. Det er fantastisk, at de kører det sted, de ønsker — for mig er det en mirakel! Systemet tilpasser sig automatisk, skaleres og er elastisk tilpasset hver bruger, så de føler, de er den eneste i dette univers.
Magien blev lidt opløst, da jeg senere kom til at arbejde som arkitekt hos Amazon. Jeg så de problemer, vi står overfor, hvordan vi løser dem, og hvordan vi udvikler tjenester. Med en større forståelse af systemets arbejde kommer der mere tillid til servicen. Derfor vil jeg dele billedet af, hvad der er under motorhjelmen i AWS skyen.
Hvad skal vi tale om
Jeg valgte en diversificeret tilgang — udvalgt 4 interessante tjenester, som det er værd at tale om.
Serveroptimering. Ephemerale skyder med fysisk manifestation: fysiske datacentre, hvor fysiske servere står, som brummer, bliver varme og blinker med lys.
Serverless-funktioner (Lambda) — sandsynligvis den mest skalerbare service i skyen.
Skalering af databaser. Jeg vil fortælle, hvordan vi bygger vores egne skalerbare databaser.
Netværksskaleringsløsninger. Den sidste del, hvor jeg åbner op for vores netværk. Det er en vidunderlig ting — hver skybruger mener, at de er alene i skyen og slet ikke ser andre lejere.
Bemærkning. Denne artikel vil fokusere på optimering af servere og skalering af databaser. Skalering af netværk vil blive behandlet i næste artikel. Hvor befinder serverless-funktionerne sig? Der er blevet udgivet en separat uddybning om dem.I denne artikel tales der om flere forskellige måder at skalere på, og løsningen Firecracker bliver nøjere gennemgået — en symbiose af de bedste kvaliteter fra virtuelle maskiner og containere.
Servere
Skyen er efemær. Men denne efemærhed har trods alt en fysisk repræsentation — serverne. Oprindeligt var deres arkitektur klassisk. Standard x86 chipset, netværkskort, Linux, hypervisor Xen, hvorpå de virtuelle maskiner blev drevet.
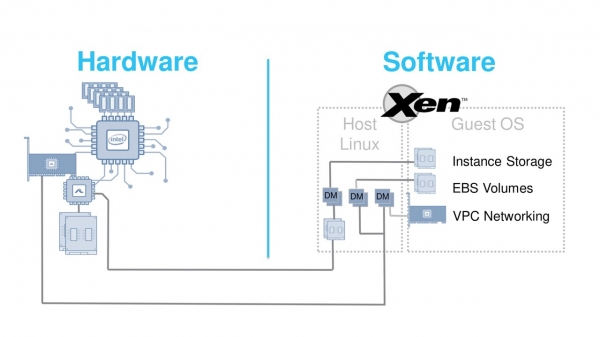
I 2012 kunne denne arkitektur helt sikkert klare sine opgaver. Xen er en fremragende hypervisor, men den har en alvorlig ulempe. Den har ret høje overheadomkostninger til emulering af enheder.Når der kom nye, hurtigere netværkskort eller SSD-diske, blev disse overheadomkostninger alt for høje. Hvordan kan man løse dette problem? Vi besluttede os for at arbejde på to fronter — både optimere hardwaren og hypervisoren.Opgaven er meget seriøs.
Optimering af hardware og hypervisor.
Det vil ikke være muligt at gøre alt godt på én gang. Hvad der mener 'godt', var oprindeligt ikke klart.
Vi besluttede os for at anvende en evolutionær tilgang — ændre et vigtigt element af arkitekturen og implementere det i produktion.
Vi træder på alle mulige skjulte problemer og lytter til klager og forslag. Derefter ændrer vi en anden komponent. På denne måde, i små inkrementer, ændrer vi hele arkitekturen radikalt baseret på feedback fra brugerne og supporten.
Transformationerne begyndte i 2013 med det mest komplekse — netværket. I C3 instanserne tilføjede vi et særligt kort Network Accelerator ud over det standard netværkskort. Det blev tilsluttet med et kort loopback-kabel på den forreste panel. Ikke kønt, men det er usynligt i skyen. Men den direkte interaktion med hardwaren forbedrede principielt jitter og netværksbåndbredde.
Dernæst besluttede vi at forbedre adgangen til EBS — Elastic Block Storage. Dette er en kombination af netværk og lager. Udfordringen er, at mens der på markedet fandtes Network Accelerator-kort, fandtes der slet ikke mulighed for at købe hardware til Storage Accelerator. Derfor henvendte vi os til startupen Annapurna Labs, som har udviklet specielle ASIC-chips til os. De gjorde det muligt at tilslutte fjerntliggende EBS-volumener som NVMe-enheder.
I instanserne C4 løste vi to opgaver. Den første var at skabe et grundlag for fremtidens lovende, men på det tidspunkt nye NVMe-teknologi. Den anden var at aflaste centralprocessoren betydeligt ved at overføre behandlingen af anmodninger til EBS til det nye kort. Det blev en succes, så nu er Annapurna Labs en del af Amazon.
I november 2017 indså vi, at det var tid til at ændre selve hypervisoren.
Den nye hypervisor blev udviklet på baggrund af modificerede KVM-kernemoduler.
Den gjorde det muligt væsentligt at reducere overheaden ved enhedsemmulering og arbejde direkte med de nye ASICs. Instanserne C5 var de første virtuelle maskiner, hvor den nye hypervisor kørte under overfladen. Vi kaldte den Nitro.
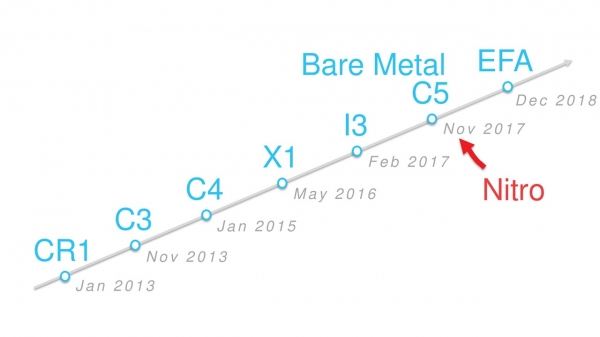 Evolutionen af instanser på en tidslinje.
Alle nye typer virtuelle maskiner, der er opstået siden november 2017, kører på denne hypervisor. Bare Metal-instanserne har ikke en hypervisor, men de kaldes også Nitro, da de bruger specialiserede Nitro-kort.
I løbet af de næste to år oversteg antallet af Nitro-instanstyper flere dusin: A1, C5, M5, T3 og andre.
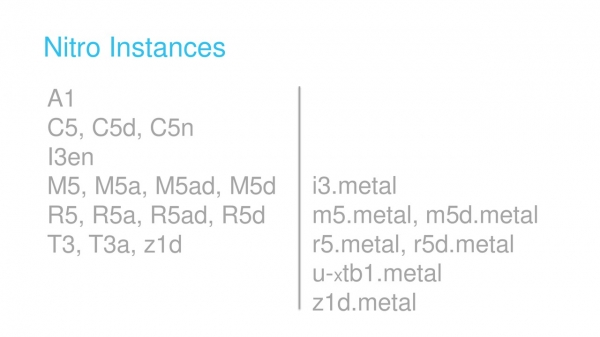
Typer af instanser.
Hvordan moderne Nitro-maskiner er opbygget
De har tre hovedkomponenter: Nitro-hypervisoren (som nævnt før), sikkerhedsbrikken og Nitro-kortene.
Sikkerhedsbrikken er integreret direkte i bundkortet. Den overvåger mange vigtige funktioner, såsom kontrol af opstart af værtens operativsystem.
Nitro-kortene — der findes fire typer. Alle er designet af Annapurna Labs og baseres på fælles ASICs. En del af deres firmware er også fælles.
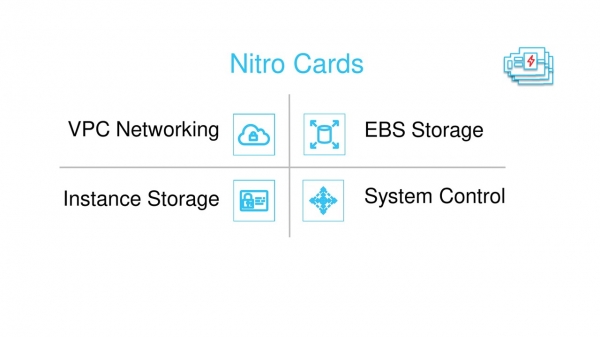
Fire typer Nitro-kort.
Et af kortene er beregnet til at arbejde med netværketVPC. Det er det, der vises i de virtuelle maskiner som et netværkskort ENA — Elastic Network Adaptor. Det kapsler også trafik, når det overføres gennem det fysiske netværk (mere om dette i den anden del af artiklen), overvåger Security Groups-firewallen, har ansvar for routing og andre netværksfunktioner.
Separat kort arbejder med bloklageret EBS og diskene, der er indbygget i serveren. De præsenteres for den gæstende virtuelle maskine som NVMe-adaptere. De har også ansvaret for datakryptering og overvågning af diskene.
Systemet af Nitro-kort, hypervisoren og sikkerhedsbrikken er forbundet i et SDN-netværk eller Software Defined Network. Kontrol af dette netværk (Control Plane) ledes af kontrolkort.
Selvfølgelig fortsætter vi med at udvikle nye ASIC. For eksempel, i slutningen af 2018 udgav vi Inferentia-chippen, som muliggør mere effektivt arbejde med maskinlæringsopgaver.
Inferentia Maskinlæringsprocessor.
Skalerbar database
En traditionel database har en lagdelt struktur. Hvis man forenkler det, kan man skelne mellem følgende niveauer.
- SQL — hvor klient- og forespørgselsbehandlere arbejder.
- Sikring af transaktioner — her er alt klart, ACID og alt det dér.
- Caching, som sikres af bufferpuljer.
- Logføring — sikrer arbejdet med redo-logs. I MySQL kaldes de Bin Logs, i PosgreSQL — Write Ahead Logs (WAL).
- Lagring – direkte nedskrivning på disk.
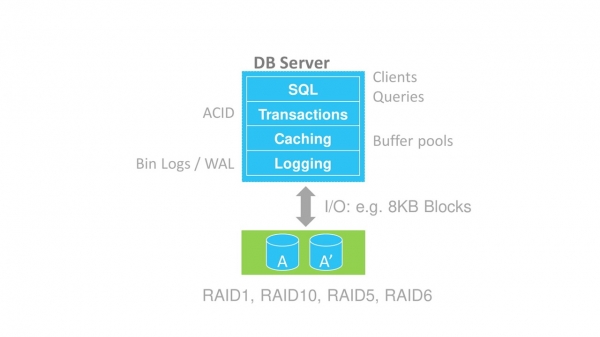
Lagdelt struktur af databasen.
Der er forskellige måder at skalere databaser på: sharding, Shared Nothing-arkitektur, delte diske.
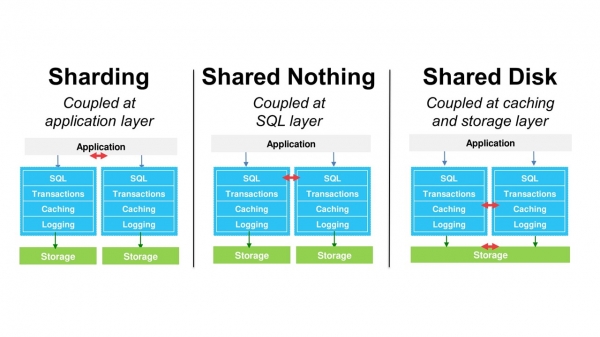
Men alle disse metoder bevarer den samme monolitiske database-struktur. Dette begrænser mærkbart skaleringen. For at løse dette problem har vi udviklet vores egen DB — Amazon Aurora. Den er kompatibel med MySQL og PostgreSQL.
Amazon Aurora
Den grundlæggende arkitektoniske idé er at skille lagene for opbevaring og logning fra den primære database.
For at komme i forkøbet vil jeg sige, at vi også gjorde cache-niveauet uafhængigt. Arkitekturen stopper med at være et monolit, og vi får yderligere frihedsgrader i skaleringen af enkle blokke.
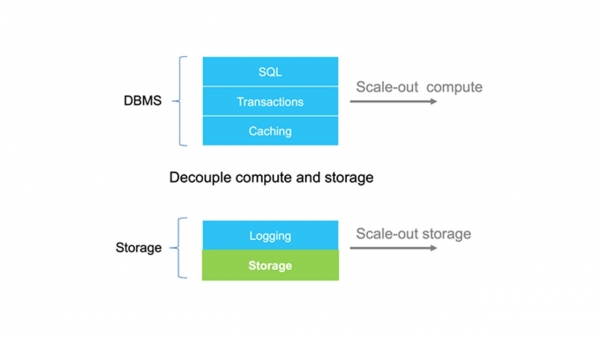
Lognings- og lagerlagene er adskilt fra databasen.
En traditionel DBMS skriver data til lagringssystemet i form af blokke. I Amazon Aurora har vi skabt en "smart" opbevaring, der kan kommunikere på sprog redo-logs. Inden i sig konverterer lageret logs til datablokke, overvåger deres integritet og laver automatisk backup.
Denne tilgang muliggør spændende funktioner som kloning. Det fungerer principielt hurtigere og mere økonomisk, da det ikke kræver oprettelse af en fuld kopi af alle data.
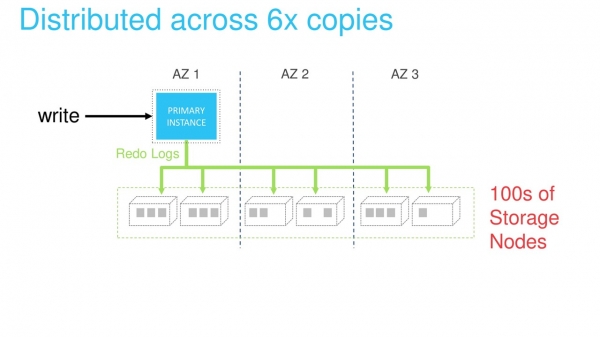
Lagerlaget er implementeret som et distribueret system. Det består af et meget stort antal fysiske servere. Hver redo-log behandles og gemmes samtidig af seks noder. Dette sikrer databeskyttelse og fordeling af belastningen.
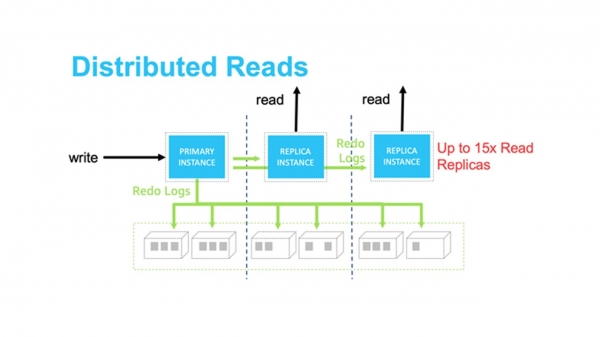
Læsningsskaleringsmuligheder kan sikres ved hjælp af de rette replikater. Det distribuerede lager eliminerer behovet for synkronisering mellem den primære databaseinstans, hvor vi skriver data, og de øvrige replikater. Aktuelle data er garanteret tilgængelige for alle replikater.
Det eneste problem er caching af gamle data på læsereplikaterne. Men denne udfordring løses ved at overføre alle redo-logfiler til replikaterne via det interne netværk. Hvis loggen er i cachen, markeres den som ugyldig og overskrives. Hvis den ikke er i cachen, bliver den blot forkastet.
Vi har styr på lageret.
Hvordan man skalerer niveauerne af DBMS
Her er det meget sværere at foretage horisontal skalering. Derfor tager vi den afprøvede vej til klassisk vertikal skalering..
Lad os antage, at vi har en applikation, der kommunikerer med DBMS via master-noden.
Ved vertikal skalering tildeler vi en ny node, der vil have flere processorer og mere hukommelse.
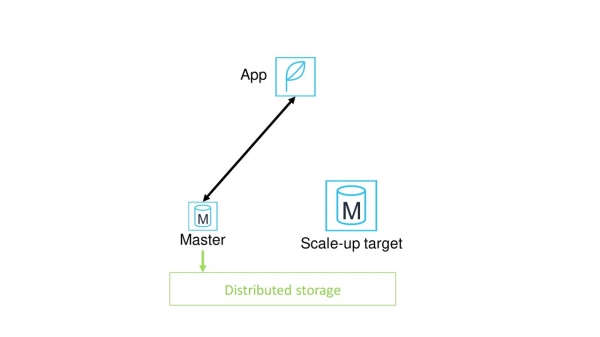
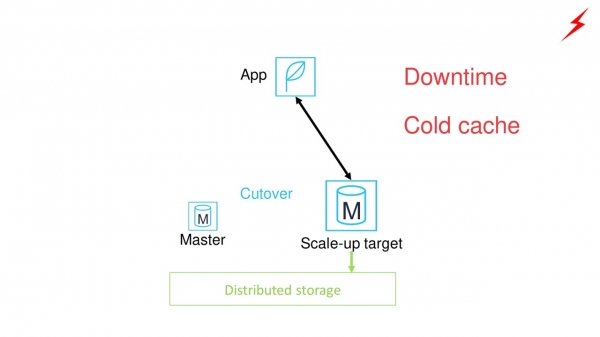
Derefter skifter vi applikationen fra den gamle master-node til den nye. Der opstår problemer.
- Dette vil kræve betydelig nedetid for applikationen.
- Den nye master-node vil have en kold cache. Databaseydelsen vil være maksimal først efter opvarmning af cachen.
Hvordan kan vi forbedre situationen? Ved at placere en proxy mellem applikationen og master-noden.
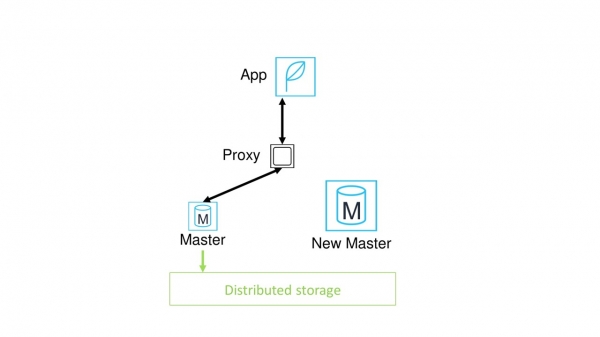
Hvad giver os det? Nu er det ikke nødvendigt manuelt at omdirigere alle applikationer til den nye node. Skiftet kan foretages under proxyen og er dermed principielt hurtigere.
Det ser ud til, at problemet er løst. Men nej, vi lider stadig af behovet for opvarmning af cachen. Desuden er der opstået et nyt problem — nu er proxyen et potentielt fejlpunk.
Den endelige løsning med Amazon Aurora serverless
Hvordan løste vi disse problemer?
Vi beholdt proxyen.Det er ikke en separat instans, men en hel distribueret flåde af proxyer, gennem hvilke applikationerne tilsluttes til databasen. Enhver af noderne kan næsten øjeblikkeligt erstattes, hvis den fejler.
Vi tilføjede et pulje af varme noder i forskellige størrelser.Derfor, ved behov for at tildele en ny node af større eller mindre størrelse, er den straks tilgængelig. Der er ikke brug for at vente på, at den indlæses.
Hele skaleringsprocessen styres af et specialiseret overvågningssystem. Overvågningen holder konstant øje med tilstanden af den aktuelle master-node. Hvis den for eksempel opdager, at belastningen på processoren har nået et kritisk niveau, informerer den puljen af varme instanser om behovet for at alloere en ny node.
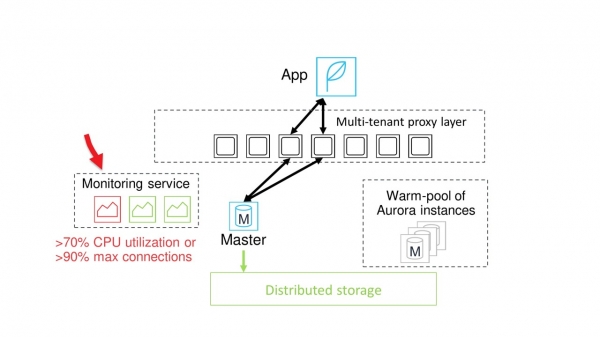
Fordelte proxyer, varme instanser og overvågning.
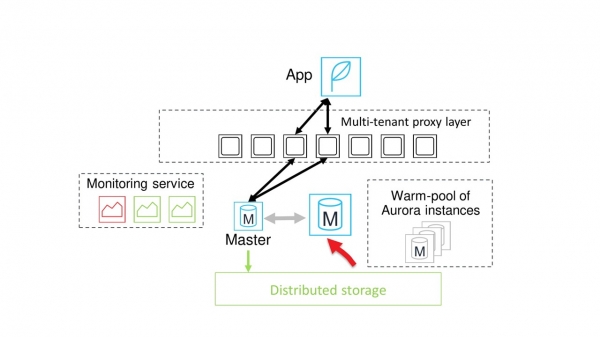
En node med den nødvendige kapacitet er tilgængelig. Bufferpuljer kopieres til den, og systemet begynder at vente på et sikkert tidspunkt til at skifte.
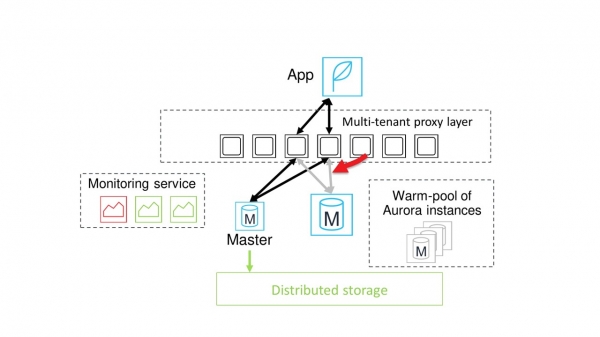
Som regel indtræffer tidspunktet for skiftet hurtigt. Kommunikation mellem proxyen og den gamle master-node pauses, og alle sessioner flyttes til den nye node.
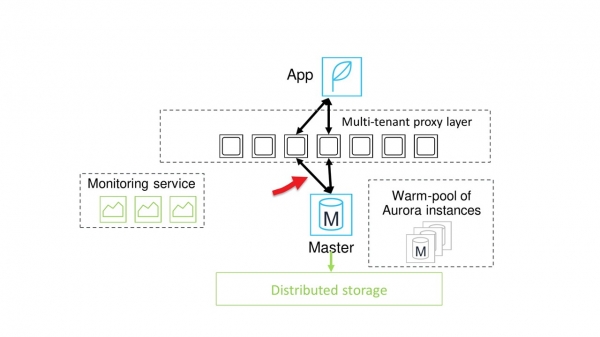
Arbejdet med databasen genoptages.
Grafen viser, at pausen faktisk er meget kort. Den blå graf viser belastningen, mens de røde trapper markerer skiftetidspunkterne. De kortvarige fald i den blå graf er netop den korte forsinkelse.
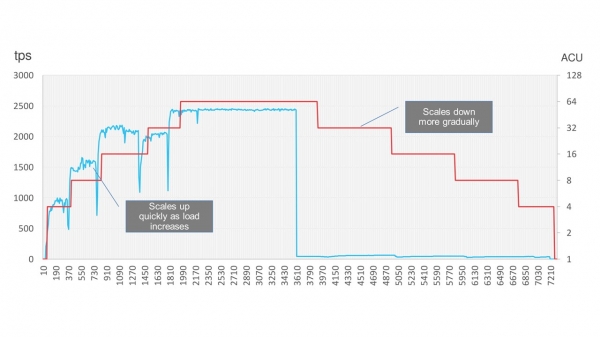
For øvrigt giver Amazon Aurora mulighed for at spare penge ved at slukke for databasen, når den ikke er i brug, for eksempel i weekenden. Efter at have reduceret belastningen, falder databasen gradvist i kapacitet og slukkes i en periode. Når belastningen vender tilbage, stiger den langsomt igen.
I den næste del af fortællingen om Amazons opsætning vil vi tale om netværksskalerbarhed. Tilmeld dig og hold dig opdateret, så du ikke går glip af artiklen.
På Vasiliy Pantyukhin vil holde et foredrag om "" Hvilke designmønstre for fordelte systemer bruger Amazon-udviklere, hvilke årsager kan føre til fejlsystemer, hvad er Cell-based architecture, Constant Work, Shuffle Sharding — det bliver spændende. Der er under en måned til konferencen — . Priserne stiger den 24. oktober.
Kilde: habr.com
