

I denne artikel vil vi gennemgå de teoretiske overvejelser om transformation af funktionen for lineær regression i den inverse logit-transformation (eller logistikresponsfunktionen). Derefter, ved at udnytte arsenal af maksimale sandsynlighedsmetode, i overensstemmelse med logistikregressionsmodellen, vil vi udlede tabsfunktionen Logistic Loss, eller med andre ord, vi vil definere en funktion, der bruges til at justere parametrene for vægtvektoren i logistikregressionmodellen  .
Artikelens plan:
- Vi gentager den lineære afhængighed mellem to variable
- Vi fremhæver behovet for transformation af funktionen for lineær regression
 i af logistikresponsfunktionen
- Vi udfører transformationer og udleder af logistikresponsfunktionen
- Vi prøver at forstå, hvad der er galt med mindste kvadraters metode ved parameterjustering funktioner Logistic Loss
- Vi bruger maksimale sandsynlighedsmetode til at bestemme parametervalgfunktionen :
5.1. Case 1: funktionen Logistic Loss for objekter med klassebetegnelser 0 og 1:
5.2. Case 2: funktionen Logistic Loss for objekter med klassebetegnelser -1 og +1:
 i af logistikresponsfunktionen

 funktioner Logistic Loss
 :


Artiklen er fyldt med enkle eksempler, hvor alle beregninger nemt kan udføres mundtligt eller på papir, og i nogle tilfælde kan en regner være nødvendig. Så vær forberedt 🙂
Denne artikel er primært rettet mod datascientister med grundlæggende kendskab til maskinlæring.
Artiklen vil også indeholde kode til at tegne grafer og udføre beregninger. Al koden er skrevet i python 2.7. Jeg vil på forhånd forklare "nyheden" i den anvendte version — det er en af betingelserne for at gennemføre det berømte kursus fra Yandex på den lige så berømte internetplatform for online uddannelse Coursera, og som man kunne forvente, er materialet udarbejdet med inspiration fra dette kursus.
01. Lineær afhængighed
Det er helt rimeligt at stille spørgsmålet — hvad har lineær afhængighed at gøre med logistikregression?
Det er enkelt! Logistikregression er en af modellerne, der hører til den lineære klassifikator. Kort sagt, opgaven for den lineære klassifikator er at forudsige målrettede værdier  fra variablerne (regressorer)
 . Her antages det, at der er en afhængighed mellem funktionerne
 og de målrettede værdier
 lineær. Heraf kommer navnet på klassifikatoren — lineær. Hvis man meget groft skal generalisere, hviler modellen for logistisk regression på antagelsen om en lineær afhængighed mellem funktionerne.
 og de målrettede værdier
 Her er forbindelse.
I studiet er det første eksempel, og korrekt nok handler det om den direkte afhængighed af de undersøgte størrelser. Under forberedelsen af artiklen stødte jeg på et eksempel, der allerede er kendt af mange — afhængigheden af strømstyrken fra spændingen. («Praktisk regressionsanalyse», N. Draper, G. Smith). Her vil vi også se på det.
I henhold til Ohms lov:
 , hvor
 — strømstyrke,
 — spænding,
 — modstand.
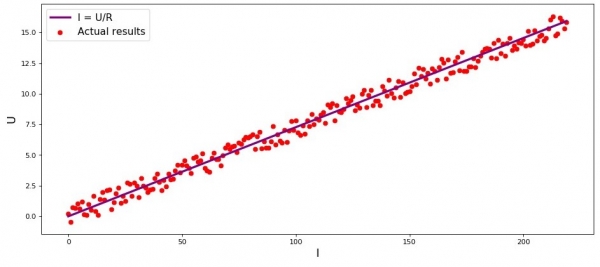
Hvis vi ikke vidste Ohms lov, kunne vi finde afhængigheden empirisk ved at ændre  og måle
 , mens vi holder
 fast. Så ville vi se, at grafen for afhængigheden
 fra
 giver en mere eller mindre lige linje, der går gennem origo. Vi sagde "mere eller mindre", da selvom afhængigheden faktisk er præcis, kan vores målinger indeholde små fejl, og derfor kan punkterne på grafen muligvis ikke lande præcist på linjen, men vil være spredt omkring den tilfældigt.
Graf 1 "Afhængighed  fra
 »
Kode til at tegne grafen
import matplotlib.pyplot as plt
%matplotlib inline

import numpy as np

import random

R = 13.75

x_line = np.arange(0,220,1)
y_line = []
for i in x_line:
    y_line.append(i/R)

y_dot = []
for i in y_line:
    y_dot.append(i + random.uniform(-0.9,0.9))


fig, axes = plt.subplots(figsize = (14,6), dpi = 80)
plt.plot(x_line, y_line, color = 'purple', lw = 3, label = 'I = U/R')
plt.scatter(x_line, y_dot, color = 'red', label = 'Faktiske resultater')
plt.xlabel('I', size = 16)
plt.ylabel('U', size = 16)
plt.legend(prop = {'size': 14})
plt.show()
02. Behovet for transformationer af den lineære regression
Lad os overveje endnu et eksempel. Forestil dig, at vi arbejder i en bank og står over for opgaven at bestemme sandsynligheden for, at en låntager tilbagebetaler et lån afhængigt af nogle faktorer. For at forenkle opgaven vil vi kun se på to faktorer: låntagers månedlige løn og månedlig betaling på lånet.
Opgaven er meget hypotetisk, men med dette eksempel kan vi forstå, hvorfor det ikke er tilstrækkeligt at anvende af funktionen for lineær regression, og også finde ud af, hvilke transformationer der kræves af funktionen.
Lad os vende tilbage til eksemplet. Det er klart, at jo højere lønnen er, desto mere kan låntageren månedligt afsætte til tilbagebetaling af lånet. For et bestemt løninterval vil denne afhængighed være ret linear. Lad os eksempelvis tage et løninterval fra 60.000 DKK til 200.000 DKK og antage, at i det angivne løninterval er afhængigheden mellem størrelsen af den månedlige betaling og størrelsen af lønnen – linear. Lad os antage, at det er blevet konstateret, at forholdet mellem løn og betaling ikke kan falde under 3, og at låntageren også skal have 5.000 DKK tilbage. Kun under disse omstændigheder vil vi betragte, at låntageren vil tilbagebetale lånet til banken. Så vil ligningen for den lineære regression tage form:

hvor  ,
 ,
 ,
 — lønnen
 for den
 — månedlige betaling
 for låntageren.
Ved at indsætte lønnen og den månedlige betaling med faste parametre  kan man træffe beslutning om godkendelse eller afslag på lånet.
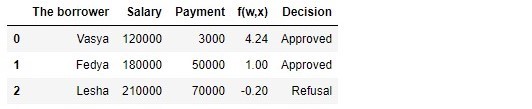
For at komme foran, kan vi bemærke, at under de givne parametre  den lineære regressionsfunktion, der anvendes i logistisk regressionsfunktion vil give høje værdier, som vil besværliggøre beregningerne af sandsynlighederne for tilbagebetaling af lånet. Derudover foreslås det at reducere vores koefficienter med 25.000 gange. Denne ændring af koefficienterne vil ikke ændre beslutningen om at give lånet. Lad os huske dette punkt til fremtiden, og nu for at gøre det endnu klarere, lad os se på situationen med tre potentielle låntagere.
Tabel 1 „Potentielle låntagere“
Kode til at oprette tabellen
import pandas as pd

r = 25000.0
w_0 = -5000.0/r
w_1 = 1.0/r
w_2 = -3.0/r

data = {'Låntageren':np.array(['Vasya', 'Fedya', 'Lesha']),
        'Løn':np.array([120000,180000,210000]),
       'Betaling':np.array([3000,50000,70000])}

df = pd.DataFrame(data)

df['f(w,x)'] = w_0 + df['Løn']*w_1 + df['Betaling']*w_2

decision = []
for i in df['f(w,x)']:
    if i > 0:
        dec = 'Godkendt'
        decision.append(dec)
    else:
        dec = 'Afslag'
        decision.append(dec)

df['Beslutning'] = decision

df[['Låntageren', 'Løn', 'Betaling', 'f(w,x)', 'Beslutning']]
I henhold til dataene i tabellen ønsker Vasya, der har en løn på 120.000 DKK, at få et lån, så han kan betale det tilbage med 3.000 DKK om måneden. Vi har fastslået, at for at lånet kan godkendes, skal Vasya have en løn, der overstiger tre gange størrelsen af betalingen, og der skal være 5.000 DKK tilbage. Dette krav opfylder Vasya:  . Der er stadig 106.000 R. På trods af at vi har reduceret koefficienterne
 med 25.000 gange, fik vi samme resultat — lånet kan godkendes. Fedya vil også få et lån, men Lesha, på trods af at han tjener mest, må nøjes med sine ønsker.
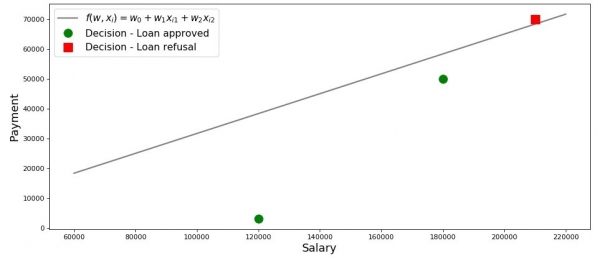
 Lad os tegne en graf i dette tilfælde.
Graf 2 «Klassificering af låntagere»
Kode til at tegne grafen
salary = np.arange(60000,240000,20000) payment = (-w_0-w_1*salary)/w_2fig, axes = plt.subplots(figsize = (14,6), dpi = 80) plt.plot(salary, payment, color = 'grey', lw = 2, label = '$f(w,x_i)=w_0 + w_1x_{i1} + w_2x_{i2}$') plt.plot(df[df['Decision'] == 'Approved']['Salary'], df[df['Decision'] == 'Approved']['Payment'], 'o', color ='green', markersize = 12, label = 'Decision - Lån godkendt') plt.plot(df[df['Decision'] == 'Refusal']['Salary'], df[df['Decision'] == 'Refusal']['Payment'], 's', color = 'red', markersize = 12, label = 'Decision - Lån afvist') plt.xlabel('Løn', size = 16) plt.ylabel('Betaling', size = 16) plt.legend(prop = {'size': 14}) plt.show()
Så vores linje, bygget i henhold til funktionen, adskiller de "dårlige" låntagere fra de "gode". De låntagere, hvis ønsker ikke stemmer overens med mulighederne, ligger over linjen (Lesha), mens dem, der kan tilbagebetale lånet ifølge vores models parametre, ligger under linjen (Vasya og Fedya). Man kunne sige det sådan — vores linje adskiller låntagere i to klasser. Lad os betegne dem som følger: til klassen  henfører vi de låntagere, der sandsynligvis vil tilbagebetale lånet, til klassen
 henfører vi de låntagere, der sandsynligvis ikke vil kunne tilbagebetale lånet.
 eller
 Lad os opsummere konklusionerne fra dette enkle eksempel. Lad os tage punktet
og, ved at indsætte koordinaterne i den relevante ligning for linjen  , overveje tre muligheder:
 Hvis punktet ligger under linjen, og vi henfører det til klassen
- , så vil funktionsværdien være positiv fra . Det betyder, at vi kan anse sandsynligheden for tilbagebetaling af lånet, ligger inden for op til . Jo større funktionsværdien er, desto højere er sandsynligheden. Hvis punktet ligger over linjen, og vi henfører det til klassen
- , så vil funktionsværdien være negativ fra eller . Så vil vi anse, at sandsynligheden for tilbagebetaling af gælden ligger inden for op til og, jo større i modulus funktionsværdien er, desto større er vores sikkerhed. Punktet ligger på linjen, på grænsen mellem de to klasser. I så fald vil funktionsværdien være
- lig med og sandsynligheden for tilbagebetaling af lånet er lig med Nu forestil dig, at vi ikke har to faktorer, men titusinder, låntagerne ikke er tre, men tusinder. Så i stedet for en linje vil vi have .
 være positiv fra
 . Det betyder, at vi kan anse sandsynligheden for tilbagebetaling af lånet, ligger inden for
 op til
 . Jo større funktionsværdien er, desto højere er sandsynligheden.
 Hvis punktet ligger over linjen, og vi henfører det til klassen
 eller
 . Så vil vi anse, at sandsynligheden for tilbagebetaling af gælden ligger inden for
 op til
 og, jo større i modulus funktionsværdien er, desto større er vores sikkerhed.
 Punktet ligger på linjen, på grænsen mellem de to klasser. I så fald vil funktionsværdien være
 og sandsynligheden for tilbagebetaling af lånet er lig med
 Nu forestil dig, at vi ikke har to faktorer, men titusinder, låntagerne ikke er tre, men tusinder. Så i stedet for en linje vil vi have
 .
Lad os nu forestille os, at vi ikke har to faktorer, men dusinvis, og ikke tre låntagere, men tusindvis. Så i stedet for at have en direkte relation, vil vi have m-måling plan og koefficienter  vi vil ikke tage dem fra loftet, men udlede dem i henhold til alle regler baseret på de indsamlede oplysninger om låntagere, der har tilbagebetalt eller ikke har tilbagebetalt lån. Og bemærk, vi vælger nu låntagere med allerede kendte koefficienter.
 Faktisk består opgaven for den logistiske regressionsmodel netop i at bestemme de parametre
 , hvor værdien af tabningsfunktionen Logistic Loss vil stræbe efter det minimale. Men hvordan vektoren
 , beregnes, finder vi ud af i 5. afsnit af artiklen. Men nu vender vi tilbage til det lovede land — til vores banker og hans tre kunder.
Takket være funktionen  ved vi, hvem vi kan give kredit, og hvem vi skal afslå. Men med sådanne oplysninger kan vi ikke gå til direktøren, da vi ønskede at få sandsynligheden for tilbagebetaling af kredit fra hver låntager. Hvad skal vi gøre? Svaret er enkelt — vi skal på en eller anden måde transformere funktionen
 , hvis værdier ligger i intervallet
 til en funktion, hvis værdier vil ligge i intervallet
 . Og en sådan funktion eksisterer, den kaldes logistic response function eller inverse-logit transformation. Mød:

Lad os se skridtene, hvordan logistic response function opnås. Bemærk, at vi vil bevæge os i den modsatte retning, dvs. vi antager, at vi kender sandsynlighedens værdi, som ligger inden for strækningen fraog derefter vil vi "afvikle" denne værdi på hele området af tal fra  op til
 03. Vi viser den logistiske responsfunktion
 op til
 .
Trin 1. Vi vil omdanne sandsynlighedsværdier til intervallet
Under transformationen af funktionen

vil vi lade vores kreditanalytiker være i fred og i stedet gå til bookmakere. Nej, vi vil selvfølgelig ikke placere væddemål, alt hvad vi er interesseret i der, er betydningen af udtrykket, for eksempel odds 4 til 1. Odds, som alle spillere, der placerer væddemål, kender, er forholdet mellem "succeser" og "fejl". Set fra sandsynligheders synspunkt er odds sandsynligheden for, at en hændelse indtræffer, divideret med sandsynligheden for, at hændelsen ikke indtræffer. Lad os skrive formlen for sandsynligheden for, at hændelsen indtræffer  i af logistikresponsfunktionen
 — sandsynligheden for, at hændelsen indtræffer,
 :

, hvor  — sandsynligheden for, at hændelsen IKKE indtræffer.
 — sandsynligheden for, at hændelsen IKKE indtræffer
For example, if the probability that a young, strong, and agile horse nicknamed "Breeze" will beat an old and frail mare named "Matilda" in a race equals  , then the chances of "Breeze" succeeding will be
 pull-requesten på GitHub

 and conversely, knowing the odds, it will not be difficult for us to calculate the probability
 :

Thus, we have learned to "translate" probability into odds, which can take values from  op til
 . Let's take one more step and learn to "translate" probability along the entire number line from
 op til
 .
Step 2. We will convert probability values into a range

This step is very simple — we will take the logarithm of the odds base Euler's number  and we get:

Now we know that if  , then calculating the value of
 will be very simple and, moreover, it should be positive:
 . Indeed.
Out of curiosity, let's check that if  , then we expect to see a negative value
 . Checking:
 . That's correct.
Now we know how to translate the probability value from  op til
 to the entire number line from
 op til
 . In the next step, we will do everything in reverse.
For now, let's note that according to the rules of logarithms, knowing the value of the function  , we can calculate the odds:

This method for determining odds will be useful in the next step.
Step 3. We will derive a formula for determining

So, we have learned, knowing  , to find the values of the function
 . However, what we actually need is to do everything in reverse — knowing the value
 to find
 . For this purpose, we will refer to the concept of the inverse function of odds, according to which:

In the article, we will not derive the above-mentioned formula, but we will check with the numbers from the example above. We know that with odds of 4 to 1 ( ), the probability of the event occurring is 0.8 (
 ). Let's make the substitution:
 . This matches our earlier calculations. Let's move on.
In the previous step, we derived that  , so one can make a substitution in the inverse function of odds. We get:

Let's divide both the numerator and the denominator by  , then:

Just in case, to make sure we haven't made any mistakes, let's do one more small check. In step 2, we found that  . Then, substituting the value
 into the logistic response function, we expect to obtain
 . We substitute and get:
 .

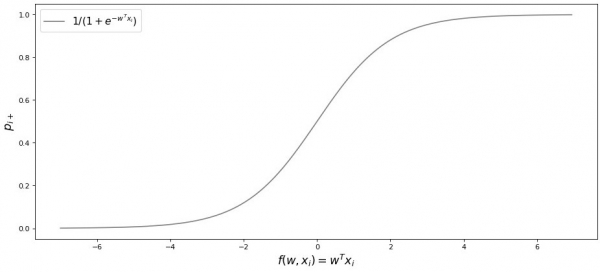
Tillykke, kære læser, vi har netop udviklet og testet logit-funktionen. Lad os se på grafen for funktionen.
Graf 3 «Logit-funktion»
salary = np.arange(60000,240000,20000) payment = (-w_0-w_1*salary)/w_2fig, axes = plt.subplots(figsize = (14,6), dpi = 80) plt.plot(salary, payment, color = 'grey', lw = 2, label = '$f(w,x_i)=w_0 + w_1x_{i1} + w_2x_{i2}$') plt.plot(df[df['Decision'] == 'Approved']['Salary'], df[df['Decision'] == 'Approved']['Payment'], 'o', color ='green', markersize = 12, label = 'Decision - Lån godkendt') plt.plot(df[df['Decision'] == 'Refusal']['Salary'], df[df['Decision'] == 'Refusal']['Payment'], 's', color = 'red', markersize = 12, label = 'Decision - Lån afvist') plt.xlabel('Løn', size = 16) plt.ylabel('Betaling', size = 16) plt.legend(prop = {'size': 14}) plt.show()
import math

def logit(f):
    return 1/(1+math.exp(-f))

f = np.arange(-7,7,0.05)
p = []

for i in f:
    p.append(logit(i))

fig, axes = plt.subplots(figsize=(14,6), dpi=80)
plt.plot(f, p, color='grey', label='$ 1 / (1+e^{-w^Tx_i})$')
plt.xlabel('$f(w,x_i) = w^Tx_i$', size=16)
plt.ylabel('$p_{i+}$', size=16)
plt.legend(prop={'size': 14})
plt.show()
I litteraturen kan denne funktion også mødes under navnet sigmoidfunktion. Det fremgår tydeligt af grafen, at den væsentlige ændring i sandsynligheden for klassetilhørsforhold sker over et relativt snævert interval  , fra cirka
 op til
 .
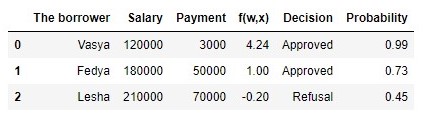
Lad os vende tilbage til vores kreditanalytiker og hjælpe ham med at beregne sandsynligheden for tilbagebetaling af lån, ellers risikerer han at miste sin bonus 🙂
Tabel 2 «Potentielle låntagere»
Kode til at oprette tabellen
proba = []
for i in df['f(w,x)']:
    proba.append(round(logit(i), 2))

df['Sandsynlighed'] = proba

df[['Låntager', 'Løn', 'Betaling', 'f(w,x)', 'Beslutning', 'Sandsynlighed']]
Så, vi har bestemt sandsynligheden for tilbagebetaling af lånet. Generelt ser det ud til at være sandt.
Faktisk er sandsynligheden for, at Vasja kan betale 3.000 kr. til banken hver måned med en løn på 120.000 kr., tæt på 100%. For øvrigt skal vi forstå, at banken kan yde lån til Løja, hvis bankens politik foreskriver at kreditere kunder med en sandsynlighed for tilbagebetaling højere end, lad os sige, 0.3. I så fald ville banken tage højde for større reserver til mulige tab.
Det skal også bemærkes, at forholdet mellem løn og betaling på mindst 3 og med en margin på 5.000 kr. blev taget uden videre. Derfor kunne vi ikke bruge vægtvektoren i sin oprindelige form.  . Vi skal markant reducere koefficienterne, og i så fald delte vi hver koefficient med 25.000, så vi i princippet justerede resultatet. Men dette blev gjort specifikt for at lette forståelsen af materialet i de tidlige faser. I virkeligheden skal vi ikke finde på eller justere koefficienter, men finde dem. I de følgende afsnit af artiklen vil vi udlede ligninger, der bruges til at bestemme parametrene.
 .
04. Metoden med mindste kvadrater til bestemmelse af vægtvektoren i logit-funktionen
 i logit-funktionen
Vi kender allerede en sådan metode til bestemmelse af vægtvektoren  , som metoden med mindste kvadrater (MMK) Og faktisk, hvorfor skulle vi så ikke bruge det i opgaver med binær klassifikation? Faktisk er der intet, der forhindrer os i at bruge det. MNK, men denne metode giver mindre præcise resultater i klassifikationsopgaver end Logistic Loss. Der er en teoretisk begrundelse for dette. Lad os først se på et simpelt eksempel.
Lad os antage, at vores modeller (der bruger MSE og Logistic Loss) allerede er begyndt at justere vægtvektoren.  Og vi stoppede beregningen på et bestemt trin. Det er ligegyldigt, om det er i midten, i slutningen eller i begyndelsen. Det vigtigste er, at vi allerede har nogle værdier af vægtvektoren, og lad os antage, at på dette trin er vægtvektorerne
 for begge modeller ens. Så tager vi de opnåede vægte og indsætter dem i af logistikresponsfunktionen (
 ) for en hvilken som helst objekt, som tilhører klassen
 . Vi undersøger to tilfælde, når vores model i henhold til den justerede vægtvektor laver en stor fejl og omvendt — modellen er meget sikker på, at objektet tilhører klassen
 . Lad os se, hvilke bøder der vil blive "udskrevet" ved brug af MNK og Logistic Loss.
Kode til beregning af bøder afhængigt af den anvendte tabsfunktion.
# класс объекта
y = 1
# вероятность отнесения объекта к классу в соответствии с параметрами w
proba_1 = 0.01

MSE_1 = (y - proba_1)**2
print 'Штраф MSE при грубой ошибке =', MSE_1

# напишем функцию для вычисления f(w,x) при известной вероятности отнесения объекта к классу +1 (f(w,x)=ln(odds+))
def f_w_x(proba):
    return math.log(proba/(1-proba))

LogLoss_1 = math.log(1+math.exp(-y*f_w_x(proba_1)))
print 'Штраф Log Loss при грубой ошибке =', LogLoss_1

proba_2 = 0.99

MSE_2 = (y - proba_2)**2
LogLoss_2 = math.log(1+math.exp(-y*f_w_x(proba_2)))

print '**************************************************************'
print 'Штраф MSE при сильной уверенности =', MSE_2
print 'Штраф Log Loss при сильной уверенности =', LogLoss_2
Sagen med grov fejl — modellen klassificerer objektet til klassen  med en sandsynlighed på 0,01.
Bøden ved brug af MNK vil være:

Bøden ved brug af Logistic Loss vil være:

Sagen med stærk sikkerhed — modellen klassificerer objektet til klassen  med en sandsynlighed på 0,99.
Bøden ved brug af MNK vil være:

Bøden ved brug af Logistic Loss vil være:

Dette eksempel illustrerer tydeligt, at ved grov fejl straffer tabsfunktionen Log Loss modellen betydeligt stærkere end MSE. Lad os nu se nærmere på, hvad de teoretiske forudsætninger for brugen af tabsfunktionen Log Loss i klassifikationsopgaver er.
05. Maximum Likelihood Metoden og logistisk regression.
Som lovet i begyndelsen, er artiklen fyldt med enkle eksempler. I studiet er der endnu et eksempel og gamle gæster — banklåntagerne: Vasja, Fedya og Lesha.
For enhver sikkerheds skyld, inden vi udvikler eksemplet, vil jeg minde om, at vi i virkeligheden arbejder med et træningssæt bestående af tusinder eller millioner af objekter med ti- eller hundredevis af karakteristika. Men her er tallene valgt, så de nemt kan forstås for en begyndende data scientist.
Lad os vende tilbage til eksemplet. Forestil dig, at bankdirektøren har besluttet at udstede lån til alle, der har brug for det, selvom algoritmen indikerede, at lånet ikke skulle gives til Lesha. Nu er der gået tilstrækkelig tid, og vi har fundet ud af, hvem af de tre personer der har betalt lånet, og hvem der ikke har. Som forventet: Vasja og Fedja har betalt lånet, mens Lesha ikke har. Lad os nu forestille os, at dette resultat er det, vi vil bruge som et nyt træningsdatasæt, og at vi tilsyneladende har mistet al information om de faktorer, der påvirker sandsynligheden for tilbagebetaling af lånet (ansattes løn, størrelsen på den månedlige betaling). Så intuitivt kan vi antage, at hver tredje låntager ikke returnerer lånet til banken, eller med andre ord er sandsynligheden for, at den næste låntager tilbagebetaler lånet  . Denne intuitive antagelse har teoretisk støtte og er baseret på maximum likelihood-metoden, som ofte i litteraturen kaldes maksimalt sandsynlighedsprincip.
Lad os starte med at blive bekendt med begreberne.
Sandsynligheden for et datasæt er sandsynligheden for at få netop dette datasæt, at få netop disse observationer/resultater, dvs. produktet af sandsynlighederne for at få hver af resultaterne i datasættet (for eksempel om Vasja, Fedja og Lesha har tilbagebetalt lånet samtidigt).
Sandsynlighedsfunktionen forbinder sandsynligheden for datasættet med værdierne af fordelingsparametrene.
I vores tilfælde repræsenterer træningsdatasættet en generaliseret Bernoulli-skema, hvor den tilfældige variabel kun kan antage to værdier:  eller
 . Derfor kan sandsynligheden for datasættet skrives som en sandsynlighedsfunktion af parameteren
 som følger:


Den ovenfor nævnte optegnelse kan fortolkes som følger. Den fælles sandsynlighed for, at Vasja og Fedja betaler lånet, er lig med  , sandsynligheden for at Lesha IKKE betaler lånet, er lig med
 (da der netop fandt sted en IKKE tilbagebetaling af lånet), derfor er den fælles sandsynlighed for alle tre hændelser lig med
 .
Maximum likelihood-metoden er en metode til estimering af en ukendt parameter ved at maksimere sandsynlighedsfunktionen. I vores tilfælde er det nødvendigt at finde en værdi,  , hvor
 opnår maksimum.
Hvor kommer ideen om at finde værdien af en ukendt parameter, hvor sandsynlighedsfunktionen når sit maksimum, fra? Ideen udspringer af forståelsen af, at en stikprøve er den eneste tilgængelige kilde til viden om den samlede population. Alt hvad vi ved om populationen er repræsenteret i stikprøven. Derfor kan vi kun sige, at stikprøven er den mest præcise repræsentation af populationen, vi har. Dermed skal vi finde den parameter, hvor den givne stikprøve bliver mest sandsynlig.
Det er tydeligt, at vi har at gøre med en optimeringsopgave, hvor vi skal finde et ekstremum for funktionen. For at finde ekstremum-punktet er det nødvendigt at overveje førsteordensbetingelsen, hvilket vil sige at sætte den deriverede af funktionen lig med nul og løse ligningen for den ønskede parameter. Dog kan søgningen efter den deriverede af produktet af mange faktorer tage lang tid, for at undgå dette findes der en særlig metode - at gå over til logaritmen. sandsynlighedsfunktionen. Hvorfor er sådan en overgang mulig? Lad os bemærke, at vi ikke søger selve ekstremum for funktionen. , men ekstremum-punktet, det vil sige værdien af den ukendte parameter,
 , hvor
 der når sit maksimum. Ved at gå over til logaritmen ændres ekstremum-punktet ikke (selvom selve ekstremum vil være anderledes), da logaritmen er en monoton funktion.
Lad os i overensstemmelse med det ovenstående fortsætte med at udvikle vores eksempel med lånene fra Vasilij, Fedja og Leša. For det første lad os gå over til logaritmen af sandsynlighedsfunktionen.:

Nu kan vi nemt differentiere udtrykket mht.  :

Og endelig, lad os overveje førsteordensbetingelsen - vi sætter den deriverede af funktionen lig med nul:

Dermed var vores intuitive vurdering af sandsynligheden for tilbagebetaling af lånet  teoretisk begrundet.
Fint, men hvad skal vi nu gøre med sådan information? Hvis vi antager, at hver tredje låntager ikke betaler pengene tilbage til banken, vil den sidstnævnte uundgåeligt gå konkurs. Sådan er det, men ved vurderingen af sandsynligheden for tilbagebetaling af lånet som værende lig med  Vi tog ikke højde for de faktorer, der påvirker tilbagebetalingen af lån: låntagers løn og størrelsen på den månedlige betaling. Lad os huske, at vi tidligere beregnede sandsynligheden for, at hvert enkelt lån ville blive tilbagebetalt, med disse faktorer i mente. Det er logisk, at vores sandsynligheder derfor er forskellige fra konstanten lig med
 .
Lad os definere sandsynligheden for stikprøver:
Kode til beregning af sandsynligheden for stikprøver
from functools import reduce

def likelihood(y,p):
    line_true_proba = []
    for i in range(len(y)):
        ltp_i = p[i]**y[i]*(1-p[i])**(1-y[i])
        line_true_proba.append(ltp_i)
    likelihood = []
    return reduce(lambda a, b: a*b, line_true_proba)


y = [1.0,1.0,0.0]
p_log_response = df['Probability']
const = 2.0/3.0
p_const = [const, const, const]


print 'Sandsynligheden for stikprøven ved konstant værdi p=2/3:', round(likelihood(y,p_const),3)

print '****************************************************************************************************'

print 'Sandsynligheden for stikprøven ved beregnet værdi p:', round(likelihood(y,p_log_response),3)
Sandsynligheden for stikprøven ved konstant værdi  :

Sandsynligheden for stikprøven ved beregning af tilbagebetalingssandsynligheden under hensyntagen til faktorer  :


Sandsynligheden for stikprøven med en sandsynlighed beregnet ud fra faktorer viste sig at være højere end sandsynligheden ved konstant sandsynlighedsværdi. Hvad betyder det? Det betyder, at kendskab til faktorerne har gjort det muligt at vælge en mere præcis sandsynlighed for tilbagebetaling af lån for hver kunde. Derfor vil det ved udstedelse af endnu et lån være mere korrekt at anvende den model for sandsynligheden for tilbagebetaling af skyld, der blev foreslået i slutningen af 3. kapitel af artiklen.
Men så, hvis vi ønsker at maksimere sandsynlighedsfunktionen for stikprøver, hvorfor så ikke bruge en algoritme, der f.eks. giver sandsynligheder for Vasia, Fedya og Lesha, der er henholdsvis 0.99, 0.99 og 0.01. Måske vil en sådan algoritme også præstere godt på træningsstikprøven, da den vil bringe værdien af stikprøvens sandsynlighed tættere på  , men for det første vil en sådan algoritme sandsynligvis have vanskeligheder med sin generaliseringsevne, og for det andet vil denne algoritme helt sikkert ikke være lineær. Og hvis metoder til at bekæmpe overfitting (ligesom svag generaliseringsevne) åbenlyst ikke er en del af denne artikels plan, lad os så se nærmere på det andet punkt. For dette er det tilstrækkeligt at besvare et enkelt spørgsmål. Kan sandsynligheden for, at lånene bliver tilbagebetalt af Vanya og Fedya, være ens, når vi tager de kendte faktorer i betragtning? I henhold til sund fornuft, selvfølgelig nej, det kan den ikke. For at tilbagebetale lånet vil Vanya skulle afgive 2,5% af sin månedlige løn, mens Fedya skal give næsten 27,8%. Desuden kan vi på grafik 2 "Klassificering af kunder" se, at Vanya er betydeligt længere væk fra linjen, der adskiller klasserne, end Fedya. Og endelig ved vi, at funktionen
 for Vanya og Fedya tager forskellige værdier: 4,24 for Vanya og 1,0 for Fedya. Hvis Fedya for eksempel tjente betydeligt mere, eller hvis han havde bedt om et mindre lån, ville sandsynlighederne for tilbagebetaling af lånene for Vanya og Fedya have været mere ens. Med andre ord kan man ikke narre den lineære afhængighed. Og hvis vi virkelig havde beregnet koefficienterne
 , og ikke blot taget dem ud af den blå luft, kunne vi roligt påstå, at vores værdier
 bedst muligt tillader at vurdere sandsynligheden for tilbagebetaling af lån af hver låntager, men da vi har aftalt at beregningen af koefficienterne
 blev udført i henhold til alle regler, vil vi netop betragte det sådan — vores koefficienter tillader at give den bedste vurdering af sandsynligheden 🙂
Men vi har afveget. I dette afsnit skal vi finde ud af, hvordan vægtvektoren  , som er nødvendig for at vurdere sandsynligheden for tilbagebetaling af lån fra hver låntager, bestemmes.
Sammenfattende, hvilket arsenal vi har til at lede efter koefficienterne  :
1. Vi antager, at afhængigheden mellem den afhængige variabel (den prognostiserede værdi) og faktoren, der påvirker resultatet — er lineær. Af denne grund anvendes den lineære regressionsfunktion typen  , hvis linje deler objekterne (kunderne) i klasser
 og
 eller
 (kunder, der kan tilbagebetale lånet, og dem, der ikke kan). I vores tilfælde tager ligningen følgende form
 .
2. Vi bruger den inverse logit-transformation typen  til at bestemme sandsynligheden for, at objektet tilhører klassen
 .
3. Vi betragter vores træningsdatasæt som en realisering af en generaliseret Bernoulli-skemata, dvs. for hvert objekt genereres en tilfældig variabel, som med sandsynlighed  (sin for hvert objekt) tager værdien 1 og med sandsynlighed
 – 0.
4. Vi ved, at vi skal maksimere sandsynlighedsfunktionen for stikprøver under hensyntagen til de accepterede faktorer, så den eksisterende stikprøve bliver så sandsynlig som muligt. Med andre ord, vi skal finde parametre, hvor stikprøven bliver mest sandsynlig. I vores tilfælde er den parameter, vi justerer — sandsynligheden for lånets tilbagebetaling  , som igen afhænger af ukendte koefficienter
 . Så vi skal finde en vægtvektor
 , hvorved sandsynligheden for stikprøven bliver maksimal.
5. Vi ved, at for at maksimere sandsynlighedsfunktionen for stikprøven kan man bruge maksimale sandsynlighedsmetode. Og vi kender alle de snedige tricks til at arbejde med denne metode.
Sådan en mangeomgangs løsning får vi 🙂
Og lad os nu huske, at vi i begyndelsen af artiklen ønskede at udlede to typer af tabsfunktioner Logistic Loss afhængig af hvordan klasserne for objekterne betegnes. Det er traditionelt, at i klassifikationsopgaver med to klasser, betegnes klasserne som  og
 eller
 . Afhængigt af betegnelse, vil der være en tilsvarende tabsfunktion.
Tilfælde 1. Klassificering af objekter til og
 og

Tidligere, ved bestemmelsen af sandsynligheden for stikprøven, hvori sandsynligheden for, at låntageren tilbagebetaler gælden, blev beregnet ud fra faktorer og angivne koefficienter  , anvendte vi formlen:

I virkeligheden  — er den værdi af logit-funktionen
 ved den angivne vægtvektor

Så intet forhindrer os i at skrive sandsynlighedsfunktionen for stikprøven sådan:

Nogle gange kan det være udfordrende for begyndende analytikere at forstå, hvordan denne funktion virker. Lad os se på 4 korte eksempler, der alle vil klarlægge:
1. Hvis  (dvs. ifølge træningsstikprøven tilhører objektet klasse +1), mens vores algoritme
 bestemmer sandsynligheden for, at objektet tilhører klassen
 til at være 0.9, så denne del af sandsynligheden for stikprøven beregnes således:

2. Hvis  , og
 , så beregningen vil være sådan:

3. Hvis  , og
 , så beregningen vil være sådan:

4. Hvis  , og
 , så beregningen vil være sådan:

Det er tydeligt, at sandsynlighedsfunktionen vil maksimeres i tilfælde 1 og 3 eller i det generelle tilfælde — når værdierne for sandsynligheden for, at objektet tilhører klassen, er korrekt gættet  .
I forbindelse med, at når sandsynligheden for, at objektet tilhører klassen, bestemmes  Vi kender kun koefficienterne
 , så vi vil lede efter dem. Som nævnt tidligere er dette en optimeringsopgave, hvor vi først skal finde derivatet af likelihood-funktionen med hensyn til vægtvektoren
 . Dog kan det være en god idé at forenkle opgaven: vi vil søge derivatet af logarithmen sandsynlighedsfunktionen.

Hvorfor, efter logaritmering, i logistisk fejlfunktion, ændrede vi tegnet fra  og få en fungerende kommando.
 . Det er simpelt, da det i modelvurderingsopgaver er almindeligt at minimere værdien af funktionen, derfor gangede vi højre side af udtrykket med
 og i stedet for at maksimere, minimerer vi nu funktionen.
Egentlig, lige nu, foran jeres øjne, er tabet af funktionen blevet stridigt udledt — Logistic Loss for træningssættet med to klasser:  og
 .
Nu, for at finde koefficienterne, skal vi blot finde derivatet logistisk fejlfunktion og derefter, ved hjælp af numeriske optimeringsmetoder som gradient descent eller stokastisk gradient descent, finde de mest optimale koefficienter  . Men i betragtning af den allerede betydelige mængde af artiklen, foreslås det at udføre differentiering selv, eller måske vil dette blive emnet for den næste artikel med et stort antal aritmetiske beregninger uden så mange detaljerede eksempler.
Case 2. Klassifikation af objekter i og
 og

Tilgangen her vil være den samme som med klasserne  og
 , men selve vejen til at udlede tabsfunktionen Logistic Loss, vil være mere kringlet. Lad os komme i gang. Vi vil bruge operatoren «hvis…, så…». Det vil sige, hvis
 -te objekt tilhører klassen
 , så til beregning af udvalgets likelihood bruger vi sandsynligheden
 , hvis objektet tilhører klassen
 , så indsætter vi i likelihood
 . Sådan ser likelihood-funktionen ud:

Lad os forklare, hvordan det fungerer. Lad os overveje 4 tilfælde:
1. Hvis  og
 , så vil likelihood for udvalget «gå ind»

2. Hvis  og
 , så vil likelihood for udvalget «gå ind»

3. Hvis  og
 , så vil likelihood for udvalget «gå ind»

4. Hvis  og
 , så vil likelihood for udvalget «gå ind»

Åbenlyst, at i tilfælde 1 og 3, hvor sandsynlighederne blev korrekt bestemt af algoritmen, vil likelihood-funktionen blive maksimeret, det er præcis, hvad vi ønskede at opnå. Men denne tilgang er ret klodset, og herefter vil vi se på en mere kompakt repræsentation. Men først, lad os logaritmere likelihood-funktionen med et tegnskift, da vi nu vil minimere den.

Lad os i stedet for  indsætte udtrykket
 :

Vi forenkler det højre leddet under logaritmen ved at bruge enkle aritmetiske teknikker og får:

Og nu er det tid til at slippe af med operatoren «hvis…, så…». Vi bemærker, at når objektet  tilhører klassen
 , så i udtrykket under logaritmen, i nævneren,
 optræder i eksponenten
 , hvis objektet tilhører klassen
 , så $e$ hæves til eksponenten
 . Derfor kan notation af eksponenten forenkles – vi kan kombinere begge tilfælde til ét:
 . Så funktionen for logistisk fejl vil have formen:

I henhold til logaritmereglerne, vil vi vende brøken om og tage " " (minus) ud foran logaritmen, og får:

Foran dig er tabsfunktionen logistic Loss, der anvendes i træningsdatasættet med objekter, der tilhører klasserne:  og
 .
Nå, på dette punkt siger jeg farvel, og vi afslutter artiklen.
Forfatterens tidligere arbejde - «Bringing the linear regression equation into matrix form»
Supplerende materialer
1. Litteratur
1) Anvendt regressionsanalyse / N. Draper, G. Smith – 2. udg. - M.: Finans og statistik, 1986 (oversættelse fra engelsk)
2) Sandsynlighedsteori og matematisk statistik / V.E. Gmurman – 9. udg. – M.: Højere skole, 2003
3) Sandsynlighedsteori / N.I. Tjernova – Novosibirsk: Novosibirsk Statsuniversitet, 2007
4) Forretningsanalyse: fra data til viden / Paklin N.B., Oreshkov V.I. – 2. udg. – Sankt Petersborg: Peter, 2013
5) Data Science – Videnskaben om data fra bunden / Joel Grass – Sankt Petersborg: BHV Petersborg, 2017
6) Praktisk statistik for Data Science-specialister / P. Bruce, E. Bruce – Sankt Petersborg: BHV Petersborg, 2018
2. Vorlesninger, kurser (video)
1)
2)
3)
4)
5)
3. Internetkilder
1)
2)
3)
4)
5)
6)
7)
8)
Kilde: habr.com
