

Denne artikel er skrevet for at hjælpe med at vælge den rigtige løsning og forstå forskellene mellem SDS som Gluster, Ceph og Vstorage (Virtuozzo).
Teksten indeholder links til artikler med en mere detaljeret beskrivelse af forskellige problemer, så beskrivelserne vil være så korte som muligt, med fokus på centrale punkter uden unødig fyldstof og indledende information, som du selv kan finde på internettet, hvis ønskes.
Emnerne berørt kræver selvfølgelig en bestemt tone, men i den moderne verden er der flere og flere mennesker, der ikke bryder sig om at læse meget))), så man kan hurtigt skimmede teksten og træffe et valg, og hvis noget er uklart, kan man følge linksene eller google ukendte ord))), og denne artikel fungerer som en gennemsigtig indpakning for disse dybe emner, der viser indholdet – hovedpunkterne for hver løsning.
Gluster
Lad os starte med Gluster, som aktivt anvendes af producenter af hyperkonvergerende platforme baseret på open source SDS til virtuelle miljøer, og det kan findes på RedHat's hjemmeside under storage, hvor man kan vælge mellem to SDS-muligheder: Gluster eller Ceph.
Gluster består af en stak oversættere – tjenester, der udfører alle opgaver relateret til filfordeling osv. Brick – en tjeneste, der varetager en disk, Volume – et volumene (pulje) – som samler disse bricks. Dernæst er der en tjeneste til filfordeling i grupper via DHT (distributed hash table) funktionen. Tjenesten Sharding vil vi ikke inkludere i beskrivelsen, da du i de link, der ligger nedenfor, vil finde en beskrivelse af de problemer, der er forbundet med den.
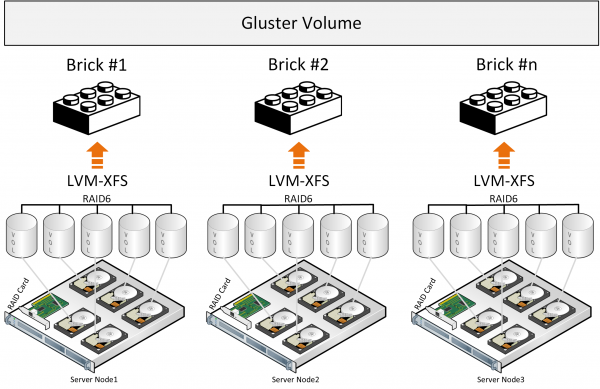
Ved skrivning placeres filen helt i en brick, og en kopi skrives parallelt til en brick på en anden server. Derefter vil den anden fil blive skrevet til den anden gruppe af to bricks (eller flere) på forskellige servere.
Hvis filerne er omtrent ens i størrelse og volumet kun vil bestå af én gruppe, vil alt være i orden, men under andre forhold vil følgende problemer opstå som beskrevet:
- pladsen i grupper udnyttes ujævnt, hvilket afhænger af filstørrelserne, og hvis der ikke er nok plads i gruppen til at skrive filen – får du en fejl, filen vil ikke blive skrevet, og den vil ikke blive omfordelt til en anden gruppe;
- ved skrivning af én fil går IO kun til én gruppe, mens de andre står stille;
- man kan ikke få IO for hele volumet ved skrivning af én fil;
- og den samlede konception virker mindre effektiv på grund af manglen på datadistrubution over blokke, hvor det er lettere at udføre balancering og løse problemet med jævn fordeling, i modsætning til hvordan en fil i øjeblikket placeres i en brik i sin helhed.
Fra den officielle beskrivelse kommer man også uundgåeligt til at forstå, at Gluster fungerer som en filopbevaring oven på klassisk hardware RAID. Der har været forsøg på at skære (Sharding) filer i blokke, men alt dette er tilføjelser, der medfører tab af ydeevne til den allerede eksisterende arkitektoniske tilgang, plus brugen af sådanne frit tilgængelige komponenter med begrænsninger i ydeevne som Fuse. Der er ingen metadata-tjenester, hvilket begrænser ydeevnen og pålideligheden af lageret ved filfordelingsblokke. Bedre ydeevne kan observeres i konfigurationen “Distributed Replicated” med et minimum af 6 noder for at organisere en pålidelig replik med 3 for optimal belastningsfordeling.
Disse konklusioner er også relateret til beskrivelsen af oplevelsen med og ved sammenligning med , samt der er en beskrivelse af erfaringerne leading til forståelsen af denne mere effektive og mere pålidelige konfiguration
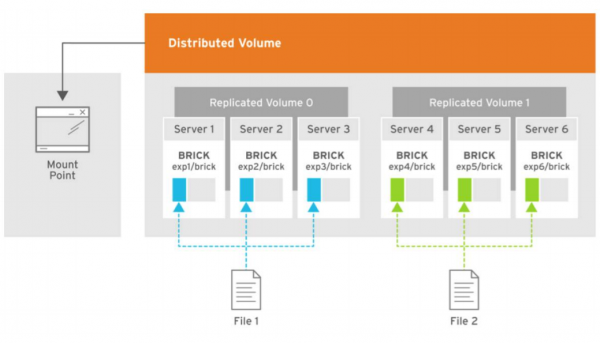
Billedet viser belastningsfordelingen ved skrivning af to filer, hvor kopierne af den første fil fordeles over de tre første servere, som er samlet i volume 0-gruppen, og tre kopier af den anden fil placeres på den anden gruppe volume 1 fra tre servere. Hver server har en disk.
Den samlede konklusion er, at Gluster kan anvendes, men med forståelse for, at der vil være begrænsninger i ydeevne og pålidelighed, som skaber udfordringer under visse betingelser i hyperkonvergerede løsninger, hvor ressourcer også er nødvendige til beregningsbelastninger i virtuelle miljøer.
Der er også nogle Gluster-ydeevneindikatorer, der kan opnås under visse forhold, begrænset til
Ceph
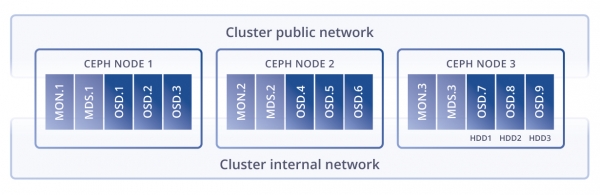
Lad os nu se på Ceph fra de arkitekturbeskrivelser, som jeg har været i stand til Der er også en sammenligning mellem , hvor man straks kan forstå, at Ceph generelt bør implementeres på separate servere, da dets tjenester kræver alle hardware-ressourcer under belastning.
Arkitektur mere komplekst end Gluster og inkluderer tjenester som metadata services, men hele komponentstakken er ret kompleks og ikke særlig fleksibel til brug i virtualiseringsløsninger. Data er opdelt i blokke, hvilket synes at være mere effektivt, men der er tab og latenstid i hierarkiet af alle tjenester (komponenter) under visse belastninger og nødsituationer, som følgende eksempel viser.
Fra arkitekturens beskrivelse er hjertet CRUSH, som bestemmer placeringen af data. Dernæst kommer PG — det er den mest komplekse abstraktion (logisk gruppe) at forstå. PG er nødvendige for at gøre CRUSH mere effektiv. Hovedformålet med PG er at gruppere objekter for at reducere ressourc verbraugen, øge ydeevnen og skalerbarheden. Direkte adressering af objekter enkeltvis uden at samle dem i PG ville være meget omkostningskrævende. OSD er en service for hver enkelt disk.
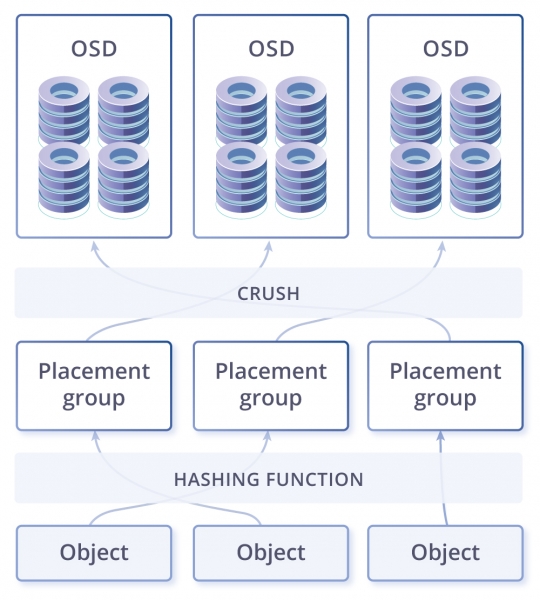
Et cluster kan have en eller flere datalagre til forskellige formål og med forskellige indstillinger. Lagringene er opdelt i placering grupper. I placering grupperne opbevares de objekter, som kunderne tilgår. Dette markerer afslutningen på det logiske niveau, og det fysiske niveau begynder, da der er knyttet en hoveddisk og flere replika diske til hver placering gruppe (hvor mange afhænger af replikationsfaktoren for lagringen). Med andre ord, på det logiske niveau opbevares objektet i en bestemt placering gruppe, mens det på det fysiske niveau ligger på de diske, der er knyttet til den. Diskene kan fysisk være placeret på forskellige noder eller endda i forskellige datacentre.
I denne skema ser gruppeplaceringer ud til at være et nødvendigt niveau for fleksibilitet i hele løsningen, men på samme tid også som et unødvendigt led i kæden, hvilket uvilkårligt fører tankerne hen på et tab af ydeevne. For eksempel, når data skal skrives, skal systemet opdele dem i disse grupper og derefter på det fysiske niveau til hoveddisken og replika-diskene. Det vil sige, at hash-funktionen arbejder, når den søger efter og indsætter objekter, men der er en bivirkning – der er meget store omkostninger og begrænsninger ved at omstrukturere hashen (når man tilføjer eller fjerner en disk). Et andet problem med hashen er den faste placering af dataene, som ikke kan ændres. Det vil sige, at hvis en disk oplever en højere belastning, har systemet ikke mulighed for ikke at skrive til den (ved at vælge en anden disk); hash-funktionen forpligter til at placere data efter en regel, uanset hvor dårligt det går med disken. Derfor bruger Ceph meget hukommelse ved omstrukturering af PG i tilfælde af selvreparation eller øgning af lagerkapaciteten. Konklusionen er, at Ceph fungerer godt (selv om det er langsomt), men kun når der ikke er skalering, nødsituationer eller opdateringer.
Der er selvfølgelig muligheder for at øge ydeevnen gennem caching og cache-tiering, men det kræver godt hardware, og der vil stadig være tab. Men generelt ser Ceph mere tiltalende ud end Gluster for produktive miljøer. Derudover er det vigtigt at tage højde for en væsentlig faktor, nemlig et højt niveau af kompetencer, erfaring og professionalisme med stort fokus på Linux, da det er meget vigtigt at implementere, konfigurere og vedligeholde det korrekt, hvilket lægger endnu mere ansvar og belastning på administratoren.
Vstorage
Endnu mere interessant ser arkitekturen ud hos , som kan bruges sammen med hypervisoren på de samme noder, på det samme , men det er meget vigtigt at konfigurere det korrekt for at opnå god ydeevne. Det vil sige, at det er meget let at implementere et sådant produkt lige ud af boksen på en vilkårlig konfiguration uden at tage højde for anbefalingerne i henhold til arkitekturen, men det vil ikke være produktivt.
Hvad kan sameksistere til lagring ved siden af hypervisor-tjenesterne kvm-qemu? Det er blot et par tjenester, hvor der er fundet en kompakt optimal hierarki af komponenter: kundeservice monteret via FUSE (modificeret, ikke open source), metadata-tjenesten MDS (Metadata service), dataservice Chunk service, som på det fysiske niveau svarer til én disk, og det er alt. For hastighed er det selvfølgelig optimalt at bruge en fejltolerant ordning med to replikaer, men hvis caching og logning på SSD-diske implementeres, kan fejlkodning (erase coding eller raid6) accelereres betydeligt i et hybrid system eller endnu bedre på all flash. Ved EC (erase coding) er der en lille ulempe: ændres én datablok, skal paritetssummerne beregnes igen. For at undgå tab på denne operation skriver Ceph i EC forsinket, og der kan opstå præstationsproblemer ved bestemte forespørgsler, når man for eksempel har brug for at læse alle blokke. I tilfælde af Virtuozzo Storage udføres skrivning af ændrede blokke ved hjælp af en tilgang med "log-structured file system", som minimerer omkostningerne ved paritetsberegningen. For at få en idé om mulighederne for at fremskynde arbejdet med og uden EC, er der – tallene kan være omtrentlige afhængigt af producentens præcisionskoefficient, men resultatet af beregningerne hjælper godt med at planlægge konfigurationen.
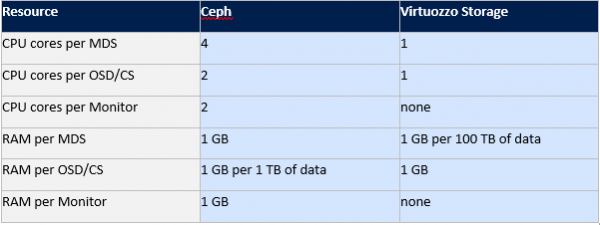
En simpel opstilling af lagringskomponenter betyder ikke, at disse komponenter ikke forbruger men hvis man beregner alle udgifter på forhånd, kan man regne med en samarbejdende drift tæt på hypervisoren.
Der er et sammenligningsskema for hardware ressourcer for Ceph-tjenesterne og Virtuozzo-storage.
Hvis man tidligere kunne sammenligne Gluster og Ceph ud fra gamle artikler, ved at bruge de vigtigste linjer fra dem, er det sværere med Virtuozzo. Der er ikke så mange artikler om dette produkt, og informationen kan kun fås fra dokumentationen på eller på russisk, hvis man betragter Vstorage som et lager, der anvendes i nogle hyperkonvergente løsninger i virksomheder som og Acronis.
Jeg vil prøve at hjælpe med beskrivelsen af denne arkitektur, så teksten bliver lidt længere, men for at forstå dokumentationen selv kræver det meget tid, og den eksisterende dokumentation kan kun bruges som reference ved at gennemgå indholdsfortegnelsen eller søge efter nøgleord.
Lad os se på skriveprocessen i en hybrid konfiguration af hardware med de ovenfor beskrevne komponenter: skrivningen begynder på den node, hvorfra den blev initieret af klienten (FUSE-monteringspunktstjenesten), men komponenten master metadata service (MDS) vil selvfølgelig sende klienten direkte til den rette chunk service (block storage service), så MDS deltager ikke i skriveprocessen, men dirigerer blot til den nødvendige chunk service. Man kan generelt lave en analogi med skrivning som vandudløb i tønder. Hver tønde er en datablok på 256 MB.
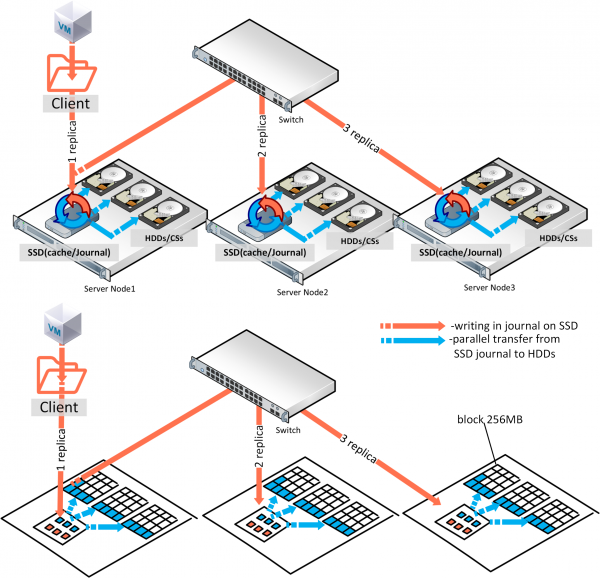
Det vil sige, at en disk er et bestemt antal af sådanne tønder, så diskens volumen divideret med 256 MB. Hver kopi udlægges til en node, den anden næsten parallelt til en anden node osv. Hvis vi har tre replikaer og der er SSD-diske til cache (til læsning og skrivejournaler), så vil bekræftelsen af skrivningen finde sted efter, at journalen er skrevet til SSD, mens den parallelle udskrivning fra SSD fortsætter på HDD, næsten i baggrunden. I tilfælde af tre replikaer vil skrivekommitment være efter bekræftelse fra SSD på den tredje node. Det kan virke som om, at den samlede hastighed for skrivningen af de tre SSD'er kan deles med tre, og at vi får hastigheden for skrivningen af én replika, men skrivningen af kopier sker parallelt, og netværkslatens er som regel højere end for SSD, og i praksis vil skriveydelsen afhænge af netværket. Derfor, for at se reelle IOPS, er det nødvendigt korrekt at belaste hele Vstorage efter , så man tester den reelle belastning, ikke blot hukommelse og cache, hvor man skal tage højde for den rette blokstørrelse, antal tråde osv.
Den førnævnte SSD-log fungerer sådan, at så snart data kommer ind, bliver de straks læst af tjenesten og skrevet til HDD. Der er flere metadata services (MDS) pr. klynge, og deres antal bestemmes af et quorum, der fungerer efter Paxos-algoritmen. For kunden er FUSE-monteringspunktet en mappe i klyngeopbevaringen, der samtidig er synlig for alle noder i klyngen; hver node har monteret en klient på denne måde, så hver enhed har adgang til denne opbevaring.
For ydeevnen af enhver af de ovenfor beskrevne tilgange er det meget vigtigt, ved planlægnings- og implementeringsfasen, at netværket indstilles korrekt, hvor der skal ske belastningsbalancering gennem aggregation og med den rigtige valgte båndbredde. I aggregationen er det vigtigt korrekt at vælge hash-tilstand og rammestrørrelser. Derudover er der en meget tydelig forskel fra de ovenfor beskrevne SDS, da dette er FUSE med hurtig sti-teknologi i Virtuozzo Storage. Denne løsning, med den opgraderede FUSE i modsætning til andre open source-løsninger, øger IOPS betydeligt og gør det muligt ikke at være begrænset til horisontal eller vertikal skalering. Sammenlignet med de tidligere beskrevne arkitekturer virker denne mere kraftfuld, men for denne fordel er det selvfølgelig nødvendigt at købe licenser i modsætning til Ceph og Gluster.
Afslutningsvis kan man fremhæve top tre: første plads for ydeevne og pålidelighed indtages af Virtuozzo Storage, efterfulgt af Ceph på anden plads og Gluster på tredje plads.
Kriterierne for valg af Virtuozzo Storage er: det optimale sæt af komponenter i arkitekturen, den opgraderede Fuse med hurtig sti, fleksible konfigurationsmuligheder for hardware, lavere ressourceforbrug og muligheden for at dele med compute (beregninger/virtualisering), hvilket gør det fuldt ud velegnet til hyperkonvergerende løsninger, som det er en del af. Andenplads går til Ceph, fordi det er en mere ydedygtig arkitektur end Gluster, takket være blokoperationer, samt mere fleksible scenarier og muligheden for at arbejde i større klynger.
Planerne inkluderer ønsket om at skrive en sammenligning mellem vSAN, Space Direct Storage, Vstorage og Nutanix Storage, test af Vstorage på HPE- og Huawei-udstyr, samt scenarier for integration af Vstorage med eksterne hardware SAN, så hvis du kunne lide artiklen, ville det være godt at modtage feedback fra dig, som kunne styrke motivationen for nye artikler med hensyntagen til dine kommentarer og ønsker.
Kilde: habr.com
