

I 2010 havde virksomheden 50 servere og en simpel netværksmodel: backend, frontend og firewall. Antallet af servere voksede, modellen blev mere kompleks: staging, isolerede VLAN med ACL, derefter VPN med VRF, VLAN med ACL på L2, VRF med ACL på L3. Har du fået hovedpine? Det bliver sjovere.
Da antallet af servere nåede 16.000, blev det umuligt at arbejde med så mange forskellige segmenter uden problemer. Derfor fandt vi en anden løsning. Vi tog Netfilter-stakken, tilføjede Consul som datakilde, og fik en hurtig distribueret firewall. Den erstattede ACL på routerne og blev brugt som en ekstern og intern firewall. For dynamisk styring af værktøjet udviklede vi systemet BEFW, som blev anvendt overalt: fra brugeradgangsstyring i produktnetværket til isolering af netværkssegmenter fra hinanden.
Hvordan det hele fungerer, og hvorfor du skal holde øje med dette system, vil Ivan Agarov () — leder af infrastruktur sikkerhedsgruppen i Maintenance-afdelingen ved Wargaming's Minsk udviklingscenter. Ivan er en fan af SELinux, elsker Perl, skriver kode. Som leder af cybersikkerhed, arbejder han regelmæssigt med logs, backups og R&D for at beskytte Wargaming mod hackere og sikre driften af alle spilserverne i virksomheden.
Historisk baggrund
Før jeg fortæller, hvordan vi gjorde det, vil jeg forklare, hvordan vi kom dertil, og hvorfor det var nødvendigt. For at gøre det, lad os gå tilbage 9 år: til 2010, da World of Tanks lige var kommet.
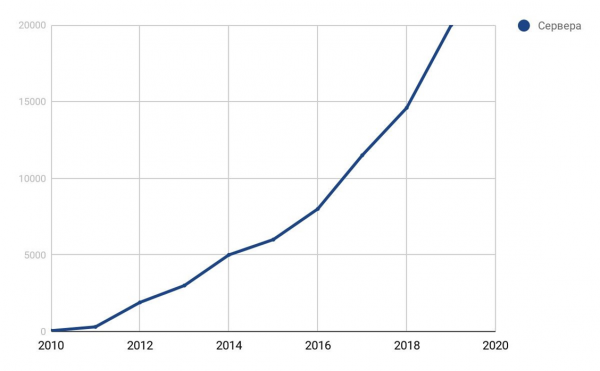
Diagram over væksten i virksomhedens servere.
Vi havde en netværksmodel. På det tidspunkt var det optimal.
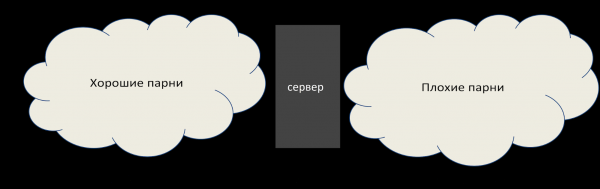
Netværksmodel i 2010.
På frontend bor de dårlige fyre, der ønsker at bryde os, men der er en firewall. På backend er der ingen firewall, men der er 50 servere, vi kender dem alle. Alt fungerer godt.
På 4 år voksede serverparken 100 gange til 5000. De første isolerede netværk dukkede op - staging: de kan ikke komme til produktionen, og der kørte ofte noget, der kunne være farligt.
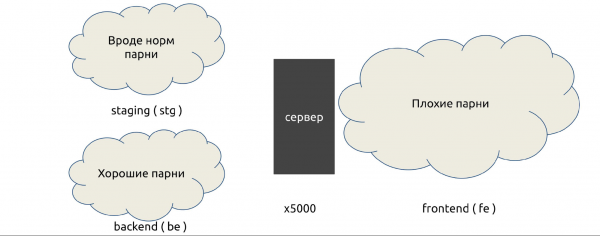
Netværksmodel i 2014.
Vi fortsatte med at bruge de samme hardware, og alt arbejde blev udført på isolerede VLAN: der skrives ACL til VLAN, der tillader eller forhindrer en bestemt forbindelse.
I 2016 nåede antallet af servere op på 8000. Wargaming opkøbte andre studier, og der kom flere partnerskaber til. De virker til at være vores, men er ikke helt: for partnere fungerer VLAN ofte ikke, så vi er nødt til at bruge VPN med VRF, hvilket komplicerer isoleringen. En blanding af ACL-isolationer voksede.
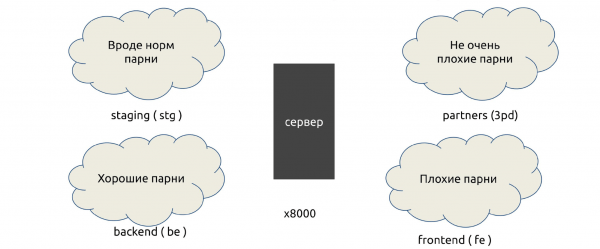
Netværksmodellen i 2016.
Ved udgangen af 2018 var maskinparken vokset til 16.000. Der var 6 segmenter, og vi talte ikke de andre, herunder de lukkede, hvor finansielle data blev opbevaret. Container-netværk (Kubernetes), DevOps, cloud-netværk, der var tilsluttet via VPN, eksempelvis fra IWS, dukkede op. Der var mange regler – det var smertefuldt.
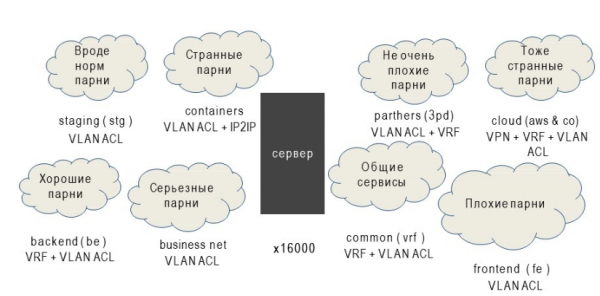
Netværksmodellen og isolationsmetoderne i 2018.
Til isolation brugte vi: VLAN med ACL på L2, VRF med ACL på L3, VPN og meget mere. Alt for meget.
Problemer
Alle lever med ACL og VLAN. Hvad er overhovedet galt? På det spørgsmål vil Harold svare og skjule smerten.
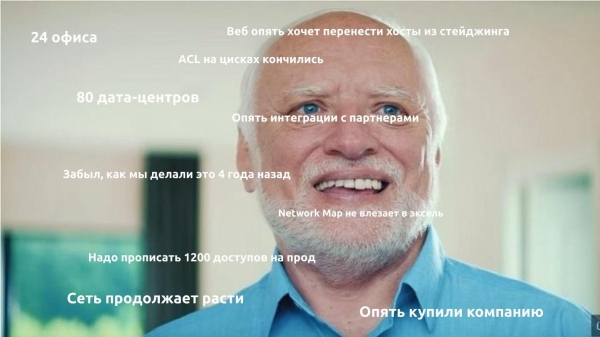
Der var mange problemer, men få massive.
- Geometrisk prisstigning for de nye regler. Hver ny regel tog længere tid at tilføje end den forrige, fordi man først skulle se, om der allerede fandtes en sådan regel.
- Der er ingen firewall inden i segmenterne. Segmenterne blev på en måde adskilt fra hinanden, men der var allerede ikke nok ressourcer indeni.
- Reglerne blev anvendt lang tid. Ved hjælp af hænderne kunne operatørerne skrive én lokal regel på en time. En global regel tog flere dage.
- Udfordringer med regelefterlevelse. Mere præcist, det var umuligt. De første regler blev skrevet tilbage i 2010, og størstedelen af deres forfattere arbejdede ikke længere i virksomheden.
- Lav kontrol over infrastrukturen. Det er det største problem – vi vidste dårligt, hvad der egentlig skete.
Sådan så netværksingeniøren ud i 2018, når han hørte: 'Vi har brug for lidt flere ACL.'
Løsninger
I begyndelsen af 2018 blev det besluttet at gøre noget ved det.
Prisen for integrationer stiger kontinuerligt. Udgangspunktet var, at store datacentre stoppede med at understøtte isolerede VLAN og ACL, fordi hukommelsen på enhederne var opbrugt.
Løsningen: at fjerne menneskeligt faktorer og maksimalt automatisere adgangsudstedelsen.
Nye regler anvendes langsomt. Løsningen: at fremskynde anvendelsen af reglerne, gøre den distribueret og parallel. Til dette er der brug for et distribueret system, så reglerne kan leveres direkte, uden rsync eller SFTP til tusind systemer.
Manglende firewall inden i segmenterne. Firewall inden for segmenter begyndte at komme til os, når forskellige tjenester opstod inden for det samme netværk. Løsning: anvende en firewall på værtsniveau — host-baserede firewalls. Praktisk talt overalt har vi Linux, og der er iptables overalt, hvilket ikke er et problem.
Udfordringer med revision af regler. Løsning: gemme alle regler ét sted til oversigt og styring, så vi kan revidere dem alle.
Lav grad af kontrol over infrastrukturen. Løsning: foretage en opgørelse over alle tjenester og adgange imellem dem.
Det er mere en administrativ proces end en teknisk. Nogle gange har vi 200-300 nye udgivelser om ugen, især under kampagner og helligdage. Dette er kun for ét af vores DevOps-hold. Med så mange udgivelser er det umuligt at forstå, hvilke porte, IP, integrationer der er nødvendige. Derfor havde vi brug for særligt uddannede serviceledere, der stillede spørgsmål til holdene: 'Hvad har I egentlig, og hvorfor satte I det op?'
Efter alt, hvad vi har lanceret, så netværksingeniøren i 2019 allerede sådan ud.
Consul
Vi besluttede, at alt, hvad vi fandt ved hjælp af serviceledere, ville blive gemt i Consul, og derfra ville vi skrive iptables-regler.
Hvordan besluttede vi at gøre dette?
- Vi samler alle tjenester, netværk og brugere.
- Vi laver iptables-regler baseret på dem.
- Vi automatiserer kontrollen.
- ….
- PROFIT.
Consul er ikke en fjern API, det kan arbejde på hver node og skrive til iptables. Det er kun tilbage at finde ud af automatiske kontrolmidler, der kan rense unødvendige ting, så det meste af problemerne vil være løst! Det resterende klarer vi i processen.
Hvorfor Consul?
Har bevist sit værd. I 2014-15 brugte vi det som backend til Vault, hvor vi gemmer vores adgangskoder.
Taber ikke data. I løbet af brugen har Consul ikke tabt data ved nogen fejl. Dette er en stor fordel for firewallstyringssystemet.
P2P-forbindelser fremskynder ændringsudbredelse. Med P2P kommer alle ændringer hurtigt, man skal ikke vente i timer.
Brugervenlig REST API. Vi overvejede også Apache ZooKeeper, men det har ikke en REST API, så vi skal lave løsninger.
Fungerer som både en nøglelagring (KV) og som et katalog (Service Discovery). Man kan gemme både tjenester, kataloger og datacentre. Dette er praktisk ikke kun for os, men også for de tilstødende teams, da vi bygger en global tjeneste og tænker stort.
Skrrevet i Go, som er en del af Wargaming-stakken. Vi elsker dette sprog, vi har mange Go-udviklere.
Mighty ACL-system. Med ACL i Consul kan man styre, hvem der skriver og hvad. Vi sikrer, at firewall-reglerne ikke overlapper med noget som helst, og at vi ikke får problemer med det.
Men Consul har også ulemper.
- Det skalerer ikke inden for datacenteret, medmindre du har business-versionen. Det skalerer kun via federation.
- Meget afhængig af kvaliteten af netværket og serverbelastningen. Consul vil ikke fungere ordentligt som server på en belastet server, hvis nettet har hakker, f.eks. uregelmæssige hastigheder. Dette skyldes P2P-forbindelser og opdateringsmodeller.
- Vanskeligheder med at overvåge tilgængelighed. I Consul-status kan det sige, at alt er godt, men den er faktisk død for længe siden.
De fleste af disse problemer har vi løst under drift af Consul, derfor valgte vi det. Virksomheden har planer om en alternativ backend, men vi har lært at håndtere problemerne og lever stadig med Consul.
Sådan fungerer Consul
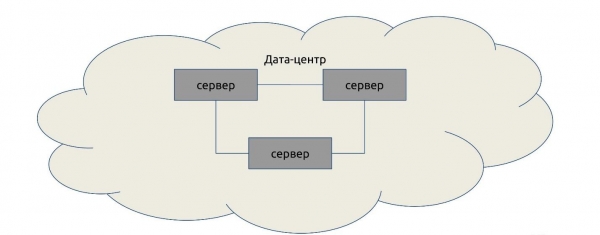
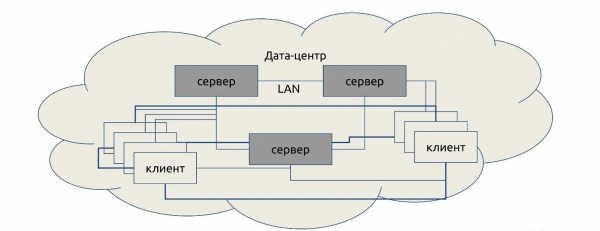
I et hypotetisk datacenter installerer vi servere - fra tre til fem. En eller to servere er ikke tilstrækkelige: de kan ikke danne quorum og afgøre, hvem der er korrekt, når dataene ikke stemmer overens. Mere end fem giver ikke mening, da ydeevnen vil falde.
Klienter tilsluttes serverne i vilkårlig rækkefølge: de samme agenter, kun med flaget server = false.
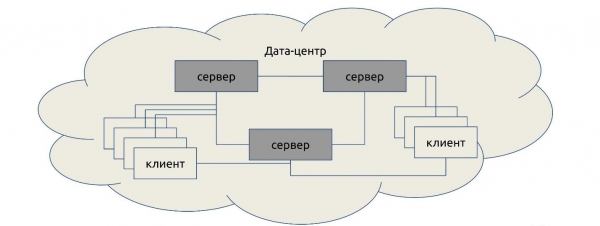
Efter dette får klienterne en liste over P2P-forbindelser og opbygger forbindelser imellem hinanden.
På globalt plan forbinder vi flere datacentre. De er også forbundet P2P og kommunikerer.
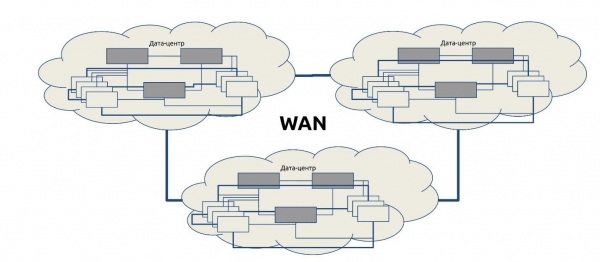
Når vi ønsker at hente data fra et andet datacenter, går anmodningen fra server til server. Denne opsætning kaldes Serf-protokollen. Serf-protokollen, ligesom Consul, er udviklet af HashiCorp.
Nogle vigtige fakta om Consul
Consul har dokumentation, der beskriver dets funktion. Jeg vil kun nævne udvalgte fakta, som er værd at vide.
Consul-servere vælger en leder blandt de stemmeberettigede. Consul vælger en leder fra listen af servere for hvert datacenter, og alle anmodninger går kun til ham, uanset antallet af servere. Hvis lederen hænger, fører det ikke til nyvalg. Hvis ingen leder er valgt, behandles anmodningerne af ingen.
Ønskede du horisontal skalering? Beklager, det er ikke muligt.
Anmodningen til et andet datacenter går fra master til master, uanset hvilken server den kommer til. Den valgte master modtager 100% af belastningen, bortset fra belastningen ved at videresende anmodninger. Den aktuelle kopi af data er tilgængelig på alle servere i datacentret, men kun én svarer.
Den eneste måde at skalere på er at aktivere stale-tilstand på klienten.
I stale-tilstand kan man svare uden quorum. Det er en tilstand, hvor vi opgiver datakonsistens, men læser en smule hurtigere end normalt, og alle servere kan svare. Selvfølgelig skrives der kun gennem masteren.
Consul kopierer ikke data mellem datacentre.Ved opsætning af federation vil hver server kun have sine egne data. For andre vil den altid henvende sig til en anden.
Atomaritet af operationer garanteres ikke uden for transaktioner.Husk, at ikke kun du kan ændre noget. Hvis du vil have det anderledes, skal du udføre en transaktion med låsning.
Låsende operationer garanterer ikke låsning.Anmodningen går fra master til master og ikke direkte, så der er ingen garanti for, at låsningen vil fungere, når du laver en låsning, for eksempel i et andet datacenter.
ACL garanterer heller ikke adgang (i mange tilfælde).ACL kan måske ikke fungere, fordi den opbevares i ét datacenter i federation — i ACL-datacenteret (Primært DC). Hvis DC ikke svarer, vil ACL ikke fungere.
En fastlåst master vil medføre, at hele federation fryser.For eksempel, i en federation med 10 datacentre, og i ét er der en dårlig forbindelse, og én master falder. Alle, der kommunikerer med den, fryser i en cyklus: der går en anmodning, der er ikke noget svar, tråden fryser. Man kan ikke vide, hvornår dette vil ske, bare efter en time eller to vil hele federation falde. Du kan ikke gøre noget ved det.
Status, quorum og valg behandles af en separat tråd. Der vil ikke ske genvalg, status viser ingenting. Du tror, at din Consul er aktiv, anmoder, og der sker ingenting — der er intet svar. I mellemtiden viser status, at alt er i orden.
Vi har stødt på dette problem, vi har været nødt til at ombygge specifikke dele af datacentre for at undgå det.
I erhvervsversionen af Consul Enterprise mangler nogle af de tidligere nævnte ulemper.Det har mange nyttige funktioner: valg af afstemmer, fordeling, skalering. Der er kun én 'men' - licenssystemet til det distribuerede system er meget dyrt.
Lifehack: rm -rf /var/lib/consul — medicinen mod alle agentens sygdomme. Hvis noget ikke virker, så slet bare dine data og hent data fra en kopi. Sandsynligvis vil Consul fungere igen.
BEFW
Lad os nu tale om, hvad vi har tilføjet til Consul.
— det er en forkortelse for BackEndFireWalle. Jeg måtte finde på et navn til produktet, da jeg oprettede repoet for at lægge de første test commits ind. Sådan et navn blev det.
Regelmønstre
Reglerne er skrevet i iptables-syntax.
- -N BEFW
- -P INPUT DROP
- -A INPUT -m state --state RELATED,ESTABLISHED -j ACCEPT
- -A INPUT -i lo -j ACCEPT
- -A INPUT -j BEFW
Alt går til kæden BEFW, bortset fra ESTABLISHED, RELATED og localhost. Mønstret kan være hvilket som helst, dette er bare et eksempel.
Hvad er BEFW godt for?
Tjenester
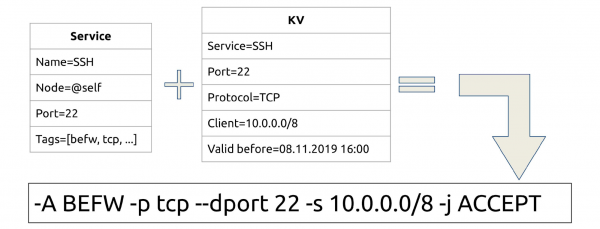
Vi har en service, den har altid en port, noden hvor den kører. Fra vores node kan vi lokalt spørge agenten og finde ud af, at vi har en eller anden service. Man kan også sætte tags.
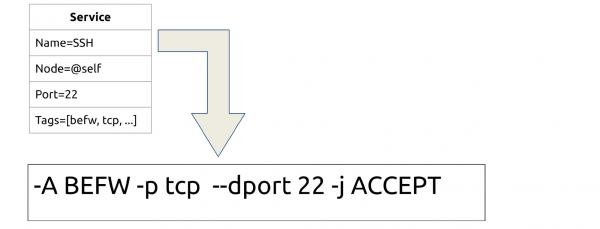
Enhver service, der kører og er registreret i Consul, bliver til en iptables regel. Vi har SSH - vi åbner port 22. Bash-scriptet er enkelt: curl og iptables, der er ikke brug for mere.
Klienter
Hvordan åbner man adgang for nogle få, men ikke for alle? Ved at navngive service og lægge IP-lister i KV-lageret.
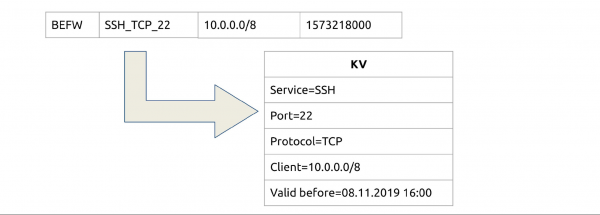
For eksempel ønsker vi, at alle fra det tiende netværk kan tilgå SSH_TCP_22 servicen. Vi tilføjer et lille felt TTL? og nu har vi tidsbegrænsede tilladelser, for eksempel i et døgn.
Adgang
Vi forbinder tjenester og klienter: vi har en service, for hver er der et klart KV-lager. Nu giver vi adgang ikke til alle, men selektivt.
Grupper
Hvis vi hver gang skal skrive tusindvis af IP'er for adgang, bliver vi trætte. Lad os finde på grupperinger - et separat subset i KV. Lad os kalde det Alias (eller grupper), og vi vil gemme grupper der efter samme princip.
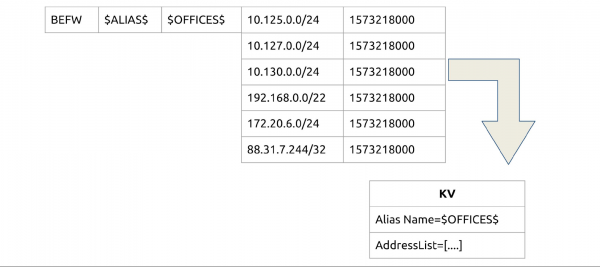
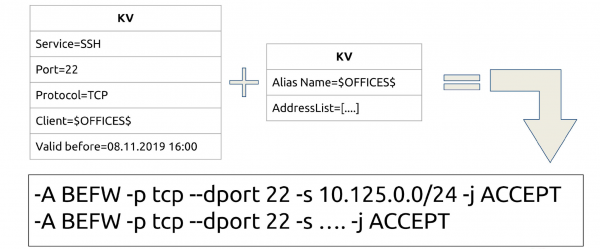
Forbindelser: nu kan vi åbne SSH ikke specifikt på P2P, men til en hel gruppe eller flere grupper. På samme måde er der TTL - man kan midlertidigt tilføje eller fjerne medlemmer fra gruppen.
Integration
Vores problem - det menneskelige element og automatisering. Indtil videre har vi løst det sådan.
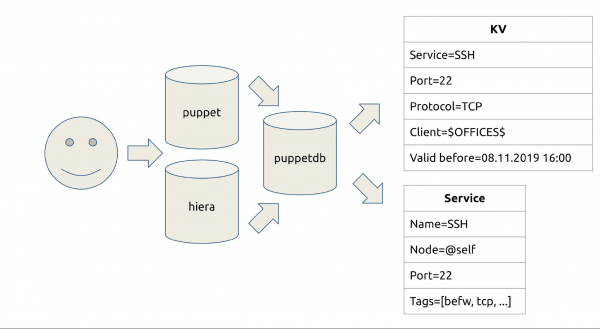
Vi arbejder med Puppet og overfører alt, der vedrører systemet (applikationskode). I puppetdb (almindelig PostgreSQL) opbevares en liste over de tjenester, der kører dér, som kan findes efter ressource-type. Her kan man også finde ud af, hvem der henvender sig til hvem. Vi har også et system for pull request og merge request til dette.
Vi har skrevet befw-sync — en simpel løsning, der hjælper med at overføre data. Først henvender sync cookies sig til puppetdb. Der er opsat et HTTP API: vi spørger, hvilke tjenester vi har, og hvad der skal gøres. Derefter foretages en anmodning til Consul.
Er der en integration? Ja: vi har skrevet regler, der tillader at acceptere Pull Requests. Skal der være en port eller tilføje en vært til en bestemt gruppe? Pull Request, review — ikke flere «Find 200 andre ACL'er og prøv at gøre noget med det».
Optimering
Ping til localhost med en tom regelkæde tager 0,075 ms.
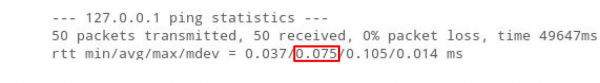
Vi tilføjer 10.000 adresser til iptables i denne kæde. Som et resultat vil ping stige 5 gange: iptables er helt lineært, behandlingen af hver adresse tager noget tid.
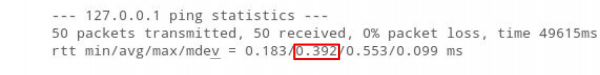
For den firewall, som vi migrerer tusindvis af ACL'er til, har vi mange regler, og det medfører forsinkelse. Det er dårligt for spileprotokoller.
Men hvis vi placerer 10.000 adresser i ipset , vil ping endda falde.
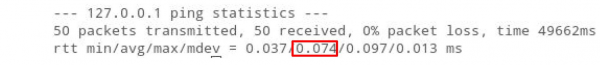
Pointen er, at «O» (algoritmens kompleksitet) for ipset altid er 1, uanset hvor mange regler der er. Dog er der en grænse — der kan ikke være mere end 65535 regler. Indtil videre lever vi med det: vi kan kombinere dem, udvide dem og lave to ipset i én.
Lagring
En logisk fortsættelse af iterasjonsprocessen er at opbevare information om kunderne til tjenesten i ipset.
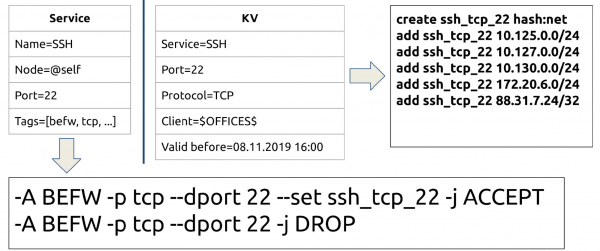
Nu har vi den samme SSH, og vi skriver ikke blot 100 IP'er med det samme, men angiver navnet på ipset, som vi skal kommunikere med, og den næste regel DROP. Det kan gøres til én regel «Den, der ikke er her, bliver DROP», men det er mere overskueligt sådan.
Nu har vi regler og sæt. Hovedopgaven er at lave sættet, inden vi skriver reglen, for ellers vil iptables ikke registrere reglen.
Generelt skema
Som en skitse ser alt, hvad jeg har fortalt, således ud.
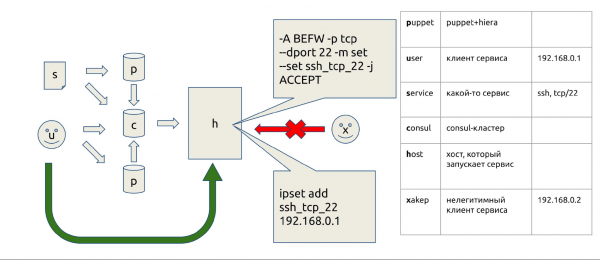
Vi committer til Puppet, alt sendes til værten, tjenesterne er her, ipset der, og dem, der ikke er registreret der, får ikke adgang.
Allow & deny
For hurtigt at redde verden eller hurtigt at koble nogen fra har vi lavet to ipset i begyndelsen af alle kæder: rules_allow og rules_deny. Hvordan fungerer det?
For example, someone creates a load on our Web using bots. In the past, it was necessary to find their IP from logs, report it to network engineers to trace the traffic source, and ban it. Now it looks different.
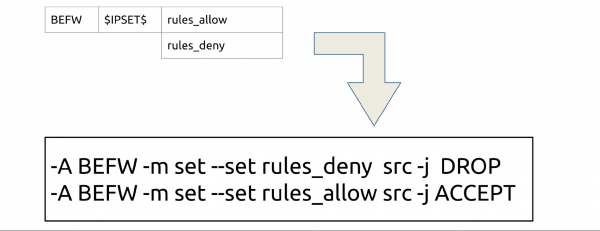
We send to Consul, wait 2.5 seconds, and it's done. Since Consul quickly distributes the load via P2P, it works everywhere, in any part of the world.
Once, I completely stopped WOT by mistakenly configuring the firewall. rules_allow — this is our insurance against such cases. If we mistakenly configure the firewall somewhere and something gets blocked, we can always send a conditional 0.0/0, to quickly bring everything back up. We can fix everything manually later.
Other sets
You can add any other sets in the space $IPSETS$.
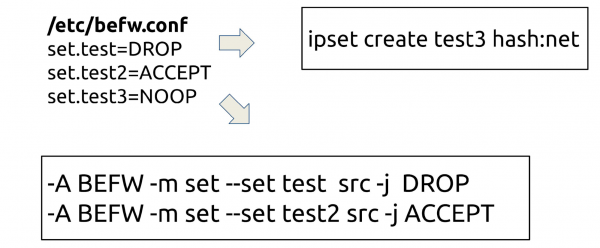
Why? Sometimes someone needs ipset, for example, to emulate turning off some part of the cluster. Anyone can bring any sets, name them, and they will be fetched from Consul. At the same time, sets can participate in iptables rules or act as a command. NOOP: consistency will be maintained by the daemon.
Brugere
It used to be: the user connected to the network and received parameters through the domain. Before the advent of next-gen firewalls, Cisco couldn't understand where the user was and where the IP was. Therefore, access was only granted via the hostname of the machine.
What did we do? We intervened at the point of address retrieval. Usually, this is dot1x, Wi-Fi, or VPN — everything goes through RADIUS. For each user, we create a group named after the user and place the IP in it with a TTL equal to their dhcp.lease — as soon as it expires, the rule disappears.
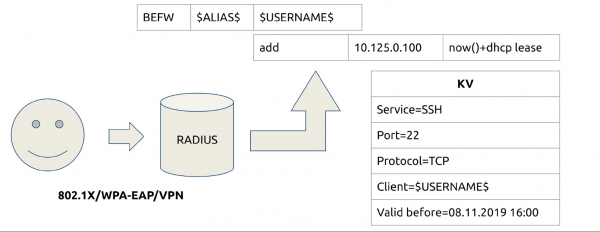
Now we can open access to services, like in other groups, by username. We eliminated the pain of hostname changes and relieved network engineers since they no longer require Cisco. Now the engineers configure access on their servers themselves.
Isolation
Meanwhile, we started addressing isolation. Service managers conducted an inventory, and we analyzed all our networks. We will break them into similar groups and added them, for example, to deny on the necessary servers. Now the same staging isolation goes into rules_deny of production but not into production itself.
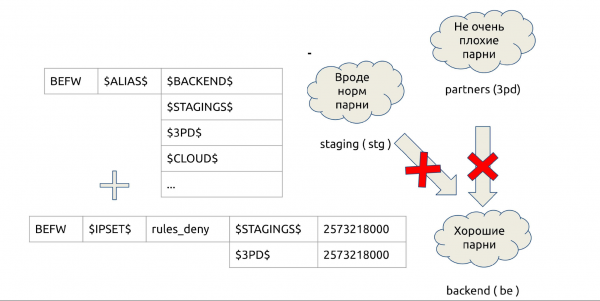
The scheme works quickly and simply: we remove all ACLs from servers, unload the hardware, and reduce the number of isolated VLANs.
Integrity control
Tidligere havde vi en speciel trigger, der gav besked, når nogen manuelt ændrede firewallreglerne. Jeg skrev en enorm linter til kontrol af firewallregler, det var besværligt. Nu opretholder BEFW integriteten. Den holder nøje øje med, at de regler, den angiver, ikke ændres. Hvis nogen ændrer firewallreglerne, vil den bringe alt tilbage. "Jeg satte hurtigt en proxy op for at arbejde hjemmefra" — sådan nogle muligheder findes ikke længere.
BEFW overvåger ipset fra tjenesterne og listen i befw.conf, service reglerne i BEFW-kæden. Men den overvåger ikke andre kæder og regler samt andre ipset.
Beskyttelse mod nedbrud
BEFW gemmer altid den sidste succesfulde tilstand direkte i den binære struktur state.bin. Hvis noget går galt, vil den altid gå tilbage til denne state.bin.
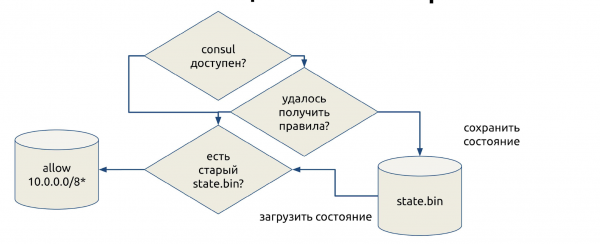
Dette er en sikkerhed mod ustabil drift af Consul, når den ikke har sendt data eller nogen har lavet en fejl og brugt regler, der ikke kan anvendes. For at vi ikke står uden en firewall, vil BEFW gå tilbage til den sidste tilstand, hvis der opstår en fejl på et tidspunkt.
I kritiske situationer er dette en garanti for, at vi forbliver med en fungerende firewall. Vi åbner alle grå netværk i håbet om, at administrationen kommer og reparerer det. En dag vil jeg inkludere dette i konfigurationerne, men lige nu har vi simpelthen tre grå netværk: 10/8, 172/12 og 192.168/16. Inden for vores Consul er dette en vigtig funktion, der hjælper os med at udvikle os videre.
Demo: under præsentationen viser Ivan demo-tilstanden for BEFW. Det er nemmere at se demonstrationen på . Kildeteksten til demoen er tilgængelig .
Faldgruber
Jeg vil fortælle om de fejl, vi stødte på.
ipset add set 0.0.0.0/0. Hvad sker der, hvis man tilføjer 0.0.0.0/0 til ipset? Bliver alle IP’er tilføjet? Åbner der adgang til internettet?
Nej, vi får en fejl, der kostede os to timers nedetid. Desuden har fejlen ikke fungeret siden 2016, og den ligger i RedHat Bugzilla under nummer #1297092, og vi fandt den tilfældigt — fra udviklerens rapport.
Nu er der i BEFW en streng regel om, at 0.0.0.0/0 bliver til to adresser: 0.0.0.0/1 og 128.0.0.0/1.
ipset restore set < file. Hvad gør ipset, når du siger til den restore? Вы думаете, он работает также, как iptables? Восстановит данные?
Ikke noget lignende — den laver en sammenlægning, og de gamle adresser forsvinder ikke, du lukker ikke adgangen.
Vi fandt fejlen, mens vi testede isolation. Nu er der et ret komplekst system — i stedet for restore udarbejdes create temp, derefter restore flush temp og restore temp. Til slut swap: for atomaritet, fordi hvis man først laver flush Og på det tidspunkt vil en eller anden pakke komme, og den vil blive afvist, og noget vil gå galt. Derfor er der lidt sort magi.
consul kv get -datacenter=other. Som jeg allerede har nævnt, tror vi, at vi anmoder om nogle data, men vi vil enten få data eller en fejl. Vi kan gøre dette lokalt gennem Consul, men selv i dette tilfælde vil begge dele fryse.
Den lokale Consul-kl client er et lag over HTTP API'et. Men den fryser bare og svarer ikke på Ctrl+C, Ctrl+Z eller noget som helst, kun på kill -9 i den tilstødende konsol. Vi stødte på dette, da vi byggede et stort cluster. Men vi har ikke nogen løsning endnu; vi forbereder os på at rette denne fejl i Consul.
Consul-lederen svarer ikke. Vores master i datacentre svarer ikke, vi tænker: "Måske vil valgalgoritmen nu træde i kraft?"
Nej, det vil ikke ske, og overvågningen vil ikke vise noget: Consul vil sige, at commit-indekset eksisterer, lederen er fundet, alt er godt.
Hvordan kæmper vi med dette? service consul restart i cron hver time. Hvis du har 50 servere, er det ikke skræmmende. Når du har 16.000, vil du forstå, hvordan det fungerer.
Konklusion
I sidste ende har vi opnået følgende fordele:
- 100% dækning af alle Linux-maskiner.
- Hastighed.
- Automation.
- Vi har befriet hardware og netværksingeniører fra slaveri.
- Mulighederne for integration, der er næsten grænseløse: enten med Kubernetes, Ansible eller Python.
Ulemper: Consul, som vi nu skal leve med, og den høje pris på fejl. Som eksempel, en gang i 18-tiden (primetime i Rusland) ændrede jeg noget i netværkslisterne. Vi byggede netop isolation på BEFW. Jeg lavede et eller andet forkert, ser ud til, at jeg angav den forkerte maske, men alt gik ned på to sekunder. Overvågningen lyser op, supportkonsulenten kommer løbende: "Alt ligger nede!" Afdelingslederen blev gråhåret, da han forklarede forretningen, hvorfor det skete.
Fejlen har så høj en pris, at vi har udviklet vores egen komplekse forebyggelsesprocedure. Hvis du implementerer dette i en stor produktion, skal du ikke give master-tokenet over Consul til alle. Det vil ende dårligt.
Omkostninger. Jeg har skrevet kode i 400 timer alene. Min supportteam på 4 personer bruger 10 timer om måneden på alles support. Sammenlignet med prisen på enhver ny generation af firewall er det gratis.
Planer. Den langsigtede plan er at finde en alternativ transport i stedet for eller som supplement til Consul. Det kunne være Kafka eller noget lignende. Men i de kommende år vil vi leve med Consul.
Næste planer: integration med Fail2ban, med overvågning, med nftables, muligvis med andre distributioner, metrics, udvidet overvågning, optimering. Støtte til Kubernetes er også et sted i planerne, fordi vi i øjeblikket har flere klynger og lyst.
Andre planer inkluderer:
- opdagelse af anomalier i trafikken;
- håndtering af netværkskort;
- støtte til Kubernetes;
- pakket bygning for alle systemer;
- Web-UI.
Vi arbejder konstant på at udvide konfigurationen, øge metrics og optimere.
Deltag i projektet. Projektet er blevet fantastisk, men desværre er det stadig et projekt for én person. Kom og og prøv at gøre noget: commit, teste, foreslå noget, give din feedback.
I mellemtiden forbereder vi os på , som finder sted den 6. og 7. april i Sankt Petersborg, og vi inviterer udviklere af højtydende systemer . Erfarne talere ved allerede, hvad de skal gøre, mens vi anbefaler nybegyndere i oplæg at i det mindste . Deltagelse i konferencen som taler har en række fordele. Hvilke kan du læse om i slutningen af .
Kilde: habr.com
