

Hej, Habr.
Jeg hedder Misha Butrimov, og jeg vil gerne fortælle lidt om Cassandra. Min fortælling vil være nyttig for dem, der aldrig har stiftet bekendtskab med NoSQL-databaser, da der er mange implementing kendetegn og faldgruber, man skal være opmærksom på. Og hvis du kun har set Oracle eller en hvilken som helst anden relationsdatabase, vil disse ting redde dit liv.
Hvad er godt ved Cassandra? Det er en NoSQL-database, designet uden et enkelt fejlpunk, som skalerer godt. Hvis du har brug for at tilføje et par terabyte til en database, tilføjer du simpelthen noder til ringen. Vil du udvide den til endnu et datacenter? Tilføjer noder til klyngen. Vil du øge den behandlede RPS? Tilføjer noder til klyngen. Det fungerer også på den anden måde.
Hvad er den anden fordel? At kunne håndtere mange forespørgsler. Men mange — hvor mange er det? 10, 20, 30, 40 tusinde forespørgsler i sekundet — det er lidt. 100 tusinde forespørgsler i sekundet på skrivning — det er også lidt. Der er virksomheder, der siger, at de holder 2 millioner forespørgsler i sekundet. Det må man nok tro på.
Og grundlæggende har Cassandra en stor forskel fra relationelle data — den ligner overhovedet ikke dem. Og det er meget vigtigt at huske.
Ikke alt, der ser ens ud, fungerer ens.
En gang kom en kollega til mig og spurgte: „Her er SQL Cassandra query language, og det har en select statement, der har where, og den har and. Jeg skriver bogstaver, og det fungerer ikke. Hvorfor?“. Hvis man forholder sig til Cassandra som en relationsdatabase, er det den perfekte måde at afslutte sit liv på en brutal måde. Og jeg fremmer ikke det, det er forbudt i Rusland. Du vil bare designe noget forkert.
For eksempel kommer en kunde til os og siger: „Lad os bygge en database til tv-serier, eller en database til en opskriftsguide. Vi vil have retter med ingredienser eller en liste over tv-serier og skuespillere i dem“. Vi svarer glædeligt: „Lad os gøre det!“. Det er to bytes at sende, et par tabeller, og så er alt klar, det vil fungere meget hurtigt og pålideligt. Og alt er perfekt, indtil kunderne kommer og siger, at husholdningerne også løser den omvendte opgave: de har en liste over ingredienser, og de vil vide, hvilken ret de ønsker at lave. Du er færdig.
Altogether, it is because Cassandra is a hybrid database: it acts as both a key-value store and stores data in wide columns. In Java or Kotlin terms, it could be described like this:
Map<RowKey, SortedMap>
This means a map that contains another sorted map inside. The first key to this map is the Row key or Partition key — the partitioning key. The second key, which is the key to the already sorted map, is the Clustering key.
To illustrate the distributed nature of the database, let's draw three nodes. Now we need to understand how to distribute the data across the nodes. Because if we shove everything into one (and there can be a thousand, two thousand, five — as many as you want), that doesn't really represent distribution. So we need a mathematical function that returns a number. Just a number, a long int, that will fall within some range. One node will be responsible for one range, the second for another, the n-th for the n-th.
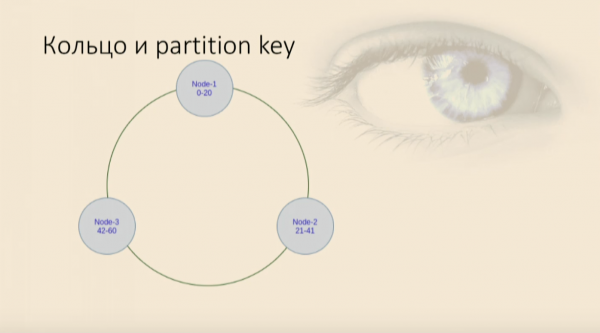
This number is obtained using a hash function, which is applied precisely to what we call the Partition key. This is the column specified in the Primary key directive, and this is the column that will be the primary and most significant key of the map. It determines which data will go to which node. A table in Cassandra is created almost with the same syntax as in SQL:
CREATE TABLE users (
	user_id uuid,
	name text,
	year int,
	salary float,
	PRIMARY KEY(user_id)

)
In this case, the Primary key consists of a single column, which is also the partitioning key.
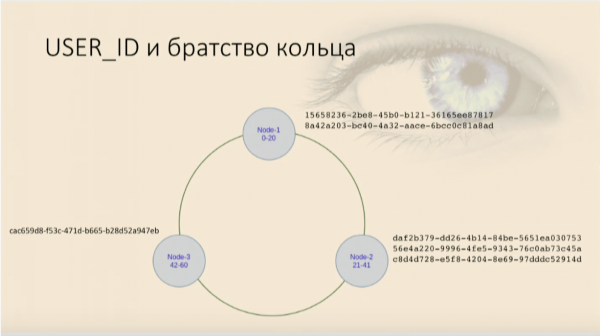
How will our users be arranged? Some will go to one node, some to another, and some to the third. This results in a regular hash table, also known as a map, or in Python — a dictionary, or a simple key-value structure from which we can read all values, read and write by key.
Select: when allow filtering turns into a full scan, or how not to do it
Let's write some select statement: select * from users where userid = . Det virker næsten som i Oracle: vi skriver select, angiver betingelserne, og alt fungerer, brugerne hentes. Men hvis vi vælger en bruger med et bestemt fødselsår, klager Cassandra over, at den ikke kan udføre forespørgslen. Fordi den overhovedet ikke ved noget om, hvordan vores data om fødselsår er fordelt - den har kun én kolonne angivet som nøgle. Så siger den: «Okay, jeg kan stadig udføre denne forespørgsel. Tilføj allow filtering». Vi tilføjer direktivet, alt fungerer. Og på dette tidspunkt sker der noget skræmmende.
Når vi kører på testdata, fungerer alt perfekt. Men når du udfører en forespørgsel i produktionen, hvor vi har for eksempel 4 millioner poster, så fungerer det ikke så godt. Fordi allow filtering - det er et direktiv, der tillader Cassandra at samle alle data fra denne tabel fra alle noder, alle datacentre (hvis der er mange i denne klynge), og kun derefter filtrere. Det er analogt med en Full Scan, og næppe nogen er begejstrede for det.
Hvis vi kun havde brug for brugere efter identifikatorer, ville det være acceptabelt. Men nogle gange skal vi skrive andre forespørgsler og pålægge andre begrænsninger på udvælgelsen. Så vi husker: dette er alle vores mappe, som har en partitioneringsnøgle, men inde i den - en sorteret mappe.
Og den har også en nøgle, som vi kalder Clustering Key. Denne nøgle består af de kolonner, vi vælger, som gør det muligt for Cassandra at forstå, hvordan dens data fysisk skal sorteres og opbevares på hver node. Det vil sige, for en bestemt Partition key vil Clustering key fortælle, hvordan dataene skal placeres i dette træ, hvilket plads de vil tage.
Det er et rigtigt træ, der bare kalder en komparator, hvor vi sender et sæt kolonner som et objekt, og det angives også som et opregnet sæt kolonner.
CREATE TABLE users_by_year_salary_id (
	user_id uuid,
	name text,
	year int,
	salary float,
	PRIMARY KEY((year), salary, user_id)
Vær opmærksom på direktivet Primary key, hvor den første parameter (i vores tilfælde året) altid er partition key. Den kan bestå af en eller flere kolonner; det er ikke vigtigt. Hvis der er flere kolonner, skal de placeres i parentes for at preprocessoren for sproget kan forstå, at dette er Primary key, efterfulgt af de øvrige kolonner — Clustering key. Disse vil således bliver sendt i comparator i den rækkefølge, de optræder. Det vil sige, at den første kolonne er mere betydningsfuld, den anden mindre betydningsfuld osv. Ligesom vi for data classes skriver, for eksempel, felterne equals: vi angiver felterne og præciserer, hvilke der er større, og hvilke der er mindre. I Cassandra er dette, betinget set, felterne i data class, som den skrevne equals vil blive anvendt på.
Vi angiver sortering og pålægger betingelser.
Det er vigtigt at huske, at sorteringsrækkefølgen (faldende, stigende, ligegyldigt) angives på samme tid som nøglen oprettes, og det kan ikke ændres senere. Dette bestemmer fysisk, hvordan data vil blive sorteret og hvordan de vil være opdelt. Hvis det bliver nødvendigt at ændre Clustering key eller sorteringsrækkefølge, skal der oprettes en ny tabel og data skal overføres til denne. Det vil ikke kunne gøres med en allerede eksisterende.
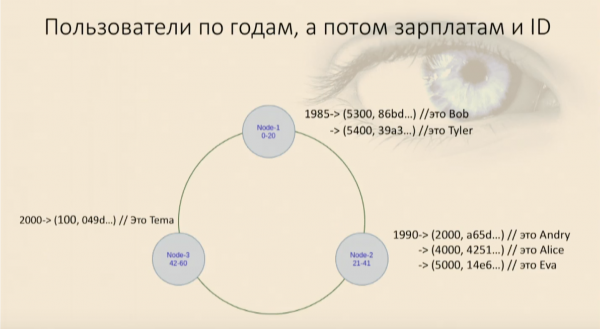
Vi har fyldt vores tabel med brugere og set, at de ligger i en ring først efter fødselsår, og derefter inden for hver node efter løn og bruger-ID. Nu kan vi vælge, mens vi pålægger betingelser.
Vores fungerende hvor, og, og vi får brugerne, og alt er godt igen. Men hvis vi prøver at bruge kun en del af Clustering key, som er mindre betydningsfuld, vil Cassandra straks brokke sig og sige, at den ikke kan finde stedet i vores map, hvor den objekt, der har disse felter for comparator null, og denne, som lige er blevet angivet, — hvor den ligger. Jeg bliver nødt til igen at hente alle data fra denne node og filtrere dem. Og dette svarer til en Full Scan inden for noden, hvilket er dårligt.
I enhver uklar situation, opret en ny tabel.
Hvis vi ønsker at kunne hente brugere efter ID, alder eller løn, hvad gør vi så? Intet. Bare brug to tabeller. Hvis vi skal kunne hente brugere på tre forskellige måder, bliver der tre tabeller. De dage, hvor vi sparemæssigt vurderede plads på harddisken, er ovre. Det er den billigste ressource. Det koster meget mindre end svartiden, som kan være skadelig for brugeren. Det er meget mere behageligt for brugeren at få noget på et sekund end på 10 minutter.
Vi bytter det overskydende optagede plads, den denormaliserede data for muligheden for godt at skalere og arbejde pålideligt. For i virkeligheden kan et cluster bestående af tre datacentre, hvoraf hver har fem noder, ved acceptabel databevaringsniveau (når der bestemt ikke går noget tabt), overleve ødelæggelsen af et datacenter helt. Og derudover to noder i hver af de to resterende. Først herefter vil der opstå problemer. Det er en ret god reserveløsning, som koster et par ekstra SSD-drev og processorer. Derfor, for at kunne bruge Cassandra, som ikke er SQL, der ikke har relationer eller fremmednøgler, er det nødvendigt at kende simple regler.
Vi designer alt ud fra forespørgslen. Hovedfokus er ikke dataene, men hvordan applikationen skal arbejde med dem. Hvis den har brug for at hente forskellige data på forskellige måder eller de samme data på forskellige måder, skal vi arrangere dem på en måde, der er praktisk for applikationen. Ellers vil vi ende i Full Scan, og Cassandra vil ikke give os nogen fordel.
At denormalisere data er en norm. Vi glemmer de normale former; vi har ikke længere relationelle databaser. Vi kan placere noget 100 gange, og det vil være der 100 gange. Det er stadig billigere end at stoppe op.
Vi vælger nøgler til partitionering, så de fordeles ordentligt. Vi ønsker ikke, at hashen fra vores nøgler falder i et snævert interval. Med andre ord, fødselsåret i ovenstående eksempel - det er et dårligt eksempel. Det vil sige, det er godt, hvis vi har brugere, der er jævnt fordelt efter fødselsår, og dårligt, hvis det drejer sig om 5. klasses elever - der vil det ikke være meget godt at partitionere.
Sorteringen vælges én gang under oprettelsen af Clustering Key. Hvis den skal ændres, skal vi omstrukturere vores tabel med en anden nøgle.
Og det vigtigste: hvis vi har brug for at hente de samme data på 100 forskellige måder, så vil vi have 100 forskellige tabeller.
Kilde: habr.com
