

Denne artikel handler om Python Gateway — et community-projekt med åbent kildekode til InterSystems IRIS dataplatform. Dette projekt gør det muligt at orkestrere alle maskinlæringsalgoritmer, der er skrevet i Python (den primære platform for mange dataforskere), og anvende mange færdige biblioteker til hurtigt at skabe adaptive, robotiserede analytiske AI/ML-løsninger på InterSystems IRIS-platformen. I denne artikel vil jeg vise, hvordan InterSystems IRIS kan orkestrere processer i Python, effektivt muliggøre tovejs dataoverførsel og skabe intelligente forretningsprocesser.
Plan
- Introduktion.
- Værktøjer.
- Installation.
- API.
- Interoperabilitet.
- Jupyter Notebook.
- Konklusioner.
- Links.
- MLToolkit.
Introduktion
Python er et høj-niveau programmeringssprog for almindelig brug, der fokuserer på at forbedre udviklerens produktivitet og læsbarheden af koden. I denne serie af artikler vil jeg tale om anvendelsesmulighederne for Python på InterSystems IRIS-platformen, hvor denne artikel har fokus på anvendelsen af Python som sprog for oprettelse og brug af maskinlæringsmodeller.
Maskinlæring (ML) er en klasse af metoder inden for kunstig intelligens, hvor kendetegnet ikke er direkte løsning på opgaver, men læring ved at løse mange lignende opgaver.
Algoritmer og modeller for maskinlæring bliver stadig mere udbredte. Der er mange grunde til dette, men det hele kommer ned til tilgængelighed, enkelhed og opnåelse af praktiske resultater. Er clustering eller endda neuralt netværksmodellering en ny teknologi?
Selvfølgelig ikke, men i øjeblikket er der ikke behov for at skrive hundredtusindvis af linjer kode for at køre en model, og omkostningerne ved at oprette og anvende modeller bliver mindre og mindre.
Værktøjerne udvikler sig — selvom vi ikke har fuldt GUI-orienterede AI/ML-værktøjer, observerer vi den samme udvikling som set med mange andre klasser af informationssystemer, såsom BI (fra kode til brug af frameworks og GUI-orienterede konfigurerbare løsninger), der også ses i værktøjer til oprettelse af AI/ML. Vi er allerede forbi kode-skrivningsfasen og bruger i dag frameworks til at opbygge og træne modeller.
Andre forbedringer, såsom muligheden for at distribuere fortrænede modeller, når slutbrugeren bare skal afslutte træningen af modellen på sine specifikke data, gør det også lettere at komme i gang med maskinlæring. Disse fremskridt letter betydeligt læringen af maskinlæring både direkte for specialister og for virksomheder generelt.
På den anden side samler vi flere og flere data. Takket være en samlet dataplatform som InterSystems IRIS kan al denne information straks forberedes og anvendes som inputdata til maskinlæringsmodeller.
Med overgangen til cloud bliver lanceringen af AI/ML-projekter lettere end nogensinde. Vi kan kun forbruge de ressourcer, vi har brug for. Desuden, takket være paralleliseringen, der tilbydes af cloudplatforme, kan vi spare tid.
Men hvordan står det til med resultaterne? Her bliver det mere kompliceret. Der findes mange værktøjer til at bygge modeller, som jeg vil tale om senere. At bygge en god model er ikke enkelt, men hvad så? At få afkast af at bruge modellen i virksomheden er også en ikke-triviel opgave. Problemet ligger i adskillelsen af analytiske og transaktionelle belastninger samt datamodeller. Når vi træner en model, gør vi det typisk på historiske data. Men en bygget models plads er i den transaktionelle databehandling. Hvad nytter det at have den bedste model til at opdage svigagtige transaktioner, hvis vi kun kører den én gang om dagen? Svindlerne er allerede forsvundet med pengene. Vi skal træne modellen på historiske data, men vi skal også anvende den i realtid på nye indkommende data, så vores forretningsprocesser kan handle i overensstemmelse med de forudsigelser, modellen laver.
ML Toolkit er et sæt værktøjer, hvis mål er netop dette: at forene modeller og den transaktionelle miljø, så de byggede modeller nemt kan anvendes direkte i dine forretningsprocesser. Python Gateway er en del af ML Toolkit og sikrer integration med Python-sproget (ligesom R Gateway, der er en del af ML Toolkit, sikrer integration med R-sproget).
Værktøjer
Før vi fortsætter, vil jeg gerne beskrive nogle værktøjer og biblioteker til Python, som vi senere vil bruge.
Teknologier
- Python er et fortolket, højniveau programmeringssprog til generelle formål. Den primære fordel ved sproget er det store bibliotek af matematiske, ML- og AI-biblioteker. Ligesom ObjectScript er det et objektorienteret sprog, men alt defineres dynamisk og ikke statisk. Alt er også et objekt. Senere artikler forudsætter en overfladisk bekendtskab med sproget. Hvis du ønsker at starte med at lære, anbefaler jeg at begynde med .
- For vores næste øvelser skal du installere .
- IDE: Jeg bruger , men generelt er der også . Hvis du bruger Atelier, findes der en Eclipse-plugin til Python-udviklere. Hvis du bruger VS Code, findes der en udvidelse til Python.
- Notebook: I stedet for et IDE kan du skrive og dele dine scripts i online-notebooks. Den mest populære er .
Biblioteker
Her er en (ikke-udtømmende) liste over biblioteker til maskinlæring:
- — den fundamentale pakke til præcise beregninger.
- — højtydende datastrukturer og datanalyseværktøjer.
- — til graftegning.
- — datavisualisering baseret på matplotlib.
- — metoder til maskinlæring.
- — algoritmer til maskinlæring inden for gradient boosting-metodologi.
- — NLP.
- — neurale netværk.
- — en platform til at bygge modeller til maskinlæring.
- — en platform til at bygge modeller til maskinlæring, der er fokuseret på Python.
- — PMML fra forskellige modeller.
AI/ML-teknologier gør det muligt at gøre forretningen mere effektiv og tilpasningsdygtig. Desuden bliver disse teknologier i dag lettere at udvikle og implementere. Begynd at lære AI/ML-teknologier og hvordan de kan hjælpe din organisation med at vokse.
Installation
Der er flere måder at installere og bruge Python Gateway på:
- OS
- Windows
- Linux
- Mac
- Docker
- Brug et billede fra DockerHub
- Opret dit eget billede
Uanset hvilken installationsmetode du vælger, skal du bruge kildekoden. Det eneste sted at downloade koden er . Den indeholder testede stabile versioner, så tag bare den nyeste. I øjeblikket er det 0.8, men der vil komme nye versioner over tid. Klon eller upload ikke opbevaringen, download den seneste udgivelse.
OS
Hvis du installerer Python Gateway på operativsystemet, skal du først (uanset operativsystemet) installere Python. For dette:
- . Det anbefales at installere Python i standardmappen.
- Installer modulet
dill:pip install dill. - Download ObjectScript-koden (dvs.
do $system.OBJ.ImportDir("C:InterSystemsReposPythoniscpy", "*.cls", "c",,1)) til enhver namespace med produkter. Hvis du ønsker, at den eksisterende namespace skal understøtte produkter, skal du udføre:write ##class(%EnsembleMgr).EnableNamespace($Namespace, 1). - Placér til mappen
bindin Instance af InterSystems IRIS. Biblioteksfilen skal være tilgængelig på stien, der returnereswrite ##class(isc.py.Callout).GetLib().
Windows
- Sørg for, at miljøvariablen
PYTHONHOMEpeger på Python 3.6.7. - Sørg for, at systemmiljøvariablen
PATHindeholder variablenPYTHONHOME(eller den mappe, den peger på).
Linux (Debian/Ubuntu)
- Kontrollér hermed, at miljøvariablen
PATHindeholder/usr/libog/usr/lib/x86_64-linux-gnu. Brug filen/etc/environmenttil at indstille miljøvariabler. - I tilfælde af fejl
undefined symbol: _Py_TrueStructskal du indstille parameterenPythonLib. Derudover er der en sektion til fejlfinding.
Mac
- I øjeblikket understøttes kun Python 3.6.7 fra . Kontroller variablen
PATH.
Hvis du har ændret miljøvariabler, skal du genstarte dit produkt InterSystems.
Docker
Brugen af containere har flere fordele:
- Bærbarhed
- Effektivitet
- Isolation
- Letvægts
- Immutabilitet
Tag et kig på denne for mere information om brugen af Docker med InterSystems-produkter.
Alle builds af Python Gateway er i øjeblikket baseret på containere. 2019.4.
Klar billede
Udfør: docker run -d -p 52773:52773 --name irispy intersystemscommunity/irispy-community:latest, for at downloade og starte Python Gateway med InterSystems IRIS Community Edition. Det er det hele.
Opret dit eget billede
For at bygge docker-billedet skal du udføre i rodmappen af dit repository: docker build --force-rm --tag intersystemscommunity/irispy:latest ..
Som standard bygges billedet baseret på billedet store/intersystems/iris-community:2019.4.0.383.0, men du kan ændre dette ved at indstille variablen IMAGE.
For at bygge fra InterSystems IRIS skal du udføre: `docker build —build-arg IMAGE=store/intersystems/iris:2019.4.0.383.0 —force-rm —tag intersystemscommunity/irispy:latest`.
Derefter kan du starte docker-billedet:
docker run -d
  -p 52773:52773
  -v //:/mount
  --name irispy
  intersystemscommunity/irispy:latest
  --key /mount/iris.key
Hvis du bruger et billede baseret på InterSystems IRIS Community Edition, skal du muligvis ikke angive nøglen.
Comments
- Testprocessen
isc.py.test.Processgemmer en række billeder i en midlertidig mappe. Du vil muligvis ændre denne sti til en monteret mappe. For at gøre dette skal du redigere indstillingenWorkingDirved at angive den monterede mappe. - For at få adgang til terminalen skal du køre:
docker exec -it irispy sh. - Adgang til System Management Portal med login
SuperUser/SYS. - For at stoppe containeren, kør:
docker stop irispy && docker rm --force irispy.
Tjek installationen
Når du har installeret Python Gateway, er det en god idé at kontrollere, om den fungerer. Kør denne kode i terminalen InterSystems IRIS:
set sc = ##class(isc.py.Callout).Setup()
set sc = ##class(isc.py.Main).SimpleString("x='HELLO'", "x", , .var).
write var
Resultatet skal være HELLO — værdien af Python-variablen x. Hvis den returnerede status sc er en fejl eller var tom, skal du kontrollere .
API
Python Gateway er installeret, og du har bekræftet, at den fungerer. Det er tid til at begynde at bruge den!
Hovedgrænsefladen til Python er isc.py.Main. Den tilbyder følgende grupper af metoder (alle returnerer %Status):
- Udførelse af kode
- Overførsel af data
- Hjælpemidler
Udførelse af kode
Disse metoder giver mulighed for at udføre vilkårlig Python-kode.
SimpleString
SimpleString — er den primære metode. Den accepterer 4 valgfrie argumenter:
code— koden der skal udføres. Linjeskift:$c(10).returnVariable— navnet på variablen til retur.serialization— hvordan der skal serialiseres.returnVariable. 0 — string (standard), 1 — repr.resultat— ByRef reference til variablen, hvor værdien skrivesreturnVariable.
Ovenfor har vi udført:
set sc = ##class(isc.py.Main).SimpleString("x='HELLO'", "x", , .var).I dette eksempel tildeler vi Python-variablen x værdien Hej og ønsker at returnere værdien af Python-variablen x til ObjectScript-variablen var.
ExecuteCode
ExecuteCode er et mere sikkert og mindre begrænset alternativ SimpleString.
Strenge i InterSystems IRIS-platformen er begrænset til 3.641.144 tegn, og hvis du vil udføre en længere kode, skal du bruge streams.
Det accepterer to argumenter:
code— en streng eller stream af Python-kode til udførelse.variable— (valgfrit) tildeler resultatet af udførelsencodetil denne Python-variabel.
Brug eksempel:
set sc = ##class(isc.py.Main).ExecuteCode("2*3", "y").I dette eksempel multiplicerer vi 2 med 3 og gemmer resultatet i Python-variablen y.
Overførsel af data
Overfør data til Python og tilbage.
Python -> InterSystems IRIS
Der er 4 måder at få værdien af en Python-variabel i InterSystems IRIS, afhængigt af den serialisering, du har brug for:
Strengtil simple datatyper og debugging.Reprtil opbevaring af enkle objekter og debugging.JSONtil let manipulation af data på InterSystems IRIS siden.Pickletil gemme objekter.
Disse metoder gør det muligt at hente variabler fra Python som strenge eller streams.
GetVariable(variable, serialization, .stream, useString)— hentserializationvariabelvariableistream. HvisuseStringer lig med 1, og serialiseringen placeres i en streng, så returneres en streng og ikke en stream.GetVariableJson(variable, .stream, useString)— hent JSON serialiseringen af variabel.GetVariablePickle(variable, .stream, useString, useDill)- hent Pickle (eller Dill) serialiseringen af variabel.
Lad os prøve at hente vores variabel y.
set sc = ##class(isc.py.Main).GetVariable("y", , .val, 1)
write val
>6
InterSystems IRIS -> Python
Vi læser data fra InterSystems IRIS til Python.
ExecuteQuery(query, variable, type, namespace)— opretter et datasæt (pandasdataframeellerlist) fra SQL-forespørgslen og sætter det i Python-variabel.variable. Pakkenisc.pyskal være tilgængelig i domænetnamespace— der hvor forespørgslen vil blive udført.ExecuteGlobal(global, variable, type, start, end, mask, labels, namespace)— indlæser data fra globalenglobalfra delindeksetstartop tilendtil Python som en variabel af typentype:list, eller pandasdataframe. Beskrivelsen af de valgfrie argumentermaskoglabelser tilgængelig i klassedokumentationen og i depotet .ExecuteClass(class, variable, type, start, end, properties, namespace)— indlæser data fra klassenklassefra idstartop tilendtil Python som en variabel af typentype:list, eller pandasdataframe.properties— en liste (adskilt af komma) af klasseegenskaber, som skal indlæses i datasættet. Masker understøttes.*og?. Som standard —*(alle egenskaber). Egenskaben%%CLASSNAMEignoreres.ExecuteTable(table, variable, type, start, end, properties, namespace)— indlæser data fra tabellentablefra idstartop tilendtil Python.
ExecuteQuery — er universel (enhver gyldig SQL-forespørgsel vil blive sendt til Python). Men, ExecuteGlobal og dens wrappers ExecuteClass og ExecuteTable har en række begrænsninger. De er meget hurtigere (3-5 gange hurtigere end ODBC-driveren og 20 gange hurtigere ExecuteQuery). Yderligere information i .
Alle disse metoder understøtter dataoverførsel fra ethvert domæne. Pakken isc.py skal være tilgængelig i det målrettede domæne.
ExecuteQuery
ExecuteQuery(request, variable, type, namespace) — overførsel af resultaterne af enhver gyldig SQL-forespørgsel til Python. Dette er den langsomste metode til dataoverførsel. Brug den, hvis ExecuteGlobal og dens wrappers ikke er tilgængelige.
Argumenter:
query— SQL-forespørgsel.variable— navnet på Python variablen, hvori dataene skrives.type—listeller Pandasdataframe.namespace— domænet, hvor forespørgslen vil blive udført.
ExecuteGlobal
ExecuteGlobal(global, variable, type, start, end, mask, labels, namespace) — overførsel af globalen til Python.
Argumenter:
global— navnet på globalen uden^variable— navnet på Python variablen, hvori dataene skrives.type—listeller Pandasdataframe.start— første delindeks på globalen. Obligatorisk%Integer.end— sidste delindeks på globalen. Obligatorisk%Integer.mask— masken for globale værdier. Masken kan være kortere end antallet af felter i globalen (i så fald vil felterne i slutningen blive udeladt). Sådan formatteres masken:+overfør værdien som den er.-spring værdien over.b— Boolesk type (0—False, alt andet —Sand).d— Dato (fra $horolog, på Windows fra 1970, på Linux fra 1900).t— Tid ($horolog, sekunder efter midnat).m— Tidsstempel (streng i formatet ÅR-MÅNED-DAG TIME:MINUT:SEKUND).
labels— %Liste af kolonne-navne. Det første element — navnet på subscriptet.namespace— domænet, hvor forespørgslen vil blive udført.
ExecuteClass
Wrapper over ExecuteGlobal. Baseret på klassedefinitionen forbereder den kaldet ExecuteGlobal og kalder det.
ExecuteClass(class, variable, type, start, end, properties, namespace) — overførsel af klassedata i Python.
Argumenter:
klasse— klassens navnvariable— navnet på Python variablen, hvori dataene skrives.type—listeller Pandasdataframe.start— start Id.end— slut Idproperties— en liste (adskilt af komma) af klasseegenskaber, som skal indlæses i datasættet. Masker understøttes.*og?. Som standard —*(alle egenskaber). Egenskaben%%CLASSNAMEignoreres.namespace— domænet, hvor forespørgslen vil blive udført.
Alle egenskaber overføres som de er, undtagen egenskaber for typer te, %Tid, %Boolsk og %Tidsstempel — de konverteres til de tilsvarende Python-klasser.
ExecuteTable
Wrapper over ExecuteClass. Translaterer tabelnavnet til klassens navn og kalder ExecuteClass. Signatur:
ExecuteTable(table, variable, type, start, end, properties, namespace) — overførsel af tabeldata i Python.
Argumenter:
table— tabelens navn.
Alle andre argumenter overføres som de er tilExecuteClass.
Noter
ExecuteGlobal,ExecuteClassogExecuteTablearbejder ligeså hurtigt.ExecuteGlobal20 gange hurtigere endExecuteQuerypå store datasæt (overførselstid mere end >0.01 sekunder).ExecuteGlobal,ExecuteClassogExecuteTablearbejder på globaler med denne struktur:^global(nøgle) = $lb(prop1, prop2, ..., propN)hvornøgle— heltal.- For
ExecuteGlobal,ExecuteClassogExecuteTableunderstøttet værdirammetesvarer til intervalletmktimeog afhænger af OS (: 1970-01-01, 1900-01-01, ). Brug%Tidsstempeltil at overføre data uden for dette interval eller brug pandas dataframe, da dette er en begrænsning kun for listen. - For
ExecuteGlobal,ExecuteClassogExecuteTablealle argumenter undtagen datakilden (globalen, klassen eller tabellen) og variablen er valgfrie.
Eksempler
Testklasse indeholder en metode, der demonstrerer alle muligheder for dataoverførsel:
set global = "isc.py.test.PersonD"
set class = "isc.py.test.Person"
set table = "isc_py_test.Person"
set query = "SELECT * FROM isc_py_test.Person"

// Generelle argumenter
set variable = "df"
set type = "dataframe"
set start = 1
set end = $g(^isc.py.test.PersonD, start)

// Metode 0: ExecuteGlobal uden argumenter
set sc = ##class(isc.py.Main).ExecuteGlobal(global, variable _ 0, type)

// Metode 1: ExecuteGlobal med argumenter
// Når globalen sendes, angives feltnavnene manuelt
// globalKey - navnet på subscriptet
set labels = $lb("globalKey", "Navn", "Fødselsdato", "TS", "RandomTid", "AlderÅr", "AlderDecimal", "AlderDobbelt", "Bool")

// mask indeholder en element mindre end labels fordi "globalKey" - navnet på subskriftet
// Vi springer %%CLASSNAME over
set mask = "-+dmt+++b"

set sc = ##class(isc.py.Main).ExecuteGlobal(global, variable _ 1, type, start, end, mask, labels)

// Metode 2: ExecuteClass
set sc = ##class(isc.py.Main).ExecuteClass(class, variable _ 2, type, start, end)

// Metode 3: ExecuteTable
set sc = ##class(isc.py.Main).ExecuteTable(table, variable _ 3, type, start, end)

// Metode 4: ExecuteTable
set sc = ##class(isc.py.Main).ExecuteQuery(query, variable _ 4, type)
Kald metoden do ##class(isc.py.test.Person).Test() for at se, hvordan alle metoder til dataoverførsel fungerer.
Hjælpefunktioner
GetVariableInfo(variable, serialization, .defined, .type, .length)— få information om variablen: om den er defineret, dens klasse og længden af serialisering.GetVariableDefined(variable, .defined)— er variablen defineret.GetVariableType(variable, .type)— få klassens type for variablen.GetStatus()— få og fjern den seneste undtagelse på Python-siden.GetModuleInfo(module, .imported, .alias)— få information om modulets variabel og importstatus.GetFunctionInfo(function, .defined, .type, .docs, .signature, .arguments)— få information om funktionen.
Interoperabilitet
Du har lært at kalde Python Gateway fra terminalen, nu begynder vi at bruge det i produktion. Grundlaget for interaktionen med Python i denne tilstand er isc.py.ens.Operation. Det giver os mulighed for:
- At udføre kode i Python
- At gemme/gendanne Python-konteksten
- At indlæse og hente data fra Python
I princippet er Python-operationen en indpakning over isc.py.Main. Operationen isc.py.ens.Operation muliggør interaktion med Python-processen fra InterSystems IRIS-produkter. Fem forespørgsler understøttes:
isc.py.msg.ExecutionRequesttil at udføre Python-koden. Returnererisc.py.msg.ExecutionResponsemed resultatet af udførelsen og værdierne af de ønskede variabler.isc.py.msg.StreamExecutionRequesttil at udføre Python-koden. Returnererisc.py.msg.StreamExecutionResponseresultatet af udførelsen og værdierne af de ønskede variabler. Analogisc.py.msg.ExecutionRequest, men accepterer og returnerer streams i stedet for strenge.isc.py.msg.QueryRequesttil at overføre resultatet af SQL-forespørgslen. ReturnererEns.Response.isc.py.msg.GlobalRequest/isc.py.msg.ClassRequest/isc.py.msg.TableRequesttil at overføre data til globaler/klasse/tabeller. ReturnererEns.Response.isc.py.msg.SaveRequesttil at gemme Python-konteksten. ReturnererEns.StringResponsemed konteksts-id.isc.py.msg.RestoreRequesttil at gendanne Python-konteksten.Derudover,
isc.py.ens.Operationhar to indstillinger:Initializer— valg af klasse, der implementerer interfacetisc.py.init.Abstract. Den kan bruges til at indlæse funktioner, moduler, klasser osv. Den udføres én gang ved opstart af processen.PythonLib— (kun for Linux) hvis du ser fejl ved indlæsning, skal du sætte den tillibpython3.6m.soeller endda den fulde sti til Python-biblioteket.
Oprettelse af forretningsprocesser
Der er to klasser, der gør det lettere at udvikle forretningsprocesser:
isc.py.ens.ProcessUtilsgiver mulighed for at udtrække annotationer fra aktiviteter med variableudskiftning.isc.py.util.BPEmulatorgør det nemt at teste forretningsprocesser med Python. Den kan udføre forretningsprocessen (dele på Python-sprog) i den aktuelle proces.
Variabeludskiftning
Alle forretningsprocesser, der er arvet fra isc.py.ens.ProcessUtils, kan bruge metoden GetAnnotation(name) til at få værdien af aktiviteten annotation efter dens navn. Aktivitetens annotation kan indeholde variable, som vil blive beregnet på InterSystems IRIS-siden, før de sendes til Python. Her er syntaksen for variabeludskiftning:
${class:method:arg1:...:argN}— kald metode#{expr}— udføre kode i ObjectScript.
Et eksempel er tilgængeligt i testforretningsprocessen isc.py.test.Process, for eksempel i aktiviteten Korrelationsmatrix: Grafik: f.savefig(r'#{process.WorkDirectory}SHOWCASE${%PopulateUtils:Integer:1:100}.png'). I dette eksempel:
#{process.WorkDirectory}returnerer egenskaben WorkDirectory for objektetprocess, som er en instans af klassenisc.py.test.Processdvs. den aktuelle forretningsproces.${%PopulateUtils:Integer:1:100}trykkes, kaldes metodenIntegerklassen%PopulateUtils, ved at sende argumenter1og100, returnerer et tilfældigt heltal i intervallet1...100.
Testforretningsprocessen
Testprodukter og testforretningsprocessen er tilgængelige som standard som en del af Python Gateway. For at bruge dem:
- Udfør i OS-terminalen:
pip install pandas matplotlib seaborn. - Udfør i InterSystems IRIS-terminalen:
do ##class(isc.py.test.CannibalizationData).Import()for at udfylde testdata. - Start produktet
isc.py.test.Production. - Send en forespørgsel af typen
Ens.Requestiisc.py.test.Process.
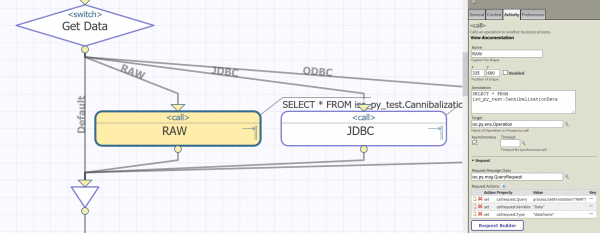
Lad os se, hvordan det hele fungerer sammen. Åbn isc.py.test.Process i BPL-editoren:
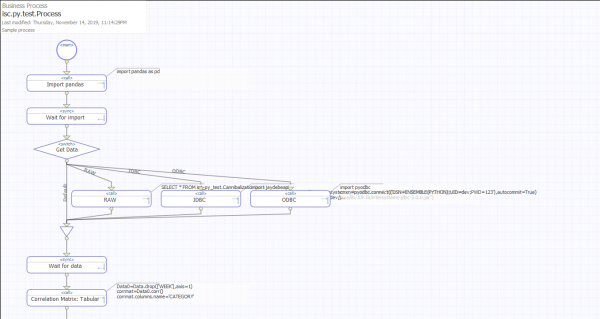
Udførelse af kode
Den vigtigste kald er udførelsen af Python-koden:
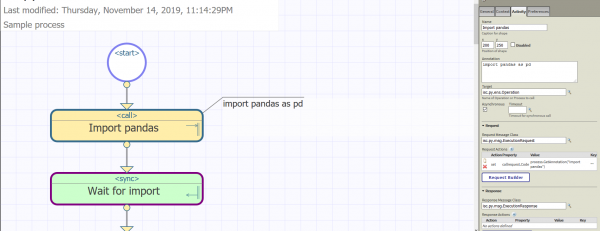
Bruger forespørgslen isc.py.msg.ExecutionRequest, her er dens egenskaber:
Kode— Python-kode.SeparateLines— om koden skal opdeles i linjer til udførelse.$c(10)(n) bruges til at adskille linjer. Bemærk, at det ikke anbefales at behandle beskeden helt på én gang; denne funktion er kun beregnet til behandlingdefog lignende flerlinjede udtryk. Som standard0.Variabler— en kommasepareret liste af variabler, der vil blive tilføjet til svaret.Serialization— Hvordan man serialiserer de variabler, vi ønsker at returnere. Muligheder:Str,Repr,JSON,PickleogDill, som standardStr.
I vores tilfælde indstiller vi kun egenskaben Kode, så alle andre egenskaber bruger standardværdier. Vi indstiller den ved at kalde process.GetAnnotation("Import pandas"), som under udførelsen returnerer annotationen efter udførelsen af variabel substitution. Til sidst vil koden import pandas as pd blive sendt til Python. GetAnnotation kan være nyttig til at hente flerlinjede Python-scripts, men der er ingen begrænsninger for denne metode til at hente koden. Du kan indstille egenskaben Kode på enhver måde, der er behagelig for dig.
Hentning af variabler
Endnu et interessant kald ved hjælp af isc.py.msg.ExecutionRequest — Korrelationsmatrix: Tabellarisk:
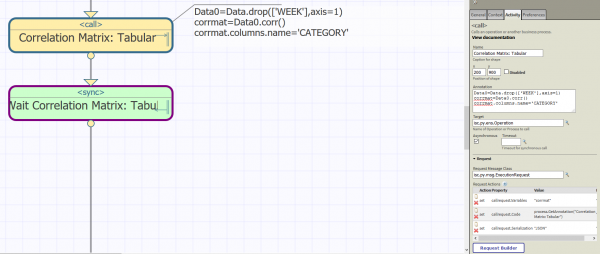
Den beregner korrelationsmatrixen på Python-siden og trækker variablen corrmat tilbage til InterSystems IRIS i JSON-format ved at indstille forespørgselsegenskaber:
Variabler:"corrmat"Serialization:"JSON"
Vi kan se resultaterne i Visual Trace:
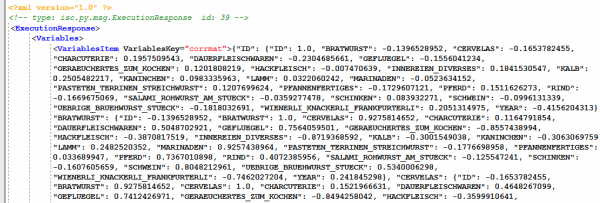
Og hvis vi har brug for denne værdi i BP, kan den hentes sådan: callresponse.Variables.GetAt("corrmat").
Overførsel af data
Lad os derefter tale om at overføre data fra InterSystems IRIS til Python; alle dataoverførselsanmodninger implementerer interface isc.py.msg.DataRequest, som tilbyder følgende egenskaber:
Variable— Python-variablen hvor dataene skrives.Type— typen af variablen:dataframe(pandas dataframe) ellerlist.Namespace— området fra hvilket vi henter data. Pakkenisc.pyskal være tilgængelig i dette område. Dette kan være et område uden produktsupport.
Baseret på dette interface er der implementeret 4 klasser af anmodninger:
isc.py.msg.QueryRequest— sæt din egenskabQuerytil at overføre SQL-anmodningen.isc.py.msg.ClassRequest— sæt din egenskabClasstil at overføre klassedata.isc.py.msg.TableRequest— sæt din egenskabTabletil at overføre tabeldata.isc.py.msg.GlobalRequest— sæt din egenskabGlobaltil at overføre globaledata.
I testprocessen, se aktiviteten RAW, hvor isc.py.msg.QueryRequest vist i aktion.
Gem/restituer Python-konteksten
Endelig kan vi gemme Python-konteksten i InterSystems IRIS; for at gøre dette sender vi isc.py.msg.SaveRequest med argumenterne:
Mask— Kun variabler, der tilfredsstiller masken, gemmes. Understøttede*og?. Eksempel:"Data*, Figure?". Som standard*.MaxLength— Den maksimale længde af den gemte variabel. Hvis serialiseringen af variablen overstiger denne længde, ignoreres den. Sæt 0 for at for at få variabler i enhver længde. Som standard$$$MaxStringLength.Navn— Navn på konteksten (valgfrit).Beskrivelse— Beskrivelse af konteksten (valgfrit).
Returnerer Ens.StringResponse med Id den gemte kontekst. I testprocessen kan du se aktiviteten Gem kontekst.
Den relevante anmodning isc.py.msg.RestoreRequest loader konteksten fra InterSystems IRIS til Python:
ContextId— kontekstens identifikator.Ryd— ryd konteksten før genoprettelse.
Jupyter Notebook
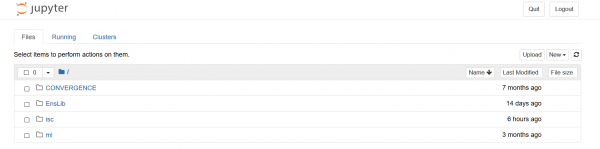
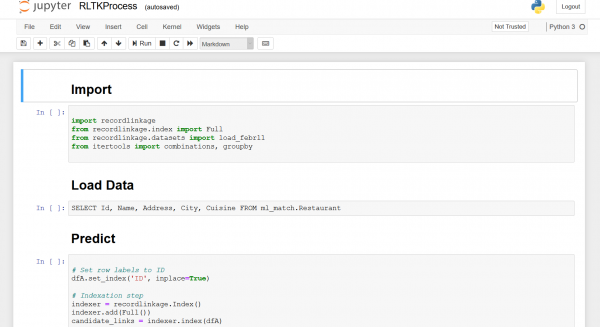
— er en webapplikation med åbent kildekode, der gør det muligt at oprette notebooks indeholdende kode, visualiseringer og tekst og offentliggøre dem. Python Gateway giver mulighed for at se og redigere BPL-processer som Jupyter Notebook. Bemærk, at den nuværende version bruger Python 3 som standard executor.
Denne udvidelse forudsætter, at annotationerne indeholder Python-kode og bruger aktivitetsnavne som overordnede overskrifter. Det er nu muligt at udvikle business processer PythonGateway i Jupyter Notebook. Her er hvad der er muligt:
- Oprette nye forretningsprocesser
- Slette forretningsprocesser
- Oprette nye aktiviteter
- Ændre aktiviteter
- Slette aktiviteter
Her er . Og nogle skærmbilleder:
Procesudforsker
Procesredigerer
Installation
- Du skal have InterSystems IRIS 2019.2+.
- Installer PythonGateway v0.8+ (kræver kun
isc.py.util.Jupyter,isc.py.util.JupyterCheckpointsogisc.py.ens.ProcessUtils). - Opdater ObjectScript-koden fra lageret.
- Kør
do ##class(isc.py.util.Jupyter).Install()og følg instruktionerne.
.
Konklusioner
MLToolkit er et værktøjssæt, hvis mål er at integrere modeller og transaktionelle miljøer, så de opbyggede modeller nemt kan bruges direkte i dine forretningsprocesser. Python Gateway er en del af MLToolkit og muliggør integration med Python-sproget og gør det muligt at orkestrere enhver maskinlæringsalgoritme lavet i Python (den primære platform for mange dataforskere), samt at bruge mange forudbyggede biblioteker til hurtigt at udvikle adaptive, automatiserede analytiske AI/ML-løsninger på InterSystems IRIS-platformen.
Links
MLToolkit
MLToolkit-brugergruppen er et privat GitHub-repositorium, oprettet som en del af Den Corporate GitHub-organisation InterSystems. Den henvender sig til eksterne brugere, der installerer, undersøger eller allerede bruger komponenter fra MLToolkit, herunder Python Gateway. Gruppen tilbyder en række implementerede use cases (med kildekode og testdata) inden for marketing, produktion, medicin og mange andre områder. For at deltage i ML Toolkit-brugergruppen bedes du sende en kort e-mail til følgende adresse: og angiv følgende oplysninger i din e-mail:
- GitHub-brugernavn
- Organisation (hvor du arbejder eller studerer)
- Position (din faktiske stilling i din organisation, eller "Studerende" eller "Selvstændig").
- Land
Til dem, der har læst artiklen og er interesseret i mulighederne med InterSystems IRIS som platform for udvikling eller hosting af AI- og maskinlæringsmekanismer, tilbyder vi at drøfte mulige scenarier af interesse for din virksomhed. Vi vil gerne analysere dine virksomheders behov og sammen definere en handlingsplan; kontakt e-mailadressen til vores AI/ML ekspertteam er .
Kilde: habr.com
