

Hej, Habr! Jeg præsenterer for jer oversættelsen af artiklen
.
Når det kommer til relationelle databaser, kan jeg ikke lade være med at føle, at der mangler noget. De bruges overalt. Der findes mange forskellige databaser, fra den lille og nyttige SQLite til den kraftfulde Teradata. Men der er kun et par artikler, der forklarer, hvordan en database fungerer. Du kan selv søge på "howdoesarelationaldatabasework" for at se, hvor få resultater der er. Desuden er disse artikler korte. Hvis du derimod leder efter de nyeste trendy teknologier (Big Data, NoSQL eller JavaScript), vil du finde flere dybdegående artikler, der forklarer, hvordan de fungerer.
Er relationelle databaser for gamle og for kedelige til at kunne forklares uden for universitetskurser, forskningsartikler og bøger?
Som udvikler hader jeg at bruge noget, jeg ikke forstår. Og hvis databaser har været i brug i over 40 år, må der være en grund. I løbet af de år har jeg brugt hundreder af timer på virkelig at forstå disse mærkelige sorte bokse, som jeg bruger hver dag. Relationelle databaser er meget interessante, fordi de er baseret på nyttige og genbrugelige begreber. Hvis du er interesseret i at forstå databasen, men aldrig har haft tid eller lyst til at dykke ned i dette brede emne, vil du sikkert kunne lide denne artikel.
Selvom titlen på denne artikel er klar, er formålet med denne artikel ikke at forstå, hvordan man bruger en database. Derfor skulle du allerede vide, hvordan man skriver en simpel join-forespørgsel og grundlæggende forespørgsler CRUD; ellers vil du måske ikke forstå denne artikel. Det er det eneste, du skal vide, jeg vil forklare alt det andet.
Jeg begynder med nogle grundlæggende datalogik, såsom tidskompleksiteten af algoritmer (Big O). Jeg ved, at nogle af jer hader dette koncept, men uden det kan du ikke forstå nuancerne inden for databasen. Da det er et stort emne, vil jeg fokusere på, hvad jeg anser for vigtigt: hvordan databasen behandler SQL anmodningen. Jeg vil kun præsentere grundlæggende databasebegreber, så du til sidst i slutningen af artiklen har en idé om, hvad der foregår bag kulisserne.
Da dette er en lang og teknisk artikel, der indeholder mange algoritmer og datastrukturer, skal du ikke være hastig med at læse den. Nogle koncepter kan være vanskelige at forstå; du kan springe dem over og stadig få en overordnet forståelse.
For de mere vidende af jer er denne artikel opdelt i 3 dele:
- Oversigt over low-level og high-level databasekomponenter
- Oversigt over forespørgselsoptimeringsprocessen
- Oversigt over transaktionsstyring og bufferpoolen
Tilbage til grundlæggende
For mange år siden (i en fjern, fjern galakse…) var udviklere nødt til at vide nøjagtigt, hvor mange operationer de kodede. De kunne udenad deres algoritmer og datastrukturer, fordi de ikke kunne tillade sig at bruge CPU og hukommelse på deres langsomme computere.
I denne del vil jeg minde dig om nogle af disse koncepter, da de er nødvendige for at forstå databaser. Jeg vil også introducere begrebet databaseindeks.
O(1) vs O(n2)
I dag bekymrer mange udviklere sig ikke om den tidslige kompleksitet af algoritmer … og de har ret!
Men når du har med store datamængder at gøre (jeg taler ikke om tusinder) eller hvis du kæmper om millisekunder, bliver det kritisk vigtigt at forstå dette koncept. Og som du forstår, skal databaser håndtere begge situationer! Jeg vil ikke få dig til at bruge mere tid, end nødvendigt for at fatte essensen. Dette vil hjælpe os senere med at forstå kostnadsbaseret optimeringsbegreb (cost based optimization).
Koncept
Den tidsmæssige kompleksitet af en algoritme bruges til at se, hvor lang tid det vil tage at udføre en algoritme for et givet datavolumen. For at beskrive denne kompleksitet bruges matematiske betegnelser af store O. Denne notation anvendes med en funktion, der beskriver, hvor mange operationer der er nødvendige for en algoritme til et givet antal inputdata.
For eksempel, når jeg siger "denne algoritme har kompleksitet O (some_function() )", betyder det, at algoritmen har brug for some_function(a_certain_amount_of_data) operationer for at behandle et bestemt datavolumen.
I dette tilfælde Det vigtige er ikke antallet af data**, men hvordan ** antallet af operationer stiger med stigende datavolumen. Tidskompleksitet giver ikke et præcist antal operationer, men er en god måde at estimere køretid på.
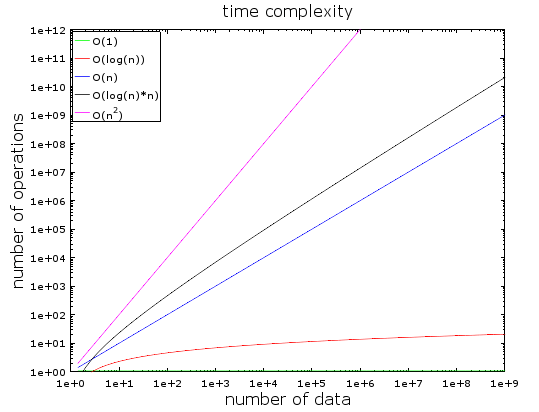
I denne grafik kan du se forholdet mellem antallet af operationer og mængden af inputdata for forskellige typer tidskompleksitet i algoritmer. Jeg har brugt en logaritmisk skala for at vise dem. Med andre ord, mængden af data stiger hurtigt fra 1 til 1 milliard. Vi kan se, at:
- O(1) eller konstant kompleksitet forbliver konstant (ellers ville det ikke kaldes konstant kompleksitet).
- D(log(n)) forbliver lav selv med milliarder af data.
- Den værste kompleksitet — O(n2), hvor antallet af operationer vokser hurtigt.
- De to andre kompleksiteter vokser også hurtigt.
Eksempler
Ved små mængder data er forskellen mellem O(1) og O(n2) ubetydelig. For eksempel, antag at du har en algoritme, der skal behandle 2000 elementer.
- Algoritmen O(1) vil koste dig 1 operation
- Algoritmen O(log(n)) vil koste dig 7 operationer
- Algoritmen O(n) vil koste dig 2000 operationer
- Algoritmen O(n * log(n)) vil koste dig 14.000 operationer
- Algoritmen O(n2) vil koste dig 4.000.000 operationer
Forskellen mellem O(1) og O(n2) virker stor (4 millioner operationer), men du vil kun miste maksimalt 2 ms, næsten den tid det tager at blinke med øjnene. Faktisk kan moderne processorer behandle . Det er derfor, ydeevne og optimering ikke er et problem i mange IT-projekter.
Som jeg allerede har nævnt, er det stadig vigtigt at kende dette koncept, når man arbejder med enorme mængder data. Hvis algoritmen nu skal behandle 1.000.000 elementer (hvilket ikke er så meget for en database):
- Algoritmen O(1) vil koste dig 1 operation
- Algoritmen O(log(n)) vil koste dig 14 operationer
- Algoritmen O(n) vil koste dig 1.000.000 operationer
- Algoritmen O(n * log(n)) vil koste dig 14.000.000 operationer
- Algoritmen O(n2) vil koste dig 1.000.000.000.000 operationer
Jeg har ikke foretaget beregningerne, men jeg vil sige, at hvis du bruger algoritmen O(n2), har du tid til at tage en kop kaffe (måske endda to!). Hvis du tilføjer endnu et 0 til mængden af data, har du tid til at tage en lur.
Lad os dykke dybere
Til reference:
- Søgning i en god hash-tabel finder elementet på O(1).
- Søgning i et godt balanceret træ giver resultatet på O(log(n)).
- Søgning i en array giver resultatet på O(n).
- De bedste sorteringsalgoritmer har kompleksitet O(n * log(n)).
- En dårlig sorteringsalgoritme har kompleksitet O(n2).
Bemærk: I de kommende afsnit vil vi se disse algoritmer og datatyper.
Der er flere typer tidskompleksitet for algoritmen:
- gennemsnitligt scenarie
- bedste udfald
- og værste scenarie
Tidskompleksiteten er ofte det værste scenarie.
Jeg har kun talt om tidskompleksitet for algoritmen, men kompleksiteten gælder også for:
- hukommelsesforbrug af algoritmen
- disk I/O-forbrug af algoritmen
Selvfølgelig er der kompleksiteter værre end n², for eksempel:
- n⁴: det er frygteligt! Nogle af de nævnte algoritmer har sådan en kompleksitet.
- 3n: det er endnu værre! En af de algoritmer, vi vil se på i midten af denne artikel, har denne kompleksitet (og den bruges faktisk i mange databaser).
- n!: du får aldrig dine resultater, selv med et lille datasæt.
- n^n: hvis du støder på denne kompleksitet, bør du spørge dig selv, om dette virkelig er dit felt …
Bemærk: Jeg har givet dig ikke en egentlig definition af betegnelsen "store O", men blot en idé. Du kan læse denne artikel i for den faktiske (asymptotiske) definition.
MergeSort (Sammenslåning sortering)
Hvad gør du, når du har brug for at sortere en samling? Hvad? Du kalder funktionen sort()… Ok, godt svar… Men for databaser skal du forstå, hvordan denne sort()-funktion fungerer.
Der findes flere gode sorteringsalgoritmer, så jeg vil fokusere på den mest vigtige: sammenslåingssortering. Du forstår muligvis ikke lige nu, hvorfor datsortering er nyttig, men du vil forstå det efter afsnittet dedikeret til optimering af forespørgsler. Desuden vil forståelsen af sammenslåingssortering hjælpe os senere med at forstå den generelle databaseoperation kaldet sammenslutte sammenføje (sammenslåing).
Sammenslutte (merge)
Som mange nyttige algoritmer er sammenslåingssortering baseret på et trick: at kombinere 2 sorterede array af størrelse N/2 til et N-element sorteret array kræver kun N operationer. Denne operation kaldes sammensmeltning.
Lad os se, hvad det betyder med et simpelt eksempel:
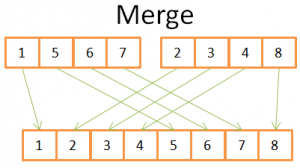
På dette billede kan man se, at for at konstruere det endelige sorterede array af 8 elementer, skal du bare udføre en iteration én gang i 2x 4-element arrays. Da begge 4-element arrays allerede er sorterede:
- 1) Du sammenligner begge nuværende elementer i to arrays (i starten er det nuværende = det første)
- 2) Tag derefter den mindste for at placere den i et array med 8 elementer
- 3) og gå videre til næste element i det array, hvor du tog det mindste element
- og gentag 1, 2, 3, indtil du når det sidste element i et af arrays.
- Dernæst tager du de resterende elementer fra det andet array for at placere dem i et array med 8 elementer.
Dette fungerer, fordi begge 4-element arrays er sorteret, og derfor behøver du ikke at "gå tilbage" i disse arrays.
Nu hvor vi har forstået dette trick, her er min pseudokode til merge:
array mergeSort(array a)
   if(length(a)==1)
      return a[0];
   end if

   //recursive calls
   [left_array right_array] := split_into_2_equally_sized_arrays(a);
   array new_left_array := mergeSort(left_array);
   array new_right_array := mergeSort(right_array);

   //merging the 2 small ordered arrays into a big one
   array result := merge(new_left_array,new_right_array);
   return result;
Merge sort opdeler opgaven i mindre opgaver, og finder derefter resultaterne af de mindre opgaver for at opnå resultatet af den originale opgave (note: denne type algoritmer kaldes deler og hersker). Hvis du ikke forstår denne algoritme, skal du ikke bekymre dig; jeg forstod det ikke første gang, jeg så det. Hvis det kan hjælpe dig, ser jeg denne algoritme som en to-fase algoritme:
- Delingsfase, hvor arrayet opdeles i mindre arrays
- Sorteringsfase, hvor de små arrays sammenføres (ved hjælp af sammenfletning) for at danne et større array.
Delingsfase (Division phase)
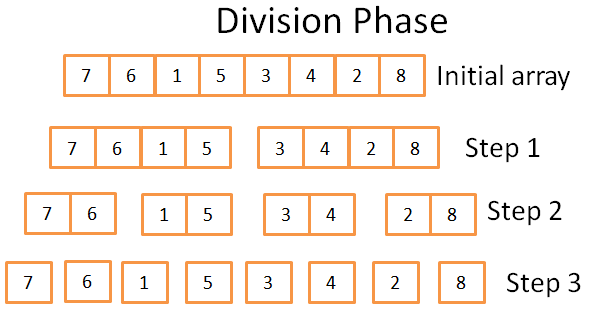
I delingsfasen opdeles arrayet i enhedselementer over 3 trin. Det formelle antal trin er log(N) (da N=8, log(N) = 3).
Hvordan ved jeg det?
Jeg er et geni! Kort sagt — matematik. Ideen er, at hvert trin deler størrelsen af det originale array i 2. Antallet af trin er antallet af gange, du kan dele det originale array i to. Dette er den præcise definition af logaritmen (med basis 2).
Sorteringsfase (Sorting phase)
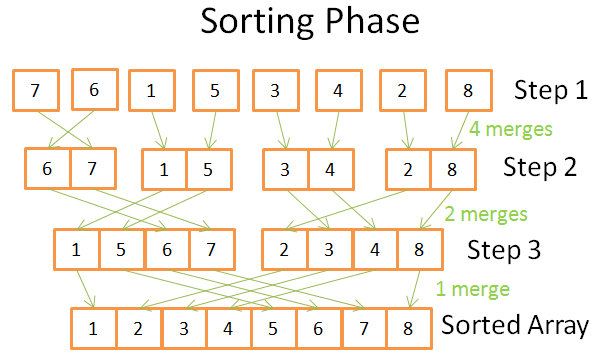
I sorteringsfasen starter du med enhedselementer (enkelt-element arrays). I løbet af hvert trin anvender du flere sammenfletningsoperationer, og den samlede omkostning er N = 8 operationer:
- I det første trin har du 4 sammenfletninger, der koster 2 operationer hver
- I det andet trin har du 2 sammenfletninger, der koster 4 operationer hver
- I det tredje trin har du 1 sammenfletning, der koster 8 operationer
Da der er log (N) skridt, den samlede omkostning er N * log(N) operationer.
Fordele ved merge sort
Hvorfor er denne algoritme så kraftfuld?
Fordi:
- Du kan ændre den, så den reducerer hukommelsesforbruget ved at modificere inputarrayet direkte uden at oprette nye arrays.
Bemærk: Denne type algoritmer kaldes (sortering uden ekstra hukommelse).
- Du kan ændre den til samtidig at bruge diskplads og et lille hukommelsesbudget uden betydelige omkostninger til disk I/O. Ideen er at indlæse i hukommelsen kun de dele, der aktuelt behandles. Dette er vigtigt, når du skal sortere en tabel, der er flere gigabyte stor, med kun et hukommelsesbuffer på 100 megabyte.
Bemærk: Denne type algoritmer kaldes .
- Du kan ændre den til at køre på flere processer / tråde / servere.
For eksempel er distribueret merge sort en af nøglekomponenterne (som er en struktur i big data).
- Denne algoritme kan forvandle bly til guld (det er sandt!).
Denne sorteringsalgoritme bruges i de fleste (hvis ikke alle) databaser, men den er ikke den eneste. Hvis du vil vide mere, kan du læse dette , som diskuterer fordele og ulemper ved generelle sorteringsalgoritmer i databaser.
Array, Træ og Hash-tabel
Nu hvor vi forstår ideen om tidskompleksitet og sortering, skal jeg fortælle dig om 3 datastrukturer. Det er vigtigt, fordi de er grundlaget for moderne databaser. Jeg vil også introducere begrebet databaseindeks.
Array
Et to-dimensionelt array er den simpleste datastruktur. En tabel kan betragtes som et array. For eksempel:
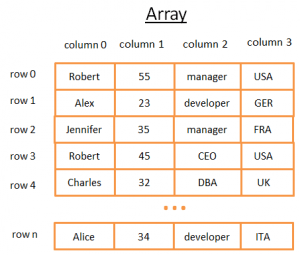
Dette 2D-array repræsenterer en tabel med rækker og kolonner:
- Hver række repræsenterer en enhed
- Kolonnerne opbevarer egenskaber, der beskriver enheden.
- Hver kolonne gemmer data af en bestemt type (integer, string, date …).
Det er så praktisk at gemme og visualisere data, men når du skal finde en bestemt værdi, er det ikke ideelt.
For eksempel, hvis du vil finde alle fyrene, der arbejder i Storbritannien, skal du gennemgå hver række for at bestemme, om denne række tilhører Storbritannien. Det vil koste dig N operationer, hvor N — antallet af rækker, som ikke er dårligt, men kan der være en hurtigere måde? Nu er det tid til at blive bekendt med træer.
Bemærk: de fleste moderne databaser tilbyder udvidede arrays til effektiv lagring af tabeller: heap-organized tables og index-organized tables. Men dette ændrer ikke problemet med hurtig søgning af en bestemt betingelse i en gruppe kolonner.
Databasetræ og indeks
Et binært søgetræ er et binært træ med en særlig egenskab, nøglen i hver knude skal være:
- større end alle nøgler, der findes i venstre undertræ
- mindre end alle nøgler, der findes i det højre undertræ
Lad os se, hvad det betyder visuelt
Idé
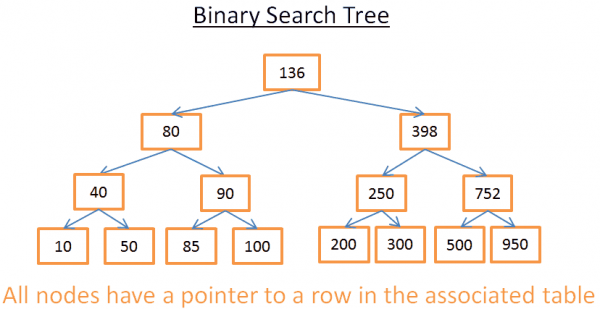
Dette træ har N = 15 elementer. Lad os antage, at jeg leder efter 208:
- Jeg starter ved roden, hvis nøgle er 136. Da 136<208, ser jeg på den højre underknude til node 136.
- 398>208, derfor ser jeg på venstre undertræ til node 398
- 250>208, derfor ser jeg på venstre undertræ til node 250
- 200<208, derfor ser jeg på det højre undertræ til node 200. Men 200 har ikke et højre undertræ, værdien eksisterer ikke (for hvis den eksisterede, ville den være i det højre undertræ af 200).
Nu, lad os sige jeg leder efter 40
- Jeg starter ved roden, hvis nøgle er 136. Da 136 > 40, ser jeg på venstre undertræ til node 136.
- 80 > 40, derfor ser jeg på venstre undertræ til node 80
- 40= 40, noden eksisterer. Jeg henter rækkeidentifikatoren inde i noden (denne findes ikke på billedet) og ser i tabellen for den pågældende rækkeidentifikator.
- At kende rækkeidentifikatoren gør, at jeg kan finde ud af, hvor dataene præcist er i tabellen, og derfor kan jeg hente dem øjeblikkeligt.
I sidste ende vil begge søgninger koste mig antallet af niveauer inden i træet. Hvis du læser om sortering med sammensmeltning, skulle du bemærke, at der her er log(N) niveauer. Så får vi, omkostningen ved søgning log(N), ikke dårligt!
Lad os vende tilbage til vores problem
Men det er meget abstrakt, så lad os vende tilbage til vores problem. I stedet for en simpel integer, forestil dig en streng, der repræsenterer nogen lands land i den tidligere tabel. Antag, at du har et træ, der indeholder feltet "country" (kolonne 3) fra tabellen:
- Hvis du vil vide, hvem der arbejder i Storbritannien
- ser du på træet for at få noden, der repræsenterer Storbritannien
- Inden for "UKnode" finder du placeringen af medarbejderoptegnelser i Storbritannien.
Denne søgning vil koste log(N) operationer i stedet for N operationer, hvis du direkte vil anvende et array. Det, du lige har præsenteret, var databaseindeks.
Du kan bygge et indeks-træ for enhver gruppe af felter (streng, tal, 2 strenge, tal og streng, dato ...) så længe du har en funktion til at sammenligne nøgler (dvs. grupper af felter), så du kan fastsætte rækkefølgen blandt nøglerne (hvilket gælder for alle grundlæggende datatyper i databasen).
B+TreeIndeks
Selvom dette træ fungerer godt til at hente en bestemt værdi, er der et STORT problem, når du skal hente flere elementer mellem to værdier.Det vil koste O(N), fordi du skal se på hver node i træet og kontrollere, om den ligger mellem disse to værdier (f.eks. med en ordnet gennemgang af træet). Desuden er denne operation ikke praktisk for disk I/O, da du skal læse hele træet. Vi skal finde en måde at effektivt udføre intervalforespørgslen.For at løse dette problem bruger moderne databaser en modificeret version af det tidligere træ kaldet B+Tree. I B+Tree træet:
- kun de nederste noder (blade) opbevarer information (placeringen af rækker i den tilknyttede tabel)
- de øvrige noder findes her til routing til den rigtige node under søgning..
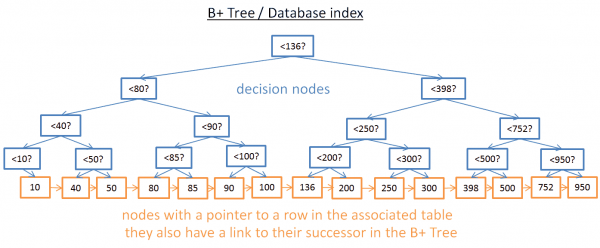
Som du kan se, er der flere noder her (dobbelt så mange). Faktisk har du ekstra noder, 'beslutningsnoder', som hjælper dig med at finde den rigtige node (som opbevarer placeringen af rækker i den tilknyttede tabel). Men kompleksiteten ved søgning er stadig O(log(N)) (der er bare et ekstra niveau). Den store forskel er, at noderne på det nederste niveau er forbundet til deres efterkommere..
Med dette B+Tree, hvis du søger efter værdier fra 40 til 100:
- Du skal blot søge efter 40 (eller nærmeste værdi efter 40, hvis 40 ikke findes), som du gjorde med det tidligere træ.
- Derefter samler du efterkommere af 40 ved hjælp af direkte henvisninger til efterkommere, indtil du når 100.
Lad os sige, at du har fundet M efterkommere, og træet har N noder. At finde en specifik node koster log(N) ligesom det tidligere træ. Men når du har denne node, får du M efterkommere i M operationer med henvisninger til deres efterkommere. Denne søgning koster kun M+log(N) operationer sammenlignet med N operationer med det tidligere træ. Desuden behøver du ikke at læse hele træet (kun M + log (N) noder), hvilket betyder mindre diskforbrug. Hvis M er lille (for eksempel 200 rækker) og N er stort (1.000.000 rækker), vil det være en STOR forskel.
Men her er der nye problemer (igen!). Hvis du tilføjer eller fjerner en række i databasen (og dermed i det relaterede B+Tree-indeks):
- skal du opretholde rækkefølgen mellem noderne inden i B+Tree-træet, ellers kan du ikke finde noderne inden i et usorteret træ.
- du skal holde antallet af niveauer i B+Tree på det lavest mulige, ellers vil tidskompleksiteten i O(log(N)) blive O(N).
Med andre ord, B+Tree skal være selvordnende og afbalanceret. Heldigvis er det muligt med smarte slette- og indsætningsoperationer. Men det er kostbart: indsættelse og sletning i B+ træet koster O(log(N)). Derfor har nogle af jer hørt, at brug af for mange indekser ikke er en særlig god idé. Faktisk, sænker du den hurtige indsættelse / opdatering / sletning af en række i tabellen, da databasen skal opdatere tabelindekserne ved hjælp af den dyre operation O(log(N)) for hvert indeks. Derudover betyder tilføjelse af indekser en større belastning for transaktionslederen (vil blive beskrevet i slutningen af artiklen).
For mere detaljeret information kan du se artiklen på Wikipedia om . Hvis du vil have et eksempel på implementering af B+Tree i en database, så kig på og af den førende udvikler af MySQL. De fokuserer begge på, hvordan InnoDB (MySQL-motoren) håndterer indekser.
Bemærk: læseren sagde til mig, at på grund af lavniveauoptimeringer skal B+ træet være helt afbalanceret.
Hashtabel (Hash Table)
Vores sidste vigtige datastruktur er en hashtabel. Det er meget nyttigt, når du ønsker hurtigt at søge efter værdier. Desuden vil forståelsen af hashtabellen hjælpe os senere med at forstå den overordnede operation for at sammenkæde med databasen, kaldet en hash-sammenkædning ( hash join). Denne datastruktur bruges også af databasen til at gemme nogle interne ting (for eksempel, låsetabel eller bufferpulje, vi vil se begge disse begreber senere).
En hash-tabel er en datastruktur, der hurtigt finder et element baseret på dets nøgle. For at opbygge en hash-tabel skal du definere:
- nøgle til dine elementer
- hash-funktion til nøgler. De beregnede hashes af nøglerne giver placeringen af elementerne (kaldet segmenter ).
- funktionen til at sammenligne nøgler. Når du har fundet det rigtige segment, skal du finde det element, du søger inde i segmentet ved hjælp af denne sammenligning.
Et simpelt eksempel
Lad os tage et illustrativt eksempel:
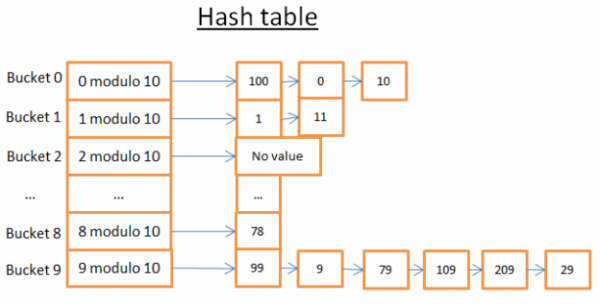
Denne hash-tabel har 10 segmenter. Da jeg er doven, har jeg kun tegnet 5 segmenter, men jeg ved, at du er klog, så jeg lader dig forestille dig de 5 andre selv. Jeg har brugt en hash-funktion ved modul 10 af nøglen. Med andre ord, jeg gemmer kun det sidste ciffer af elementets nøgle for at finde dets segment:
- hvis det sidste ciffer er 0, falder elementet ind i segment 0,
- hvis det sidste ciffer er 1, falder elementet ind i segment 1,
- hvis det sidste ciffer er 2, falder elementet ind i segment 2,
- …
Den sammenligningsfunktion, jeg brugte, er bare lighed mellem to heltal.
Antag, at du vil hente elementet 78:
- Hash-tabellen beregner hash-koden for 78, som er 8.
- Hash-tabellen kigger i segment 8, og det første element, den finder, er 78.
- Den returnerer elementet 78 til dig.
- Søgningen kostede kun 2 operationer (én til at beregne hash-funktionsværdien, og den anden til at finde elementet inde i segmentet).
Lad os sige, at du nu vil hente elementet 59:
- Hash-tabellen beregner hash-koden for 59, som er 9.
- Hash-tabellen søger i segment 9, det første fundne element er 99. Da 99!=59, er elementet 99 ikke det rigtige element.
- Ved at bruge denne samme logik tages det andet element (9), det tredje (79), …, det sidste (29).
- Elementet blev ikke fundet.
- Søgningen kostede 7 operationer..
En god hash-funktion
Som du kan se, varierer omkostningerne afhængigt af værdien, du søger!
Hvis jeg nu ændrer hash-funktionen til modul 1.000.000 af nøglen (dvs. ved at tage de sidste 6 cifre), vil den anden søgning kun koste 1 operation, da der i segment 000059 ikke er nogen elementer. Den reelle opgave er at finde en god hash-funktion, der skaber segmenter med meget få elementer..
I mit eksempel er det let at finde en god hash-funktion. Men det er mere komplekst at finde en god hash-funktion, når nøglen er:
- en streng (f.eks. efternavn)
- 2 strenge (f.eks. efternavn og fornavn)
- 2 strenge og en dato (f.eks. efternavn, fornavn og fødselsdato)
- …
Med en god hash-funktion er søgningen i hash-tabellen O(1).
Array vs hash-tabel
Hvorfor ikke bruge et array?
Hmm, godt spørgsmål.
- En hash-tabel kan være delvist indlæst i hukommelsen, mens de øvrige segmenter kan forblive på disken.
- Med et array skal du bruge sammenhængende plads i hukommelsen. Hvis du indlæser en stor tabel, er det meget svært at finde tilstrækkelig sammenhængende plads..
- For en hash-tabel kan du vælge den ønskede nøgle (f.eks. et land og en persons efternavn).
For yderligere information kan du læse artiklen om , som er en effektiv implementering af en hash-tabel; du behøver ikke at forstå Java for at forstå de koncepter, der beskrevet i denne artikel.
Kilde: habr.com
