

Så, du indsamler metrics. Ligesom os. Vi indsamler også metrics. Selvfølgelig dem, der er nødvendige for forretningen. I dag vil vi fortælle om det første led i vores overvågningssystem - en statsd-kompatibel aggregationsserver. , hvorfor vi skrev den, og hvorfor vi opgav brubeck.
Fra vores tidligere artikler (, ) kan du finde ud af, at vi indtil for nylig indsamlede labels ved hjælp af . Den er skrevet i C. Set fra et kodeperspektiv er den simpel som en prop (det er vigtigt, når du ønsker at bidrage), og vigtigst af alt, den håndterer vores volumener på 2 millioner metrics per sekund (MPS) i spidsbelastninger uden større problemer. Dokumentationen angiver støtte til 4 millioner MPS med en anmærkning. Det betyder, at du får det angivne tal, hvis du konfigurerer netværket korrekt på Linux. (Hvor mange MPS man kan få, hvis man lader netværket være som det er, ved vi ikke). På trods af disse fordele havde vi flere alvorlige klager over brubeck.
Klager 1. Github - udvikleren af projektet - har stoppet understøttelsen: offentliggøre patches og fixes, acceptere vores og (ikke kun vores) PR. I de sidste par måneder (cirka siden februar-marts 2018) er aktiviteten genoptaget, men før det var der næsten to års total stilhed. Desuden udvikles projektet , hvilket kan være en alvorlig hindring for implementeringen af nye funktioner.
Klager 2. Nøjagtigheden af beregninger. Brubeck indsamler kun 65,536 værdier til aggregation. I vores tilfælde kan der komme meget flere værdier inden for aggregationsperioden (30 sekunder) for nogle metrics (1,527,392 i spidsbelastning). Som følge af denne sampling ser maksimums- og minimumsværdierne ubrugelige ud. For eksempel sådan her:
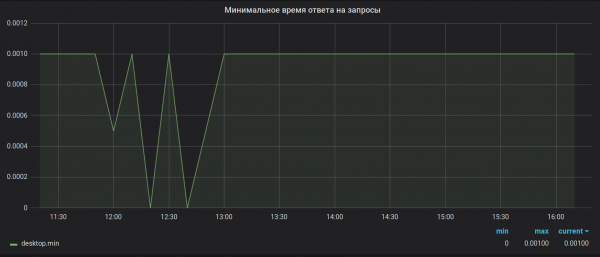
Hvordan det var
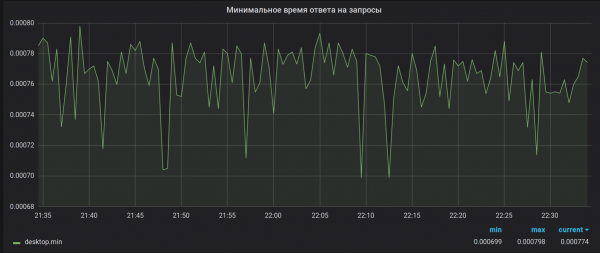
Hvordan det skulle have været
Af samme grund beregnes summen overhovedet forkert. Tilføj her en bug med overfyldning af 32-bit float, der sender serveren i segfault, når den modtager en tilsyneladende uskyldig metric, og det bliver endnu bedre. Bugen, for øvrigt, er stadig ikke rettet.
Og til sidst, Klager X. På tidspunktet for skrivelsen er vi klar til at præsentere den for alle 14 mere eller mindre fungerende implementeringer af statsd, som vi har været i stand til at finde. Lad os forestille os, at en bestemt infrastruktur er vokset så meget, at 4 millioner MPS ikke længere er tilstrækkeligt. Eller måske er den endnu ikke vokset, men metrics er allerede så vigtige for dig, at selv kortvarige, 2-3 minutters nedbrud på graferne kan blive kritiske og forårsage ubarmhjertig depression blandt ledere. Da behandling af depression er en utaknemmelig opgave, er tekniske løsninger nødvendige.
For det første fejltolerance, så en pludselig problem med serveren ikke forårsager et psykiatrisk zombie-apokalypse på kontoret. For det andet skal der være skalerbarhed, så vi kan håndtere mere end 4 millioner MPS uden at grave dybt i Linux-netværksstakken og vokse "udad" til de nødvendige størrelser.
Da vi havde noget overskud til skalerbarhed, besluttede vi at starte med fejltolerance. "Åh! Fejltolerance! Det er let, det kan vi!" tænkte vi og startede 2 servere, og kørte en kopi af brubeck på hver. For at gøre dette måtte vi kopiere trafik med metrics til begge servere og endda skrive en lille . Vi løste problemet med fejltolerance med dette, men… ikke særlig godt. Først var alt tilsyneladende fint: hver brubeck indsamler sin egen variant af aggregation, skriver data til Graphite hvert 30. sekund, og overskriver det gamle interval (dette gøres på Graphite-siden). Hvis en af serverne skulle svigte, har vi altid den anden med sin egen kopi af de aggregerede data. Men her er problemet: hvis serveren svigter, opstår der en "sav" på graferne. Dette er relateret til, at de 30-sekunders intervaller hos brubeck ikke er synkroniserede, og på tidspunktet for nedbruddet overskrives en af dem ikke. Det samme sker ved opstarten af den anden server. Det er tåleligt, men vi ønsker mere! Problemet med skalerbarhed er heller ikke forsvundet. Alle metrics er stadig "på vej" til en enkelt server, og derfor er vi begrænset af de samme 2-4 millioner MPS, alt efter hvordan netværket er opgraderet.
Når man tænker lidt over problemet og samtidig graver sne med en spade, kan en åbenlys idé komme frem: der er brug for en statsd, der kan fungere i distribueret tilstand. Det vil sige en, hvor synkronisering mellem noder er implementeret baseret på tid og målinger. "Selvfølgelig er der sikkert allerede en sådan løsning," sagde vi og gik i gang med at google... og fandt ingenting. Efter at have gennemgået dokumentationen for forskellige statsd ( pr. 11.12.2017), fandt vi præcis ingenting. Tilsyneladende har hverken udviklerne eller brugerne af disse løsninger haft så MANGE målinger at gøre med endnu, ellers ville de helt sikkert have fundet på et eller andet.
Og så kom vi i tanke om den "legetøjs" statsd - bioyino, som vi lavede på et hackathon bare for sjov (projektets navn blev genereret af et script før hackathonen) og indså, at vi hurtigt havde brug for vores egen statsd. Hvorfor?
- Fordi der er alt for få kloner af statsd i verden,
- Fordi vi kan sikre den ønskede eller nærværende fejltolerance og skalerbarhed (herunder synkronisere opsamlede målinger mellem servere og løse konflikter ved udsendelsen),
- Fordi vi kan måle målingerne mere præcist end brubeck gør,
- Fordi vi selv kan indsamle mere detaljerede statistikker, som brubeck stort set ikke gav os,
- Fordi vi fik muligheden for at programmere vores egen højtydende distribuerede skalaapplikation, som ikke vil gentage arkitekturen af en anden sådan højtydende... nu har vi ikke.
Hvad skriver vi på? Selvfølgelig på Rust. Hvorfor?
- Fordi der allerede var en prototype af løsningen,
- Fordi forfatteren af artiklen på det tidspunkt allerede kendte Rust og ønskede at skrive noget produktionsklart, som kunne offentliggøres som open-source,
- Fordi sprog med GC ikke passer til den natur af den trafik, vi får (næsten realtime) og GC-pausen er stort set uacceptabel,
- Fordi maksimal ydeevne, der kan sammenlignes med C, er nødvendigt
- Fordi Rust giver os fearless concurrency, og hvis vi havde startet med at skrive dette i C/C++, ville vi få endnu flere sårbarheder, buffer-overløb, race conditions og andre skræmmende ord end hos brubeck.
Der var også et argument imod Rust. Virksomheden havde ingen erfaring med at skabe projekter i Rust, og vi planlægger heller ikke at bruge det i vores hovedprojekt. Derfor var der alvorlige bekymringer om, at det ikke ville lykkes, men vi besluttede at tage chancen og prøve.
Tiden gik…
Endelig, efter flere mislykkede forsøg, var den første fungerende version klar. Hvad fik vi? Vi fik noget sådant.
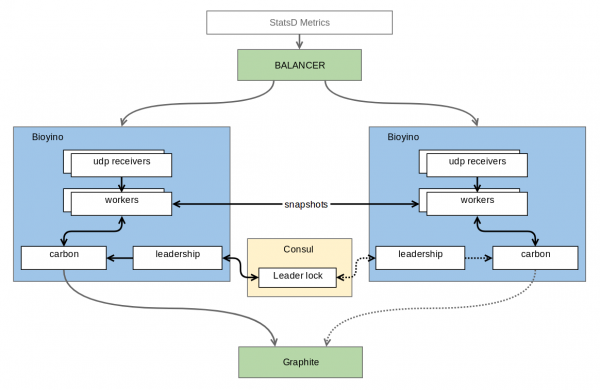
Hver node får sit eget sæt metrics og opbevarer dem, men aggregerer ikke metrics for de typer, hvor den endelige aggregation kræver det fulde sæt. Noderne er forbundet med en form for distribueret låseprotokol (distributed lock), som gør det muligt at vælge den ene (her græd vi), der er værdig til at sende metrics til den Store. I øjeblikket løses dette problem ved hjælp af , men i fremtiden strækker forfatterens ambitioner sig til Raft, hvor den værdige selvfølgelig vil være node-lederen for konsensus. Udover konsensus sender noderne ofte (som standard én gang i sekundet) de dele af de pre-aggregerede metrics, som de har formået at indsamle i løbet af det sekund, til deres naboer. Det betyder, at skalerbarhed og fejltolerance bevares — hver af noderne har stadig det fulde sæt metrics, men metrics sendes allerede aggregeret, via TCP og med kodning i et binært protokol, hvilket reducerer omkostningerne til duplication sammenlignet med UDP betydeligt. På trods af det ret store antal indkommende metrics kræver opsamlingen meget lidt hukommelse og endnu mindre CPU. For vores godt komprimerbare metrics er det kun et par dusin megabyte data. En ekstra bonus er fraværet af unødvendige overskrivninger af data i Graphite, som det var tilfældet med burbeck.
UDP-pakker med målinger er balanceret mellem noder på netværksudstyret via en simpel Round Robin. Selvfølgelig, netværksudstyret analyserer ikke indholdet af pakkerne og kan derfor håndtere langt mere end 4M pakker per sekund, for ikke at nævne målingerne, som det overhovedet ikke ved noget om. Hvis man tager i betragtning, at målingerne kommer ikke én ad gangen i hver pakke, så forventer vi ikke nogen ydeevneproblemer her. I tilfælde af servernedbrud opdager netværksenheden hurtigt (inden for 1-2 sekunder), at dette er sket, og den fjerner den nedbrudte server fra rotationen. Som et resultat heraf kan passive (dvs. ikke-leder) noder tændes og slukkes praktisk talt uden at man bemærker fald på grafikkerne. Det maksimale, vi mister, er en del målinger, der er kommet i det sidste sekund. Pludselig tab af/slukning/omskiftning af lederen vil stadig vise en ubetydelig anomali (30-sekunders intervallet er stadig desynkroniseret), men med forbindelse mellem noderne kan man minimere selv disse problemer, f.eks. ved at sende synkroniserende pakker.
Lidt om den interne struktur. Applikationen er selvfølgelig multitrådet, men trådarkitekturen adskiller sig fra den, der bruges i brubeck. Trådene i brubeck er ens — hver af dem er ansvarlig for både indsamling af information og aggregation. I bioyino er arbejdsstrømmene (workers) opdelt i to grupper: dem, der er ansvarlige for netværket, og dem, der er ansvarlige for aggregation. Denne opdeling tillader en mere fleksibel styring af applikationen afhængig af typen af målinger: hvor der kræves intens aggregation, kan man tilføje flere aggregatorer, og hvor der er meget netværkstrafik — kan man øge antallet af netværkstråde. I øjeblikket arbejder vi på vores servere med 8 netværkstråde og 4 aggregerende tråde.
Den tællende (ansvarlig for aggregation) del er temmelig kedelig. De fyldte buffers fra netværkstrådene distribueres mellem de tællende tråde, hvor de derefter parses og aggregeres. På forespørgsel gives målingerne tilsendt til andre noder. Alt dette, inklusive overførsel af data mellem noderne og arbejdet med Consul, udføres asynkront, hvilket kører på rammeværket .
Mange flere problemer under udviklingen opstod i den netværkselement, der var ansvarligt for modtagelse af metrikker. Hovedopgaven med at adskille netværksstrømme i separate enheder var at reducere den tid, som strømmen bruger ikke på at læse data fra socketen. Mulighederne med brug af asynkron UDP og almindelig recvmsg faldt hurtigt bort: den første bruger for meget user-space CPU til at behandle begivenheder, den anden — for mange konteksskift. Derfor bruges der nu med store buffere (og.buffere, mine herrer, det er ikke noget at tage let på!). Støtte til almindelig UDP er bevaret til lette tilfælde, hvor der ikke er behov for recvmmsg. I multimessage-tilstand lykkes det at opnå det vigtigste: at stort set det meste af tiden rydder netværksstrømmen OS-køen — læser data fra socketen og overfører dem til userspace-bufferen, kun sjældent skifter fokus for at aflevere den fyldte buffer til aggregatorerne. Køen i socketen ophobes praktisk talt ikke, og antallet af kasserede pakker vokser næsten ikke.
Bemærk
I de standardindstillinger, der er angivet, er bufferstørrelsen sat til at være stor nok. Hvis du beslutter dig for at teste serveren selv, vil du måske opleve, at efter at have sendt et lille antal metrikker, så ankommer de ikke til Graphite, men forbliver i netværksstrømsbufferen. For at arbejde med den lille mængde metrikker, skal du sætte bufsize og task-queue-size værdierne til en lavere.
Som afslutning — lidt grafer til graffans.
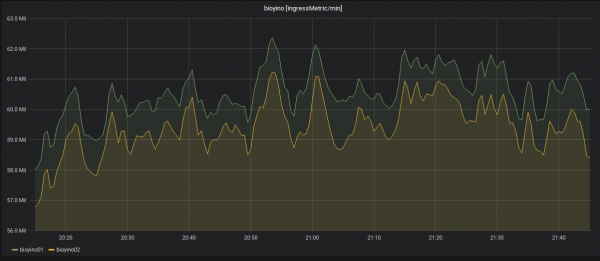
Statistik over antallet af indgående metrikker fra hver server: over 2 millioner MPS.
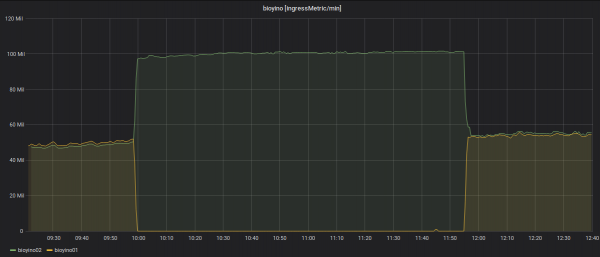
Deaktivering af en af noderne og omfordeling af de indgående metrikker.
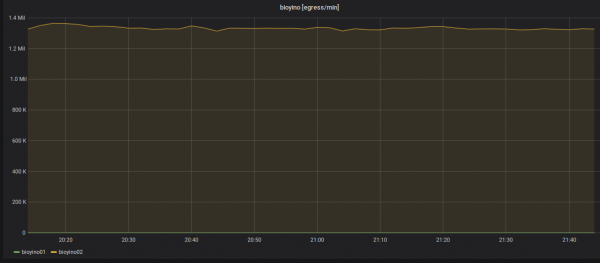
Statistik over udgående metrikker: sendes der altid kun en node — raidbossen.
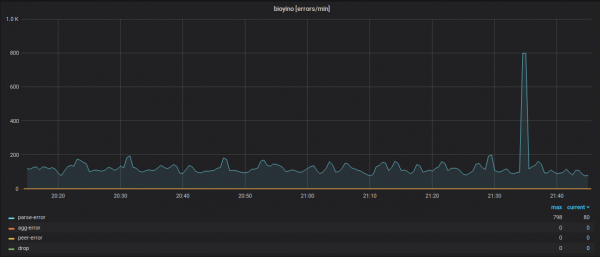
Statistik over hver nodes arbejde med hensyn til fejl i forskellige systemmoduler.
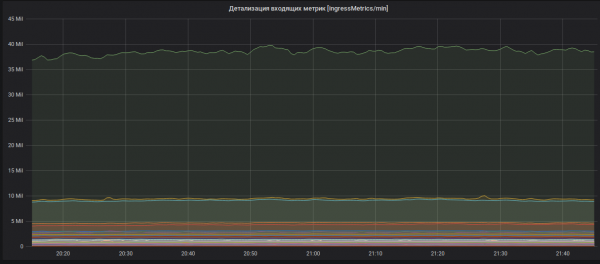
Detaljering af de indgående metrikker (metriknavne er skjult).
Hvad planlægger vi at gøre med alt dette fremad? Selvfølgelig at skrive kode, bl...! Projektet var oprindeligt planlagt som open-source og vil forblive sådan hele dets liv. I de nærmeste planer er der et skifte til vores egen version af Raft, ændring af peer-protokollen til en mere bærbar en, indførelse af yderligere intern statistik, nye typer metrikker, fejlrettelser og andre forbedringer.
Selvfølgelig er alle, der ønsker at hjælpe med udviklingen af projektet, velkomne: skab PR, Issues, og vi vil svare og forbedre, når det er muligt, osv.
Og med dette, som man siger, that’s all folks, køb vores elefanter!
Kilde: habr.com
