

I over 20 år har vi set websteder gennem HTTP-protokollen. De fleste brugere tænker slet ikke over, hvad det er, og hvordan det fungerer. Andre ved, at der et sted under HTTP er TLS, og under det TCP, og under det IP, og så videre. Og nogle – de heretikere – mener, at TCP er fortid, og de ønsker noget hurtigere, mere pålideligt og sikkert. Men i deres forsøg på at finde en ny ideel protokol er de gået tilbage til teknologierne fra 80'erne og prøver at bygge en vidunderlig ny verden på dem.
Lidt historie: HTTP/1.1
I 1997 fik tekstudvekslingsprotokollen HTTP version 1.1 sit RFC. På det tidspunkt var protokollen allerede blevet brugt af browsere i flere år, og den nye standard holdt i yderligere femten. Protokollen fungerede kun efter forespørgsels-svar-princippet og var hovedsageligt beregnet til at overføre tekstinformation.
HTTP blev designet til at arbejde oven på TCP-protokollen, som sikrer pålidelig levering af pakker til modtageren. TCP's funktionsmåde er baseret på at etablere og opretholde en pålidelig forbindelse mellem endepunkter og opdelt trafik i segmenter. Segmenterne har deres egen sekvensnummer og kontrolsum. Hvis et af segmenterne ikke kommer frem, eller kommer med en forkert kontrolsum, stopper transmissionen, indtil det tabte segment er genoprettet.
I HTTP/1.0 blev TCP-forbindelsen lukket efter hver forespørgsel. Dette var ekstremt spild, da etableringen af en TCP-forbindelse (3-Way-Handshake) ikke er en hurtig proces. I HTTP/1.1 blev der introduceret en keep-alive-mekanisme, der tillader genbrug af én forbindelse til flere forespørgsler. Men da det let kan blive en flaskehals, tillader forskellige implementeringer af HTTP/1.1 åbning af flere TCP-forbindelser til én vært. For eksempel tillader Chrome og de nyeste versioner af Firefox op til seks forbindelser.
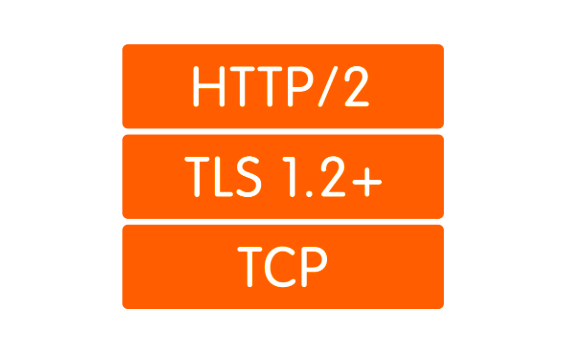
Kryptering blev også meningen skulle overlades til andre protokoller, og derfor anvendte man TLS-protokollen oven på TCP, som ganske pålideligt beskyttede data, men også i højere grad øgede den tid, der kræves for at etablere forbindelsen. I sidste ende så håndtryksprocessen sådan ud:
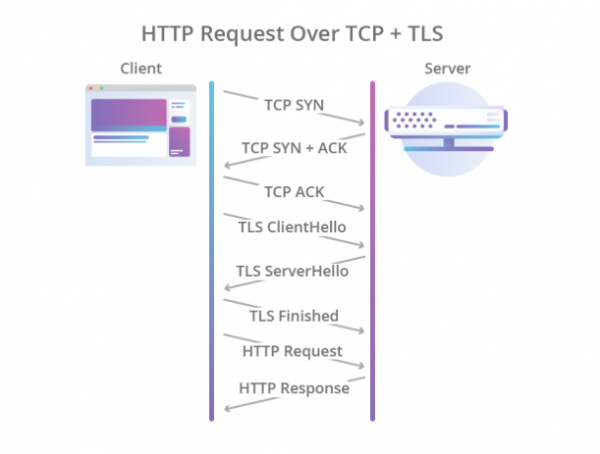
Illustration Cloudflare
Således havde HTTP/1.1 en række problemer:
- Langsom oprettelse af forbindelse.
- Data overføres som tekst, hvilket gør overførslen af billeder, videoer og anden ikke-tekstual information ineffektiv.
- Én TCP-forbindelse bruges til én anmodning, hvilket betyder, at de øvrige anmodninger må finde en anden forbindelse eller vente, indtil den nuværende anmodning afsluttes.
- Kun pull-modellen understøttes. Der er ikke noget om server-push i standarden.
- Overskrifterne sendes som tekst.
Hvis server-push svært kan implementeres via WebSocket-protokollen, så skulle der findes mere radikale løsninger til de øvrige problemer.
Lidt modernitet: HTTP/2
I 2012 begyndte Google at arbejde på SPDY-protokollen (udtales "spidi"). Protokollen skulle løse de vigtigste problemer ved HTTP/1.1 og skulle samtidig bevare bagudkompatibilitet. I 2015 præsenterede IETF’s arbejdsgruppe specifikationen for HTTP/2, baseret på SPDY-protokollen. Her er de forskelle, der var i HTTP/2:
- Binær serialisering.
- Multiplexing af flere HTTP-anmodninger i én TCP-forbindelse.
- Server-push lige fra starten (uden WebSocket).
Protokollen var et stort skridt fremad. Den betydeligt og kræver ikke oprettelse af flere TCP-forbindelser: alle anmodninger til én vært multiplexes i én. Det vil sige, at der i én forbindelse er flere såkaldte streams, hver med sit ID. Som en bonus får man server-push lige fra starten.
Men multiplexing fører til et andet grundlæggende problem. Tænk på, at vi asynkront laver 5 anmodninger til én server. Når vi bruger HTTP/2, vil alle disse anmodninger blive udført inden for én TCP-forbindelse, og hvis en hvilken som helst segment af nogen anmodning går tabt eller er forkert, stopper transmissionen af alle anmodninger og svar, indtil det tabte segment er genoprettet. Det er indlysende, at jo dårligere kvaliteten af forbindelsen er, desto langsommere fungerer HTTP/2. , i situationer hvor tabte pakker udgør 2% af alle, præsterer HTTP/1.1 i browseren bedre end HTTP/2, da den åbner 6 forbindelser i stedet for én.
Dette problem kaldes "head-of-line blocking", og desværre ser det ikke ud til at kunne løses ved brug af TCP.
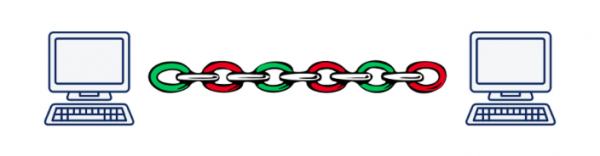
Illustration af Daniel Steinberg
Som konklusion har udviklerne af HTTP/2-standarden udført et kolossalt stykke arbejde og gjort stort set alt, hvad der kunne gøres på applikationsniveau i OSI-modellen. Det er tid til at bevæge sig ned på transportniveauet og opfinde en ny transportprotokol.
Vi har brug for en ny protokol: UDP vs TCP
Det blev hurtigt klart, at det at implementere en helt ny transportprotokol er en uløselig opgave i dagens realiteter. Problemet er, at udstyr eller middle-boxes (routere, firewalls, NAT-servere...) kender til transportniveauet, og det er yderst vanskeligt at lære dem noget nyt. Desuden er understøttelsen af transportprotokoller indbygget i operativsystemernes kerne, og kernerne ændrer sig ikke ligefrem med stor vilje.
Her kunne man give op og sige: "Vi vil selvfølgelig opfinde ny HTTP/3 med præferencer og kurtisaner, men det vil tage 10-15 år at implementere (det er omtrent den tid, det vil tage, før de fleste enheder er udskiftet)," men der er endnu en ikke så indlysende mulighed: at bruge UDP-protokollen. Ja, lige præcis den protokol, vi brugte til at sende filer lokalt i slutningen af 90'erne og starten af 00'erne. Næsten alt dagens udstyr kan arbejde med den.
Hvad er fordelene ved UDP i forhold til TCP? Først og fremmest, at vi ikke har en transportsessionsforbindelse, som udstyret kender til. Dette giver os mulighed for selv at definere sessionen på endepunkterne og der også løse opståede konflikter. Det vil sige, at vi ikke er begrænset til én eller flere sessioner (som i TCP), men kan oprette så mange vi har brug for. For det andet sker dataoverførslen hurtigere over UDP end over TCP. Teoretisk set kan vi derfor bryde den nuværende hastighedsgrænse, der er nået i HTTP/2.
Men UDP garanterer ikke pålideligheden af dataoverførsel. Faktisk sender vi bare pakker og håber, at de bliver modtaget i den anden ende. Fik de ikke det? Nå, så var det ikke heldigt... Dette var tilstrækkeligt til at transmittere voksenvideoer, men til mere seriøse ting er der behov for pålidelighed, hvilket betyder, at det bliver nødvendigt at lægge noget ekstra oven på UDP.
Som med HTTP/2 begyndte arbejdet med at skabe den nye protokol i Google i 2012, altså omtrent samtidig med begyndelsen på arbejdet med SPDY. I 2013 præsenterede Jim Roskind protokollen for offentligheden. , og allerede i 2015 blev der indsendt et Internet Draft til standardisering i IETF. Allerede på det tidspunkt adskilte den protokol, der blev udviklet af Roskind hos Google, sig kraftigt fra den, som blev præsenteret til standard, så Googles version blev kaldt gQUIC.
Hvad er QUIC
For det første, som nævnt, er det et lag oven på UDP. Oven på UDP opbygges en QUIC-forbindelse, hvor flere streams kan eksistere på samme tid, ligesom med HTTP/2. Disse streams eksisterer kun på endpoints og håndteres uafhængigt. Hvis der sker et pakketab i en stream, påvirker det ikke de andre.
Illustration af Daniel Steinberg
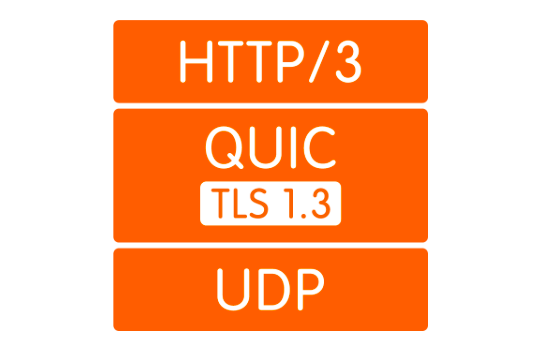
For det andet er kryptering nu implementeret ikke som et separat lag, men som en del af protokollen. Dette muliggør, at man kan etablere en forbindelse og udveksle offentlige nøgler i ét handshake, og det muliggør også brugen af en smart mekanisme til 0-RTT handshake, hvilket helt undgår forsinkelser ved handshaket. Desuden kan man nu kryptere individuelle datapakker. Dette gør det muligt at dechiffrere de modtagne pakker uafhængigt af, om dataene fra streamen er fuldført. En sådan driftsmode var helt umulig i TCP, da TLS og TCP arbejdede uafhængigt af hinanden, og TLS ikke kunne vide, hvordan dataene ville blive opdelt af TCP. Derfor kunne det ikke forberede sine segmenter, så de matchede TCP-segmenterne en til en og kunne dekrypteres uafhængigt. Alle disse forbedringer gør det muligt for QUIC at reducere latens i forhold til TCP.
For det tredje tillader konceptet med lette streams at adskille forbindelsen fra klientens IP-adresse. Dette er vigtigt, for eksempel når klienten skifter fra et Wi-Fi-netværk til et andet, hvilket ændrer sin IP. I dette tilfælde gennemgår TCP en lang proces, hvor eksisterende TCP-forbindelser falder ud på grund af timeout, og der oprettes nye forbindelser med den nye IP. I tilfælde af QUIC fortsætter klienten simpelthen med at sende pakker til serveren fra den nye IP med det gamle stream-ID. Da stream-ID'et nu er unikt og ikke genbruges, forstår serveren, at klienten har ændret IP, sender de tabte pakker, der mangler, og fortsætter kommunikationen på den nye adresse.
For det fjerde implementeres QUIC på applikationsniveau og ikke på operativsystemniveau. Dette gør det hurtigere at foretage ændringer i protokollen, da man blot skal opdatere biblioteket for at få en opdatering i stedet for at vente på en ny version af OS. På den ene side fører det til en betydelig stigning i CPU-forbruget.
Og til sidst, overskrifterne. Kompressionen af overskrifterne er netop et aspekt, der adskiller QUIC fra gQUIC. Jeg ser ikke nogen grund til at bruge meget tid på dette, jeg vil kun sige, at i den version, der er blevet fremsat til standardisering, er kompressionen af overskrifterne gjort så ligesom kompressionen i HTTP/2. Du kan læse mere .
Hvor meget hurtigere er det?
Det er et komplekst spørgsmål. Tingen er, at vi ikke har en standard endnu, så der er ikke meget at måle. Måske er de eneste statistiske data, vi har, statistikken fra Google, som har brugt gQUIC siden 2013 og i 2016 , at omkring 90% af trafikken til deres servere fra Chrome-browseren nu bruger QUIC. I denne samme præsentation rapporterer de, at sider indlæses cirka 5% hurtigere gennem gQUIC, og at der er 30% færre hængninger i streamingvideo i forhold til TCP.
I 2017 offentliggjorde en gruppe forskere ledet af Arash Molavi Kakhki en undersøgelse af ydeevnen af gQUIC sammenlignet med TCP.
Undersøgelsen afdækkede flere svagheder ved gQUIC, såsom ustabilitet over for netværkspakkeombygningsmetoder, grådighed (unfairness) i forhold til kanalens båndbredde og langsommere overførsel af små (op til 10 kB) objekter. Det sidste kan dog kompensere for ved hjælp af 0-RTT. I alle andre undersøgte tilfælde viste gQUIC en hastighedsforøgelse i forhold til TCP. Det er svært at tale om konkrete tal her. Det er bedre at læse eller .
Her skal det siges, at dette data specifikt handler om gQUIC, og at de ikke er relevante for den standard, der er under udvikling. Hvad der vil ske for QUIC: Det forbliver en hemmelighed, men der er håb om, at de svagheder, der blev identificeret i gQUIC, vil blive taget i betragtning og rettet.
En smule fremtidsudsigter: hvad med HTTP/3?
Her er alt glasklart: API'en vil ikke ændre sig. Alt forbliver præcis som det var i HTTP/2. Hvis API'en forbliver den samme, skal overgangen til HTTP/3 håndteres ved at bruge en ny version af biblioteket på backend, som understøtter transport via QUIC. Men det vil tage lang tid, før vi kan slippe for at have et fallback til gamle HTTP-versioner, da internettet i øjeblikket ikke er klart til en fuldstændig overgang til UDP.
Hvem understøtter allerede
Her er eksisterende QUIC-implementeringer. På trods af manglen på en standard er listen ikke dårlig.
Ingen browser understøtter i øjeblikket QUIC i produktionsversionen. For nylig blev der meldt om, at Chrome har aktiveret understøttelse af HTTP/3, men kun i Canary.
Af backend-løsninger understøtter kun og , men det er stadig eksperimentelt. NGINX arbejdede i slutningen af foråret 2019 , hvilket indikerer, at de er i gang med at arbejde på understøttelse af HTTP/3, men de er endnu ikke færdige.
Hvilke problemer der er
Vi lever i en virkelighed, hvor ingen store teknologier kan nå masserne uden at møde modstand, og QUIC er intet undtagelse.
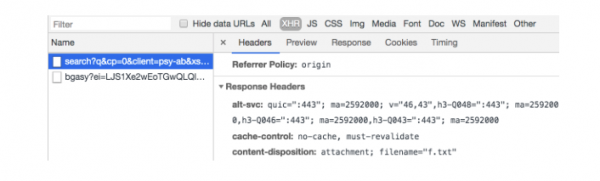
Det vigtigste er, at man på en eller anden måde skal forklare browseren, at "https://" nu ikke nødvendigvis peger på TCP-port 443. Der kan slet ikke være TCP. Dette gøres ved hjælp af Alt-Svc headeren. Den tillader browseren at vide, at denne hjemmeside også er tilgængelig på en bestemt protokol via en bestemt adresse. I teorien skulle dette fungere som smurt, men i praksis vil vi støde på, at UDP muligvis er blokkeret af en firewall for at forhindre DDoS-angreb.
Men selv hvis UDP ikke er blokeret, kan klienten befinde sig bag en NAT-router, der er konfigureret til at opretholde TCP-sessionen på IP-adressen, og da vi bruger UDP, som ikke har en hård sessionshåndtering, vil NAT ikke opretholde forbindelsen, og QUIC-sessionen .
Alle disse problemer er relateret til, at UDP tidligere ikke har været brugt til at overføre internetindhold, og hardwareproducenterne kunne ikke forudse, at dette en dag ville ske. Ligeledes forstår administratorer heller ikke helt, hvordan de korrekt skal konfigurere deres netværk til at arbejde med QUIC. Denne situation vil langsomt ændre sig, og under alle omstændigheder vil sådanne ændringer tage mindre tid end implementeringen af en ny transportprotokol.
Derudover, som allerede nævnt, øger QUIC kraftigt CPU-brugen. Daniel Stenberg stigningen i CPU-brug til op til tre gange.
Hvornår kommer HTTP/3
Standarten I maj 2020, men givet at de nuværende dokumenter, der er planlagt til juli 2019, stadig ikke er færdige, kan man sige, at datoen sandsynligvis vil blive udsat.
Google har brugt sin implementation af gQUIC siden 2013. Hvis man ser på HTTP-anmodningen, der sendes til Googles søgemaskine, kan man se dette:
Konklusioner
QUIC fremstår nu som en ret uudviklet, men meget lovende teknologi. I betragtning af at de sidste 20 år har fokus været på optimeringer af transportprotokoller stort set kun med TCP, ser QUIC, som i de fleste tilfælde vinder på ydeevne, allerede nu ret godt ud.
Der er dog stadig uafklarede problemer, som vi skal tackle i de kommende år. Processen kan trække ud, fordi der er hardware involveret, som ingen elsker at opdatere, men alle problemer ser faktisk ud til at være håndterbare, og før eller senere vil vi alle have HTTP/3.
Fremtiden er ikke langt væk!
Kilde: habr.com
