

I denne artikel vil vi tale om funktionelle afhængigheder i databaser - hvad det er, hvor det anvendes, og hvilke algoritmer der findes til at finde dem.
Vi vil betragte funktionelle afhængigheder i konteksten af relationelle databaser. Hvis man skal sige det meget enkelt, så opbevares oplysninger i sådanne databaser i form af tabeller. Dernæst bruger vi tilnærmede begreber, som i streng relationel teori ikke er indbyrdes udskiftelige: selve tabellen kalder vi en relation, kolonnerne - attributter (deres mængde - relationens skema), og mængden af værdier i en række for et underparti af attributterne - et tuple.
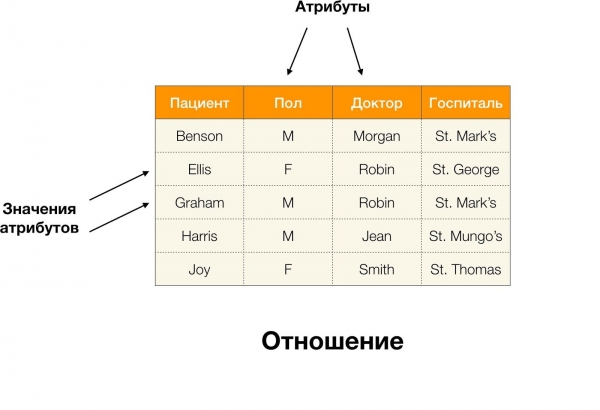
For eksempel, i ovenstående tabel, (Benson, M, M organ) er et tuple for attributterne (Patient, Køn, Læge).
Mere formelt skrives dette som følgende:  [Patient, Køn, Læge] = (Benson, M, M organ).
Nu kan vi introducere begrebet funktionel afhængighed (FA):
Definition 1. Relation R opfylder FA X → Y (hvor X, Y ⊆ R) hvis og kun hvis for alle tupler  ,
 ∈ R gælder: hvis
 [X] =
 [X], så
 [Y ] =
 [Y ]. I så fald siger man, at X (determinant eller definerende mængde af attributter) funktionelt definerer Y (afhængig mængde).
Med andre ord betyder tilstedeværelsen af FA X → Y at hvis vi har to tupler i R og de er ens med hensyn til attributterne X, så vil de også være ens med hensyn til attributterne Y.
Lad os nu tage det i rækkefølge. Lad os se på attributterne Patient og Køn for hvilke vi ønsker at finde ud af, om der er afhængigheder mellem dem eller ej. For en sådan mængde af attributter kan der eksistere følgende afhængigheder:
- Patient → Køn
- Køn → Patient
Ifølge definitionen ovenfor, for at den første afhængighed kan opretholdes, skal hvert unikke værdi i kolonnen Patient svare til kun ét værdi i kolonnen Køn. Og for tabel-eksemplet er dette virkelig tilfældet. Men i den modsatte retning fungerer det ikke, dvs. den anden afhængighed opretholdes ikke, og attributten Køn er ikke en determinant for Patient. Tilsvarende, hvis vi tager afhængigheden Læge → Patient, kan man bemærke, at den overtrædes, da værdien Robin for denne attribut har flere forskellige værdier - Ellis og Graham.
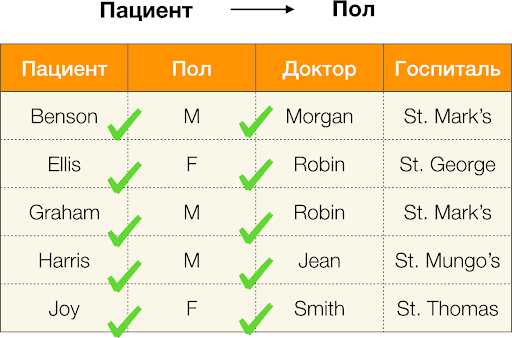
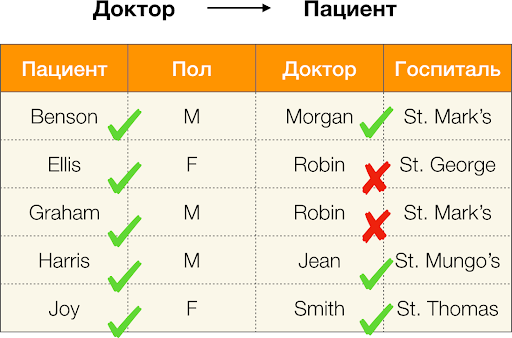
Dermed giver funktionelle afhængigheder mulighed for at bestemme de eksisterende forbindelser mellem mængderne af tabelattributter. Derfor vil vi fremover se på de mest interessante forbindelser, og mere præcist dem X → Y, hvor de er:
- ikke-trivielle, dvs. at højresiden af afhængigheden ikke er en delmængde af venstresiden (Y ̸⊆ X);
- minimale, dvs. at der ikke eksisterer nogen sådan afhængighed Z → Y, at Z ⊂ X.
De afhængigheder, vi hidtil har diskuteret, har været strenge, dvs. at de ikke tillader nogen overtrædelser i tabellen, men der findes også sådanne, der tillader en vis inkonsistens mellem værdierne af tupler. Disse afhængigheder placeres i en særskilt klasse, kaldes tilnærmede og tillades at blive overtrådt i et bestemt antal tupler. Dette antal reguleres af den maksimale fejlindikator emax. For eksempel kan en fejlandel  = 0,01 betyde, at afhængigheden kan overtrædes af 1% af de eksisterende tupler i den betragtede mængde af attributter. Dvs. for 1000 posteringer kan højst 10 tupler overtræde den funktionelle afhængighed. Vi vil dog se på en lidt anden metrik, der er baseret på de parvist forskellige værdier af de sammenlignede tupler. For afhængigheden X → Y på relationen r beregnes den som følger:

Lad os beregne fejlen for Læge → Patient i eksemplet ovenfor. Vi har to tupler, hvis værdier adskiller sig på attributten Patient, men er ens på Læge:  [Læge, Patient] = (Robin, Ellis) og
 [Læge, Patient] = (Robin, Graham). I henhold til fejldefinitionen skal vi tage højde for alle konflikterende par, og dermed vil der være to: (
 ,
 ) og dens inversion (
 ,
 ). Lad os indsætte i formlen og få:

Og nu vil vi forsøge at besvare spørgsmålet: «Hvorfor er det hele nødvendigt?». Faktisk findes der mange typer funktionelle afhængigheder. Den første type er sådanne afhængigheder, der defineres af administratoren i designfasen af databasen. De er normalt få, strenge, og deres primære anvendelse er normalisering af data og design af relationsskemaet.
Den anden type er afhængigheder, der repræsenterer "skjulte" data og tidligere ukendte relationer mellem attributter. Det vil sige, at man ikke har tænkt over sådanne afhængigheder på tidspunktet for designet, og de opdages først på eksisterende datasæt, for derefter at trække konklusioner om de gemte oplysninger baseret på de mange identificerede funktionelle afhængigheder. Det er netop med sådanne afhængigheder, vi arbejder. Det er en hel disciplin inden for datamining, der involverer forskellige søgeteknikker og algoritmer bygget på deres grundlag. Lad os undersøge, hvordan de fundne funktionelle afhængigheder (præcise eller tilnærmede) kan være nyttige i nogle data.
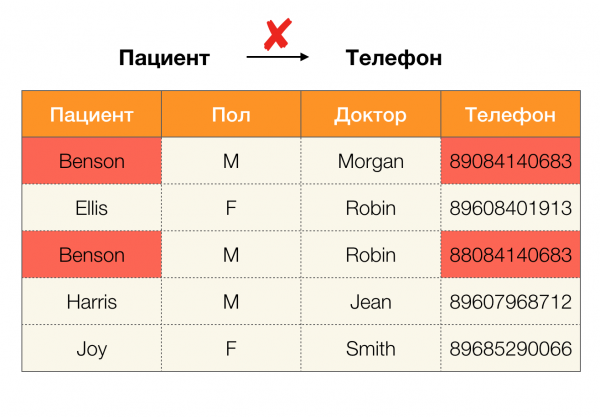
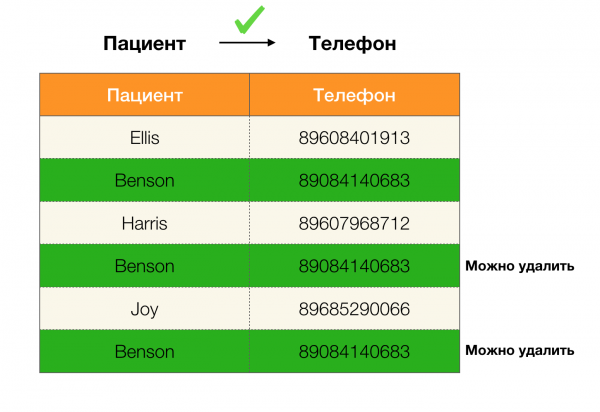
I dag выделяют несколько основных областей применения зависимостей, среди которых — очистка данных. Dette indebærer udvikling af processer til identifikation af "beskidte data", som derefter skal rettes. Klare repræsentanter for "beskidte data" inkluderer duplikater, fejl i dataene eller tastefejl, manglende værdier, forældede data, overflødige mellemrum og lignende.
Eksempel på en fejl i dataene:
Eksempel på duplikater i dataene:
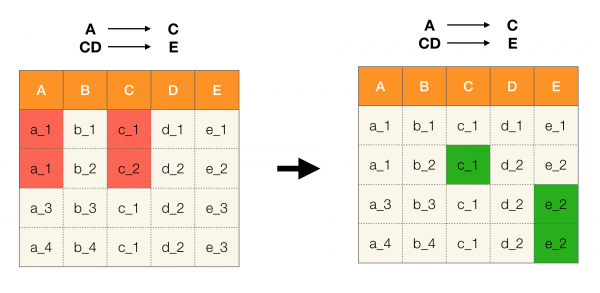
For eksempel har vi en tabel og et sæt funktionelle afhængigheder, der skal overholdes. Datacleaning i dette tilfælde indebærer at ændre dataene, så de funktionelle afhængigheder bliver sande. Samtidig skal antallet af modifikationer være minimalt (der findes specifikke algoritmer til denne procedure, som vi ikke vil fokusere på i denne artikel). Nedenfor er et eksempel på en sådan datatransformation. Til venstre er den oprindelige relation, hvor det tydeligt ses, at de nødvendige funktionelle afhængigheder ikke overholdes (et eksempel på overtrædelse af en af de funktionelle afhængigheder er fremhævet med rødt). Til højre præsenteres den opdaterede relation, hvor de grønne celler viser ændrede værdier. Efter denne procedure blev de nødvendige afhængigheder fastholdt.
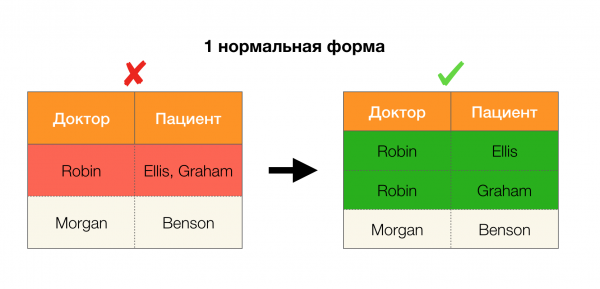
Et andet populært anvendelsesområde er databasens design. Her skal vi minde om normale former og normalisering. Normalisering er en proces, hvor et forhold bringes i overensstemmelse med et bestemt sæt krav, hvor hvert krav defineres af en normalform på sin egen måde. Vi vil ikke uddybe kravene for de forskellige normale former (det bliver behandlet i enhver bog om databaser for begyndere), men vi bemærker blot, at hver af dem på sin måde anvender konceptet funktionelle afhængigheder. For funktionelle afhængigheder er de i deres essens integritetsbegrænsninger, som tages i betragtning ved design af databasen (i denne kontekst kaldes funktionelle afhængigheder nogle gange supernøgler).
Lad os overveje deres anvendelse for de fire normale former på billedet nedenfor. Vi minder om, at Boyce-Codd-normalformen er strengere end den tredje form, men mindre streng end den fjerde. Den sidste overvejer vi ikke nu, da dens formulering kræver forståelse af mangesidede afhængigheder, som ikke er interessante i denne artikel.
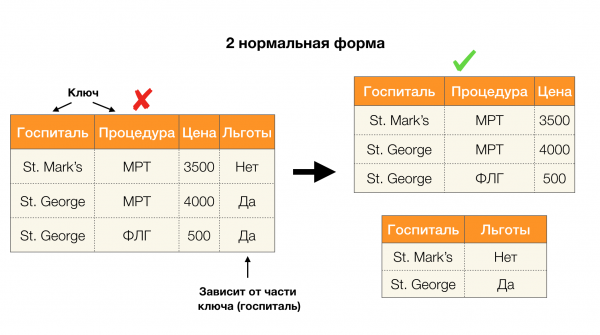
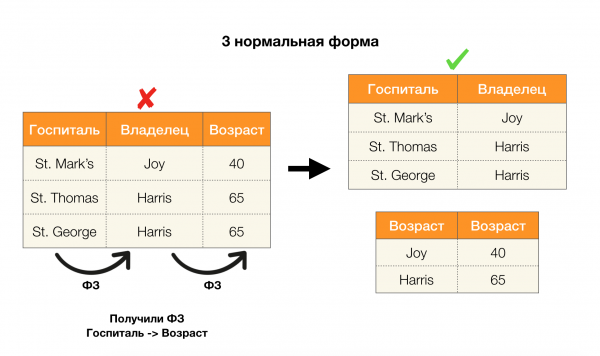
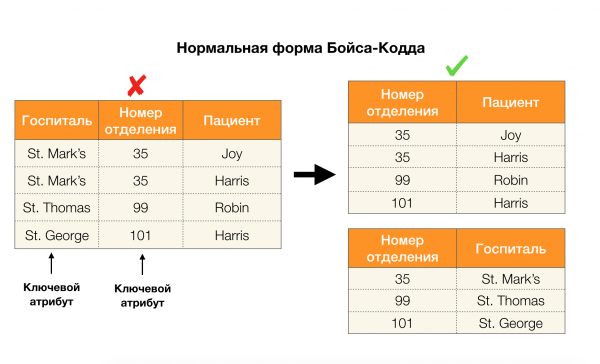
Et andet område, hvor afhængigheder har fundet anvendelse, er reduktion af dimensionerne i funktionsrum i opgaver som opbygning af en naiv bayesiansk klassifikator, udvinding af signifikante funktioner og reparmeterisering af en regressionsmodel. I de originale artikler kaldes denne opgave bestemmelse af overflødige funktioner (feature redundancy) og relevante funktioner (feature relevancy) [5, 6], og den løses aktivt med anvendelse af databaskonceptet. Med fremkomsten af sådanne arbejder kan vi sige, at der i dag er en efterspørgsel efter løsninger, der kombinerer databasen, analyse og implementeringen af de nævnte optimeringsproblemer i ét værktøj [7, 8, 9].
Der findes mange algoritmer til at finde funktionelle afhængigheder i datasættet (både moderne og mindre moderne). Disse algoritmer kan deles op i tre grupper:
- Algoritmer, der bruger gennemgang af algebraiske gitter (Lattice traversal algorithms)
- Algoritmer, der er baseret på søgning af konsistente værdier (Difference- and agree-set algorithms)
- Algoritmer, der er baseret på parvise sammenligninger (Dependency induction algorithms)
En kort beskrivelse af hver type algoritme er præsenteret i tabellen nedenfor:
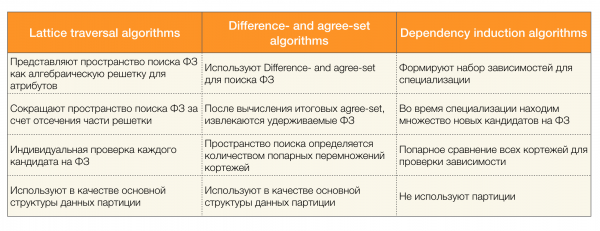
Læs mere om denne klassificering [4]. Nedenfor er eksempler på algoritmer for hver type:
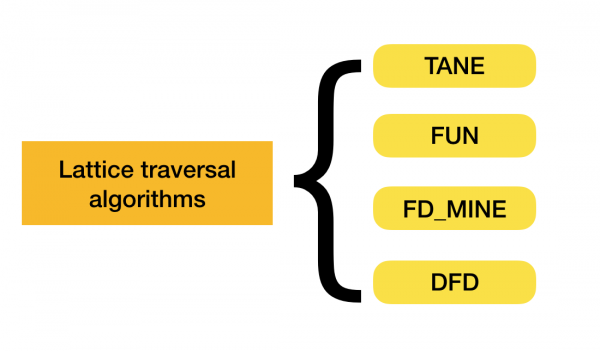
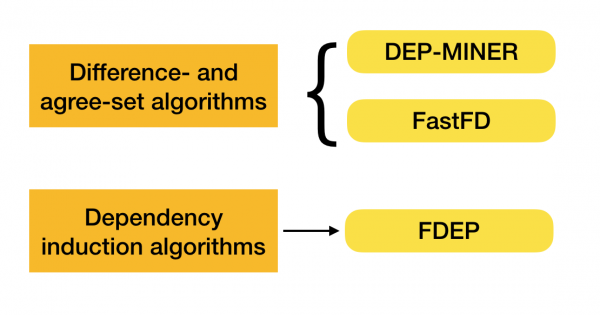
I øjeblikket dukker der nye algoritmer op, der kombinerer flere tilgange til at finde funktionelle afhængigheder. Eksempler på sådanne algoritmer er Pyro [2] og HyFD [3]. En analyse af deres funktion vil blive givet i de følgende artikler i denne serie. I denne artikel vil vi kun gennemgå de grundlæggende begreber og sætningen, der er nødvendige for at forstå teknikkerne til at identificere afhængigheder.
Lad os starte med det enkle — difference- og agree-set, som anvendes i den anden type algoritmer. Difference-set er et sæt af tupler, der ikke stemmer overens med værdierne, mens agree-set derimod er tupler, der stemmer overens med værdierne. Det er vigtigt at bemærke, at vi i dette tilfælde kun betragter venstre side af afhængigheden.
Et andet vigtigt begreb, som blev nævnt ovenfor, er den algebraiske gitter. Da mange moderne algoritmer opererer med dette begreb, er det nødvendigt for os at have en forståelse af, hvad det er.
For at indføre begrebet gitter er det nødvendigt at definere et delvist ordnet sæt (eller partially ordered set, forkortet — poset).
Definition 2. Man siger, at en mængde S er delvist ordnet ved hjælp af en binær forhold ⩽, hvis for enhver a, b, c ∈ S gælder egenskaberne:
- Refleksivitet, det vil sige a ⩽ a
- Antisymmetri, det vil sige, hvis a ⩽ b og b ⩽ a, så er a = b
- Transitivitet, det vil sige, for a ⩽ b og b ⩽ c følger, at a ⩽ c
Et sådant forhold kaldes en (ikke-streng) delvis ordning, og selve mængden kaldes et delvist ordnet sæt. Den formelle betegnelsen er: ⟨S, ⩽⟩.
Som et simpelt eksempel på et delvist ordnet sæt kan man tage mængden af alle naturlige tal N med det sædvanlige ordensforhold ⩽. Det er ikke svært at verificere, at alle nødvendige aksier er opfyldt.
Et mere indholdsrigt eksempel. Lad os overveje mængden af alle delmængder {1, 2, 3}, ordnet efter inklusionsforholdet ⊆. Dette forhold opfylder faktisk alle betingelserne for en delvis orden, derfor er ⟨P({1, 2, 3}), ⊆⟩ — et delvist ordnet sæt. I figuren nedenfor er strukturen af denne mængde vist: hvis man kan nå fra et element til et andet gennem pile, så er de i ordenforhold.
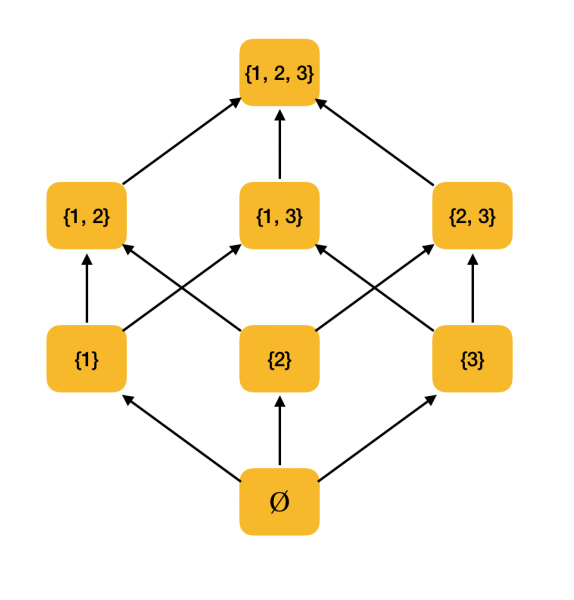
Vi har brug for endnu to enkle definitioner fra matematikken - supremum (supremum) og infimum (infimum).
Definition 3. Lad ⟨S, ⩽⟩ være en delvist ordnet mængde, A ⊆ S. Den øvre grænse for A er et element u ∈ S, sådan at ∀x ∈ S: x ⩽ u. Lad U være mængden af alle øvre grænser for S. Hvis der i U findes et mindste element, kaldes dette for supremum og betegnes som sup A.
Tilsvarende indføres begrebet præcise nederste grænse.
Definition 4. Lad ⟨S, ⩽⟩ være en delvist ordnet mængde, A ⊆ S. Den nederste grænse for A er et element l ∈ S, sådan at ∀x ∈ S: l ⩽ x. Lad L være mængden af alle nederste grænser for S. Hvis der i L findes et største element, kaldes dette for infimum og betegnes som inf A.
Lad os tage det ovenfor nævnte delvist ordnede mængde ⟨P ({1, 2, 3}), ⊆⟩ som et eksempel og finde supremum og infimum i det:
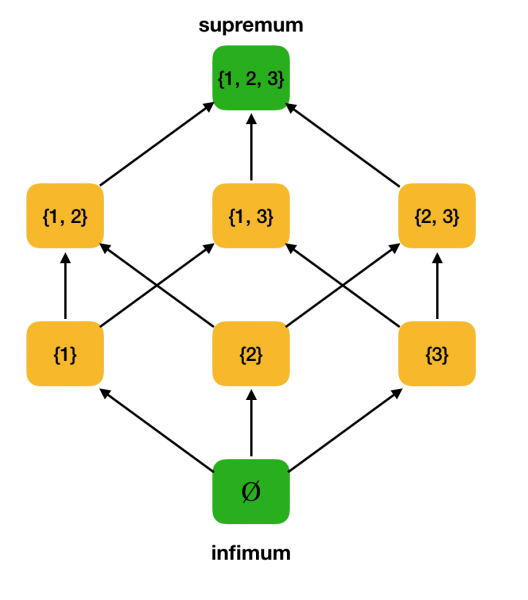
Nu kan vi formulere definitionen af en algebraisk gitter.
Definition 5. Lad ⟨P, ⩽⟩ være en delvist ordnet mængde, sådan at enhver to-element delmængde har præcise øvre og nederste grænser. Så kaldes P for en algebraisk gitter. Her skrives sup{x, y} som x ∨ y, og inf {x, y} som x ∧ y.
Lad os kontrollere, at vores arbejds eksempel ⟨P ({1, 2, 3}), ⊆⟩ er en gitter. Faktisk, for enhver a, b ∈ P ({1, 2, 3}), er a∨b = a∪b, og a∧b = a∩b. For eksempel, lad os tage mængderne {1, 2} og {1, 3} og finde deres infimum og supremum. Hvis vi krydser dem, får vi mængden {1}, som er infimum. Supremum opnår vi ved at forene dem - {1, 2, 3}.
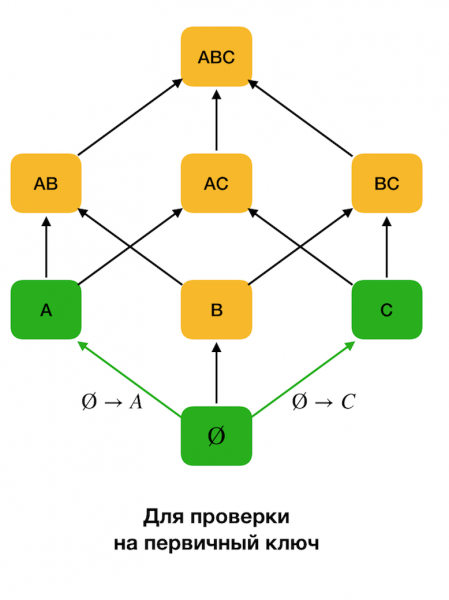
I algoritmer til identifikation af FZ præsenteres søgeområdet ofte i form af et gitter, hvor mængderne med ét element (læse første niveau af søge gitteret, hvor den venstre del af afhængighederne består af ét attribut) repræsenterer hvert attribut fra den oprindelige relation.
I starten betragtes afhængigheder af typen ∅ → Et enkelt attribut. Dette skridt gør det muligt at bestemme, hvilke attributter der er primære nøgler (for sådanne attributter findes der ingen determinanter, og derfor er den venstre del tom). Derefter bevæger sådanne algoritmer sig opad i gitteret. Det er værd at bemærke, at man ikke behøver at gennemgå hele gitteret, så hvis der gives en ønsket maksimalt størrelse for den venstre del, vil algoritmen ikke fortsætte længere op til niveauet med den størrelse.
Nedenfor er vist, hvordan man kan bruge en algebraisk gitter i opgaven med at finde FDs. Her repræsenterer hver kant (X, XY) en afhængighed X → Y. For eksempel har vi passeret det første niveau og ved, at afhængigheden holdes A → B (vi viser dette med en grøn forbindelse mellem noderne A og B). Det betyder, at når vi bevæger os opad i gitteret, kan vi undlade at kontrollere afhængigheden A, C → B, fordi den allerede ikke vil være minimal. Tilsvarende ville vi ikke kontrollere den, hvis afhængigheden C → B.
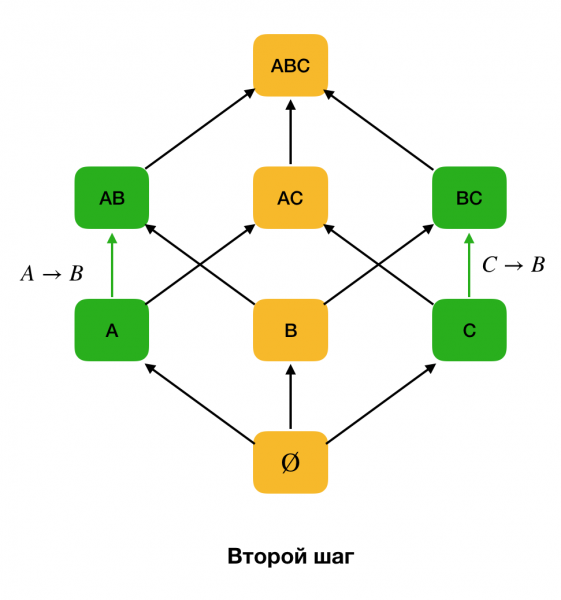
blev holdt. Derudover bruger alle moderne algoritmer til at finde FDs typisk en datastruktur kaldet partition (i originalen - stripped partition [1]). Den formelle definition af en partition ser således ud:
Definition 6. Lad X ⊆ R være et sæt af attributter for relationen r. En klynge er et sæt af indeks for tupler i r, som har samme værdi for X, det vil sige c(t) = {i|ti[X] = t[X]}. En partition er en mængde af klumper, der ekskluderer klumper med en længde på 1:

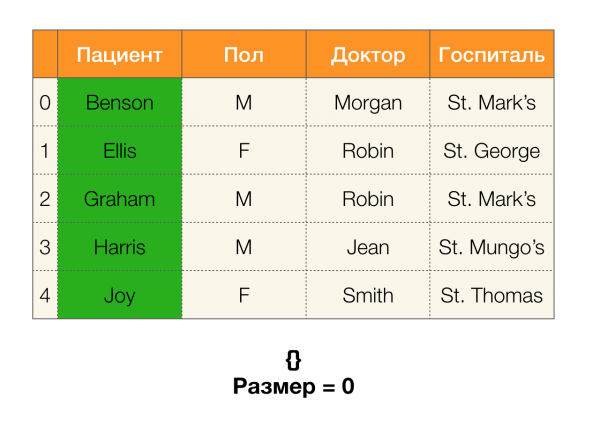
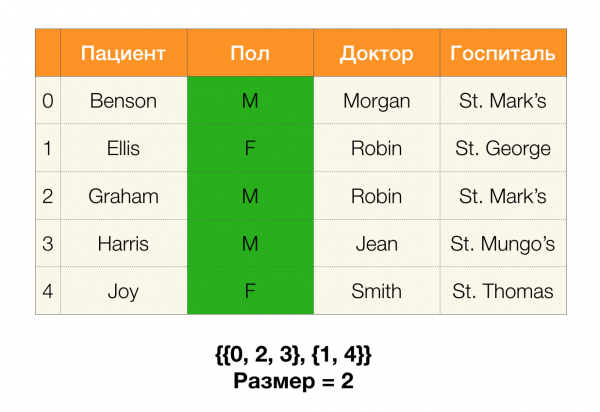
Enkelt sagt repræsenterer partitionen for attributten X et sæt af lister, hvor hver liste indeholder række numre med de samme værdier for X. I moderne litteratur kaldes strukturen, der repræsenterer partitioner, position list index (PLI). Klumper med en længde på 1 ekskluderes af komprimeringsårsager i PLI, fordi det er klumper, der kun indeholder nummeret på den post med en unik værdi, hvilket altid vil være nemt at fastslå.
Lad os overveje et eksempel. Lad os vende tilbage til den samme tabel med patienter og bygge partitioner for kolonnerne Patient og Køn (en ny kolonne til venstre viser række numrene i tabellen):
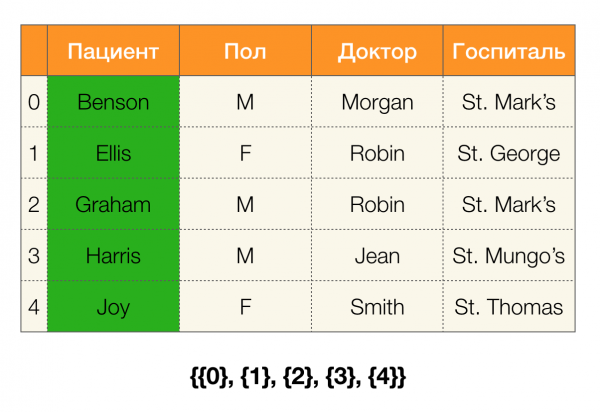
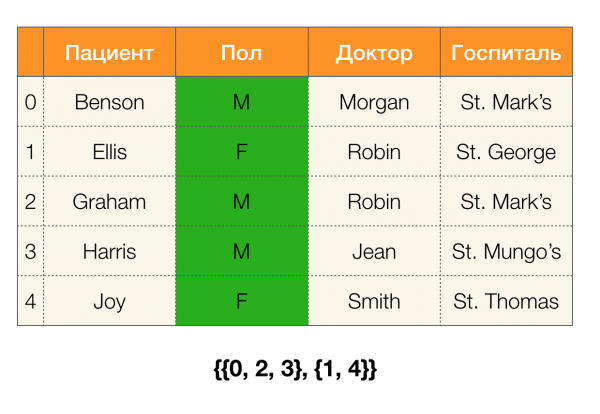
I dette tilfælde, ifølge definitionen, vil partitionen for kolonnen Patient faktisk være tom, da enkeltklumper ekskluderes fra partitionen.
Partitioner kan opnås ved flere attributter. Der er to måder at gøre dette på: ved at gå gennem tabellen for at bygge en partition straks for alle nødvendige attributter, eller ved at konstruere den ved hjælp af operationen af intersektion af partitioner over et delmængde af attributter. Algoritmer til at finde FDs bruger den anden mulighed.
Enkelt sagt, for at få en partition for kolonnerne, for eksempel ABC, kan man tage partitioner for AC og B (eller enhver anden mængde ikke-overlappende delmængder) og krydse dem med hinanden. At krydse to partitioner fremhæver de længste klynger, der er fælles for begge partitioner.
Lad os se på et eksempel:
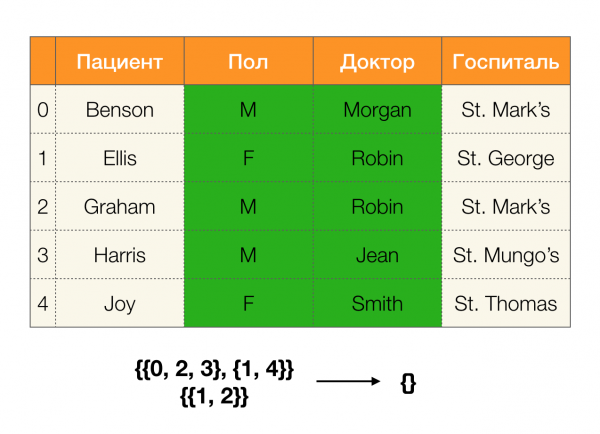
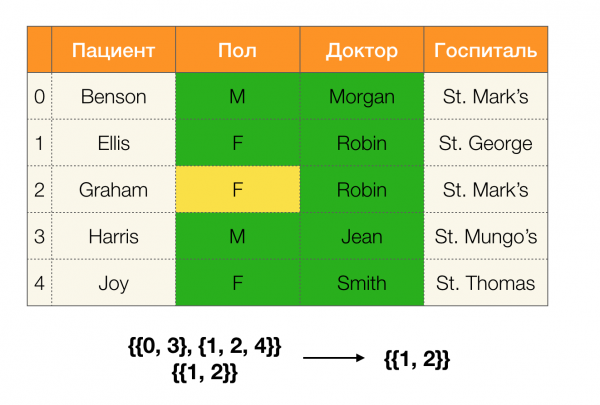
I det første tilfælde fik vi en tom partition. Ved at se nærmere på tabellen er der faktisk ingen ens værdier på de to attributter. Hvis vi derimod lidt ændrer tabellen (tilfælde til højre), får vi en ikke-tom krydsning. I denne situation indeholder rækkerne 1 og 2 faktisk ens værdier på attributterne. Køn og Doktor.
Dernæst har vi brug for begrebet partitionstørrelse. Formelt:

Sagt mere enkelt, partitionstørrelsen repræsenterer antallet af klynger, der indgår i partitionen (vi husker, at enkle klynger ikke indgår i partitionen!):
Nu kan vi definere en af de centrale sætninger, der for de givne partitioner muliggør at fastslå, om afhængigheden opretholdes eller ej:
Sætning 1. Afhængigheden A, B → C opretholdes, hvis og kun hvis

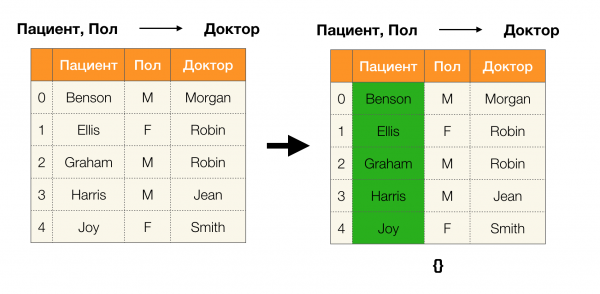
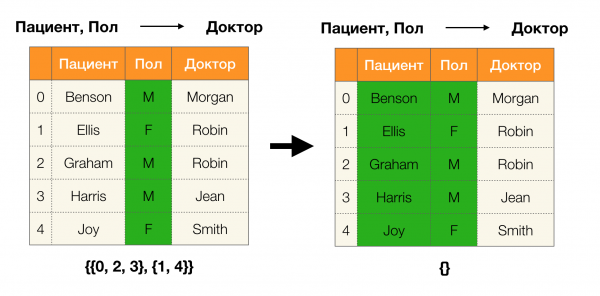
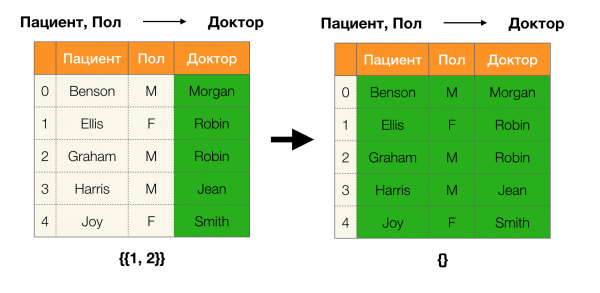
Ifølge sætningen er det nødvendigt at udføre fire trin for at bestemme, om afhængigheden opretholdes:
- Beregne partitionen for den venstre del af afhængigheden
- Beregne partitionen for den højre del af afhængigheden
- Beregne produktet af første og andet trin
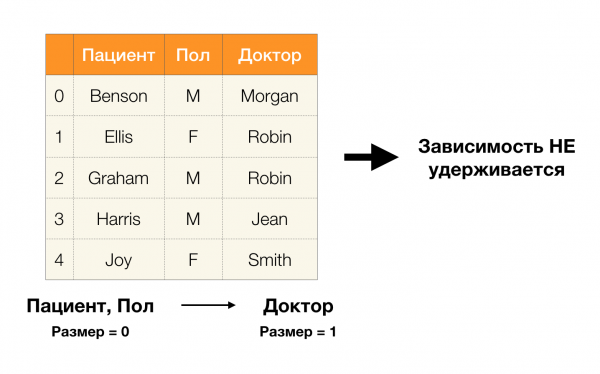
- Sammenligne størrelserne af partitionerne, der blev opnået i første og tredje trin
Nedenfor er et eksempel på kontrol af, om afhængigheden opretholdes i henhold til denne sætning:
I denne artikel har vi gennemgået begreber som funktionel afhængighed, nærmeste funktionelle afhængighed, set på, hvor de anvendes, samt hvilke algoritmer til søgning af FA der findes. Vi har også grundigt gennemgået de grundlæggende, men vigtige begreber, der aktivt anvendes i moderne algoritmer til søgning af FA.
Referencer:
- Huhtala Y. et al. TANE: En effektiv algoritme til at opdage funktionelle og approximative afhængigheder //The computer journal. – 1999. – Vol. 42. – No. 2. – S. 100-111.
- Kruse S., Naumann F. Effektiv opdagelse af approximative afhængigheder //Proceedings of the VLDB Endowment. – 2018. – Vol. 11. – No. 7. – S. 759-772.
- Papenbrock T., Naumann F. En hybrid tilgang til opdagelse af funktionelle afhængigheder //Proceedings of the 2016 International Conference on Management of Data. – ACM, 2016. – S. 821-833.
- Papenbrock T. et al. Opdagelse af funktionelle afhængigheder: En eksperimentel evaluering af syv algoritmer //Proceedings of the VLDB Endowment. – 2015. – Vol. 8. – No. 10. – S. 1082-1093.
- Kumar A. et al. At slå sig sammen eller ej?: Tænke en gang mere over sammenføjninger inden funktionel selektion //Proceedings of the 2016 International Conference on Management of Data. – ACM, 2016. – S. 19-34.
- Abo Khamis M. et al. In-database learning with sparse tensors // Proceedings of the 37th ACM SIGMOD-SIGACT-SIGAI Symposium on Principles of Database Systems. – ACM, 2018. – S. 325-340.
- Hellerstein J. M. et al. The MADlib analytics library: or MAD skills, the SQL // Proceedings of the VLDB Endowment. – 2012. – T. 5. – Nr. 12. – S. 1700-1711.
- Qin C., Rusu F. Speculative approximations for terascale distributed gradient descent optimization // Proceedings of the Fourth Workshop on Data analytics in the Cloud. – ACM, 2015. – S. 1.
- Meng X. et al. Mllib: Machine learning in apache spark // The Journal of Machine Learning Research. – 2016. – T. 17. – Nr. 1. – S. 1235-1241.
Artiklens forfattere: , forsker ved , og , forsker ved
Kilde: habr.com
