

Hej alle! Mit navn er Dmitry Samsonov, jeg arbejder som førende systemadministrator hos 'Odноклассники'. Vi har mere end 7.000 fysiske servere, 11.000 containere i vores cloud og 200 applikationer, der i forskellige konfigurationer danner 700 forskellige klynger. Størstedelen af serverne kører på CentOS 7.
Den 14. august 2018 blev der offentliggjort oplysninger om sårbarheden FragmentSmack
() og SegmentSmack (). Det er sårbarheder med et netværksangrebsvector og en relativt høj vurdering (7,5), der truer med serviceafbrydelse (DoS) på grund af ressourceudtømning (CPU). Der blev på det tidspunkt ikke tilbudt nogen patch i kernen for FragmentSmack; desuden blev den udgivet betydeligt senere end offentliggørelsen af oplysningerne om sårbarheden. For at håndtere SegmentSmack blev det foreslået at opdatere kernen. Selve opdateringspakken blev udgivet samme dag, det var kun nødvendigt at installere den.
Nej, vi er bestemt ikke imod at opdatere kernen! Men der er nuancer…
Sådan opdaterer vi kernen på prod
I det store og hele, ikke så svært:
- Hente pakkerne;
- Installere dem på et antal servere (inklusive servere, der hoster vores cloud);
- Sikre, at der ikke er noget, der er brudt;
- Sikre, at alle standardkernelindstillinger er anvendt uden fejl;
- Vente et par dage;
- Kontrollere servernes præstationer;
- Skifte deployment af nye servere til den nye kerne;
- Opdatere alle servere i datacentre (et datacenter ad gangen for at minimere effekten på brugerne i tilfælde af problemer);
- Genstarte alle servere.
Gentag for alle de varianter af kerner, vi har. I øjeblikket er dette:
- Standard CentOS 7 3.10 — til de fleste almindelige servere;
- Vanilla 4.19 — til vores , fordi vi har brug for BFQ, BBR osv.;
- Elrepo kernel-ml 5.2 — til , fordi 4.19 tidligere opførte sig ustabilt, og de samme funktioner er nødvendige.
Som du kunne gætte, tager det mest tid at genstarte tusindvis af servere. Da ikke alle sårbarheder er kritiske for alle servere, genstarter vi kun dem, der er direkte tilgængelige fra internettet. I skyen, for ikke at begrænse fleksibiliteten, binder vi ikke de extern tilgængelige containere til separate servere med en ny kerne, men genstarter alle værter uden undtagelse. Heldigvis er proceduren der lettere end med almindelige servere. For eksempel kan stateless-containere blot flytte til en anden server under rebooten.
Alligevel er der stadig meget arbejde, og det kan tage flere uger, og ved eventuelle problemer med den nye version kan det tage op til flere måneder. Kriminelle forstår dette perfekt, så der er brug for en plan "B".
FragmentSmack/SegmentSmack. Workaround
Heldigvis findes der en sådan plan "B" for nogle sårbarheder, og den kaldes Workaround. Det handler oftest om ændringer i kerne-/applikationsindstillinger, der gør det muligt at minimere den mulige effekt eller helt undgå udnyttelse af sårbarheder.
I tilfælde af FragmentSmack/SegmentSmack følgende Workaround:
«Man kan ændre standardværdierne 4MB og 3MB i net.ipv4.ipfrag_high_thresh og net.ipv4.ipfrag_low_thresh (og deres analoger for ipv6 net.ipv6.ipfrag_high_thresh og net.ipv6.ipfrag_low_thresh) til henholdsvis 256 kB og 192 kB eller lavere. Tests viser fra moderat til betydelig fald i CPU-forbruget under et angreb afhængigt af udstyret, indstillingerne og forholdene. Der kan dog være en vis indvirkning på ydeevnen på grund af ipfrag_high_thresh=262144 bytes, da kun to 64K-fragmenter kan være i køen til genopbygning på én gang. For eksempel er der en risiko for, at applikationer, der arbejder med store UDP-pakker, kan gå i stykker.».
Selve parametrene er beskrevet som:
ipfrag_high_thresh - LANG HELE TAL
     Maksimal hukommelse brugt til at samle IP-fragmenter.
ipfrag_low_thresh - LANG HEELE
     Maksimal hukommelse, der anvendes til at genopbygge IP-fragmenter, før kerne
     begynder at fjerne ufuldstændige fragmentkøer for at frigøre ressourcer.
     Kernen accepterer stadig nye fragmenter til defragmentering.
Vi har ikke produktionsservices med store UDP. I LAN er fragmenteret trafik fraværende, i WAN er det til stede, men ikke betydeligt. Intet tyder på, at man kan implementere Workaround!
FragmentSmack/SegmentSmack. Første blod
Det første problem, vi stødte på, var, at de cloud-containere undertiden kun anvendte nye indstillinger delvist (kun ipfrag_low_thresh), og nogle gange slet ikke – de crashede simpelthen ved opstart. Vi kunne ikke reproducere problemet stabilt (alle indstillinger blev anvendt uden problemer manuelt). At forstå, hvorfor containeren crashede ved opstart, er heller ikke så let: ingen fejl kunne findes. Én ting var dog helt sikkert: en rollback af indstillingerne løste problemet med container-crashes.
Hvorfor er det ikke tilstrækkeligt at anvende Sysctl på værten? Containere lever i deres dedikerede netværksnamespace, så i det mindste i containeren kan være anderledes end på værten.
Hvordan anvendes Sysctl-indstillingerne i containeren? Da vores containere er uden privilegier, kan vi ikke ændre nogen Sysctl-indstillinger ved at gå ind i selve containeren – vi har simpelthen ikke de rette tilladelser. Til at starte containere brugte vores cloud på det tidspunkt Docker (nu allerede) ). Docker modtog parametre for den nye container via API, inklusive de nødvendige Sysctl-indstillinger.
Under gennemgang af versioner viste det sig, at Docker API ikke returnerede alle fejl (i det mindste i version 1.10). Ved forsøg på at starte containeren via “docker run” så vi endelig noget:
write /proc/sys/net/ipv4/ipfrag_high_thresh: invalid argument docker: Error response from daemon: Cannot start container : [9] System error: kunne ikke synkronisere med containerprocessen.
Parameterens værdi er ikke gyldig. Men hvorfor? Og hvorfor er den ikke gyldig kun nogle gange? Det viste sig, at Docker ikke garanterer rækkefølgen for anvendelse af Sysctl-parametrene (den senest kontrollerede version - 1.13.1), så nogle gange forsøgte ipfrag_high_thresh at sætte sig på 256K, når ipfrag_low_thresh stadig var 3M, hvilket betyder, at den øverste grænse var lavere end den nederste, hvilket førte til fejlen.
På det tidspunkt havde vi allerede implementeret vores mekanisme til efterkonfiguration af containeren efter start (frysning af containeren via og udførelse af kommandoer i containerens namespace via ), og vi tilføjede også registreringen af Sysctl-parametrene i denne del. Problemet blev løst.
FragmentSmack/SegmentSmack. Første blod 2
Vi nåede knap at finde ud af, hvordan Workaround skulle anvendes i skyen, før de første sjældne klager fra brugerne begyndte at komme ind. På det tidspunkt var der gået flere uger siden begyndelsen af anvendelsen af Workaround på de første servere. Den indledende efterforskning viste, at klagerne kom fra specifikke tjenester og ikke fra alle servere for disse tjenester. Problemet havde igen en ekstremt usikker karakter.
Først og fremmest forsøgte vi selvfølgelig at rulle Sysctl-indstillingerne tilbage, men det gav ingen effekt. Forskellige manipulationer med server- og applikationsindstillingerne hjalp heller ikke. En genstart hjalp. Genstart af Linux er lige så unaturligt, som det engang var en normal betingelse for arbejde med Windows. Ikke desto mindre hjalp det, og vi tilskrev det et "kernefejl" ved anvendelsen af de nye Sysctl-indstillinger. Hvor letfærdigt…
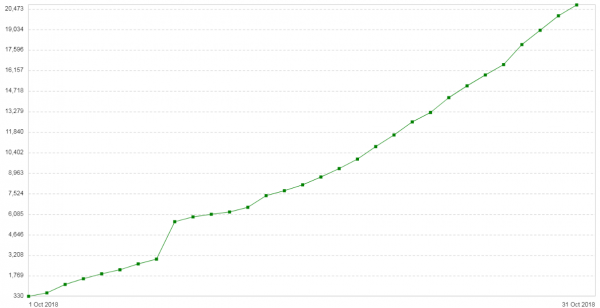
Tre uger senere opstod problemet igen. Konfigurationen af disse servere var ret enkel: Nginx i proxy/balanceringsmodus. Der var lidt trafik. En ny oplysning: antallet af 504-fejl på klienterne stiger dag for dag (). Grafen viser antallet af 504-fejl pr. dag for denne tjeneste:
Alle fejl vedrører den samme backend — den, der er i skyen. Grafen for hukommelsesforbruget til pakkefragmenter på denne backend så således ud:
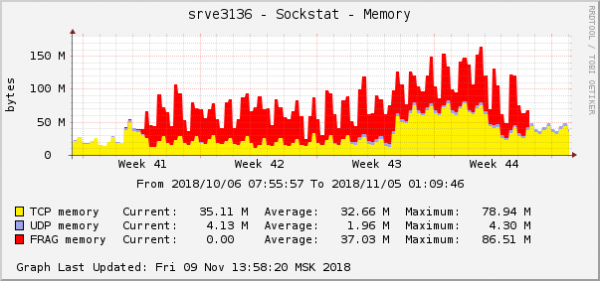
Dette er et af de mest markante udtryk for problemet på driftsystemets grafer. I skyen blev der netop på dette tidspunkt rettet en anden netværksfejl vedrørende QoS-indstillinger (Traffic Control). Grafen for hukommelsesforbruget til pakkefragmenter så helt ens ud:
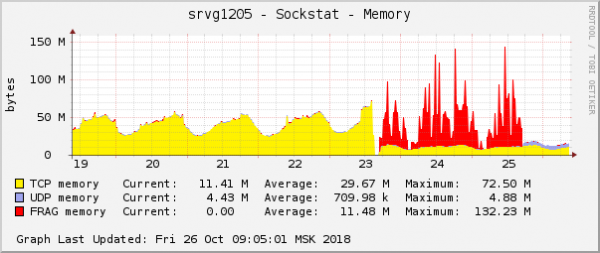
Antagelsen var enkel: hvis de ser ens ud på graferne, så er årsagen også den samme. Især da problemer med denne type hukommelse sjældent opstår.
Kernen i det løste problem var, at vi brugte en pakkeplanlægger fq i QoS med standardindstillinger. Som standard tillader den at tilføje 100 pakker til køen for én forbindelse, og nogle forbindelser begyndte i situationer med utilstrækkelig båndbredde at fylde køen helt op. I dette tilfælde droppes pakkerne. I statistikken fra tc (tc -s qdisc) ses dette sådan:
qdisc fq 2c6c: forælder 1:2c6c grænse 10000p flow_limit 100p buckets 1024 orphan_mask 1023 quantum 3028 initial_quantum 15140 refill_delay 40.0ms
  Sendt 454701676345 bytes 491683359 pkt (droppet 464545, overgrænser 0 omprioriteringer 0)
  backlog 0b 0p omprioriteringer 0
   1024 flows (1021 inaktive, 0 throttled)
   0 gc, 0 highprio, 0 throttled, 464545 flows_plimit
«464545 flows_plimit» er de pakker, der er droppet på grund af overskridelse af køgrænsen for en forbindelse, og «dropped 464545» er summen af alle droppede pakker fra denne scheduler. Efter at have øget køens længde til 1.000 og genstartet containerne, forsvandt problemet. Man kan læne sig tilbage i stolen og nyde en smoothie.
FragmentSmack/SementSmack. Sidste blod
For det første, efter flere måneder efter offentliggørelsen af sårbarhederne i kernen, er der endelig kommet en løsning på FragmentSmack (jeg minder om, at der kun kom en løsning til SegmentSmack ved offentliggørelsen i august), hvilket gav os mulighed for at undgå den workaround, der havde givet os en del udfordringer. Nogle af serverne var vi allerede nået at opgradere til den nye kerne, og nu skulle vi starte forfra. Hvorfor opdaterede vi kernen uden at vente på løsningen til FragmentSmack? Problemet er, at beskyttelsesprocessen mod disse sårbarheder sammenfaldt (og fusionerede) med opdateringsprocessen af selve CentOS (som tager endnu længere tid end at opdatere kun kernen). Desuden er SegmentSmack en mere farlig sårbarhed, og løsningen til den kom med det samme, så der var alligevel mening i det. Men vi kunne ikke bare opdatere kernen på CentOS, fordi sårbarheden FragmentSmack, der opstod i CentOS 7.5, først blev løst i version 7.6, så vi måtte stoppe opdateringen til 7.5 og starte forfra med opdateringen til 7.6. Sådan kan det også ske.
For det andet er der kommet sjældne klager fra brugere om problemer. Vi ved nu med sikkerhed, at alle disse er relateret til filupload fra kunder til nogle af vores servere. Desuden var der kun meget få uploads tilgængelige fra den samlede mængde.
Som vi husker fra tidligere, hjalp rollback af Sysctl ikke. Genstart hjalp, men kun midlertidigt.
Mistanken om Sysctl blev ikke afvist, men denne gang var det nødvendigt at samle så meget information som muligt. Det var også meget svært at kunne reproducere uploadproblemet fra kunden for mere præcist at undersøge, hvad der skete.
Analysering af al tilgængelig statistik og logs førte os ikke tættere på forståelsen af, hvad der foregik. Det var akut nødvendigt at kunne reproducere problemet for at "føle" det specifikke forbindelsesproblem. Endelig lykkedes det udviklerne på den specielle version af applikationen at opnå stabil reproduktion af problemerne på testenheden, når der blev tilsluttet via Wi-Fi. Dette var et gennembrud i efterforskningen. Klienten tilsluttede sig Nginx, som proxyede til backend, som var vores Java-applikation.
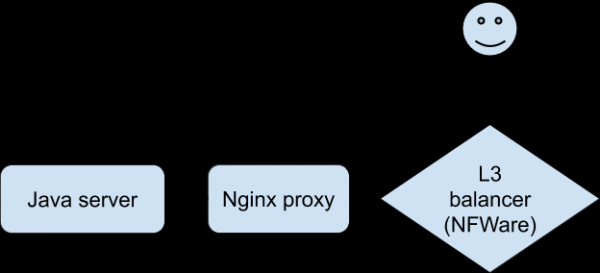
Dialogen under problemerne var som følger (optegnet på siden af Nginx-proxyen):
- Klient: anmodning om at modtage information om filnedlægningsprocessen.
- Java-server: svar.
- Klient: POST med en fil.
- Java-server: fejl.
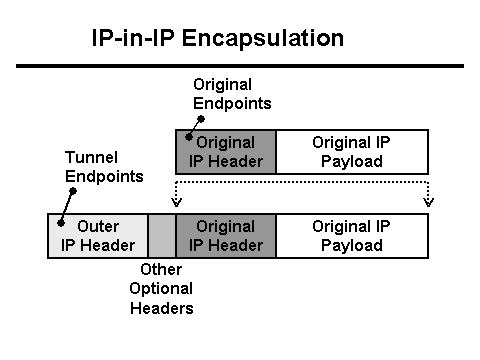
Java-serveren skriver samtidig i loggen, at der er modtaget 0 byte data fra klienten, mens Nginx-proxyen rapporterer, at anmodningen tog mere end 30 sekunder (30 sekunder er timeouttiden i klientapplikationen). Hvorfor timeout og hvorfor 0 byte? Set fra HTTP-synspunkt fungerer alt som det skal, men POST med filen forsvinder tilsyneladende fra netværket. Desuden forsvinder den mellem klienten og Nginx. Det er tid til at væbne sig med Tcpdump! Men først skal vi forstå netværkskonfigurationen. Nginx-proxyen står bag en L3-loadbalancer. . Der anvendes tunneling til overførsel af pakker fra L3-loadbalanceren til serveren, hvilket tilføjer sine egne headers til pakkerne:
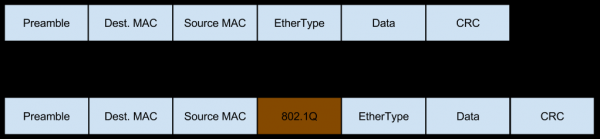
Samtidig ankommer netværket til denne server i form af VLAN-tagget trafik, som også tilføjer sine egne felter til pakkerne:
Og denne trafik kan også fragmenteres (den lille procentdel af indkommende fragmenteret trafik, som vi talte om ved vurderingen af risici fra Workaround), hvilket også ændrer indholdet af headers:
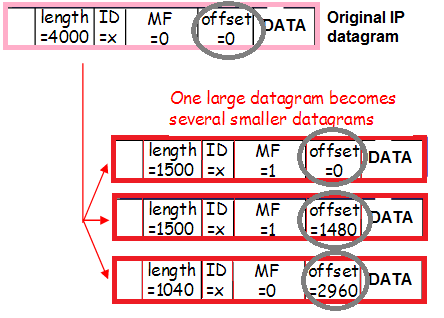
En gang til: pakkerne er inkapslet i VLAN-tag, inkapslet i tunnelen, fragmenteret. For bedre at forstå, hvordan dette sker, lad os følge pakkevejen fra klienten til Nginx-proxyen.
- Pakken når L3-loadbalanceren. For korrekt routing inden for datacenteret inkapsles pakken i tunnelen og sendes til netværkskortet.
- Da pakken + tunnelfelterne ikke passer ind i MTU, opdeles pakken i fragmenter og sendes ud i netværket.
- Switch'en efter L3-loadbalanceren tilføjer en VLAN-tag til pakken, når den modtager den, og sender den videre.
- Switchen før Nginx-proxien ser (ifølge porteindstillingerne), at serveren forventer en Vlan-inkapslet pakke, så den sender den, som den er, uden at fjerne Vlan-tagget.
- Linux modtager fragmenter af individuelle pakker og samler dem til en stor pakke.
- Dernæst kommer pakken til Vlan-interfacet, hvor det første lag — Vlan-inkapslingen — fjernes.
- Derefter sender Linux den til Tunnel-interfacet, hvor endnu et lag — Tunnel-inkapslingen — fjernes.
Udfordringen ligger i at overføre det hele som parametre til tcpdump.
Lad os starte fra slutningen: Er der rene (uden unødvendige overskrifter) IP-pakker fra kunderne, som har fået fjernet vlan- og tunnel-inkapslingen?
tcpdump host
Nej, der var ingen sådanne pakker på serveren. Derfor må problemet ligge tidligere. Er der pakker med kun Vlan-inkapslingen fjernet?
tcpdump ip[32:4]=0xx390x2xx
0xx390x2xx — dette er klientens IP-adresse i hex-format.
32:4 — adressen og længden af feltet, hvor SCR IP er gemt i Tunnel-pakken.
Feltadressen måtte findes ved prøvning, da der på internettet skrives om 40, 44, 50, 54, men der var ingen IP-adresser. Man kan også se en af pakkerne i hex (parameter -xx eller -XX i tcpdump) og tælle, hvilken adresse den kendte IP har.
Er der fragments pakker uden fjernet Vlan- og Tunnel-inkapsling?
tcpdump ((ip[6:2] > 0) and (not ip[6] = 64))
Denne magi vil vise os alle fragmenter, inklusive det sidste. Man kan sikkert også filtrere det efter IP, men jeg har ikke forsøgt, da der ikke er mange sådanne pakker, og det var let at finde dem, jeg havde brug for, blandt det samlede flow. Her er de:
14:02:58.471063 I 00:de:ff:1a:94:11 ethertype IPv4 (0x0800), længde 1516: (tos 0x0, ttl 63, id 53652, offset 0, flags [+], proto IPIP (4), længde 1500)
     11.11.11.11 > 22.22.22.22: truncated-ip - 20 bytes mangler! (tos 0x0, ttl 50, id 57750, offset 0, flags [DF], proto TCP (6), længde 1500)
     33.33.33.33.33333 > 44.44.44.44.80: Flags [.], seq 0:1448, ack 1, win 343, options [nop,nop,TS val 11660691 ecr 2998165860], længde 1448
         0x0000: 0000 0001 0006 00de fb1a 9441 0000 0800 ...........A....
         0x0010: 4500 05dc d194 2000 3f09 d5fb 0a66 387d E.......?....f8}
         0x0020: 1x67 7899 4500 06xx e198 4000 3206 6xx4 .faEE.....@.2.m.
         0x0030: b291 x9xx x345 2541 83b9 0050 9740 0x04 .......A...P.@..
         0x0040: 6444 4939 8010 0257 8c3c 0000 0101 080x dDI9...W.......
         0x0050: 00b1 ed93 b2b4 6964 xxd8 ffe1 006a 4578 ......ad.....jEx
         0x0060: 6966 0000 4x4d 002a 0500 0008 0004 0100 if..MM.*........
14:02:58.471103 Ind 00:de:ff:1a:94:11 ethertype IPv4 (0x0800), længde 62: (tos 0x0, ttl 63, id 53652, offset 1480, flags [none], proto IPIP (4), længde 40)
11.11.11.11 > 22.22.22.22: ip-proto-4
0x0000: 0000 0001 0006 00de fb1a 9441 0000 0800 ...........A....
0x0010: 4500 0028 d194 00b9 3f04 faf6 2x76 385x E..(....?....f8}
0x0020: 1x76 6545 xxxx 1x11 2d2c 0c21 8016 8e43 .faE...D-,.!...C
0x0030: x978 e91d x9b0 d608 0000 0000 0000 7c31 .x............|Q
0x0040: 881d c4b6 0000 0000 0000 0000 0000 ..............
Dette er to fragmenter af én pakke (samme ID 53652) med et billede (ordet Exif ses i den første pakke). Fordi pakker på dette niveau findes, men ikke i samlet form i dumpene — er problemet tydeligvis i samlingen. Endelig er der dokumentation for dette!
Pakke-dekoder fandt ingen problemer, der forhindrede samlingen. Har prøvet her: Først, da der blev forsøgt at putte noget ind, kunne dekoderen ikke lide formatet af pakken. Det viste sig, at der var to unødvendige oktetter mellem Srcmac og Ethertype (som ikke vedrørte fragmentinformationer). Efter deres fjernelse fungerede dekoderen. Dog viste den ingen problemer.
Uanset hvordan man vender og drejer det, fandtes der ikke noget andet end de specifikke Sysctl. Det var nødvendigt at finde en måde at identificere problembaserede servere på for at forstå omfanget og træffe beslutninger om yderligere handlinger. Det blev hurtigt klart, hvilken tæller der var nødvendig:
netstat -s | grep "packet reassembles failed"
Den findes også i snmpd under OID=1.3.6.1.2.1.4.31.1.1.16.1 ().
«Antallet af fejl registreret af IP re-sammensætningsalgoritmen (af hvilken som helst årsag: timeout, fejl osv.)».
Blandt gruppen af servere, hvor problemet blev undersøgt, blev tælleren hurtigt øget på to af dem, langsommere på to andre, og på to slet ikke øget. Sammenligningen af denne tællers dynamik med dynamikken af HTTP-fejl på Java-serveren afslørede en korrelation. Det vil sige, at tælleren kunne sættes til overvågning.
Tilstedeværelsen af en pålidelig indikator for problemer er meget vigtig for nøjagtigt at kunne bestemme, om en tilbageførsel af Sysctl hjælper, da vi fra den tidligere fortælling ved, at dette ikke kan forstås straks ud fra applikationen. Denne indikator ville have gjort det muligt at identificere alle problematiske steder i produktionen, før brugerne opdagede dem.
Efter tilbageførslen af Sysctl stoppede overvågningsfejlene, hvilket dermed beviste årsagen til problemerne, ligesom at tilbageførelsen hjælper.
Vi rullede indstillingerne for fragmentering tilbage på andre servere, hvor ny overvågning blev aktiveret, og nogle steder tildelte vi endda mere hukommelse til fragmenter end der tidligere var standard (det var udp-statistik, hvis delvise tab ikke var synlige i det samlede billede).
De vigtigste spørgsmål
Hvorfor fragmenteres pakkerne på vores L3-loadbalancer? De fleste pakker, som ankommer fra brugerne til balancerne, er SYN og ACK. Størrelsen på disse pakker er lille. Men da andelen af sådanne pakker er meget høj, bemærkede vi ikke de store pakker, der begyndte at blive fragmenteret.
Årsagen var et beskadiget konfigurationsscript På servere med Vlan-grænseflader (servere med tagget trafik var på det tidspunkt i produktion meget få). Advmss gør det muligt at informere kunden om, at pakkerne i vores retning skal være mindre, så de ikke skal fragmenteres efter påsætning af tunneloverskrifter.
Hvorfor hjalp tilbageførsel af Sysctl ikke, men genstart gjorde? Tilbageførelsen af Sysctl ændrede mængden af hukommelse, der var tilgængelig til at sammenkæde pakker. Samtidig, tilsyneladende, førte selve faktum, at hukommelsen til fragmenter blev overbelastet, til forsinkelser i forbindelserne, hvilket medførte, at fragmenterne blev forsinket i lang tid i køen. Dvs. processen blev cyklisk.
Genstart nulstillede hukommelsen, og alt faldt på plads.
Kunne man klare sig uden workaround? Ja, men der var stor risiko for at efterlade brugerne uden support i tilfælde af angreb. Naturligvis førte anvendelsen af workaround til forskellige problemer, inklusive forsinkelser i en af tjenesterne for brugerne, men vi mener alligevel, at handlingerne var berettigede.
Stort tak til Andrey Timofeyev () for hjælpen med at gennemføre undersøgelsen, samt til Alexey Krenyov () — for det titaniske arbejde med at opdatere Centos og kerner på serverne. En proces, som i dette tilfælde måtte startes forfra flere gange, hvilket forsinkede det i mange måneder.
Kilde: habr.com
