

Hej alle sammen!
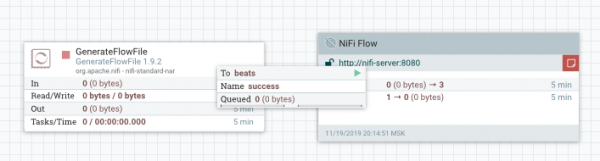
Opgaven er som følger — der er et flow, som vist på billedet ovenfor, som skal implementeres på N servere med . Flowet er et testflow — der genereres en fil og sendes til en anden NiFi-instans. Dataoverførslen sker ved hjælp af NiFi Site to Site-protokollen.
NiFi Site to Site (S2S) — en sikker, let konfigurerbar metode til dataoverførsel mellem NiFi-instans. Se hvordan S2S fungerer i og det er vigtigt ikke at glemme at konfigurere NiFi-instansen, så den tillader S2S fra .
I de tilfælde, hvor der tales om dataoverførsel ved hjælp af S2S — kaldes den ene instans klientinstansen, den anden serverinstansen. Klienten sender data, serveren modtager. Der er to måder at konfigurere dataoverførsel mellem dem:
- Push. Data sendes fra klientinstansen ved hjælp af Remote Process Group (RPG). På serverinstansen modtages dataene ved hjælp af Input Port
- Pull. Serveren modtager data ved hjælp af RPG, mens klienten sender ved hjælp af Output port.
Flowet til implementering opbevares i Apache Registry.
Apache NiFi Registry — et delprojekt af Apache NiFi, der repræsenterer et værktøj til at opbevare flows og administrere versioner. En slags GIT. Oplysninger om installation, konfiguration og arbejde med registry kan findes i . Flowet til opbevaring samles i en process group og opbevares i denne form i registry. Dette vil vi vende tilbage til senere i artiklen.
I starten, når N er et lille tal, leveres og opdateres flowet manuelt inden for en rimelig tidsramme.
Men med stigningen af N opstår der flere problemer:
- det tager længere tid at opdatere flowet. Man skal logge ind på alle servere
- der opstår fejl i opdateringen af skabeloner. Her blev det opdateret, men her blev der glemt
- menneskelige fejl ved udførelsen af et stort antal ensartede operationer
Alt dette fører os til, at vi skal automatisere processen. Jeg har prøvet følgende metoder til at løse denne opgave:
- Brug MiNiFi i stedet for NiFi
- NiFi CLI
- NiPyAPI
Brug af MiNiFi
— underprojektet Apache NiFi. MiNiFy — en kompakt agent, der bruger de samme processorer som NiFi, og som muliggør at skabe de samme flows som i NiFi. Agentens letvægtsdesign opnås blandt andet ved, at MiNiFy ikke har en grafisk brugerflade til konfiguration af flow. Manglen på en grafisk brugerflade i MiNiFy betyder, at problemet med at levere flow til Minifi skal løses. Da MiNiFy anvendes aktivt i IoT, er der mange komponenter, og leveringen af flow til de endelige instanser af MiNiFy skal automatiseres. En velkendt opgave, ikke sandt?
Sådan en opgave kan løses med endnu et underprojekt — MiNiFi C2 Server. Dette produkt er designet til at være det centrale punkt i arkitekturen for udrulning af konfigurationer. Hvordan man konfigurerer miljøet er beskrevet i på Habr, og der er tilstrækkelig information til at løse den stillede opgave. MiNiFi opdaterer automatisk sin konfiguration i forbindelse med C2 Server. Den eneste ulempe ved denne tilgang er, at man skal oprette skabeloner på C2 Server; en simpel commit til registreringen er ikke tilstrækkelig.
Den løsning, der er beskrevet i ovenstående artikel, er fungerende og ikke svær at implementere, men man skal huske følgende:
- I MiNiFy er ikke alle processorer fra NiFi
- Versionerne af processorerne i MiNiFy er forsinket i forhold til versionerne af processorerne i NiFi.
På tidspunktet for denne publikation er den nyeste version af NiFi — 1.9.2. Versionen af processorerne i den nyeste version af MiNiFi — 1.7.0. Processorer kan tilføjes til MiNiFi, men på grund af versionerne mellem processorerne i NiFi og MiNiFi, kan det muligvis ikke fungere.
NiFi CLI
Ifølge af værktøjet på den officielle hjemmeside, er det et værktøj til at automatisere interaktionen mellem NiFi og NiFi Registry inden for levering af flow eller processtyring. For at begynde at arbejde, skal dette værktøj downloades .
Vi starter værktøjet
.\/bin\/cli.sh
           _     ___  _
 Apache   (_)  .' ..](_)   ,
 _ .--.   __  _| |_  __    )
[ `.-. | [  |'-| |-'[  |  \/
|  | | |  | |  | |   | | '    '
[___||__][___][___] [___]',  ,'
                           `'
          CLI v1.9.2

Type 'help' to see a list of available commands, use tab to auto-complete.
For at indlæse det nødvendige flow fra registreringen, skal vi kende identifikatorerne for bucket (bucket identifier) og selve flowet (flow identifier). Disse oplysninger kan fås enten via CLI eller i webgrænsefladen til NiFi registry. I webgrænsefladen ser det således ud:
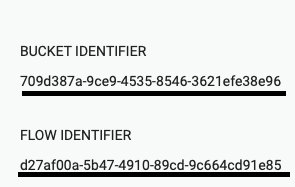
Med CLI gøres det sådan:
#> registry list-buckets -u http://nifi-registry:18080

#   Name             Id                                     Description
-   --------------   ------------------------------------   -----------
1   test_bucket   709d387a-9ce9-4535-8546-3621efe38e96   (empty)

#> registry list-flows -b 709d387a-9ce9-4535-8546-3621efe38e96 -u http://nifi-registry:18080

#   Name           Id                                     Description
-   ------------   ------------------------------------   -----------
1   test_flow   d27af00a-5b47-4910-89cd-9c664cd91e85
Vi starter importen af processgruppen fra registreringen:
#> nifi pg-import -b 709d387a-9ce9-4535-8546-3621efe38e96 -f d27af00a-5b47-4910-89cd-9c664cd91e85 -fv 1 -u http://nifi:8080

7f522a13-016e-1000-e504-d5b15587f2f3
Et vigtigt punkt — som vært kan enhver instans af nifi angives for den processgruppe, vi implementerer.
Processgruppen er tilføjet med stoppede processorer, og de skal startes.
#> nifi pg-start -pgid 7f522a13-016e-1000-e504-d5b15587f2f3 -u http://nifi:8080
Fantastisk, processorerne er startet. Men ifølge opgavebetingelserne skal NiFi-instanserne sende data til andre instanser. Lad os antage, at vi har valgt Push-metoden til dataoverførsel til serveren. For at organisere dataoverførslen skal vi aktivere dataoverførsel på den tilføjede Remote Process Group (RPG), som allerede er inkluderet i vores flow (Enable transmitting).
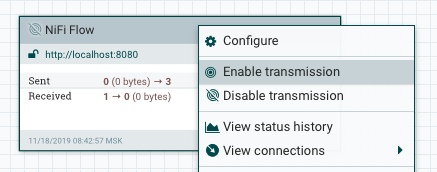
I dokumentationen, i CLI og andre kilder, har jeg ikke fundet en måde at aktivere dataoverførslen. Hvis du ved, hvordan man gør det — skriv venligst en kommentar.
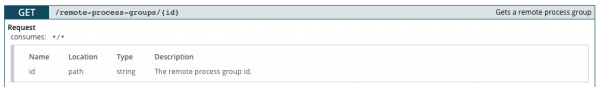
Da vi har bash, og vi er klar til at gå hele vejen — lad os finde en løsning! Vi kan bruge NiFi API til at løse dette problem. Vi bruger følgende metode, ID'en tages fra de tidligere eksempler (i vores tilfælde er det 7f522a13-016e-1000-e504-d5b15587f2f3). Beskrivelse af metoderne i NiFi API .
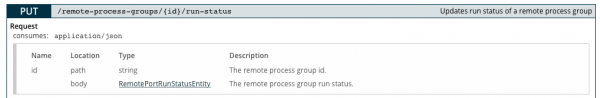
I body skal der sendes JSON af følgende type:
{
    "revision": {
	    "clientId": "value",
	    "version": 0,
	    "lastModifier": "value"
	},
    "state": "value",
    "disconnectedNodeAcknowledged": true
}
Parametre, der skal udfyldes for at "det virker":
state — status for dataoverførsel. Tilgængeligt TRANSMITTING for at aktivere dataoverførsel, STOPPED for at deaktivere.
version — versionen af processoren.
versionen vil som standard være 0 ved oprettelse, men disse parametre kan hentes ved hjælp af metoden.
For bash-script entusiaster kan denne metode virke anvendelig, men det er ikke min yndlings — bash-scripts er ikke det, jeg elsker mest. Den næste metode er mere interessant og mere praktisk efter min mening.
NiPyAPI
NiPyAPI — et Python-bibliotek til interaktion med instanser af NiFi. indeholder de nødvendige oplysninger til at arbejde med biblioteket. Hurtig start er beskrevet i på github.
Vores script til udrulning af konfigurationen — et program i Python. Lad os gå i gang med kodningen.
Vi konfigurerer indstillingerne til videre arbejde. Vi har brug for følgende parametre:
nipyapi.config.nifi_config.host = 'http://nifi:8080/nifi-api' #vej til nifi-api instansen, hvor vi implementerer processgruppen
nipyapi.config.registry_config.host = 'http://nifi-registry:18080/nifi-registry-api' #vej til nifi-registry-api registry
nipyapi.config.registry_name = 'MyBeutifulRegistry' #navnet på registry, som det vil blive kaldt i nifi instansen
nipyapi.config.bucket_name = 'BucketName' #navnet på bucket, som vi henter flow fra
nipyapi.config.flow_name = 'FlowName' #navnet på flowet, som vi henter
Fremover vil jeg indsætte navne på metoder fra dette bibliotek, som er beskrevet .
Vi forbinder registry til instansen nifi ved hjælp af
nipyapi.versioning.create_registry_clientPå dette trin kan vi også tilføje en kontrol for, om registry allerede er tilføjet til instansen, ved at bruge metoden
nipyapi.versioning.list_registry_clientsVi finder bucket til yderligere søgning af flow i kurven
nipyapi.versioning.get_registry_bucketFra den fundne bucket søger vi flow
nipyapi.versioning.get_flow_in_bucketDet er også vigtigt at forstå, om denne process group allerede er tilføjet. Process group placeres efter koordinater, og det kan opstå en situation, hvor én komponent overlapper en anden. Jeg har kontrolleret dette; det kan ske 🙂 For at få alle tilføjede process groups bruger vi metoden
nipyapi.canvas.list_all_process_groupsog vi kan derefter søge, for eksempel efter navn.
Jeg vil ikke beskrive opdateringsprocessen for skabelonen, jeg vil bare sige, at hvis der tilføjes processorer i den nye version af skabelonen, er der ingen problemer med tilstedeværelsen af meddelelser i køerne. Men hvis processorer fjernes, kan der opstå problemer (nifi tillader ikke at fjerne en processor, hvis der er samlet en meddelelseskø foran den). Hvis du er interesseret i, hvordan jeg løste dette problem, så skriv venligst til mig, så vi kan diskutere det. Kontaktdetaljer findes i slutningen af artiklen. Lad os gå videre til trin med tilføjelsen af process group.
Under fejlsøgning af scriptet stødte jeg på en egenskab, at den seneste version af flowet ikke altid hentes, så jeg anbefaler først at afklare denne version:
nipyapi.versioning.get_latest_flow_verVi deployer process group:
nipyapi.versioning.deploy_flow_versionVi starter processorerne:
nipyapi.canvas.schedule_process_groupI afsnittet om CLI var det nævnt, at der automatisk ikke inkluderes dataoverførsel i remote process group? Da jeg implementerede scriptet, stødte jeg også på dette problem. På det tidspunkt lykkedes det mig ikke at starte dataoverførslen ved hjælp af API, så jeg besluttede at skrive til udvikleren af NiPyAPI og spørge om råd/hjælp. Udvikleren svarede mig, vi diskuterede problemet, og han skrev, at han havde brug for tid til "at tjekke noget". Og så, et par dage senere, modtager jeg en e-mail, hvor der er skrevet en funktion i Python, der løser mit problem med at starte!!! På det tidspunkt var versionen af NiPyAPI 0.13.3, og selvfølgelig var der ikke noget sådant. Men i version 0.14.0, som for nylig blev udgivet, var denne funktion allerede inkluderet i biblioteksstrukturen. Mød,
nipyapi.canvas.set_remote_process_group_transmissionSå, ved hjælp af NiPyAPI-biblioteket har vi tilsluttet registry, implementeret flow og endda startet behandlere og dataoverførsel. Herefter kan vi pusse koden, tilføje alle mulige kontroller, logning og alt det der. Men det er en helt anden historie.
Af de muligheder for automatisering, jeg har overvejet, virkede den sidste som den mest effektive. For det første er det stadig kodning i Python, hvor man kan indbygge støttende programkode og drage fordel af alle programmeringssprogets fordele. For det andet udvikles NiPyAPI aktivt, og hvis der opstår problemer, kan man kontakte udvikleren. For det tredje er NiPyAPI et mere fleksibelt værktøj til at interagere med NiFi i løsningen af komplekse opgaver. For eksempel i at bestemme, om beskedkøer i flowet er tomme, og om man kan opdatere processgruppen.
Det var alt for nu. Jeg har beskrevet tre tilgange til automatisering af leveringen af flow til NiFi, samt de udfordringer, som udvikleren kan stå over for, og givet et fungerende kodeeksempel til automatisering af leveringen. Hvis emnet interesserer dig ligesom mig —
Kilde: habr.com
