

I Vi har talt om prognoser for tidsserier. En logisk fortsættelse vil være en artikel om detektion af anomalier.
Anvendelse
Detektion af anomalier anvendes i områder som:
1) Forudsigelse af udstyrsfejl
I 2010 blev iranske centrifuger angrebet af virusen Stuxnet, som indførte en suboptimal driftsmode og medførte, at dele af udstyret blev beskadiget på grund af accelereret slid.
Hvis der var blevet anvendt algoritmer til detektion af anomalier på udstyret, kunne situationer med nedbrud være blevet undgået.
Detektion af anomalier i udstyrets drift anvendes ikke kun i atomindustrien, men også i metalarbejdning og drift af flyveturbiner. Og i andre områder, hvor anvendelsen af prædiktiv diagnose er billigere end de mulige tab ved uforudsigelige nedbrud.
2) Forudsigelse af svindelaktiviteter
Hvis der tages penge fra kortet, du bruger i Podolsk, mens der foretages transaktioner i Albanien, bør de muligvis kontrolleres nærmere.
3) Identifikation af unormale forbrugsmønstre
Hvis en del af kunderne viser unormad adfærd, kan der være et problem, som du ikke kender til.
4) Identifikation af unormal efterspørgsel og belastning
Hvis salget i en FMCG-butik falder under konfidensintervallets nedre grænse i prognosen, kan det være nødvendigt at finde årsagen.
Metoder til identifikation af anomalier
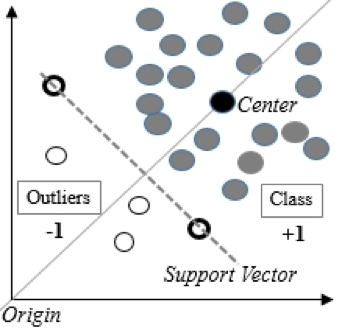
1) Enkeltklasse støttende vektorer One-Class SVM
Velegnet når data i træningssættet følger en normal fordeling, mens testen indeholder anomalier.
One-Class SVM opbygger en ikke-lineær overflade omkring koordinatsystemets oprindelse. Der kan angives en grænse for, hvilke data der betragtes som anomalier.
Baseret på erfaringen fra vores team hos DATA4 er One-Class SVM den mest anvendte algoritme til at løse arbejdsopgaven med at opdage anomalier.
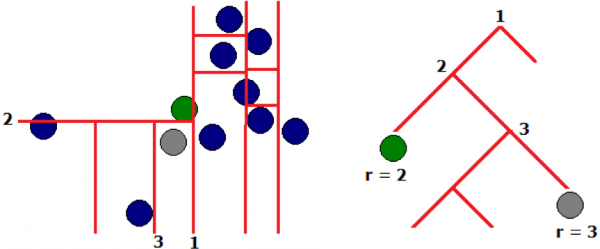
2) Isoleringsskovmetoden – isolate forest
Ved en "tilfældig" metode til opbygning af træer vil outliers lande i bladene tidligt (ved lav dybde i træet), dvs. outliers er lettere at "isolere". Identifikationen af anomaløse værdier finder sted i de tidlige iterationer af algoritmens arbejde.
3) Elliptisk kuvert og statistiske metoder
Anvendes, når data er normalt fordelte. Jo tættere målingen er på halerne af blandingen af fordelinger, desto mere anomal værdien.
Denne klasse inkluderer også andre statistiske metoder.
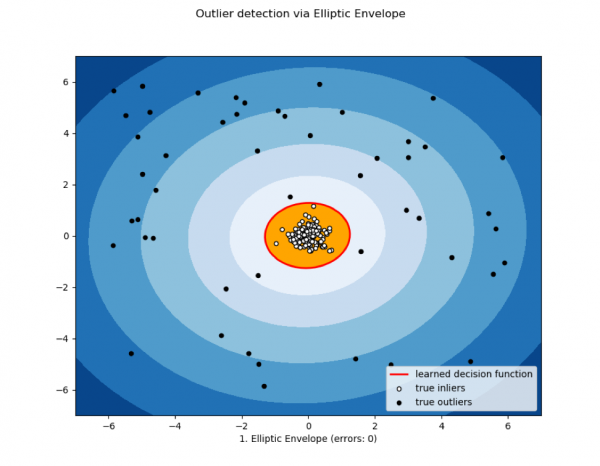
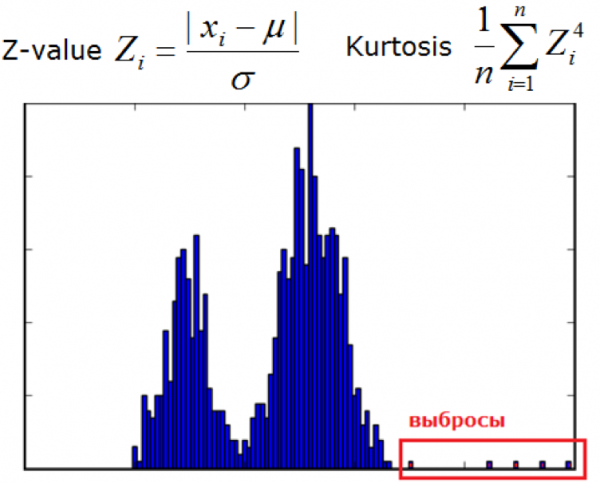
Billede fra dyakonov.org
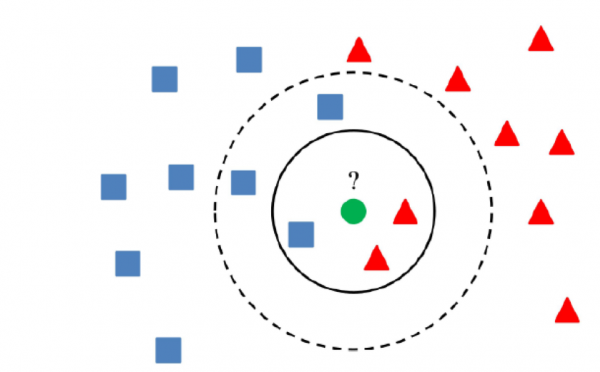
4) Metriske metoder
Metoderne inkluderer algoritmer som k nærmeste naboer, k'te nærmeste nabo, ABOD (angle-based outlier detection) eller LOF (local outlier factor).
De er passende, hvis afstanden mellem værdierne i funktionerne er ligeligt fordelt eller normaliseret (for ikke at måle en python i papegøjer).
K nærmeste nabo-algoritmen antager, at normale værdier er placeret inden for et bestemt område af det multidimensionale rum, og at afstanden til anomalier vil være større end til den adskillende hyperplan.
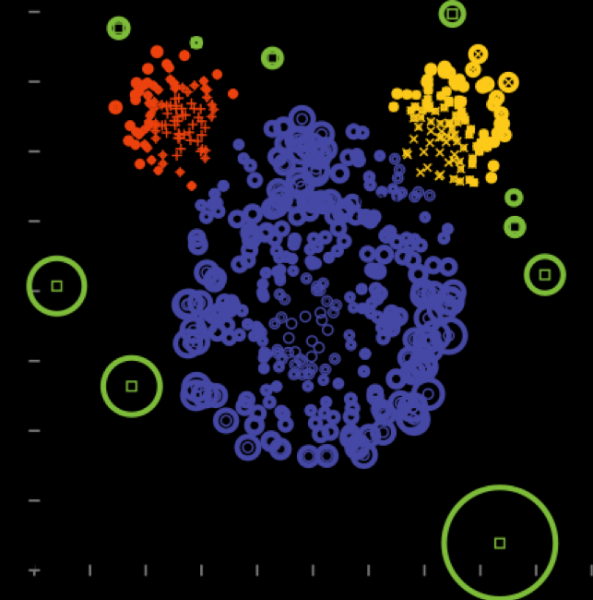
5) Klyngemetoder
Essensen af klyngemetoder er, at hvis en værdi er mere end en bestemt størrelse væk fra klyngecentrene, kan værdien betragtes som anomali.
Det vigtigste er at bruge en algoritme, der korrekt klynger data, hvilket afhænger af den specifikke opgave.
6) Principal component method
Egnet, hvor retningerne med den største ændring i varians identificeres.
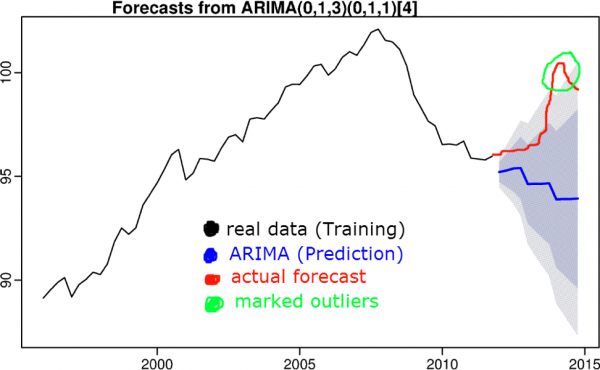
7) Algoritmer baseret på tidsserieprognoser
Ideen er, at hvis en værdi falder uden for konfidensintervallet for prognosen, betragtes værdien som anomali. Til tidsserieprognoser anvendes algoritmer som triple smoothing, S(ARIMA), boosting osv.
Algoritmer til tidsserieprognoser blev nævnt i den tidligere artikel.
8) Læring med vejledning (regression, klassifikation)
Hvis dataene tillader det, bruger vi algoritmer fra lineær regression til rekursive netværk. Vi måler forskellen mellem prædiktions- og faktiske værdier, og drager konklusioner om, hvor meget dataene afviger fra normen. Det er vigtigt, at algoritmen har tilstrækkelig generaliseringsevne, og at træningssættet ikke indeholder anomalier.
9) Modelleringstests
Vi vil nærme os problemet med at finde anomalier som et problem med at lave anbefalinger. Vi nedbryder vores funktionsmatrix ved hjælp af SVD eller faktorisationsmaskiner, og værdierne i den nye matrix, der væsentligt afviger fra de oprindelige, betragtes som anomale.
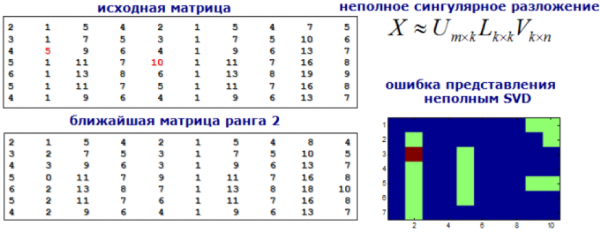
Billede fra dyakonov.org
Konklusion
I denne artikel har vi set på de grundlæggende tilgange til anomali-detektering.
At finde anomalier kan i høj grad betragtes som en kunst. Der er ingen perfekt algoritme eller tilgang, hvis anvendelse løser alle opgaver. Ofte anvendes et kompleks af metoder til at håndtere specifikke tilfælde. Anomalifinding udføres ved hjælp af metoder som støttende vektormaskiner, isoleringsskove, metriske og klyngemetoder samt ved anvendelse af hovedkomponenter og tidsserieprognoser.
Hvis du kender andre metoder, så skriv om dem i kommentarerne til artiklen.
Kilde: habr.com
