

Bem. overs.: Denne artikel, skrevet af Galo Navarro, der fungerer som Principal Software Engineer i det europæiske firma Adevinta, er en fascinerende og lærerig "undersøgelse" inden for infrastrukturdrift. Den oprindelige titel er blevet lidt ændret i oversættelsen af en grund, som forfatteren forklarer i begyndelsen.
Bemærkning fra forfatteren: Det ser ud til, at dette opslag mange flere opmærksomhed, end forventet. Jeg modtager stadig vrede kommentarer om, at artikelens titel er vildledende, og at nogle læsere er skuffede. Jeg forstår årsagerne til det, der sker, så på trods af risikoen for at ødelægge spændingen, vil jeg straks fortælle, hvad denne artikel handler om. Når teams overgår til Kubernetes, observerer jeg en interessant ting: hver gang der opstår et problem (f.eks. stigende forsinkelser efter migration), bliver Kubernetes først beskyldt, men det viser sig, at orkestratoren i bund og grund ikke er skyld i det. Denne artikel handler om et af disse tilfælde. Dens titel gentager et udbrud fra en af vores udviklere (senere vil du se, at Kubernetes slet ikke er involveret her). Du vil ikke finde nogen overraskende åbenbaringer om Kubernetes, men du kan regne med et par gode lektier om komplekse systemer.
For et par uger siden arbejdede mit team på at migrere en mikroservice til den primære platform, som inkluderer CI/CD, et Kubernetes-baseret arbejdsområde, målinger og andre nyttige funktioner. Flytningen var eksperimentel: vi planlagde at tage den som grundlag og migrere cirka 150 andre tjenester i de kommende måneder. Alle disse tjenester er ansvarlige for driften af nogle af de største online platforme i Spanien (Infojobs, Fotocasa mv.).
Efter vi havde implementeret applikationen i Kubernetes og dirigeret en del af trafikken mod den, ventede der os en bekymrende overraskelse. Forsinkelsen (latency) af anmodninger i Kubernetes var ti gange højere end i EC2. Alt i alt var det nødvendigt enten at finde en løsning på dette problem eller opgive migrationen af mikroservicen (og måske hele projektet).
Hvorfor er forsinkelsen i Kubernetes så meget højere end i EC2?
For at finde flaskehalsen indsamlede vi målinger på hele forespørgselens vej. Vores arkitektur er enkel: API-gateway (Zuul) proxyer anmodninger til instanser af mikroservicen i EC2 eller Kubernetes. I Kubernetes bruger vi NGINX Ingress Controller, mens backendene er almindelige objekter af typen med en JVM-applikation på Spring-platformen.
                                  EC2
                            +---------------+
                            |  +---------+  |
                            |  |         |  |
                       +-------> BACKEND |  |
                       |    |  |         |  |
                       |    |  +---------+  |
                       |    +---------------+
             +------+  |
Public       |      |  |
      -------> ZUUL +--+
traffic      |      |  |              Kubernetes
             +------+  |    +-----------------------------+
                       |    |  +-------+      +---------+ |
                       |    |  |       |  xx  |         | |
                       +-------> NGINX +------> BACKEND | |
                            |  |       |  xx  |         | |
                            |  +-------+      +---------+ |
                            +-----------------------------+
Det så ud til, at problemet var relateret til forsinkelsen i den tidlige drift af backend (jeg markerede det problematiske område på grafen som «xx»). I EC2 tog applikationens svar omkring 20 ms. I Kubernetes steg forsinkelsen til 100—200 ms.
Vi hurtigt udelukkede sandsynlige mistænkte relateret til ændringen af runtime. JVM-versionen forblev den samme. Containeriseringsproblemer var heller ikke involveret: applikationen havde allerede fungeret korrekt i containere i EC2. Belastning? Men vi observerede høje forsinkelser selv ved 1 anmodning pr. sekund. Pauserne til affaldsindsamling kunne også ignoreres.
En af vores Kubernetes-administratorer spurgte, om applikationen havde eksterne afhængigheder, da anmodninger til DNS tidligere havde forårsaget lignende problemer.
Hypotese 1: DNS-navneopslag
Ved hver anmodning kalder vores applikation en til tre gange en AWS Elasticsearch-instans i et domæne som elastic.spain.adevinta.com. Inden i containere har vi , så vi kan kontrollere, om domænesøgningen faktisk tager lang tid.
DNS-anmodninger fra containeren:
[root@be-851c76f696-alf8z \/]# while true; do dig "elastic.spain.adevinta.com" | grep time; sleep 2; done
;; Query time: 22 msec
;; Query time: 22 msec
;; Query time: 29 msec
;; Query time: 21 msec
;; Query time: 28 msec
;; Query time: 43 msec
;; Query time: 39 msec
Svarende anmodninger fra en af EC2-instanserne, hvor applikationen kører:
bash-4.4# while true; do dig "elastic.spain.adevinta.com" | grep time; sleep 2; done
;; Query time: 77 msec
;; Query time: 0 msec
;; Query time: 0 msec
;; Query time: 0 msec
;; Query time: 0 msec
Da søgningen tager cirka 30 ms, blev det klart, at DNS-opløsningen, når man tilgår Elasticsearch, faktisk bidrager til den øgede forsinkelse.
Men det var mærkeligt af to grunde:
- Vi har allerede mange applikationer i Kubernetes, der interagerer med AWS-ressourcer, men ikke lider under store forsinkelser. Uanset hvad årsagen måtte være, relaterer det sig specifikt til denne situation.
- Vi ved, at JVM udfører in-memory caching af DNS. I vores billeder er TTL-værdien angivet i
$JAVA_HOME/jre/lib/security/java.securityog er indstillet til 10 sekunder:networkaddress.cache.ttl = 10. Med andre ord skal JVM cache alle DNS-forespørgsler i 10 sekunder.
For at bekræfte den første hypotese besluttede vi at midlertidigt stoppe med at anmode om DNS og se, om problemet forsvandt. Først besluttede vi at omkonfigurere applikationen, så den forbandt direkte til Elasticsearch via IP-adresse i stedet for domænenavn. Dette ville kræve ændringer i koden og en ny udrulning, så vi blot matchede domænet med dets IP-adresse i /etc/hosts:
34.55.5.111 elastic.spain.adevinta.comNu modtog containeren IP næsten øjeblikkeligt. Dette førte til en vis forbedring, men vi nærmede os kun lidt det forventede niveau af forsinkelse. Selvom DNS-opløsning tog lang tid, forblev den reelle årsag stadig uforklarlig for os.
Diagnosticering via netværk
Vi besluttede at analysere trafikken fra containeren ved hjælp af tcpdump, for at spore hvad der præcist sker i netværket:
[root@be-851c76f696-alf8z /]# tcpdump -leni any -w capture.pcap Derefter sendte vi flere forespørgsler og downloadede deres capture (kubectl cp my-service:/capture.pcap capture.pcap) til videre analyse i .
Der var ikke noget mistænkeligt i DNS-forespørgslerne (bortset fra en lille detalje, som jeg vil fortælle om senere). Men der var bestemte underligheder i, hvordan vores service håndterede hver forespørgsel. Nedenfor er et screenshot af capture, der viser modtagelsen af forespørgslen før svaret begyndte:
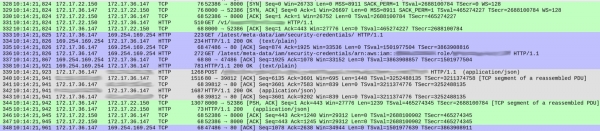
Pakkenumrene vises i den første kolonne. For klarhed har jeg fremhævet de forskellige TCP-strømme med farve.
Den grønne strøm, der starter med den 328. pakke, viser, hvordan klienten (172.17.22.150) etablerede en TCP-forbindelse til containeren (172.17.36.147). Efter den indledende handshake (328-330) bragte pakke 331 HTTP GET /v1/.. — den indkommende forespørgsel til vores service. Hele processen tog 1 ms.
Den grå strøm (fra pakke 339) viser, at vores service sendte en HTTP-forespørgsel til Elasticsearch-instansen (TCP-handshake mangler, da der bruges en eksisterende forbindelse). Dette tog 18 ms.
Indtil videre er alt i orden, og tiderne svarer stort set til de forventede forsinkelser (20-30 ms ved målinger fra klienten).
Men den blå sektion tager 86 ms. Hvad sker der her? Med pakken 333 sendte vores service en HTTP GET-forespørgsel til /latest/meta-data/iam/security-credentials, og straks efter, over den samme TCP-forbindelse, en anden GET-forespørgsel til /latest/meta-data/iam/security-credentials/arn:...
Vi har opdaget, at dette gentager sig med hver forespørgsel i hele traceringen. DNS-opløsning er faktisk lidt langsommere i vores containere (forklaringen på dette fænomen er meget interessant, men jeg gemmer det til en separat artikel). Det viste sig, at årsagen til de store forsinkelser er anmodninger til AWS Instance Metadata-tjenesten ved hver forespørgsel.
Hypotese 2: unødvendige anmodninger til AWS
Begge endpoint'er tilhører . Vores mikrotjeneste bruger denne tjeneste, når den arbejder med Elasticsearch. Begge kald er en del af den grundlæggende autorisationsproces. Endpoint, som der anmodes til ved den første forespørgsel, udsteder IAM-rollen knyttet til instansen.
/ # curl http://169.254.169.254/latest/meta-data/iam/security-credentials/
arn:aws:iam::<account_id>:role/some_role
Den anden forespørgsel går til det andet endpoint for midlertidige tilladelser for denne instans:
/ # curl http://169.254.169.254/latest/meta-data/iam/security-credentials/arn:aws:iam::<account_id>:role/some_role`
{
    "Code" : "Success",
    "LastUpdated" : "2012-04-26T16:39:16Z",
    "Type" : "AWS-HMAC",
    "AccessKeyId" : "ASIAIOSFODNN7EXAMPLE",
    "SecretAccessKey" : "wJalrXUtnFEMI/K7MDENG/bPxRfiCYEXAMPLEKEY",
    "Token" : "token",
    "Expiration" : "2017-05-17T15:09:54Z"
}
Klienten kan bruge dem i en kort periode og skal periodisk indhente nye certifikater (indtil deres Expiration). Modellen er simpel: AWS udfører hyppig rotation af midlertidige nøgler af sikkerhedsmæssige årsager, men kunderne kan cache dem i flere minutter, hvilket kompenserer for det præstationsfald, der er forbundet med at få nye certifikater.
AWS Java SDK skal tage ansvar for at organisere denne proces, men af en eller anden grund sker dette ikke.
Ved at søge i issues på GitHub blev vi stødt på en problemstilling . Den hjalp os med at bestemme den retning, vi skulle 'grave' videre.
AWS SDK opdaterer certifikaterne, når en af følgende betingelser opfyldes:
- Udløbsdatoen for dem (
Expiration) falder indenforEXPIRATION_THRESHOLD, som er fastsat i koden til 15 minutter. - Der er gået længere tid siden den seneste forsøgsopdatering af certifikater end
REFRESH_THRESHOLD, som er 'hardcode'et' til 60 minutter.
For at se den reelle udløbsdato for de certifikater, vi får, udførte vi de nævnte cURL-kommandoer fra containeren og fra EC2-instansen. Udløbstiden for certifikatet, der blev modtaget fra containeren, viste sig at være meget kortere: præcist 15 minutter.
Nu er alt klart: for den første anmodning modtog vores service midlertidige certifikater. Da gyldigheden af disse ikke oversteg 15 minutter, besluttede AWS SDK at opdatere dem ved efterfølgende anmodninger. Og dette skete med hver anmodning.
Hvorfor blev gyldigheden af certifikaterne kortere?
AWS Instance Metadata service er designet til at arbejde med EC2-instanser, ikke Kubernetes. På den anden side ønskede vi ikke at ændre applikationsgrænsefladen. Derfor brugte vi — et værktøj, der ved hjælp af agenter på hver Kubernetes-node giver brugerne (ingeniører, der distribuerer applikationer i klyngen) mulighed for at tildele IAM-roller til containere i pod'er, som om de var EC2-instanser. KIAM opfanger kald til AWS Instance Metadata service og behandler dem fra sin cache, efter at have hentet dem fra AWS. Set fra applikationens synsvinkel ændrer intet sig.
KIAM leverer kortvarige certifikater til pod'er. Det er fornuftigt, da den gennemsnitlige levetid for en pod er kortere end en EC2-instanse. Som standard er gyldigheden af certifikaterne .
Som et resultat, hvis begge standardværdier lægges over hinanden, opstår der et problem. Hvert certifikat, der gives til applikationen, udløber efter 15 minutter. Samtidig tvinger AWS Java SDK enhver certifikatopdatering, hvis der er mindre end 15 minutter tilbage af gyldigheden.
Som et resultat opdateres det midlertidige certifikat tvingende med hver anmodning, hvilket medfører flere opkald til AWS API og resulterer i en betydelig forøgelse af forsinkelsen. I AWS Java SDK fandt vi , hvor der omtales et lignende problem.
Løsningen viste sig at være enkel. Vi omlagde bare KIAM til at anmode om certifikater med længere gyldighed. Så snart dette skete, begyndte anmodningerne at gå igennem uden involvering af AWS Metadata-servicen, og forsinkelsen faldt endda til et lavere niveau end i EC2.
Konklusioner
Baseret på vores erfaring med migrationer kan det siges, at en af de mest almindelige kilder til problemer ikke er fejl i Kubernetes eller andre platformelementer. Det er heller ikke relateret til nogen grundlæggende mangler i de mikrotjenester, vi migrerer. Problemer opstår ofte simpelthen fordi vi forbinder forskellige elementer sammen.
Vi samler komplekse systemer, der aldrig før har interageret med hinanden, i håbet om, at de sammen danner et enkelt, større system. Desværre, jo flere elementer, jo større er rummet for fejl, og jo højere er entropien.
I vores tilfælde var den høje forsinkelse ikke resultatet af fejl eller dårlige beslutninger i Kubernetes, KIAM, AWS Java SDK eller vores mikrotjeneste. Det var et resultat af sammenkomsten af to uafhængige standardindstillinger: en i KIAM og den anden i AWS Java SDK. Hver af disse parametre giver mening for sig: både den aktive politik for opdatering af certifikater i AWS Java SDK og den korte udløbstid for certifikaterne i KIAM. Men når de er sat sammen, bliver resultaterne uforudsigelige. To uafhængige og logiske beslutninger behøver ikke nødvendigvis at give mening, når de kombineres.
P.S. fra oversætteren
Du kan læse mere om KIAM-arkitekturen til integration af AWS IAM med Kubernetes i fra dens skabere.
Og læs også i vores blog:
- «»;
- «»;
- «»;
- «».
Kilde: habr.com
