

Background
Der er salgsautomater udviklet internt. Inden i en Raspberry Pi og lidt ekstra udstyr på et separat kort. Tilsluttet er møntindkast, sedelmater, bankterminal... Det hele styres af et skræddersyet program. Al driftshistorik skrives til en log på et flash-drev (MicroSD), som derefter overføres via internettet (med en USB-modem) til en server, hvor det gemmes i en database. Oplysninger om salget uploades til 1C, og der er også et simpelt web-interface til overvågning osv.
Så loggen er absolut nødvendig — til registrering (herunder indtægter, salg osv.), overvågning (forskellige fejl og andre uforudsete omstændigheder); det kan siges at være al den information, vi har om denne automat.
Problemet
USB-drev viser sig at være meget ustabile enheder. De går med jævne mellemrum i stykker. Dette fører til både stilstand i automaterne og (hvis loggen af en eller anden grund ikke kunne overføres online) til tab af data.
Dette er ikke det første forsøg med USB-drev; tidligere var der et andet projekt med mere end hundrede enheder, hvor loggen blev gemt på USB-drev, der var også problemer med pålidelighed, og nogle gange var antallet af defekte enheder om måneden i titaller. Vi har prøvet forskellige USB-drev, herunder mærkevarer med SLC hukommelse, og nogle modeller er mere pålidelige end andre, men at skifte USB-drev løste ikke problemet fundamentalt.
Opmærksomhed! Langt indlæg! Hvis du ikke er interesseret i 'hvorfor', men kun i 'hvordan', kan du gå direkte til af artiklen.
Løsning
Det første, der kommer til at tænke på, er at opgive MicroSD, sætte en SSD i stedet, og starte derfra. Teoretisk set er det muligvis, men ret dyrt, og ikke så pålideligt (en USB-SATA adapter tilføjes; statistikker for billige SSD'er ser heller ikke så gode ud).
USB HDD ser heller ikke ud til at være en særlig attraktiv løsning.
Derfor kom vi frem til denne løsning: beholde opstart fra MicroSD, men bruge dem i read-only tilstand, og gemme driftloggen (og anden unik information for det pågældende udstyr — serienummer, sensor kalibreringer, osv.) et andet sted.
Emnet read-only filsystemer til Raspberry Pi er allerede blevet grundigt undersøgt, jeg vil ikke dvæle ved detaljerne i implementeringen i denne artikel (men hvis der er interesse — så må jeg måske skrive en mini-artikel om dette emne). Det eneste, jeg gerne vil nævne, er, at både ud fra personlige erfaringer og anmeldelser fra dem, der allerede har implementeret det, er der en vund i pålideligheden. Ja, det er umuligt helt at undgå fejl, men det er ret realistisk at reducere deres hyppighed betydeligt. Desuden bliver kortene ensartede, hvilket mærkbart letter udskiftningen for servicepersonalet.
Hardware
Der var ingen særlige tvivl om valget af hukommelsestype — NOR Flash.
Argumenter:
- nem forbindelse (som oftest SPI-bussen, som vi allerede har erfaring med, så der forventes ikke 'hardware' problemer);
- lidt sjov pris;
- standard driftsprotokol (implementeringen findes allerede i Linux-kernen, hvis ønskes kan man tage en tredjepartsløsning, som også findes, eller endda skrive sin egen, da alt er ganske enkelt);
- pålidelighed og levetid:
fra et typisk datablad: data opbevares i 20 år, 100.000 sletninger for hver blok;
fra eksterne kilder: ekstremt lav BER, det postuleres, at der ikke er behov for fejlkorrigeringskoder (i nogle arbejder overvejes ECC for NOR, men normalt henviser de dog til MLC NOR, der findes også sådanne);.
Lad os overveje kravene til volumen og ressource.
Vi ønsker, at data skal bevares sikkert i flere dage. Det er nødvendigt for at sikre, at salgsstatistikken ikke går tabt i tilfælde af kommunikationsproblemer. Lad os sigte efter 5 dage, i denne periode (selv med hensyn til weekender og helligdage) kan problemet løses.
Hos os indsamles omkring 100 kb log pr. dag (3-4 tusinde poster), men gradvist stiger det tal — detaljeringen øges, og nye hændelser tilføjes. Derudover er der nogle gange spikes (for eksempel begynder en sensor at spamme med falske positive). Lad os regne med 10.000 poster med 100 bytes — en megabyte om dagen.
Det giver i alt 5 Mb rene (godt komprimerbare) data. Dertil kommer (grov vurdering) 1 Mb overhead data.
Det vil sige, vi har brug for en chip på 8 Mb, hvis vi ikke bruger kompression, eller 4 Mb, hvis vi bruger det. Helt realistiske tal for denne type hukommelse.
Hvad angår levetiden: hvis vi planlægger, at hukommelsen bliver skrevet helt over, ikke oftere end hver 5. dag, så får vi mindre end tusind omskrivninger i løbet af 10 års drift.
Jeg minder om, at producenten lover hundrede tusinde.
Lidt om NOR vs NAND
I dag er NAND-hukommelse selvfølgelig langt mere populær, men til dette projekt ville jeg ikke vælge den; NAND kræver i modsætning til NOR altid brug af fejlkorrektion, defekte bloktabeller osv., og benene på NAND-chips er som regel også mange flere.
Ulemper ved NOR kan nævnes:
- lille kapacitet (og dermed høj pris pr. megabyte);
- lav udvekslingshastighed (meget på grund af brugen af sekventiel grænseflade, normalt SPI eller I2C);
- langsom sletning (afhængig af blokstørrelsen tager det fra brøkdele af et sekund til flere sekunder).
Der ser ikke ud til at være noget kritisk for os, så lad os fortsætte.
Hvis detaljer er interessante, blev chippen valgt (det er dog ikke væsentligt, der er masser af analoger på markedet, som er kompatible med pinout og kommando-system; selv hvis vi beslutter os for at sætte en chip fra en anden producent og/eller af en anden størrelse, vil alt fungere uden ændringer i koden).
Jeg bruger den indbyggede driver i Linux-kernen, på Raspberry Pi er det ret enkelt takket være understøttelsen af device tree overlay — man skal blot lægge den kompilerede overlay i /boot/overlays og ændre lidt i /boot/config.txt.
Eksempel på dts-fil
Ærligt talt er jeg ikke sikker på, at det er skrevet fejlfrit, men det fungerer.
/*
 * Device tree overlay for at25 at spi0.1
 */

/dts-v1/;
/plugin/;

/ {
    compatible = "brcm,bcm2835", "brcm,bcm2836", "brcm,bcm2708", "brcm,bcm2709";

    /* disable spi-dev for spi0.1 */
    fragment@0 {
        target = <&spi0>;
        __overlay__ {
            status = "okay";
            spidev@1{
                status = "disabled";
            };
        };
    };

    /* the spi config of the at25 */
    fragment@1 {
        target = <&spi0>;
        __overlay__ {
            #address-cells = <1>;
            #size-cells = <0>;
            flash: m25p80@1 {
                    compatible = "atmel,at25df321a";
                    reg = <1>;
                    spi-max-frequency = <50000000>;

                    /* default to false:
                    m25p,fast-read ;
                    */
            };
        };
    };

    __overrides__ {
        spimaxfrequency = <&flash>,"spi-max-frequency:0";
        fastread = <&flash>,"m25p,fast-read?";
    };
};
Og endnu en linje i config.txt
dtoverlay=at25:spimaxfrequency=50000000Jeg vil lade beskrivelsen af, hvordan chippen forbindes til Raspberry Pi, ligge. På den ene side er jeg ikke specialist i elektronik, på den anden side er det ret enkelt selv for mig: chippen har kun 8 ben, hvoraf vi har brug for jord, strøm, SPI (CS, SI, SO, SCK); niveauerne svarer til dem på Raspberry Pi, ingen yderligere kredsløb er nødvendigt — man skal blot forbinde de nævnte 6 ben.
Problemformulering
Som sædvanligt foregår opstilling af opgaven i flere iterationer, og jeg synes, det er tid til endnu en. Så lad os stoppe op, samle det, der allerede er skrevet, og afklare de tilbageholdte detaljer.
Så vi har besluttet, at loggen vil blive gemt i SPI NOR Flash.
Hvad er NOR Flash for dem, der ikke ved det?
Det er en ikke-flygtig hukommelse, hvor man kan udføre tre operationer:
- Læsning:
Den mest almindelige læsning: vi sender adressen og læser så mange bytes som vi har brug for; - Skrivning:
I NOR flash ser man ud som almindelig, men den har en særlig egenskab: man kan kun ændre 1 til 0, men ikke omvendt. For eksempel, hvis der lå 0x55 i hukommelsescellen, så vil der efter skrivning af 0x0f stå 0x05 der. (se tabellen lidt længere nede); - Slet:
Selvfølgelig skal vi kunne udføre den omvendte operation - ændre 0 til 1; det er netop derfor, operationen slet eksisterer. I modsætning til de to første opererer den ikke med bytes, men med blokke (den mindste sletteblok i den valgte mikrochip er 4kb). Sletningen tilintetgør hele blokken, og det er den eneste måde at ændre 0 til 1. Derfor skal man ofte justere datastrukturer til grænsen for sletteblok.
Skriv til NOR Flash:
Binære data
Var
01010101
Skrevet
00001111
Er blevet
00000101
Selv journalen repræsenterer en sekvens af poster af variabel længde. Den typiske længde for en post er cirka 30 bytes (selv om der nogle gange optræder poster, der er flere kilobytes lange). I dette tilfælde arbejder vi med dem som et sæt bytes, men hvis det er interessant, bruges der CBOR indenfor posterne.
Udover journalen har vi brug for at gemme nogle "konfigurations" informationer, både opdaterede og ikke: et slags ID for enheden, sensor kalibreringer, flag "enheden er midlertidigt slukket", osv.
Disse oplysninger består af et sæt key-value poster, der også gemmes i CBOR. Vi har ikke meget af denne information (maksimalt et par kilobytes), og den opdateres ikke ofte.
Fremover kalder vi det kontekst.
Hvis man husker, hvordan denne artikel begyndte, så er det meget vigtigt at sikre pålidelig datalagring og om muligt uafbrudt drift, selv i tilfælde af hardwarefejl/dataskader.
Hvilke kilder til problemer kan man overveje?
- Strømafbrydelse under write/slet operationer. Dette er i kategorien "mod en hammer findes der ingen råd".
Oplysninger fra på stackexchange: ved strømafbrydelse under arbejde med flash, både hvad sletning (indstilling til 1) og skrivning (indstilling til 0) fører til undefined behavior: data kan blive skrevet, delvist skrevet (lad os sige, at vi sendte 10 bytes/80 bits, men kun nåede at skrive 45 bits), og det er ikke usandsynligt, at nogle bits vil være i en "mellemliggende" tilstand (læsning kan vise både 0 og 1); - Fejl i selve flash-hukommelsen.
BER er meget lav, men kan ikke være lig med nul; - Fejl over bussen
Data transmitted via SPI is not protected in any way, and single-bit errors or synchronization errors can easily occur—loss or insertion of bits (which leads to significant data corruption); - Other errors/failures
Errors in the code, Raspberry glitches, alien interference...
I formulated the requirements that, in my opinion, are necessary for ensuring reliability:
- records must be written to flash memory immediately; deferred writing is not considered; - if an error occurs, it must be detected and handled as early as possible; - the system should restore operation after errors whenever possible.
(an example from life "how it shouldn't be," which I think everyone has encountered: after an emergency reboot, the file system got corrupted and the operating system doesn't boot)
Ideas, approaches, reflections
When I started thinking about this task, a bunch of ideas flashed through my mind, for example:
- using data compression;
- using clever data structures, for example, storing the headers of records separately from the records themselves, so that in case of an error in any record, the others can still be read without issues;
- using bit fields to control the completeness of the record during power loss;
- storing checksums for everything;
- using some kind of error-resistant coding.
Some of these ideas were used, while others were decided to be discarded. Let's go through them in order.
Data compression
The events we log are fairly uniform and repetitive ("coin toss of 5 rubles," "pressed the change button," ...). Therefore, compression should turn out to be quite effective.
The overhead for compression is negligible (our processor is powerful enough, even the first Pi had a core with a frequency of 700 MHz, and the current models have several cores with frequencies over one gigahertz), the speed of communication with storage is low (a few megabytes per second), and the size of the records is small. Overall, if compression does affect performance, it will only be positively. (not critical at all, just stating the fact). Plus, we don't have a real embedded system, but a regular Linux — so the implementation shouldn't require much effort (just link the library and use a few functions from it).
The log was taken from a working device (1.7MB, 70 thousand entries) and initially checked for compressibility using gzip, lz4, lzop, bzip2, xz, zstd available on the computer.
- gzip, xz, zstd showed similar results (40KB).
It was surprising that the trendy xz performed on par with gzip or zstd here; - lzip with default settings gave slightly worse results;
- lz4 and lzop showed not very good results (150KB);
- bzip2 surprisingly yielded good results (18KB).
So, the data compresses very well.
Therefore, (if we don't find fatal flaws) compression will happen! Simply because more data can fit on the same flash drive.
Let's consider the disadvantages.
The first issue: we already agreed that each entry must be immediately written to the flash. Usually, compressors accumulate data from the input stream until they decide it's time to write to the output. We need to immediately get a compressed block of data and save it in non-volatile memory.
I see three paths:
- Compress each entry using dictionary compression instead of the algorithms discussed above.
A workable option, but I don't like it. To ensure a decent level of compression, the dictionary must be 'tuned' for specific data; any change will lead to a catastrophic drop in the compression level. Yes, the issue can be resolved by creating a new version of the dictionary, but that's a headache — we would need to store all dictionary versions; in every entry, we would need to specify which version of the dictionary it was compressed with... - Compress each entry using 'classical' algorithms, but independently of the others.
The compression algorithms being considered are not designed to work with entries of this size (dozens of bytes), the compression ratio will clearly be less than 1 (i.e., an increase in data volume instead of compression); - Perform a FLUSH after each entry.
Many compression libraries support FLUSH. This is a command (or parameter to the compression procedure), upon receiving which the compressor generates a compressed stream so that it can restore alle the uncompressed data that has already been received. Such an analogysynki filsystemer ellercommiti sql.
Vigtigt er, at efterfølgende komprimeringsoperationer vil kunne bruge den akkumulerede ordbog, og komprimeringsgraden vil ikke lide så meget som i den tidligere version.
Det er åbenlyst, at jeg har valgt den tredje mulighed, lad os se nærmere på den.
Fundet om FLUSH i zlib.
Jeg lavede et testforsøg inspireret af en artikel, tog 70.000 poster fra en rigtig enhed med en sidestørrelse på 60Kb (til sidestørrelsen vender vi tilbage senere) opnåede:
Kildedata
Gzip kompression -9 (uden FLUSH)
zlib med Z_PARTIAL_FLUSH
zlib med Z_SYNC_FLUSH
Størrelse, Kb
1692
40
352
604
Ved første øjekast virker omkostningen ved FLUSH overdreven, men i virkeligheden har vi ikke meget valg - enten komprimere slet ikke, eller komprimere (og meget effektivt) med FLUSH. Man skal huske, at vi har 70.000 poster, overflødigheden introduceret af Z_PARTIAL_FLUSH er kun 4-5 bytes pr. post. Og komprimeringsgraden viste sig at være næsten 5:1, hvilket er mere end et fremragende resultat.
Det kan virke overraskende, men i virkeligheden er Z_SYNC_FLUSH en mere effektiv måde at lave FLUSH på.
I tilfælde af brug af Z_SYNC_FLUSH vil de sidste 4 bytes af hver post altid være 0x00, 0x00, 0xff, 0xff. Og hvis vi kender dem - kan vi undlade at gemme dem, således at den endelige størrelse bliver kun 324Kb.
I artiklen, jeg refererer til, er der en forklaring:
En ny type 0 blok med tomt indhold tilføjes.
En type 0 blok med tomt indhold består af:
- den tre-bit blokoverskrift;
- 0 til 7 bits lig med nul for at opnå bytejustering;
- den fire-byte sekvens 00 00 FF FF.
Som det er let at se, går der i den sidste blok før disse 4 bytes fra 3 til 10 nul-bits. Men praksis har vist, at der faktisk er mindst 10 nul-bits.
Det viser sig, at så korte datablokke normalt (eller altid?) kodes ved hjælp af en blok type 1 (fast blok), som nødvendigvis slutter med 7 nul-bits, så vi får 10-17 garanteret nul-bits (og de øvrige vil være nul med en sandsynlighed på omkring 50%).
Så på testdata i 100% af tilfældene går der en nul-byte før 0x00, 0x00, 0xff, 0xff, og i mere end en tredjedel af tilfældene - to nul-bytes. (måske skyldes det, at jeg bruger binær CBOR, og når jeg bruger tekstbaseret JSON ville jeg oftere møde blokke type 2 - dynamisk blok, og derfor ville der være blokke uden ekstra nul-bytes før 0x00, 0x00, 0xff, 0xff).
I alt kan man på de eksisterende testdata komprimere til mindre end 250Kb med komprimerede data.
Man kan spare lidt mere ved at jonglere med bits: lige nu ignorerer vi tilstedeværelsen af flere nul-bits i slutningen af blokken, flere bits i starten af blokken ændrer sig heller ikke...
Men her tog jeg en afgørende beslutning om at stoppe, ellers kan jeg med dette tempo ende med at udvikle min egen arkiveringssoftware.
I alt fik jeg fra mine testdata 3-4 byte pr. skrivning, og komprimeringsforholdet endte med at være mere end 6:1. Ærligt talt, jeg havde ikke forventet et så godt resultat; efter min mening er alt, hvad der er bedre end 2:1, allerede et resultat, der retfærdiggør brugen af komprimering.
Alt er perfekt, men zlib (deflate) er trods alt en gammel, velkendt og lidt gammeldags komprimeringsalgoritme. Bare det faktum, at de seneste 32KB af den ukomprimerede datastream bruges som ordbog, virker i dag mærkeligt (dvs. hvis en datablok ligner noget fra indstrømningen for 40KB siden, så vil den begynde at blive arkiveret forfra og ikke referere til tidligere indgange). I moderne komprimeringsværktøjer måles ordbogs størrelsen ofte i megabyte i stedet for kilobyte.
Så lad os fortsætte med vores mini-undersøgelse af komprimeringsprogrammer.
Den næste, der blev testet, var bzip2 (jeg minder om, at uden FLUSH viste den en fantastisk grad af komprimering, næsten 100:1). Desværre, med FLUSH viste den sig at være meget dårlig, størrelsen på de komprimerede data endte med at være større end de ukomprimerede.
Mine formodninger om årsagerne til fiaskoen
Libbz2 tilbyder kun én mulighed for flush, som tilsyneladende rydder ordbogen (analogt med Z_FULL_FLUSH i zlib); man kan ikke tale om effektiv komprimering efter dette.
Og den sidste, der blev testet, var zstd. Afhængigt af parametrene komprimerer den enten på niveau med gzip, men meget hurtigere, eller bedre end gzip.
Desværre, med FLUSH viste den sig at være "ikke så god": størrelsen på de komprimerede data blev cirka 700KB.
Jeg på projektets github-side, fik svaret, at man skal regne med op til 10 byte serviceoplysninger pr. blok af komprimerede data, hvilket er tæt på de opnåede resultater; man kan ikke indhente deflate.
På dette besluttede jeg at stoppe eksperimenterne med komprimeringsprogrammer (jeg minder om, at xz, lzip, lzo og lz4 ikke viste sig at være effektive allerede i testfasen uden FLUSH, og jeg ønskede ikke at overveje mere eksotiske komprimeringsalgoritmer).
Lad os vende tilbage til problemerne med arkivering.
Det næste (som man siger i rækkefølge, ikke i betydning) problem er, at de komprimerede data repræsenterer et enkelt stream, hvor der konstant henvises til tidligere sektioner. Dermed, når en del af de komprimerede data skades, mister vi ikke kun de usammenhængende data, der er knyttet til den del, men også alle efterfølgende.
Der er tilgange til at løse dette problem:
- At forhindre problemet i at opstå – ved at tilføje redundans til de komprimerede data, som muliggør identifikation og rettelse af fejl; dette vil vi tale om senere;
- At minimere konsekvenserne, hvis problemet opstår.
Vi har tidligere nævnt, at vi kan komprimere hver datablok uafhængigt, hvilket vil tage problemet ud af ligningen (beskadigelse af data i en blok vil kun resultere i tab af data i den blok). Men dette er et yderpunkt, hvor datakompression vil være ineffektiv. Den modsatte yderpunkt: at bruge de 4 MB af vores chip som et enkelt arkiv, hvilket vil give os fremragende kompression, men katastrofale konsekvenser i tilfælde af dataskader.
Ja, en kompromis kræves set fra et pålidelighedssynspunkt. Men man må huske, at vi udvikler et dataopbevaringsformat til energifri hukommelse med ekstremt lav BER og en erklæret opbevaringsperiode på 20 år.
Under eksperimenter fandt jeg, at mere eller mindre mærkbare tab i kompressionsniveauet begynder med komprimerede datablokke, der er mindre end 10 KB.
Det blev tidligere nævnt, at den anvendte hukommelse har en sideorganisering. Jeg ser ingen grund til ikke at benytte tilsvarende 'én side – én blok med komprimerede data'.
Det vil sige, at den mindste fornuftige sides størrelse er 16 KB (med lidt margen til administrationsinformation). Men en så lille sides størrelse lægger betydelige begrænsninger på den maksimale størrelsen af en post.
Selvom jeg endnu ikke forventer poster større end et par kilobyte komprimeret, har jeg besluttet at bruge sider på størrelse med 32 KB (det giver 128 sider pr. chip).
Resume:
- Data opbevares komprimeret med zlib (deflate);
- For hver post indstiller vi Z_SYNC_FLUSH;
- For hver komprimeret post beskærer vi de afsluttende bytes (for eksempel 0x00, 0x00, 0xff, 0xff); i headeren angiver vi, hvor mange bytes vi har beskåret;
- Data opbevares i blokke af 32KB; inden for blokken er der en sammenhængende strøm af komprimerede data; komprimeringen genoptages fra starten af hver blok.
Og før vi afslutter komprimeringen, vil jeg gerne påpege, at vi kun får et par byte komprimerede data pr. post, så det er ekstremt vigtigt ikke at opsvulme metadata, da hver byte tæller.
Opbevaring af dataoverskrifter
Da vi har variable længdeoptegnelser, skal vi finde en måde at bestemme placeringen/grænserne for optegnelserne.
Jeg kender tre tilgange:
- Alle optegnelser opbevares i en kontinuerlig strøm, først kommer optegnelsens header, der indeholder længden, og derefter selve optegnelsen.
I denne variant kan både overskrifter og data have variabel længde.
I realiteten får vi en enkelt linked list, der benyttes ofte; - Overskrifterne og selve optegnelserne opbevares i separate strømme.
Ved at bruge faste længdeoverskrifter sikrer vi, at beskadigelse af en header ikke påvirker de andre.
Denne tilgang anvendes eksempelvis i mange filsystemer; - Optegnelserne opbevares i en kontinuerlig strøm, hvor grænsen for en optegnelse bestemmes af en bestemt markør (tegn/tegnsekvens, der er forbudt inden for datablokke). Hvis en markør findes inden for en optegnelse, erstatter vi den med en bestemt sekvens (escaper den).
Denne tilgang anvendes eksempelvis i PPP-protokollen.
Jeg vil illustrere det.
Variant 1:
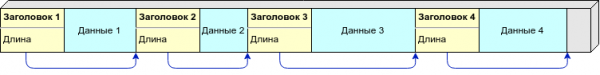
Her er det meget enkelt: ved at kende længden af optegnelsen kan vi beregne adressen til den næste header. På den måde bevæger vi os gennem overskrifterne, indtil vi møder et område fyldt med 0xff (frit område) eller enden på blokken.
Variant 2:
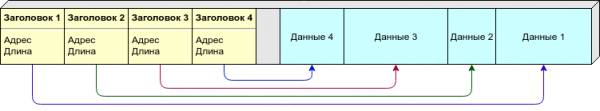
På grund af den variable længde af optegnelser kan vi ikke på forhånd sige, hvor mange optegnelser (og dermed også overskrifter) vi får brug for pr. side. Vi kan adskille overskrifterne fra dataene på forskellige sider, men jeg foretrækker en anden tilgang: både overskrifter og data placeres på én og samme side, men overskrifterne (af fast størrelse) kommer fra begyndelsen af siden, mens dataene (af variabel længde) kommer fra slutningen. Så snart de "møder hinanden" (der er ikke plads til en ny optegnelse) — betragter vi denne side som fyldt.
Variant 3:

Her er der ikke behov for at gemme længden eller anden information om dataplacering i headeren, det er tilstrækkeligt med markører, der angiver grænserne for posterne. Men dataene skal behandles ved skrivning/læsning.
Som markør ville jeg bruge 0xff (som siden er fyldt med efter sletning), så den frie plads vil helt klart ikke blive opfattet som data.
Sammenligningstabel:
Mulighed 1
Mulighed 2
Mulighed 3
Fejltolerance
—
+
+
Kompakthed
+
—
+
Implementeringskompleksitet
*
**
**
Mulighed 1 har en fatal ulempe: hvis en af headerne beskadiges, vil hele den efterfølgende kæde blive ødelagt. De andre muligheder tillader at genoprette dele af dataene, selv ved omfattende skader.
Men her er det værd at huske, at vi besluttede at gemme data i komprimeret form, så vi vil miste alle data på siden efter en "defekt" post. Selvom der står minus i tabellen, tager vi det ikke i betragtning.
Kompakthed:
- I den første mulighed skal vi kun gemme længden i headeren; hvis vi bruger variabel længde, kan vi i de fleste tilfælde klare os med ét byte;
- I den anden mulighed skal vi gemme startadressen og længden; posten skal have en konstant størrelse, jeg vurderer det til 4 bytes pr. post (to bytes til offset og to bytes til længde);
- Den tredje mulighed kræver kun ét tegn for at angive begyndelsen af posten, plus selve posten vil på grund af escaping vokse med 1-2%. Generelt er der omtrent paritet med den første mulighed.
Oprindeligt betragtede jeg den anden mulighed som den primære (og skrev endda en implementering). Jeg droppede den kun, da jeg endeligt besluttede at bruge komprimering.
Måske vil jeg en dag faktisk bruge en sådan mulighed. For eksempel hvis jeg skal opbevare data for et skib, der sejler mellem Jorden og Mars - helt andre krav til pålidelighed, rumstråling, …
Hvad angår den tredje mulighed: jeg gav den to stjerner for implementeringskompleksitet bare fordi jeg ikke kan lide at beskæftige mig med escaping, ændring af længde undervejs osv. Ja, det er måske forudindtaget, men det er mig, der skal skrive koden - hvorfor tvinge mig selv til at lave noget, jeg ikke kan lide.
Resume: Vi vælger en lagringstype i form af kæder "overskrift med længde - data af variabel længde" på grund af effektiviteten og enkel implementering.
Brug af bitfelter til at kontrollere succesraten for skriveoperationer
Jeg kan ikke huske, hvor jeg så idéen, men det ser omtrent sådan ud:
For hver opslag afsætter vi nogle bits til lagring af flag.
Som vi tidligere har nævnt, efter erase er alle bits fyldt med 1, og vi kan ændre 1 til 0, men ikke omvendt. Så for "flag ikke sat" bruger vi 1, for "flag sat" - 0.
Sådan kan placeringen af en variabel længde post i flash se ud:
- Vi sætter flaget "skrivning af længde er startet";
- Vi skriver længden;
- Vi sætter flaget "skrivning af data er startet";
- Vi skriver data;
- Vi sætter flaget "skrivning er afsluttet".
Derudover har vi et flag "der opstod en fejl", i alt 4 bitflag.
I dette tilfælde har vi to stabile tilstande "1111" - skrivningen er ikke startet, og "1000" - skrivningen er lykkedes; ved en uventet afbrydelse af skriveprocessen får vi mellemtilstande, som vi senere kan opdage og håndtere.
Tilgangen er interessant, men den beskytter kun mod pludselig strømafbrydelse og lignende fejl, hvilket selvfølgelig er vigtigt, men det er langt fra den eneste (og endda ikke den primære) årsag til mulige fejl.
Resume: Lad os fortsætte med at lede efter en god løsning.
Kontrolsummer
Kontrolsummer giver os også mulighed for at være sikre (med tilstrækkelig sandsynlighed) for, at vi læser akkurat det, der skulle være skrevet. Og i modsætning til de bitfelter, vi har gennemgået ovenfor, fungerer de altid.
Hvis vi overvejer listen over potentielle kilder til problemer, som vi nævnte ovenfor, kan kontrolsummen identificere fejl uanset deres oprindelse (med undtagelse af måske ondskabsfulde rumvæsener - de kan også forfalske kontrolsummen).
Så hvis vores mål er at kontrollere, at dataene er intakte, er kontrolsummer en fremragende idé.
Valget af algoritme til beregning af kontrolsummen gav ikke anledning til spørgsmål - CRC. På den ene side gør de matematiske egenskaber det muligt at fange 100% af fejl af visse typer, og på den anden side viser denne algoritme normalt en sandsynlighed for kollisioner, der ikke er meget større end den teoretiske grænse på tilfældige data.  Selvom det ikke er den hurtigste algoritme, og ikke altid den mest optimale med hensyn til antallet af kollisioner, har den en meget vigtig egenskab: i de tests, jeg har mødt, har der ikke været nogen mønstre, hvor den åbenlyst svigtede. Stabilitet er den vigtigste kvalitet i dette tilfælde.
Eksempel på en omfattende undersøgelse: , (links til narod.ru, undskyld).
Men opgaven med at vælge en kontrolsum er ikke afsluttet, CRC er en hel familie af checksums. Vi skal beslutte længden, og derefter vælge polynomiet.
Valget af længden på checksummen er ikke et så enkelt spørgsmål, som det kan synes ved første øjekast.
Jeg vil illustrere:
Lad os antage, at sandsynligheden for fejl i hver byte  og den ideelle kontrolsum, lad os beregne det gennemsnitlige antal fejl pr. million poster:
Data, byte
Kontrolsum, byte
Uopdagede fejl
Falske positive fejl
I alt forkerte aktiveringer
1
0
1000
0
1000
1
1
4
999
1003
1
2
≈0
1997
1997
1
4
≈0
3990
3990
10
0
9955
0
9955
10
1
39
990
1029
10
2
≈0
1979
1979
10
4
≈0
3954
3954
1000
0
632305
0
632305
1000
1
2470
368
2838
1000
2
10
735
745
1000
4
≈0
1469
1469
Det virker simpelt — vælg længden på checksummen afhængigt af længden af de beskyttede data med mindst mulige falske aktiveringer — og det er klaret.
Men med korte checksums opstår der et problem: selvom de godt opdager enkelte bitfejl, kan de med en ret høj sandsynlighed acceptere helt tilfældige data som gyldige. Der har allerede været en artikel på Habr, der beskrev .
Derfor, for at gøre tilfældige matches af checksummen praktisk talt umulige, skal man bruge checksums med længde på 32 bit eller mere (til længder over 64 bit bruger man normalt kryptografiske hash-funktioner).
På trods af at jeg tidligere har skrevet, at man skal spare plads med alle midler, vil vi alligevel bruge en 32-bit kontrolsum (16 bit er for lidt, kollisionssandsynligheden er over 0,01%; og 24 bit, som man siger, er hverken her eller der).
Her kan der opstå et indvending: har vi ikke sparet hver byte ved kompression for senere at give 4 byte væk? Var det ikke bedre ikke at komprimere og ikke tilføje en kontrolsum? Selvfølgelig ikke, mangel på kompression betyder ikke, at integritetskontrol ikke er nødvendig.
Vi vil ikke opfinde cyklen på valget af polynomiet, men tage den populære CRC-32C.
Denne kode opdager 6 bitfejl i pakker op til 22 byte (sandsynligvis den mest almindelige situation for os), 4 bitfejl i pakker op til 655 byte (også en hyppig situation for os), 2 eller et hvilket som helst ulige antal bitfejl i pakker af enhver rimelig længde.
Hvis nogen er interesseret i detaljerne
om CRC.
og få en fungerende kommando. — sandsynligvis den førende ekspert i verden inden for CRC.
I er , som giver lidt bedre parametre for de pakker, der er relevante for os, men jeg fandt ikke forskellen væsentlig og føler mig kompetent nok til at vælge en brugerdefineret kode frem for den standard og godt undersøgte.
Derudover, da vi har komprimerede data, opstår spørgsmaalet: skal vi beregne summen af kontrolekserne for de komprimerede eller ukomprimerede data?
Argumenter for at beregne summen af kontrolekserne for de ukomprimerede data:
- vi skal i sidste ende kontrollere, at dataene er bevaret — her kontrollerer vi det direkte (samtidig vil eventuelle fejl i implementationen af komprimering/afkomprimering, fejl forårsaget af beskadiget hukommelse osv. også blive kontrolleret);
- deflate-algoritmen i zlib har en tilstrækkelig moden implementering og bør ikke nedbrud på "skæve" inddata, tværtimod er den ofte i stand til selv at opdage fejl i indstrømningen, hvilket reducerer den samlede sandsynlighed for ikke at opdage en fejl (jeg lavede en test med at invertere en enkelt bit i en kort optagelse, zlib opdagede fejlen i ca. en tredjedel af tilfældene).
Argumenter imod at beregne summen af kontrolekserne for de ukomprimerede data:
- CRC er specifikt designet til de få bitfejl, der er karakteristiske for flash-hukommelse (en bitfejl i en komprimeret strøm kan føre til massivt ændret udgangsstrøm, på hvilken vi teoretisk set kan "fange" en kollision);
- jeg kan ikke lide tanken om at overføre potentielt beskadigede data til dekompressoren, , hvordan den vil reagere.
I dette projekt besluttede jeg at afvige fra den almindelige praksis med at gemme summen af kontrolekserne for de ukomprimerede data.
Resume: vi bruger CRC-32C, og vi beregner summen af kontrolekserne baseret på dataene i den form, de er gemt i flash (efter komprimering).
Overflødighed
Brugen af redundante kodninger udelukker selvfølgelig ikke datatab, men det kan væsentligt (ofte med mange rækkefordele) reducere sandsynligheden for uopretteligt datatab.
Vi kan anvende forskellige former for redundans for at korrigere fejl.
Hamming-koder kan rette enlige bitfejl, Reed-Solomon-koder kan håndtere tegnfejl, mens flere kopier af data sammen med kontrolsummer eller kodning som RAID-6 kan hjælpe med at genskabe data selv ved massefejl.
Oprindeligt var jeg indstillet på at bruge meget fejltolerant kodning, men jeg indså, at man først skal have en forståelse af, hvilke fejl man ønsker at beskytte sig imod, før man vælger kodningen.
Vi har tidligere talt om, at fejl skal opdages så hurtigt som muligt. Hvornår kan vi støde på fejl?
- Ufuldstændig registrering (af forskellige grunde, f.eks. strømmen gik under registreringen, Raspberry hang, …)
Desværre er der kun mulighed for at ignorere ugyldige registreringer og betragte data som tabt i tilfælde af en sådan fejl; - Skrivefejl (af forskellige grunde blev der skrevet noget andet til flash-hukommelsen end det, der skulle skrives)
Sådanne fejl kan vi straks opdage, hvis vi laver en kontrolaflæsning umiddelbart efter skrivning; - Forvrængning af data i hukommelsen under opbevaring;
- Læsefejl
For at rette det er det tilstrækkeligt at gentage aflæsningen flere gange, hvis kontrolsummen ikke stemmer overens.
Det vil sige, at kun fejl af den tredje type (spontan datakorruption under opbevaring) ikke kan rettes uden fejltolerant kodning. Man må antage, at sådanne fejl er yderst usandsynlige.
Resume: Det blev besluttet at opgive redundante kodninger, men hvis driften viser, at denne beslutning er fejlagtig, vil man overveje spørgsmålet igen (med allerede opsamlede statistikker om svigt, som vil muliggøre valg af den mest optimale kodning).
Andet
Naturligvis tillader artikelens format ikke at begrunde hver bit i formatet (og jeg er også blevet træt), derfor vil jeg kort skitsere nogle punkter, der ikke er blevet berørt tidligere.
- Det er besluttet at gøre alle sider "ligeværdige".
Det vil sige, at der ikke vil være nogle specielle sider med metadata, separate strømme osv., men i stedet en enkelt strøm, der skriver alle sider sekventielt.
Dette sikrer en jævn slid på siderne, fraværet af et enkelt fejlpunkts og passer bare til mig; - Der skal nødvendigvis tages højde for versionering af formatet.
Et format uden versionsnummer i overskriften er ondsindet!
Det er tilstrækkeligt at tilføje et felt med et eller andet Magic Number (signatur) i sidens overskrift, som vil angive den anvendte version af formatet. (Jeg tror ikke, at der i praksis vil være mere end ti af dem.); - Brug en variabel længdeoverskrift til posterne (hvilket der er rigtig mange af), og prøv for de fleste tilfælde at gøre den én byte lang.
- Til kodning af længden på overskriften og længden af den beskårne del af den komprimerede post skal der anvendes variable længdekoder.
Det hjalp meget af Huffman-koder. Jeg kunne bogstaveligt talt finde de nødvendige variable længdekoder på få minutter.
Beskrivelse af dataopbevaringsformatet.
Byteordens
Felter, der overstiger én bytes størrelse, gemmes i big-endian-format (netværks byteordens), det vil sige 0x1234 skrives som 0x12, 0x34.
Opdeling i sider
Hele flashhukommelsen er opdelt i sider af ens størrelse.
Standardstørrelsen på en side er 32 KB, men ikke mere end 1/4 af den samlede størrelse på hukommelseschippen (for en chip på 4 MB bliver det 128 sider).
Hver side gemmer data uafhængigt af andre (det vil sige data fra én side henviser ikke til data fra en anden side).
Alle sider er nummereret i naturlig rækkefølge (i stigende adresseorden), begyndende med nummer 0 (den nullæssige side begynder ved adresse 0, den første ved 32 KB, den anden ved 64 KB osv.).
Hukommelseschippen bruges som en cirkulær buffer (ring buffer), hvilket betyder, at skrivningen først går til siden med nummer 0, derefter til siden med nummer 1, … når vi fylder den sidste side, starter en ny cyklus, og skrivningen fortsætter fra den nullæssige side.
Inde i siden
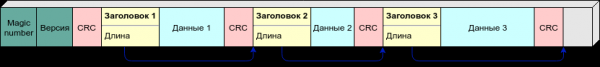
I begyndelsen af siden gemmes der en 4-byte sideoverskrift, derefter en kontrolsum af overskriften (CRC-32C), derefter gemmes posterne i formatet "overskrift, data, kontrolsum".
Sideoverskriften (i diagrammet er den smaragdgrøn) består af:
- et to-byte Magic Number felt (det er også - en indikator for formatversionen)
for den nuværende version af formatet betragtes det som0xed00 ⊕ side nummer; - to-bytters tæller "Versions nummer" (genopskrivningscyklus nummer).
Poster på siden gemmes i komprimeret form (deflate-algoritmen anvendes). Alle poster på én side komprimeres i én strøm (en fælles ordbog bruges), og komprimeringen starter på ny på hver ny side. Det betyder, at alle tidligere poster fra denne side kræves for at dekomprimere enhver post (og kun fra denne).
Hver post komprimeres med flaget Z_SYNC_FLUSH, hvilket betyder, at der i slutningen af den komprimerede strøm er 4 bytes 0x00, 0x00, 0xff, 0xff, som eventuelt kan være forudgået af en eller to null-bits.
Denne sekvens (4, 5 eller 6 bytes lang) kasseres, når der skrives til flashhukommelsen.
Headeren for posten består af 1, 2 eller 3 bytes, som indeholder:
- et bit (T), der betyder posttypen: 0 — kontekst, 1 — log;
- et variabelt længdefelt (S) fra 1 til 7 bits, der angiver længden på headeren og "halen", der skal tilføjes til posten for dekomprimering;
- længden af posten (L).
Værdi tabel S:
Angreb op til 1,2
Headerens længde, bytes
Kasseres ved skrivning, bytes
0
1
5 (00 00 00 ff ff)
10
1
6 (00 00 00 00 ff ff)
110
2
4 (00 00 ff ff)
1110
2
5 (00 00 00 ff ff)
11110
2
6 (00 00 00 00 ff ff)
1111100
3
4 (00 00 ff ff)
1111101
3
5 (00 00 00 ff ff)
1111110
3
6 (00 00 00 00 ff ff)
Forsøgte at illustrere, ved ikke, hvor klart det er:
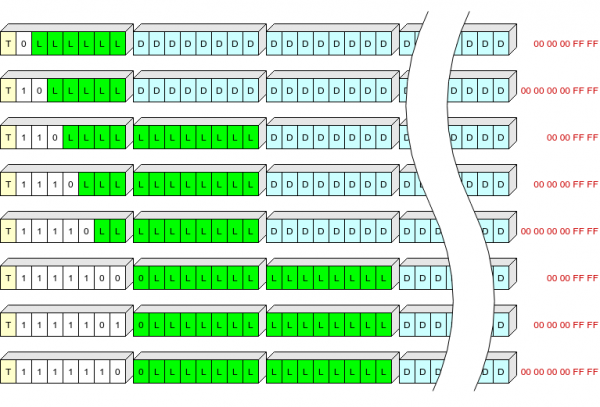
Gul markerer feltet T, hvid markerer feltet S, grøn markerer L (længden af de komprimerede data i bytes), blå markerer de komprimerede data, rød markerer de afsluttende bytes af de komprimerede data, som ikke skrives til flashhukommelsen.
Således kan vi gemme headeren for de mest almindelige længder (op til 63+5 bytes i komprimeret form) med én byte.
Efter hver post opbevares en CRC-32C kontrolsum, hvor det initiale værdien (init) bruges som den inverterede værdi af den forrige kontrolsum.
CRC har en "fortsættelses" egenskab, og sådan en formel fungerer (plus-minus bitinvertering i processen):  .
Det vil sige, at vi faktiske beregner CRC for alle tidligere bytes af headerne og dataene på denne side.
Lige efter kontrolsummen ligger headeren for den næste post.
Headeren er konstrueret sådan, at den første byte altid er forskellig fra 0x00 og 0xff (hvis vi møder 0xff i stedet for den første byte af headeren, betyder det, at det er et ubenyttet område; 0x00 indikerer en fejl).
Eksempler på algoritmer
Læsning fra flashhukommelsen
Enhver læsning sker med kontrolsum verificering.
Hvis kontrolsummen ikke stemmer overens, gentages læsningen flere gange i håbet om at læse de korrekte data.
(det giver mening, Linux cacher ikke læsning fra NOR Flash, bekræftet)
Skrivning til flashhukommelse
Vi skriver data.
Vi læser dem.
Hvis de læste data ikke matcher de skrevne, fylder vi området med nuller og signalerer en fejl.
Forberedelse af den nye chip til brug
Til initialisering skrives en header med version 1 til den første (mere præcist, nulte) side.
Derefter skrives den indledende kontekst (indeholder UUID for enheden og standardindstillinger) til denne side.
Alt er klar, flashhukommelsen er klar til brug.
Indlæsning af enheden
Under indlæsning læses de første 8 bytes af hver side (header + CRC), sider med ukendt Magic Number eller ukorrekt CRC ignoreres.
Fra de "korrekte" sider vælges sider med den højeste version, hvorfra siden med det højeste nummer tages.
Den første post læses, CRC-korrekthed og tilstedeværelsen af flaget "kontekst" kontrolleres. Hvis alt er i orden, betragtes denne side som den aktuelle. Hvis ikke, går vi tilbage til den forrige, indtil vi finder en "levende" side.
På den fundne side læser vi alle posterne, de med flaget "kontekst" anvender vi.
Vi gemmer zlib-ordbog (den vil være nødvendig for genopskrivning til denne side).
Alt er godt, indlæsningen er afsluttet, konteksten er genskabt, nu kan vi arbejde.
Tilføjelse af en post til loggen
Vi komprimerer posten med den korrekte ordbog, angiver Z_SYNC_FLUSH. Vi ser, om den komprimerede post kan placeres på den nuværende side.
Hvis den ikke kan placeres (eller der var CRC-fejl på siden) - starter vi en ny side (se nedenfor).
Vi skriver posten og CRC. Hvis der opstod en fejl - starter vi en ny side.
Ny side
Vi vælger en ledig side med det laveste nummer (vi betragter en side som ledig, hvis der er en forkert kontrolsum i headeren eller en version mindre end den aktuelle). Hvis der ikke er sådanne sider, vælger vi en side med det laveste nummer med en version, der er lig med den aktuelle.
Vi sætter den valgte side til at blive slettet. Vi sammenligner indholdet med 0xff. Hvis der er noget galt, tager vi den næste ledige side osv.
Til den slettede side skriver vi headeren, som den første post, den aktuelle tilstand af konteksten, den næste - ikke skrevne post fra loggen (hvis der er en).
Anvendelighed af formatet
Efter min mening er dette en god format til opbevaring af enhver nævneværdig komprimerbar informationsstrøm (enkelt tekst, JSON, MessagePack, CBOR, muligvis protobuf) i NOR Flash.
Selvfølgelig er formatet "tilpasset" SLC NOR Flash.
Det skal ikke bruges med medier med høj BER, som NAND eller MLC NOR. (er sådan hukommelse overhovedet til salg? Jeg har kun set omtale af det i artikler om fejlkorrektioner.).
Endda bør det ikke bruges med enheder, der har deres egen FTL: USB flash, SD, MicroSD osv. (for sådan hukommelse lavede jeg et format med en side størrelse på 512 byte, en signatur i begyndelsen af hver side og unikke postnumre — nogle gange lykkedes det at gendanne alle data ved simpel sekventiel læsning fra en "fejlende" flash-ven.).
Afhængigt af opgaverne kan formatet bruges uændret på flash-drev fra 128 Kbit (16 Kb) til 1 Gbit (128 Mb). Hvis ønskes, kan det også bruges på chips med større kapacitet, men det skal nok tilpasses sidestørrelsen. (Men her opstår spørgsmålet om økonomisk rentabilitet, prisen på højkapacitets NOR Flash er ikke tilfredsstillende.).
Hvis nogen har fundet formatet interessant og ønsker at bruge det i et åbent projekt — skriv, så vil jeg prøve at finde tid til at forbedre koden og uploade den til GitHub.
Konklusion
Som vi kan se, viste formatet sig at være enkelt. og endda kedeligt..
I artiklen er det svært at skildre evolutionen af min mening, men tro mig: i starten ville jeg skabe noget avanceret, næsten ubrydeligt, i stand til at overleve selv efter en atomexplosion i nærheden. Men fornuften (forhåbentlig) sejrede, og prioriteterne skiftede gradvist mod enkelhed og kompakthed.
Kan det være, at jeg tog fejl? Ja, selvfølgelig. Det kan meget vel vise sig, for eksempel, at vi har købt en batch af defekte chips. Eller af en eller anden grund, at udstyret ikke vil leve op til forventningerne om pålidelighed.
Har jeg en plan for dette tilfælde? Jeg tror, at efter at have læst artiklen, vil du ikke tvivle på, at der er en plan. Og ikke bare én.
Hvis vi ser lidt mere seriøst på det, er formatet udviklet både som en arbejdsvariant og som et "forsøg".
I øjeblikket fungerer alt fint på bordet, løsningen vil snart blive implementeret. (cirka) På hundrede enheder, lad os se, hvad der sker under "virkelig" drift (heldigvis håber jeg, at formatet gør det muligt at registrere fejl pålideligt; så vi kan samle en komplet statistik). Om et par måneder kan der drages konklusioner. (og hvis uheldet er ude — så før det).
Hvis der opdages alvorlige problemer efter brug, og der er behov for forbedringer, vil jeg bestemt skrive om det.
Litteratur
Jeg ønskede ikke at lave en lang, kedelig liste over de anvendte værker, alle har jo Google.
Her besluttede jeg at efterlade en liste over fund, som jeg syntes var særligt interessante, men efterhånden blev de direkte indarbejdet i teksten, og der er kun én post tilbage på listen:
- Utility fra forfatteren zlib. Den kan vise indholdet af deflate/zlib/gzip-arkiver på en forståelig måde. Hvis du skal forstå den indre struktur af deflate-formatet (eller gzip) — kan jeg stærkt anbefale det.
Kilde: habr.com
