

Artiklen omhandler flere metoder til at bestemme matematiske ligninger for en simpel (parret) regression.
Alle de metoder, der her diskuteres, er baseret på metoden med de mindste kvadrater. Lad os betegne metoderne som følger:
- Analytisk løsning
- Gradientfald
- Stokastisk gradient nedstigning
For hver af metoderne til løsning af ligningen for en lineær regression præsenteres forskellige funktioner, som generelt opdeles i dem, der er skrevet uden brug af biblioteket NumPy og dem, der anvender NumPy. Det anses for, at dygtig brug af NumPy vil bidrage til at reducere beregningsomkostningerne.
Hele koden, der præsenteres i artiklen, er skrevet på sproget python 2.7 ved hjælp af Jupyter Notebook. Kildekoden og dataprøven er tilgængelig på
Artiklen er primært rettet mod både begyndere og dem, der allerede er begyndt at lære om den meget omfattende del af kunstig intelligens - maskinlæring.
For at illustrere materialet bruger vi et meget simpelt eksempel.
Eksemplets betingelser
Vi har fem værdier, der karakteriserer afhængigheden af Y fra X (Tabel nr. 1):
Tabel nr. 1 «Eksemplets betingelser»
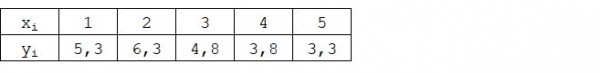
Lad os antage, at værdierne  er måneden på året, og
 er indtægten i denne måned. Med andre ord afhænger indtægten af måneden, og
 er det eneste træk, som indtægten afhænger af.
Eksemplet er ikke det bedste, hverken med hensyn til den hypotetiske afhængighed af indtægten af måneden eller med hensyn til antallet af værdier - der er for få. Imidlertid tillader denne forenkling, hvad man kan kalde på fingrene, at forklare materialet, som nybegyndere ikke altid let forstår. Desuden vil enkelheden i tallene gøre det muligt for dem, der ønsker det, at løse eksemplet på "papir" uden store arbejdsomkostninger.
Lad os antage, at den afhængighed, der præsenteres i eksemplet, kan tilnærmes ret godt af en matematisk ligning for en simpel (parret) regressionslinje af formen:

hvor  er måneden, hvor indtægten blev opnået,
 er indtægten svarende til måneden,
 og
 er regressionskoefficienterne for den estimerede linje.
Det skal bemærkes, at koefficienten  ofte kaldes hældningskoefficienten eller gradienten for den estimerede linje; den repræsenterer den mængde, som
 ændres ved ændring af
 .
Det er indlysende, at vores opgave i eksemplet er at finde sådanne koefficienter i ligningen.  og
 , hvor afvigelserne af vores beregnede omsætningsværdier pr. måned fra de sande svar, det vil sige værdierne præsenteret i udvalget, vil være minimale.
Metoden for mindste kvadrater
I henhold til metoden for mindste kvadrater skal afvigelsen beregnes ved at kvadrere den. Denne tilgang undgår overensstemmelse af afvigelser, hvis de har modsatte tegn. For eksempel, hvis i et tilfælde afvigelsen er +5 (plus fem), og i et andet -5 (minus fem), så vil summen af afvigelserne ophæve hinanden og være 0 (nul). Man kan også undgå at kvadrere afvigelsen og i stedet benytte modulus, så alle afvigelser bliver positive og akkumuleres. Vi vil ikke stoppe op ved dette punkt, men blot angive, at det for nemheds skyld er almindeligt at kvadrere afvigelsen.
Her er formlen, som vi bruger til at bestemme den mindste sum af kvadrerede afvigelser (fejl):

hvor  — dette er funktionen for approksimation af de sande svar (det vil sige den omsætning, vi har beregnet),
 — disse er de sande svar (den omsætning, der er præsenteret i udvalget),
 — dette er udvalgsindekset (månedens nummer, i hvilken afvigelsen bestemmes)
Vi differentierer funktionen, bestemmer ligningerne for de partielle afledte og er klar til at gå til den analytiske løsning. Men først lad os lave en kort introduktion til, hvad differentiering er, og minde os om den geometriske betydning af derivatet.
Differentiering
Differentiering er operationen med at finde den afledte funktion.
Hvad er formålet med den afledte? Den afledte funktion karakteriserer hastigheden af ændringen af funktionen og angiver dens retning. Hvis den afledte i et givet punkt er positiv, stiger funktionen; omvendt, hvis den er negativ, falder funktionen. Jo større værdien af den afledte er i absolut værdi, desto højere er hastigheden af ændringen af funktionens værdier, og desto stejlere er grafens hældning.
For eksempel, i koordinatsystemet med kartesiske koordinater, betyder værdien af den afledte i punktet M(0,0) +25 at i det givne punkt, når værdien  flyttes til højre med én enhed, stiger værdien
 med 25 enheder. På grafen ser dette ud som en ret stejl hældning af værdierne
 fra det givne punkt.
Et andet eksempel. Værdien af derivatet lig med -0,1 betyder, at når vi flytter  med én enhed, falder værdien
 kun med 0,1 enhed. På grafen for funktionen kan vi se en knap mærkbar nedadgående hældning. Hvis vi sammenligner med et bjerg, er det som om vi meget langsomt glider ned ad en svag skrænt, i modsætning til det tidligere eksempel, hvor vi måtte klatre op ad meget stejle toppe :)
Dermed, ved at differentiere funktionen  i forhold til koefficienterne
 og
 , bestemmer vi ligningerne for de partielle afledte 1. orden. Efter at have fundet ligningerne, får vi et system af to ligninger, som vi kan løse for at finde sådanne koefficientværdier
 og
 , hvor værdierne af de relevante afledte i de angivne punkter ændres med en meget lille mængde, og i tilfælde af en analytisk løsning ændres de slet ikke. Med andre ord vil fejlfunktionen med de fundne koefficienter nå et minimum, da værdierne af de partielle afledte i disse punkter vil være lig med nul.
Så ifølge reglerne for differentiering er ligningen for den partielle afledte 1. orden i forhold til koefficienten  vil have formen:

ligningen for den partielle afledte 1. orden i forhold til  vil have formen:

Som resultat har vi fået et system af ligninger, der har en ganske simpel analytisk løsning:
begin{equation*}
begin{cases}
na + bsumlimits_{i=1}^nx_i - sumlimits_{i=1}^ny_i = 0
sumlimits_{i=1}^nx_i(a + bsumlimits_{i=1}^nx_i - sumlimits_{i=1}^ny_i) = 0
end{cases}
end{equation*}
Før vi løser ligningen, vil vi først indlæse, kontrollere korrektheden af indlæsningen og formatere dataene.
Indlæsning og formatering af data
Det er vigtigt at nævne, at i forbindelse med den analytiske løsning, og senere for gradient og stochastisk gradientnedstigning, vil vi anvende koden i to varianter: med og uden brug af biblioteket NumPy og uden dens anvendelse, så vi vil have brug for den korrekte formatering af dataene (se koden).
Kode til indlæsning og behandling af data
# импортируем все нужные нам библиотеки
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import math
import pylab as pl
import random

# графики отобразим в Jupyter
%matplotlib inline

# укажем размер графиков
from pylab import rcParams
rcParams['figure.figsize'] = 12, 6

# отключим предупреждения Anaconda
import warnings
warnings.simplefilter('ignore')

# загрузим значения
table_zero = pd.read_csv('data_example.txt', header=0, sep='t')

# посмотрим информацию о таблице и на саму таблицу
print table_zero.info()
print '********************************************'
print table_zero
print '********************************************'

# подготовим данные без использования NumPy

x_us = []
[x_us.append(float(i)) for i in table_zero['x']]
print x_us
print type(x_us)
print '********************************************'

y_us = []
[y_us.append(float(i)) for i in table_zero['y']]
print y_us
print type(y_us)
print '********************************************'

# подготовим данные с использованием NumPy

x_np = table_zero[['x']].values
print x_np
print type(x_np)
print x_np.shape
print '********************************************'

y_np = table_zero[['y']].values
print y_np
print type(y_np)
print y_np.shape
print '********************************************'
Visualisering
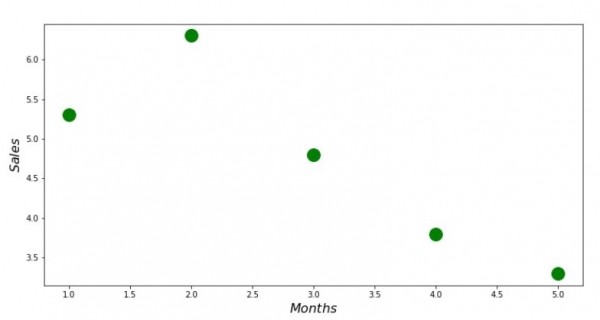
Nu, efter at vi for det første har indlæst dataene, for det andet har kontrolleret indlæsningens korrekthed og endelig har formateret dataene, lad os lave den første visualisering. Dette gøres ofte ved hjælp af metoden pairplot biblioteket Seaborn. I vores eksempel, på grund af begrænsningen af tal, er der ikke nogen mening i at anvende biblioteket Seaborn. Vi vil bruge det almindelige bibliotek Matplotlib og kun se på scatter-diagrammet.
Kode til scatter-diagram
print 'Grafik nr. 1 "Afhængighed af indtægter fra årets måneder"'

plt.plot(x_us,y_us,'o',color='green',markersize=16)
plt.xlabel('$Måneder$', size=16)
plt.ylabel('$Indtægter$', size=16)
plt.show()
Grafik nr. 1 «Afhængighed af indtægter fra måned i året»
Analytisk løsning
Vi vil benytte de mest almindelige værktøjer i python og løse ligningssystemet:
begin{equation*}
begin{cases}
na + bsumlimits_{i=1}^nx_i - sumlimits_{i=1}^ny_i = 0
sumlimits_{i=1}^nx_i(a + bsumlimits_{i=1}^nx_i - sumlimits_{i=1}^ny_i) = 0
end{cases}
end{equation*}
Ifølge Cramers regel finder vi den generelle determinant samt determinanterne for  og for
 , hvorefter vi kan finde koefficienten ved at dividere determinanten for
 med den generelle determinant — så finder vi koefficienten
 , og på samme måde finder vi koefficienten
 .
Koden til den analytiske løsning
# определим функцию для расчета коэффициентов a и b по правилу Крамера
def Kramer_method (x,y):
        # сумма значений (все месяца)
    sx = sum(x)
        # сумма истинных ответов (выручка за весь период)
    sy = sum(y)
        # сумма произведения значений на истинные ответы
    list_xy = []
    [list_xy.append(x[i]*y[i]) for i in range(len(x))]
    sxy = sum(list_xy)
        # сумма квадратов значений
    list_x_sq = []
    [list_x_sq.append(x[i]**2) for i in range(len(x))]
    sx_sq = sum(list_x_sq)
        # количество значений
    n = len(x)
        # общий определитель
    det = sx_sq*n - sx*sx
        # определитель по a
    det_a = sx_sq*sy - sx*sxy
        # искомый параметр a
    a = (det_a / det)
        # определитель по b
    det_b = sxy*n - sy*sx
        # искомый параметр b
    b = (det_b / det)
        # контрольные значения (прооверка)
    check1 = (n*b + a*sx - sy)
    check2 = (b*sx + a*sx_sq - sxy)
    return [round(a,4), round(b,4)]

# запустим функцию и запишем правильные ответы
ab_us = Kramer_method(x_us,y_us)
a_us = ab_us[0]
b_us = ab_us[1]
print ' 33[1m' + ' 33[4m' + "Оптимальные значения коэффициентов a и b:"  + ' 33[0m'
print 'a =', a_us
print 'b =', b_us
print

# определим функцию для подсчета суммы квадратов ошибок
def errors_sq_Kramer_method(answers,x,y):
    list_errors_sq = []
    for i in range(len(x)):
        err = (answers[0] + answers[1]*x[i] - y[i])**2
        list_errors_sq.append(err)
    return sum(list_errors_sq)

# запустим функцию и запишем значение ошибки
error_sq = errors_sq_Kramer_method(ab_us,x_us,y_us)
print ' 33[1m' + ' 33[4m' + "Сумма квадратов отклонений" + ' 33[0m'
print error_sq
print

# замерим время расчета
# print ' 33[1m' + ' 33[4m' + "Время выполнения расчета суммы квадратов отклонений:" + ' 33[0m'
# % timeit error_sq = errors_sq_Kramer_method(ab,x_us,y_us)
Her er, hvad vi har fået:
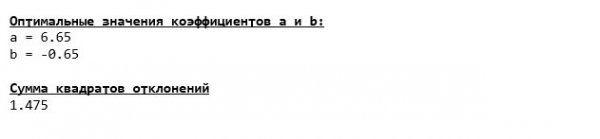
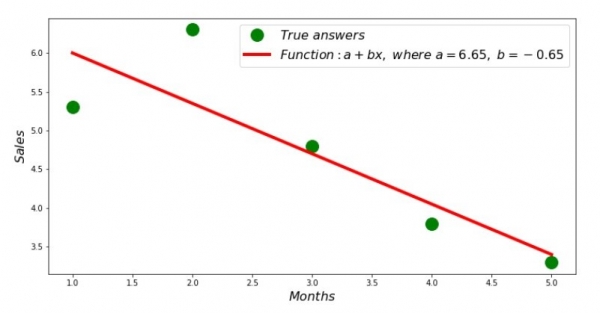
Så koefficientværdierne er fundet, summen af kvadraterne afvigelserne er etableret. Lad os tegne en lige linje på spredningsdiagrammet i overensstemmelse med de fundne koefficienter.
Koden til regressionslinjen
# определим функцию для формирования массива рассчетных значений выручки
def sales_count(ab,x,y):
    line_answers = []
    [line_answers.append(ab[0]+ab[1]*x[i]) for i in range(len(x))]
    return line_answers

# построим графики
print 'Грфик№2 "Правильные и расчетные ответы"'
plt.plot(x_us,y_us,'o',color='green',markersize=16, label = '$True$ $answers$')
plt.plot(x_us, sales_count(ab_us,x_us,y_us), color='red',lw=4,
         label='$Function: a + bx,$ $where$ $a='+str(round(ab_us[0],2))+',$ $b='+str(round(ab_us[1],2))+'$')
plt.xlabel('$Months$', size=16)
plt.ylabel('$Sales$', size=16)
plt.legend(loc=1, prop={'size': 16})
plt.show()
Grafik nr. 2 «Rette og beregnede svar»
Vi kan se på grafikken over afvigelser for hver måned. I vores tilfælde vil vi ikke udtrække nogen signifikant praktisk værdi fra den, men vi vil tilfredsstille nysgerrigheden om, hvor godt ligningen for simpel linear regression beskriver afhængigheden af indtægter fra måned i året.
Koden til afvigelsesgrafikken
# определим функцию для формирования массива отклонений в процентах
def error_per_month(ab,x,y):
    sales_c = sales_count(ab,x,y)
    errors_percent = []
    for i in range(len(x)):
        errors_percent.append(100*(sales_c[i]-y[i])/y[i])
    return errors_percent

# построим график
print 'График№3 "Отклонения по-месячно, %"'
plt.gca().bar(x_us, error_per_month(ab_us,x_us,y_us), color='brown')
plt.xlabel('Months', size=16)
plt.ylabel('Calculation error, %', size=16)
plt.show()
Grafik nr. 3 «Afvigelser, %»
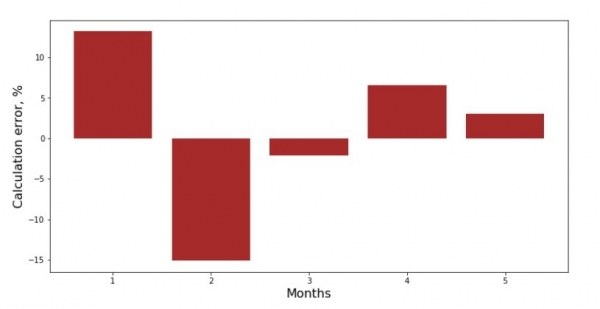
Ikke perfekt, men vi har gennemført vores opgave.
Lad os skrive en funktion, der til bestemmelser af koefficienter  og
 bruger biblioteket NumPy, nærmere sagt — lad os skrive to funktioner: en med brug af pseudoinverteret matrix (ikke anbefalet i praksis, da processen er beregningsmæssigt udfordrende og ustabil), den anden med brug af matrixligning.
Koden til den analytiske løsning (NumPy)
# для начала добавим столбец с не изменяющимся значением в 1.
# Данный столбец нужен для того, чтобы не обрабатывать отдельно коэффицент a
vector_1 = np.ones((x_np.shape[0],1))
x_np = table_zero[['x']].values # на всякий случай приведем в первичный формат вектор x_np
x_np = np.hstack((vector_1,x_np))

# проверим то, что все сделали правильно
print vector_1[0:3]
print x_np[0:3]
print '***************************************'
print

# напишем функцию, которая определяет значения коэффициентов a и b с использованием псевдообратной матрицы
def pseudoinverse_matrix(X, y):
    # задаем явный формат матрицы признаков
    X = np.matrix(X)
    # определяем транспонированную матрицу
    XT = X.T
    # определяем квадратную матрицу
    XTX = XT*X
    # определяем псевдообратную матрицу
    inv = np.linalg.pinv(XTX)
    # задаем явный формат матрицы ответов
    y = np.matrix(y)
    # находим вектор весов
    return (inv*XT)*y

# запустим функцию
ab_np = pseudoinverse_matrix(x_np, y_np)
print ab_np
print '***************************************'
print

# напишем функцию, которая использует для решения матричное уравнение
def matrix_equation(X,y):
    a = np.dot(X.T, X)
    b = np.dot(X.T, y)
    return np.linalg.solve(a, b)

# запустим функцию
ab_np = matrix_equation(x_np,y_np)
print ab_np
Lad os sammenligne den tid, der blev brugt på at bestemme koefficienterne  og
 , i overensstemmelse med de 3 præsenterede metoder.
Koden til beregningstiden
print ' 33[1m' + ' 33[4m' + "Tid til at beregne koefficienter uden brug af NumPy-biblioteket:" + ' 33[0m'
% timeit ab_us = Kramer_method(x_us,y_us)
print '***************************************'
print
print ' 33[1m' + ' 33[4m' + "Tid til at beregne koefficienter med brug af pseudoinverteret matrix:" + ' 33[0m'
%timeit ab_np = pseudoinverse_matrix(x_np, y_np)
print '***************************************'
print
print ' 33[1m' + ' 33[4m' + "Tid til at beregne koefficienter med brug af matrixligning:" + ' 33[0m'
%timeit ab_np = matrix_equation(x_np, y_np)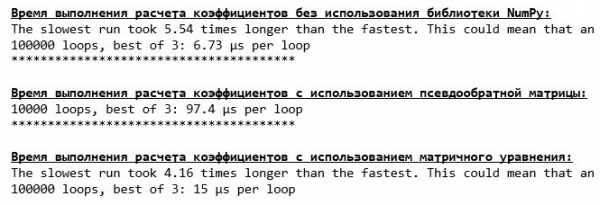
Ved et begrænset antal data tager den 'hjemmelavede' funktion, der bruger Cramers metode til at finde koefficienterne, føringen.
Nu kan vi gå videre til andre metoder til at finde koefficienterne  og
 .
Gradientfald
Lad os først definere, hvad en gradient er. Enkelt sagt er gradienten et segment, der angiver retningen for den maksimale vækst af en funktion. Ligesom at bestige et bjerg; der hvor gradienten peger, er den stejleste stigning mod bjergets top. Hvis vi fortsætter med eksemplet med bjerget, skal vi huske, at vi faktisk har brug for den stejleste nedstigning for hurtigere at nå lavlandet, dvs. minimum — stedet hvor funktionen hverken vokser eller falder. På dette sted vil den afledte være lig med nul. Derfor har vi brug for ikke en gradient, men en antigradient. For at finde antigradienten skal vi blot gange gradienten med -1 (minus én).
Vi bemærker, at funktionen kan have flere minima, og hvis vi falder ned i et af dem efter den nedenfor foreslåede algoritme, vil vi ikke kunne finde et andet minimum, som muligvis ligger lavere end det fundne. Lad os slappe af, det bekymrer os ikke! I vores tilfælde har vi at gøre med et enkelt minimum, da vores funktion  på grafen er en almindelig parabel. Som vi alle bør vide fra matematikundervisningen i skolen — har en parabel kun ét minimum.
Når vi har afklaret, hvorfor vi har brug for gradienten, samt at gradienten er et segment, altså en vektor med givne koordinater, som netop er de nævnte koefficienter,  og
 kan vi implementere gradient descent.
Før vi starter, foreslår jeg, at vi læser blot et par sætninger om descent-algoritmen:
- Vi definerer koefficienternes koordinater pseudotilfældig.
 og I vores eksempel vil vi bestemme koefficienterne tæt på nul. Dette er en almindelig praksis, men for hver situation kan der være sin egen praksis.
- Fra koordinaten trækker vi værdien af den partielle afledning af 1. orden på punktet . Så hvis den afledte er positiv, vokser funktionen. Derfor, ved at trække værdien af den afledte fra, bevæger vi os i den modsatte retning af væksten, altså nedad. Hvis den afledte er negativ, falder funktionen på dette punkt, og ved at trække værdien af den afledte fra bevæger vi os nedad.
- Vi udfører en lignende operation med koordinaten : vi trækker værdien af den partielle afledning på punktet .
- For not skipping the minimum and not drifting off into deep space, it's necessary to set the step size in the descent direction. Overall, one could write an entire article on how to properly set the step and how to change it during the descent process to reduce computational costs. But now we have a somewhat different task ahead, and through a scientific method of 'trial and error' or as people commonly say, through empirical means, we will establish the step size.
- After we subtract the derivative values from the specified coordinates, og we obtain new coordinates. og We take the next step (the subtraction) from the calculated coordinates. And thus, the cycle restarts again and again until the required convergence is achieved.
 og
 I vores eksempel vil vi bestemme koefficienterne tæt på nul. Dette er en almindelig praksis, men for hver situation kan der være sin egen praksis.
 trækker vi værdien af den partielle afledning af 1. orden på punktet
 . Så hvis den afledte er positiv, vokser funktionen. Derfor, ved at trække værdien af den afledte fra, bevæger vi os i den modsatte retning af væksten, altså nedad. Hvis den afledte er negativ, falder funktionen på dette punkt, og ved at trække værdien af den afledte fra bevæger vi os nedad.
 : vi trækker værdien af den partielle afledning på punktet
 .
 og
 we obtain new coordinates.
 og
 We take the next step (the subtraction) from the calculated coordinates. And thus, the cycle restarts again and again until the required convergence is achieved.
That's it! Now we are ready to go in search of the deepest part of the Mariana Trench. Let's get started.
Code for gradient descent
# напишем функцию градиентного спуска без использования библиотеки NumPy.
# Функция на вход принимает диапазоны значений x,y, длину шага (по умолчанию=0,1), допустимую погрешность(tolerance)
def gradient_descent_usual(x_us,y_us,l=0.1,tolerance=0.000000000001):
    # сумма значений (все месяца)
    sx = sum(x_us)
    # сумма истинных ответов (выручка за весь период)
    sy = sum(y_us)
    # сумма произведения значений на истинные ответы
    list_xy = []
    [list_xy.append(x_us[i]*y_us[i]) for i in range(len(x_us))]
    sxy = sum(list_xy)
    # сумма квадратов значений
    list_x_sq = []
    [list_x_sq.append(x_us[i]**2) for i in range(len(x_us))]
    sx_sq = sum(list_x_sq)
    # количество значений
    num = len(x_us)
    # начальные значения коэффициентов, определенные псевдослучайным образом
    a = float(random.uniform(-0.5, 0.5))
    b = float(random.uniform(-0.5, 0.5))
    # создаем массив с ошибками, для старта используем значения 1 и 0
    # после завершения спуска стартовые значения удалим
    errors = [1,0]
    # запускаем цикл спуска
    # цикл работает до тех пор, пока отклонение последней ошибки суммы квадратов от предыдущей, не будет меньше tolerance
    while abs(errors[-1]-errors[-2]) > tolerance:
        a_step = a - l*(num*a + b*sx - sy)/num
        b_step = b - l*(a*sx + b*sx_sq - sxy)/num
        a = a_step
        b = b_step
        ab = [a,b]
        errors.append(errors_sq_Kramer_method(ab,x_us,y_us))
    return (ab),(errors[2:])

# запишем массив значений
list_parametres_gradient_descence = gradient_descent_usual(x_us,y_us,l=0.1,tolerance=0.000000000001)


print ' 33[1m' + ' 33[4m' + "Значения коэффициентов a и b:" + ' 33[0m'
print 'a =', round(list_parametres_gradient_descence[0][0],3)
print 'b =', round(list_parametres_gradient_descence[0][1],3)
print


print ' 33[1m' + ' 33[4m' + "Сумма квадратов отклонений:" + ' 33[0m'
print round(list_parametres_gradient_descence[1][-1],3)
print


print ' 33[1m' + ' 33[4m' + "Количество итераций в градиентном спуске:" + ' 33[0m'
print len(list_parametres_gradient_descence[1])
print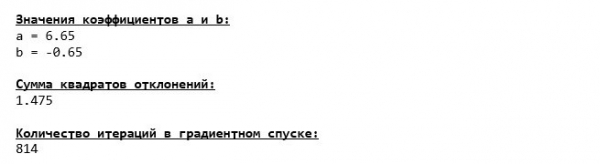
We have descended to the bottom of the Mariana Trench and found all the same coefficient values,  og
 which is what we expected.
Let's make one more dive, but this time, the filling of our deep-sea apparatus will consist of different technologies, specifically the library NumPy.
Code for gradient descent (NumPy)
# перед тем определить функцию для градиентного спуска с использованием библиотеки NumPy,
# напишем функцию определения суммы квадратов отклонений также с использованием NumPy
def error_square_numpy(ab,x_np,y_np):
    y_pred = np.dot(x_np,ab)
    error = y_pred - y_np
    return sum((error)**2)

# напишем функцию градиентного спуска с использованием библиотеки NumPy.
# Функция на вход принимает диапазоны значений x,y, длину шага (по умолчанию=0,1), допустимую погрешность(tolerance)
def gradient_descent_numpy(x_np,y_np,l=0.1,tolerance=0.000000000001):
    # сумма значений (все месяца)
    sx = float(sum(x_np[:,1]))
    # сумма истинных ответов (выручка за весь период)
    sy = float(sum(y_np))
    # сумма произведения значений на истинные ответы
    sxy = x_np*y_np
    sxy = float(sum(sxy[:,1]))
    # сумма квадратов значений
    sx_sq = float(sum(x_np[:,1]**2))
    # количество значений
    num = float(x_np.shape[0])
    # начальные значения коэффициентов, определенные псевдослучайным образом
    a = float(random.uniform(-0.5, 0.5))
    b = float(random.uniform(-0.5, 0.5))
    # создаем массив с ошибками, для старта используем значения 1 и 0
    # после завершения спуска стартовые значения удалим
    errors = [1,0]
    # запускаем цикл спуска
    # цикл работает до тех пор, пока отклонение последней ошибки суммы квадратов от предыдущей, не будет меньше tolerance
    while abs(errors[-1]-errors[-2]) > tolerance:
        a_step = a - l*(num*a + b*sx - sy)/num
        b_step = b - l*(a*sx + b*sx_sq - sxy)/num
        a = a_step
        b = b_step
        ab = np.array([[a],[b]])
        errors.append(error_square_numpy(ab,x_np,y_np))
    return (ab),(errors[2:])

# запишем массив значений
list_parametres_gradient_descence = gradient_descent_numpy(x_np,y_np,l=0.1,tolerance=0.000000000001)

print ' 33[1m' + ' 33[4m' + "Значения коэффициентов a и b:" + ' 33[0m'
print 'a =', round(list_parametres_gradient_descence[0][0],3)
print 'b =', round(list_parametres_gradient_descence[0][1],3)
print


print ' 33[1m' + ' 33[4m' + "Сумма квадратов отклонений:" + ' 33[0m'
print round(list_parametres_gradient_descence[1][-1],3)
print

print ' 33[1m' + ' 33[4m' + "Количество итераций в градиентном спуске:" + ' 33[0m'
print len(list_parametres_gradient_descence[1])
print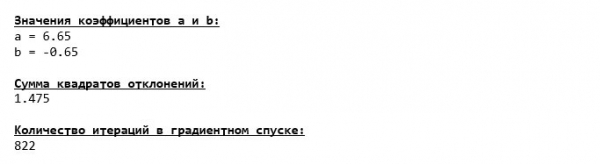
The coefficient values  og
 are unchanged.
Let's look at how the error changed during the gradient descent, that is, how the sum of squared deviations changed with each step.
Code for the graph of the sum of squared deviations
print 'Graph No. 4 "Sum of squared deviations step-by-step"'
plt.plot(range(len(list_parametres_gradient_descence[1])), list_parametres_gradient_descence[1], color='red', lw=3)
plt.xlabel('Steps (Iteration)', size=16)
plt.ylabel('Sum of squared deviations', size=16)
plt.show()
Graph No. 4 "Sum of squared deviations during gradient descent"
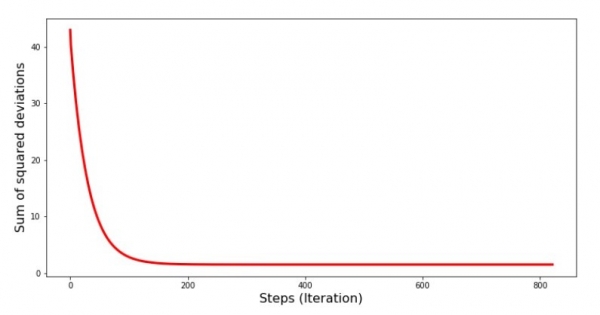
On the graph, we see that with each step the error decreases, and after a certain number of iterations, we observe an almost horizontal line.
Finally, let's assess the difference in execution time of the code:
Code to determine the computation time of the gradient descent
print ' 33[1m' + ' 33[4m' + "Execution time of gradient descent without using the NumPy library:" + ' 33[0m'
%timeit list_parametres_gradient_descence = gradient_descent_usual(x_us,y_us,l=0.1,tolerance=0.000000000001)
print '***************************************'
print

print ' 33[1m' + ' 33[4m' + "Execution time of gradient descent using the NumPy library:" + ' 33[0m'
%timeit list_parametres_gradient_descence = gradient_descent_numpy(x_np,y_np,l=0.1,tolerance=0.000000000001)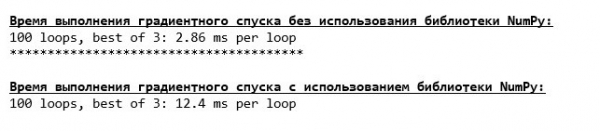
Måske gør vi noget forkert, men alligevel overgår en simpel 'håndlavet' funktion, der ikke bruger et bibliotek NumPy tidsmæssigt en funktion, der bruger et bibliotek NumPy.
Men vi står ikke stille, og vi bevæger os i retning af at lære en anden spændende metode til at løse ligningen for simpel lineær regression. Mød!
Stokastisk gradient nedstigning
For bedre at forstå, hvordan stochastisk gradientnedstigning fungerer, er det bedst at definere dets forskelle fra almindelig gradientnedstigning. I vores tilfælde med gradientnedstigning brugte vi i derivatligningerne  og
 summen af værdierne for alle egenskaber og de sande svar, der er tilgængelige i datasættet (det vil sige summen af alle
 og
 ). I stochastisk gradientnedstigning vil vi ikke bruge alle værdierne i datasættet, men i stedet pseudo-tilfældigvis vælge den såkaldte udvalgindeks og bruge dens værdier.
For eksempel, hvis indekset viser sig at være nummer 3 (tre), så tager vi værdierne  og
 , derefter indsætter vi værdierne i derivatligningerne og bestemmer nye koordinater. Så, efter at have bestemt koordinaterne, vælger vi igen pseudo-tilfældigvis udvalgindekset, indsætter værdierne, der svarer til indekset, i ligningerne for partielle afledte, og bestemmer igen koordinaterne
 og
 osv. indtil konvergens er opnået. Ved første øjekast kan det virke som om, hvordan dette overhovedet kan fungere, men det virker. Det skal dog bemærkes, at fejlen ikke nødvendigvis falder med hvert skridt, men der er bestemt en tendens.
Hvad er fordelene ved stochastisk gradientnedstigning i forhold til almindelig? Hvis vi har en meget stor størrelse af datasættet, der måles i titusinder af værdier, er det meget nemmere at behandle, lad os sige, en tilfældig tusinde af dem i stedet for hele datasættet. I dette tilfælde aktiveres den stochastiske gradientnedstigning. I vores tilfælde vil vi selvfølgelig ikke bemærke en stor forskel.
Lad os se på koden.
Kode til stochastisk gradientnedstigning
# определим функцию стох.град.шага
def stoch_grad_step_usual(vector_init, x_us, ind, y_us, l):
#     выбираем значение икс, которое соответствует случайному значению параметра ind
# (см.ф-цию stoch_grad_descent_usual)
    x = x_us[ind]
#     рассчитывыаем значение y (выручку), которая соответствует выбранному значению x
    y_pred = vector_init[0] + vector_init[1]*x_us[ind]
#     вычисляем ошибку расчетной выручки относительно представленной в выборке
    error = y_pred - y_us[ind]
#     определяем первую координату градиента ab
    grad_a = error
#     определяем вторую координату ab
    grad_b = x_us[ind]*error
#     вычисляем новый вектор коэффициентов
    vector_new = [vector_init[0]-l*grad_a, vector_init[1]-l*grad_b]
    return vector_new


# определим функцию стох.град.спуска
def stoch_grad_descent_usual(x_us, y_us, l=0.1, steps = 800):
#     для самого начала работы функции зададим начальные значения коэффициентов
    vector_init = [float(random.uniform(-0.5, 0.5)), float(random.uniform(-0.5, 0.5))]
    errors = []
#     запустим цикл спуска
# цикл расчитан на определенное количество шагов (steps)
    for i in range(steps):
        ind = random.choice(range(len(x_us)))
        new_vector = stoch_grad_step_usual(vector_init, x_us, ind, y_us, l)
        vector_init = new_vector
        errors.append(errors_sq_Kramer_method(vector_init,x_us,y_us))
    return (vector_init),(errors)


# запишем массив значений
list_parametres_stoch_gradient_descence = stoch_grad_descent_usual(x_us, y_us, l=0.1, steps = 800)

print ' 33[1m' + ' 33[4m' + "Значения коэффициентов a и b:" + ' 33[0m'
print 'a =', round(list_parametres_stoch_gradient_descence[0][0],3)
print 'b =', round(list_parametres_stoch_gradient_descence[0][1],3)
print


print ' 33[1m' + ' 33[4m' + "Сумма квадратов отклонений:" + ' 33[0m'
print round(list_parametres_stoch_gradient_descence[1][-1],3)
print

print ' 33[1m' + ' 33[4m' + "Количество итераций в стохастическом градиентном спуске:" + ' 33[0m'
print len(list_parametres_stoch_gradient_descence[1])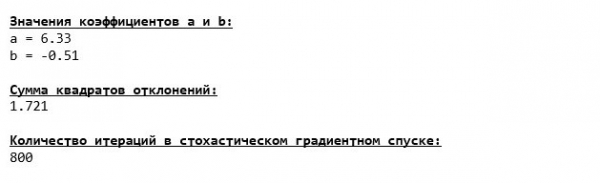
Lad os kigge nøje på koefficienterne og fange os selv i spørgsmålet 'Hvordan kan dette være?'. Vi fik andre værdier for koefficienterne  og
 Har den stochastiske gradientnedstigning muligvis fundet mere optimale parametre til ligningen? Desværre nej. Det er nok at se på summen af kvadraterne af afvigelserne og se, at med de nye værdier for koefficienterne er fejlen større. Lad os ikke miste modet. Lad os lave en graf for ændringen i fejlen.
Kode til grafen for summen af kvadraterne af afvigelserne ved stochastisk gradientnedstigning
print 'Graf nr. 5 "Summen af kvadraterne af afvigelserne trin for trin"'
plt.plot(range(len(list_parametres_stoch_gradient_descence[1])), list_parametres_stoch_gradient_descence[1], color='red', lw=2)
plt.xlabel('Trin (Iteration)', size=16)
plt.ylabel('Sum af kvadraterne af afvigelser', size=16)
plt.show()
Graf nr. 5 «Summen af kvadraterne af afvigelser ved stochastisk gradientnedstigning»
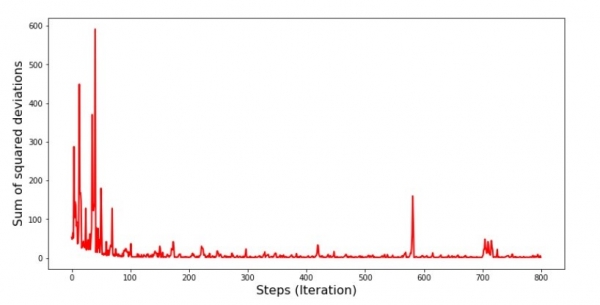
Når man ser på grafen, falder alt på plads, og nu vil vi rette op på det.
Så hvad skete der? Det skete følgende. Når vi vælger en måned tilfældigt, stræber vores algoritme netop for den valgte måned efter at minimere fejlen i beregningen af indtægterne. Derefter vælger vi en anden måned og gentager beregningen, men vi minimerer fejlen for den anden valgte måned. Og lad os huske, at de første to måneder afviger betydeligt fra linjen for den enkle lineære regression. Det betyder, at når nogen af disse to måneder vælges, så øger vores algoritme drastisk fejlen over hele udvalget, når vi mindsker fejlen for hver af dem. Hvad skal man så gøre? Svaret er enkelt: man skal reducere skridtdimensionen. For ved at mindske skridtdimensionen vil fejlen også stoppe med at
Kode til at køre SGD med en mindre skridtdimension
# запустим функцию, уменьшив шаг в 100 раз и увеличив количество шагов соответсвующе
list_parametres_stoch_gradient_descence = stoch_grad_descent_usual(x_us, y_us, l=0.001, steps = 80000)

print ' 33[1m' + ' 33[4m' + "Значения коэффициентов a и b:" + ' 33[0m'
print 'a =', round(list_parametres_stoch_gradient_descence[0][0],3)
print 'b =', round(list_parametres_stoch_gradient_descence[0][1],3)
print


print ' 33[1m' + ' 33[4m' + "Сумма квадратов отклонений:" + ' 33[0m'
print round(list_parametres_stoch_gradient_descence[1][-1],3)
print


print ' 33[1m' + ' 33[4m' + "Количество итераций в стохастическом градиентном спуске:" + ' 33[0m'
print len(list_parametres_stoch_gradient_descence[1])

print 'График №6 "Сумма квадратов отклонений по-шагово"'
plt.plot(range(len(list_parametres_stoch_gradient_descence[1])), list_parametres_stoch_gradient_descence[1], color='red', lw=2)
plt.xlabel('Steps (Iteration)', size=16)
plt.ylabel('Sum of squared deviations', size=16)
plt.show()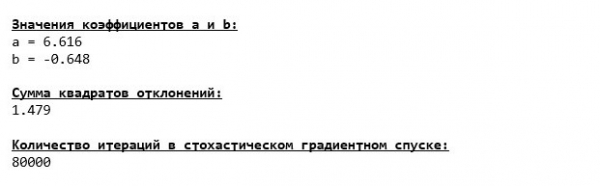
Graf nr. 6 «Summen af kvadraterne af afvigelserne ved stochastisk gradientnedstigning (80.000 skridt)»
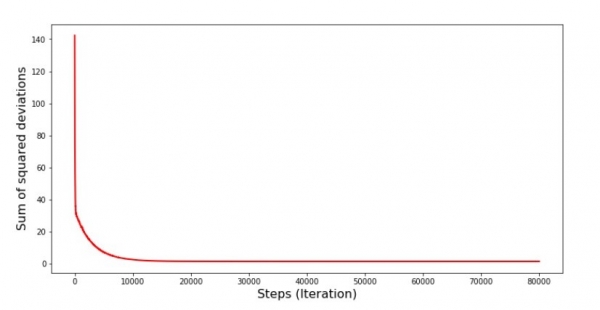
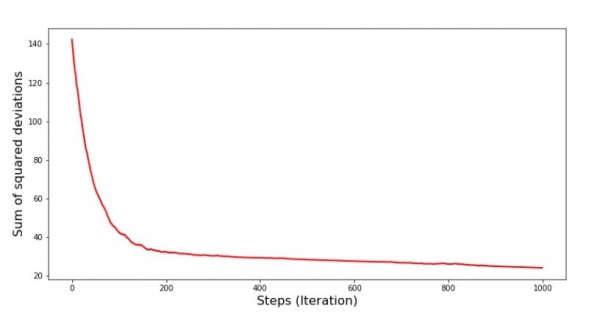
Værdierne for koefficienterne er forbedret, men stadig ikke perfekte. Teoretisk set kan dette rettes på følgende måde. Vi vælger for eksempel de sidste 1000 iterationer med de koefficientværdier, der har medført den mindste fejl. Men vi skal også registrere selve værdierne for koefficienterne. Vi vil ikke gøre dette, men i stedet fokusere på grafen. Den ser glat ud, og fejlen ser ud til at falde jævnt. Faktisk er det ikke sådan. Lad os se på de første 1000 iterationer og sammenligne dem med de sidste.
Kode til grafen fra SGD (de første 1000 skridt)
print 'Grafik nr. 7 "Summen af kvadraterne af afvigelser trin for trin. De første 1000 iterationer"'
plt.plot(range(len(list_parametres_stoch_gradient_descence[1][:1000])),
         list_parametres_stoch_gradient_descence[1][:1000], color='red', lw=2)
plt.xlabel('Trin (Iteration)', size=16)
plt.ylabel('Summen af kvadraterne af afvigelser', size=16)
plt.show()

print 'Grafik nr. 7 "Summen af kvadraterne af afvigelser trin for trin. De sidste 1000 iterationer"'
plt.plot(range(len(list_parametres_stoch_gradient_descence[1][-1000:])),
         list_parametres_stoch_gradient_descence[1][-1000:], color='red', lw=2)
plt.xlabel('Trin (Iteration)', size=16)
plt.ylabel('Summen af kvadraterne af afvigelser', size=16)
plt.show()
Grafik nr. 7 «Summen af kvadraterne af afvigelser fra SGD (de første 1000 trin)»
Grafik nr. 8 «Summen af kvadraterne af afvigelser fra SGD (de sidste 1000 trin)»
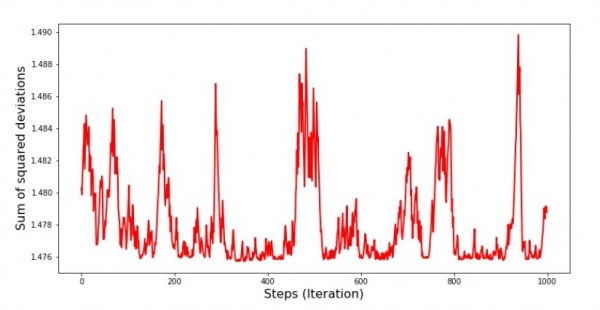
I starten af nedstigningen ser vi en ret jævn og stejl reduktion af fejlen. Ved de sidste iterationer ser vi, at fejlen svinger omkring værdien 1,475 og i nogle øjeblikke er lig med denne optimale værdi, men alligevel går den op igen... Jeg gentager, man kan registrere værdierne af koefficienterne  og
 , og derefter vælge dem, hvor fejlen er minimal. Men vi står over for et mere alvorligt problem: vi måtte tage 80.000 skridt (se koden) for at få værdier tæt på de optimale. Og det modsiger allerede idéen om at spare beregningstid ved stokastisk gradientnedstigning i forhold til gradientnedstigning. Hvad kan rettes og forbedres? Det er ikke svært at bemærke, at vi i de første iterationer går sikkert nedad, og derfor bør vi holde et stort skridt i de første iterationer og efterhånden reducere skridtet. Vi vil ikke gøre det i denne artikel — den er allerede lang nok. De interesserede kan selv tænke over, hvordan det kan gøres, det er ikke svært 🙂
Lad os nu udføre stokastisk gradientnedstigning ved hjælp af biblioteket NumPy (og vi vil ikke støde på de problemer, vi fandt tidligere)
Koden til stokastisk gradientnedstigning (NumPy)
# для начала напишем функцию градиентного шага
def stoch_grad_step_numpy(vector_init, X, ind, y, l):
    x = X[ind]
    y_pred = np.dot(x,vector_init)
    err = y_pred - y[ind]
    grad_a = err
    grad_b = x[1]*err
    return vector_init - l*np.array([grad_a, grad_b])

# определим функцию стохастического градиентного спуска
def stoch_grad_descent_numpy(X, y, l=0.1, steps = 800):
    vector_init = np.array([[np.random.randint(X.shape[0])], [np.random.randint(X.shape[0])]])
    errors = []
    for i in range(steps):
        ind = np.random.randint(X.shape[0])
        new_vector = stoch_grad_step_numpy(vector_init, X, ind, y, l)
        vector_init = new_vector
        errors.append(error_square_numpy(vector_init,X,y))
    return (vector_init), (errors)

# запишем массив значений
list_parametres_stoch_gradient_descence = stoch_grad_descent_numpy(x_np, y_np, l=0.001, steps = 80000)

print ' 33[1m' + ' 33[4m' + "Значения коэффициентов a и b:" + ' 33[0m'
print 'a =', round(list_parametres_stoch_gradient_descence[0][0],3)
print 'b =', round(list_parametres_stoch_gradient_descence[0][1],3)
print


print ' 33[1m' + ' 33[4m' + "Сумма квадратов отклонений:" + ' 33[0m'
print round(list_parametres_stoch_gradient_descence[1][-1],3)
print


print ' 33[1m' + ' 33[4m' + "Количество итераций в стохастическом градиентном спуске:" + ' 33[0m'
print len(list_parametres_stoch_gradient_descence[1])
print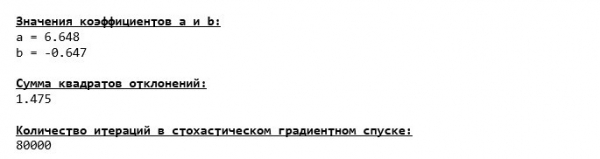
Værdierne kom ud næsten de samme som ved nedstigning uden brug af NumPy. Det er dog logisk.
Lad os finde ud af, hvor meget tid de stokastiske gradientnedstigninger tog os.
Koden til at bestemme beregningstiden for SGD (80.000 skridt)
print ' 33[1m' + ' 33[4m' +
"Tiden for udførelse af stochastisk gradientdescent uden brug af NumPy-biblioteket:"
+ ' 33[0m'
%timeit list_parametres_stoch_gradient_descence = stoch_grad_descent_usual(x_us, y_us, l=0.001, steps = 80000)
print '***************************************'
print

print ' 33[1m' + ' 33[4m' +
"Tiden for udførelse af stochastisk gradientdescent med brug af NumPy-biblioteket:"
+ ' 33[0m'
%timeit list_parametres_stoch_gradient_descence = stoch_grad_descent_numpy(x_np, y_np, l=0.001, steps = 80000)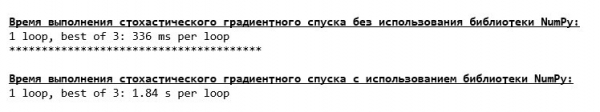
Jo længere ind i skoven, desto mørkere bliver skyerne: igen viser den "håndlavede" formel det bedste resultat. Alt dette får en til at overveje, at der må eksistere endnu mere raffinerede måder at bruge biblioteket på. NumPy, der virkelig accelererer beregningerne. I denne artikel får vi ikke kendskab til dem. Det er noget at tænke over i fritiden :)
To summarize
Før vi opsummerer, vil jeg gerne svare på det spørgsmål, som vores kære læser sandsynligvis har: Hvorfor overhovedet gennemgå disse "liderligheder" med bækkene, hvorfor skal vi gå op og ned ad bjerge (primært ned) for at finde den ønskede lavning, når vi har en så kraftfuld og simpel enhed i form af en analytisk løsning, der øjeblikkeligt teleporterer os til det ønskede sted?
Svaret på dette spørgsmål ligger lige for. I øjeblikket har vi behandlet et meget simpelt eksempel, hvor det sande svar  afhænger af én variabel
 . I livet møder man sjældent en sådan situation, så lad os forestille os, at vi har 2, 30, 50 eller flere variabler. Tilføj dertil tusinder, ja måske endda titusinder af værdier for hver variabel. I dette tilfælde kan den analytiske løsning ikke holde til prøvelsen og fejle. Omvendt vil gradient descent og dets varianter langsomt, men sikkert bringe os tættere på målet — minimum af funktionen. Og hvad angår hastigheden, skal du ikke bekymre dig — vi vil helt sikkert endnu engang gennemgå metoder, der gør det muligt at angive og justere skridtlængden (dvs. hastigheden).
Og nu selve korte resumé.
For det første håber jeg, at materialet præsenteret i artiklen hjælper begyndende "data scientists" med at forstå, hvordan man løser ligninger for simpel (og ikke kun) lineær regression.
For det andet har vi set på flere måder at løse ligningen på. Nu kan vi, afhængigt af situationen, vælge den, der passer bedst til at løse den stillede opgave.
For the third point, we saw the power of additional settings, specifically the step length of gradient descent. This parameter should not be overlooked. As mentioned above, in order to reduce computation costs, the step length should be adjusted during descent.
Fourthly, in our case, 'home-made' functions demonstrated better computation times. This is likely due to not fully utilizing the capabilities of the library. NumPyNevertheless, the conclusion seems quite clear. On one hand, it is sometimes worth questioning established opinions, and on the other hand, not everything needs to be complicated—sometimes a simpler solution is more effective. Since our goal was to analyze three approaches to solving the equation of simple linear regression, the use of 'home-made' functions was sufficient for us.
Literature (or something like that)
1. Linear Regression
2. Least Squares Method
3. Derivative
4. Gradient
5. Gradient Descent
6. NumPy Library
Kilde: habr.com
