

Pas på operationer, buffers der bringer ...
Lad os se på en lille forespørgsel, og gennemgå nogle universelle tilgange til optimering af forespørgsler i PostgreSQL. Om man vil bruge dem eller ej – det er op til dig, men det er værd at vide.
I fremtidige versioner af PG kan situationen ændre sig med 'intelligensen' i planlægningsværktøjerne, men for 9.4/9.6 ser det omtrent ens ud som eksempler her.
Jeg vil tage en helt reel forespørgsel:
SELECT
  TRUE
FROM
  "Dokument" d
INNER JOIN
  "DokumentUdvidelse" doc_ex
    USING("@Dokument")
INNER JOIN
  "DokumentType" t_doc ON
    t_doc."@DokumentType" = d."DokumentType"
WHERE
  (d."Lid3" = 19091 or d."Medarbejder" = 19091) AND
  d."$Udkast" IS NULL AND
  d."Slettet" IS NOT TRUE AND
  doc_ex."Status"[1] IS TRUE AND
  t_doc."DokumentType" = 'ArbejdPlan'
LIMIT 1;
om tabel- og feltnavneMan kan have forskellige holdninger til "russiske" navne på felter og tabeller, men det er en smagssag. Da ikke har udenlandske udviklere, og PostgreSQL tillader os at give navne selv i hieroglyffer, så længe de er indkapslet i anførselstegn, så foretrækker vi at navngive objekter klart og tydeligt for at undgå misforståelser.
Lad os se på den resulterende plan:
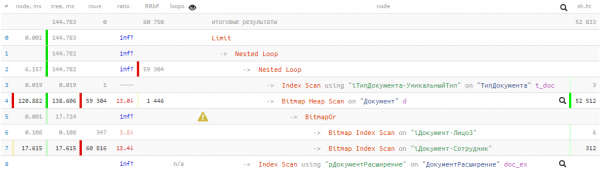
144ms og næsten 53K buffers — det vil sige over 400MB data! Og vi er heldige, hvis alle de data er i cachen, når vores forespørgsel kommer, ellers bliver den meget længere ved indlæsning fra disken.
Algoritmen er vigtigst!
For at optimere enhver forespørgsel, skal man først forstå, hvad den egentlig skal gøre.
Lad os lade udviklingen af selve databasestrukturen være udenfor denne artikel, og aftale, at vi kan 'billigt' omskrive forespørgslen og/eller implementere nogle nødvendige indekser.
Så forespørgslen:
— kontrollerer eksistensen af en hvilken som helst dokument
— i den ønskede tilstand og af en bestemt type
— hvor forfatteren eller udføreren er den medarbejder, vi har brug for
JOIN + LIMIT 1
Ofte er det lettere for udvikleren at skrive en forespørgsel, hvor der først udføres en sammenkobling af mange tabeller, hvorefter der kun er én eneste post tilbage. Men lettere for udvikleren – betyder ikke mere effektivt for databasen.
I vores tilfælde var der kun 3 tabeller – men hvilken effekt ...
Lad os i første omgang slippe for sammenkoblingen med tabellen "DokumentType" og samtidigt fortælle databasen, at vi har en unik type post (det ved vi, men planlæggeren ved det ikke endnu):
WITH T AS (
  SELECT
    "@DokumentType"
  FROM
    "DokumentType"
  WHERE
    "DokumentType" = 'ArbejdPlan'
  LIMIT 1
)
...
WHERE
  d."DokumentType" = (TABLE T)
...
Ja, hvis tabellen/CTE består af et enkelt felt fra en enkelt post, kan man i PG endda skrive sådan, i stedet for
d."DokumentType" = (SELECT "@DokumentType" FROM T LIMIT 1)«Dovne» beregninger i PostgreSQL-forespørgsler
BitmapOr vs UNION
I nogle tilfælde kan Bitmap Heap Scan blive meget kostbart for os – for eksempel i vores situation, hvor et betydeligt antal poster passerer det krævede vilkår. Vi fik dette på grund af OR-betingelsen, der er blevet til BitmapOr-operation i planen.
Lad os vende tilbage til den oprindelige opgave – vi skal finde en post, der svarer til hvilket som helst af betingelserne – det vil sige, der er ingen grund til at søge blandt alle 59K poster efter begge betingelser. Der er en metode til at håndtere én betingelse, og overgå til den anden kun, når den første ikke har givet noget.Vi kan bruge følgende konstruktion:
(
  SELECT
    ...
  LIMIT 1
)
UNION ALL
(
  SELECT
    ...
  LIMIT 1
)
LIMIT 1
Den "ydre" LIMIT 1 sikrer, at søgningen stopper, når den første post er fundet. Og hvis den findes i det første blok, vil den anden ikke blive udført (aldrig udført i planen).
„Skjuler under CASE“ komplekse betingelser
I den oprindelige forespørgsel er der et ekstremt besværligt punkt – kontrollen af tilstanden via den relaterede tabel „DokumentUdvidelse“. Uanset sandheden af de øvrige betingelser i udtrykket (for eksempel, d."Slettet" IS NOT TRUE), udføres denne forbindelse altid og „koster ressourcer“. Hvor meget der vil blive brugt – afhænger af størrelsen på denne tabel.
Men vi kan modificere forespørgslen, så søgningen efter den relaterede post kun finder sted, når det virkelig er nødvendigt:
SELECT
  ...
FROM
  "Dokument" d
WHERE
  ...
/*index cond*/ AND
  CASE
    WHEN "$Udkast" IS NULL AND "Slettet" IS NOT TRUE THEN (
      SELECT
        "Tilstand"[1] IS TRUE
      FROM
        "DokumentUdvidelse"
      WHERE
        "@Dokument" = d."@Dokument"
    )
  END
Da vi ikke har brug for noget felt fra den relaterede tabel , kan vi omdanne JOIN til en betingelse via en underforespørgsel.Vi lader de indeksérbare felter være "uden for skiven" i CASE, de enkle betingelser inden for posten placeres i WHEN-blokken – og nu udføres den "tunge" forespørgsel kun, når vi går ind i THEN.
Mit efternavn er „I alt“
Vi samler den resulterende forespørgsel med alle de ovenfor beskrevne mekanismer:
Vi indsamler den resulterende forespørgsel med alle de ovenfor beskrevne mekanismer:
MED T SOM (
  VELG
    "@DokumentType"
  FRA
    "DokumentType"
  HVOR
    "DokumentType" = 'Arbejdsplan'
)
  (
    VELG
      SAND
    FRA
      "Dokument" d
    HVOR
      ("Person3", "DokumentType") = (19091, (TABEL T)) OG
      SAG
        HVIS "$Udkast" ER NULL OG "Slettet" ER IKKE SAND SÅ (
          VELG
            "Status"[1] ER SAND
          FRA
            "DokumentUdvidelse"
          HVOR
            "@Dokument" = d."@Dokument"
        )
      BEGGE
    LIMIT 1
  )
UNION ALL
  (
    VELG
      SAND
    FRA
      "Dokument" d
    HVOR
      ("DokumentType", "Medarbejder") = ((TABEL T), 19091) OG
      SAG
        HVIS "$Udkast" ER NULL OG "Slettet" ER IKKE SAND SÅ (
          VELG
            "Status"[1] ER SAND
          FRA
            "DokumentUdvidelse"
          HVOR
            "@Dokument" = d."@Dokument"
        )
      BEGGE
    LIMIT 1
  )
LIMIT 1;
Tilpasser [til] indekserne
Et trænede øje bemærkede, at de indekserede betingelser i UNION-underblokke varierer en smule – det er fordi, vi allerede har passende indekser på tabellen. Og hvis der ikke havde været nogen – så ville det have været værd at oprette: Dokument(Person3, DokumentType) og Dokument(DokumentType, Medarbejder).
om rækkefølgen af felterne i ROW-betingelserSet fra planlæggerens perspektiv, kan man selvfølgelig også skrive (A, B) = (constA, constB), og (B, A) = (constB, constA). Men ved skrivning i rækkefølgen af felterne i indekset, er det simpelthen lettere at feilsøge en sådan forespørgsel.
Hvad er planen?
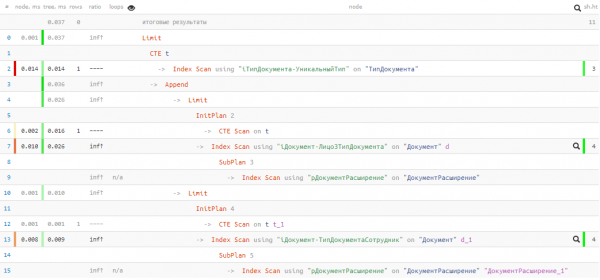
Desværre havde vi ikke held, og i den første UNION-blok blev der ikke fundet noget, så den anden gik alligevel videre med udførelsen. Men selv da – kun 0,037ms og 11 buffere!
Vi har accellereret forespørgslen og reduceret "opbremsningen" af data i hukommelsen med flere tusinde gange, ved at anvende ret enkle metoder – et godt resultat ved lidt copy-paste. 🙂
Kilde: habr.com
