

Denne artikel er den anden i rækken om hurtig datakomprimering. I den første artikel blev der beskrevet en kompressor, der arbejder med en hastighed på 10GB/sek. pr. processorkerne (mindste kompression, RTT-Min).
Denne kompressor er allerede implementeret i udstyret til retfærdighedens dublikanter til hurtig komprimering af dumpfiler fra datalagringsmedier og til at forbedre kryptografiens modstandsdygtighed. Den kan også bruges til at komprimere billeder af virtuelle maskiner og swap-filer fra den primære hukommelse, når de gemmes på hurtige SSD-lagringsenheder.
I den første artikel blev udviklingen af en komprimeringsalgoritme også annonceret til komprimering af backup af HDD- og SSD-lagringsenheder (gennemsnitlig kompression, RTT-Mid) med betydeligt forbedrede datapressionsparametre. På nuværende tidspunkt er denne kompressor fuldt færdig, og denne artikel handler netop om den.
Kompressoren, der implementerer RTT-Mid-algoritmen, sikrer en kompressionsgrad, der er sammenlignelig med standardarkiveringsprogrammer som WinRar og 7-Zip, der arbejder i hurtig tilstand. Derudover er dens arbejdshastighed mindst en orden højere.
Hastigheden for pakning/udpakning af data er en kritisk parameter, der bestemmer anvendelsesområdet for kompressionsteknologier. Det ville næppe falde nogen ind at komprimere en terabyte data med hastigheder på 10-15 megabyte i sekundet (netop sådan er hastigheden for arkiveringsprogrammer i standardkompressionsmode), da det ville tage næsten tyve timer, hvis processoren var fuldt belastet…
På den anden side kan den samme terabyte kopieres med hastigheder på omkring 2-3 gigabyte i sekundet på ti minutter.
Derfor er komprimering af store datamængder relevant, hvis den udføres med en hastighed, der ikke er lavere end hastigheden for reel input/output. For moderne systemer er det ikke mindre end 100 megabyte i sekundet.
Sådanne hastigheder kan moderne kompressorer kun give i 'hurtig' tilstand. Og netop i denne relevante tilstand vil vi sammenligne algoritmen RTT-Mid med traditionelle kompressorer.
Sammenlignende test af den nye komprimeringsalgoritme
Kompressoren RTT-Mid arbejdede som en del af et testprogram. I en rigtig 'arbejdende' applikation arbejder den betydeligt hurtigere, hvor der intelligens anvendes for multitrådning, og der anvendes en 'normal' compiler, ikke C#.
Da de komprimeringsværktøjer, der anvendes i den sammenlignende test, er bygget på forskellige principper, og da forskellige datatyper komprimeres forskelligt, blev der for objektivitet anvendt en metode til måling af "gennemsnitstemperaturen på hospitalet"...
Der blev oprettet en fil med sektordump af det logiske drev med operativsystemet Windows 10, som er den mest naturlige blanding af forskellige datastrukturer, der findes på enhver computer. Komprimering af denne fil vil muliggøre en sammenligning af hastighed og kompressionsgrad af den nye algoritme med de mest avancerede kompressorer, der anvendes i moderne arkiveringsprogrammer.
Her er dumpfilen:
Dumpfilen blev komprimeret af kompressorerne RTT-Mid, 7-zip og WinRar. Kompressoren WinRar og 7-zip blev sat til maksimal hastighed.
Kompressoren arbejder 7-zip:
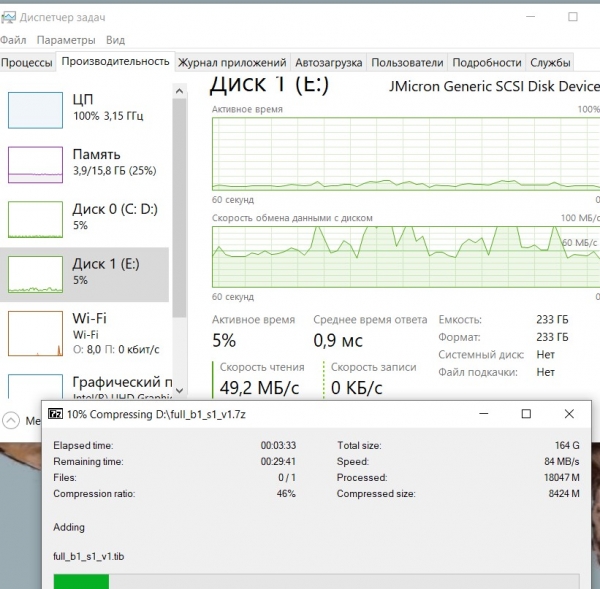
Den belaster procesoren med 100%, mens den gennemsnitlige læsehastighed af den originale dumpfil er omkring 60 Megabyte/sek.
Kompressoren arbejder WinRar:
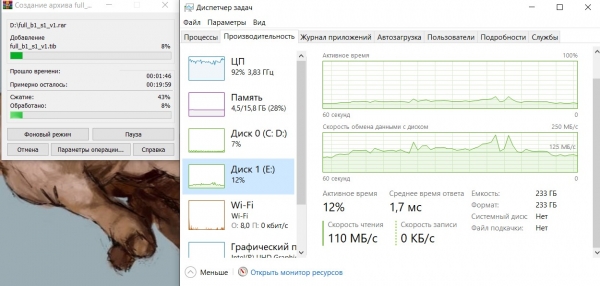
Situationen er den samme, belastningen på procesoren er næsten 100%, den gennemsnitlige læsehastighed for dumpfilen er omkring 125 Megabyte/sek.
Som i det tidligere tilfælde er hastigheden for arkiveringsprogrammet begrænset af processeffektens muligheder.
Nu kører testprogrammet for kompressoren RTT-Mid:
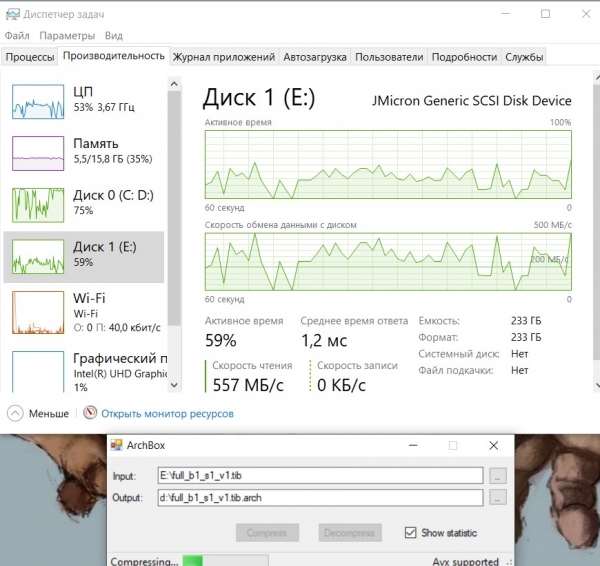
Screenshots viser, at procesoren er belastet med 50% og er inaktiv resten af tiden, fordi der ikke er noget sted at udlede de komprimerede data. Dataudtagningsdreven (Disk 0) er næsten helt fyldt. Læsehastigheden for data (Disk 1) svinger meget, men i gennemsnit over 200 Megabyte/sek.
Hastigheden for kompressoren er i dette tilfælde begrænset af muligheden for at skrive de komprimerede data til Disk 0.
Nu er graden af komprimering for de resulterende arkiver:
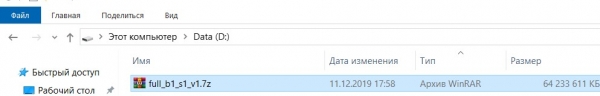
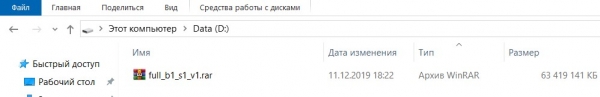
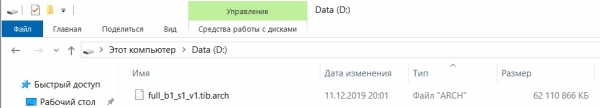
Det er klart, at kompressoren RTT-Mid klarede sig bedst i komprimeringen, arkivet oprettet af den er 1,3 Gigabyte mindre end WinRar-arkivet og 2,1 Gigabyte mindre end 7z-arkivet.
Tiden brugt på at oprette arkivet:
- 7-zip – 26 minutter 10 sekunder;
- WinRar – 17 minutter 40 sekunder;
- RTT-Mid – 7 minutter 30 sekunder.
Således var selv testprogrammet, som ikke er optimeret, i stand til at oprette arkivet mere end to og en halv gang hurtigere ved at bruge RTT-Mid-algoritmen, samtidig med at arkivet blev betydeligt mindre end konkurrenternes...
De, der ikke tror på screenshots, kan selv kontrollere deres nøjagtighed. Testprogrammet er tilgængeligt på , download og tjek.
Men kun på processorer med AVX-2 understøttelse; uden understøttelse af disse instruktioner fungerer kompressoren ikke, og test ikke algoritmen på gamle AMD-processorer, da de er langsomme til at udføre AVX-kommandoer...
Den anvendte komprimeringsmetode
Algoritmen anvender en metode til indeksering af gentagne tekstfragmenter på byte-niveau. Denne komprimeringsmetode er kendt i lang tid, men blev ikke brugt, da søgningen efter match var meget ressourcetung og tog meget længere tid end at opbygge et ordforråd. Så algoritmen RTT-Mid er et klassisk eksempel på bevægelsen "tilbage til fremtiden"...
I RTT-kompressoren anvendes en unik hurtig matcher-søger, som netop har gjort det muligt at fremskynde komprimeringsprocessen. Scanneren er speciallavet; "det er min skønhed..." "den koster ikke så lidt, da den er helt håndlavet" (skrevet i assembler).
Matcher-søgeren er bygget efter et to-niveau sandsynlighedsschema; først scannes der for tilstedeværelsen af et "tegn" for match, og først efter identifikation af "tegnet" i dette område startes proceduren til at opdage det faktiske match.
Søgevinduet for match er uforudsigeligt i størrelse, afhængig af graden af entropi i det behandlede datablok. For helt tilfældige (ukomprimerbare) data har det en størrelse i megabytes, for data med gentagelser er størrelsen altid over en megabyte.
Men mange moderne dataformater er ukomprimerbare, og det er spild af ressourcer at køre en ressourcetung scanner på dem, derfor anvendes der to driftsmetoder i scanneren. Først søges der efter segmenter af den oprindelige tekst med mulige gentagelser, og denne operation udføres også ved en sandsynlighedsmetode og kan udføres meget hurtigt (ved en hastighed på 4-6 gigabyte/sek.). Derefter behandles segmenterne med mulige matches af hovedscanneren.
Indeks-komprimering er ikke særlig effektiv; gentagne fragmenter skal erstattes af indekser, og indeksarrayet reducerer væsentligt kompressionsforholdet.
For increased compression, not only complete matches of byte strings are indexed but also partial matches, where there are both matching and non-matching bytes in the string. For this, the index format includes a match mask field that indicates the matched bytes of two blocks. For even greater compression, indexing overlays several partially matching blocks onto the current block.
All this allowed the RTT-Mid compressor to achieve a compression ratio comparable to compressors based on the dictionary method, but operating much faster.
The speed of the new compression algorithm
If the compressor works with exclusive use of cache memory (4 Megabytes required per thread), the operating speed fluctuates in the range of 700-2000 Megabytes/sec per CPU core, depending on the type of compressed data, and is minimally affected by the processor's clock frequency.
In a multithreaded implementation of the compressor, effective scalability is determined by the amount of third-level cache memory. For example, with 9 Megabytes of cache memory on board, there is no point in running more than two compression threads, as the speed will not increase. However, with 20 Megabytes of cache, it is possible to run up to five compression threads.
Another significant parameter determining the compressor's speed is the latency of the RAM. The algorithm uses random access to RAM, some of which does not hit the cache memory (about 10%), causing it to stall while waiting for data from RAM, which reduces the operating speed.
The operation of the data input/output system also significantly impacts the speed of the compressor. Requests from the I/O block cache memory block data requests from the CPU, which also slows down the compression speed. This problem is significant for laptops and desktops, while servere it is less critical due to a more advanced access control unit for the system bus and multi-channel RAM.
I hele teksten i artiklen tales der om kompression, dekodning forbliver uden for denne artikel, da der «alt er i orden». Dekodning udføres betydeligt hurtigere og begrænses af ind-/uddatahastigheder. Et fysisk kerne i én tråd kan nemt opnå hastigheder for udpakning på niveau med 3-4 Gigabyte/sek.
Dette skyldes fraværet af operationen for at finde matchende data under udpakning, hvilket «spiser» de primære ressourcer fra processoren og cache-hukommelsen under kompression.
Pålidelighed ved opbevaring af komprimerede data
Som navnet på hele klassen af softwareværktøjer, der bruger datakompression (arkiver), antyder, er de beregnet til langtidsopbevaring af information, ikke i år, men i århundreder og årtusinder…
Over tid mister lagermedierne en del af dataene, her er et eksempel:
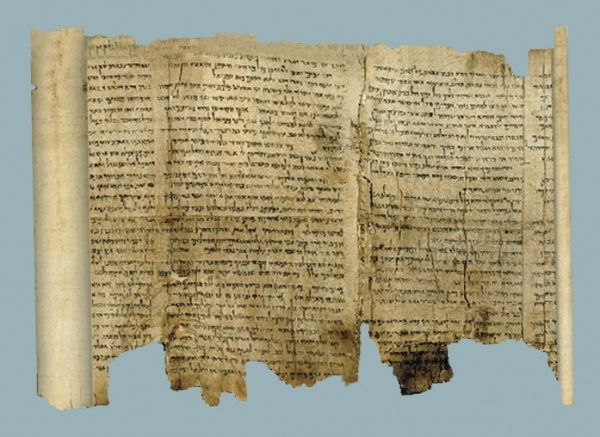
Dette «analoge» datalager er tusinde år gammelt, nogle fragmenter er gået tabt, men generelt er informationen «læselig»…
Ingen af de ansvarlige producenter af moderne digitale lagringssystemer og de digitale medier, der hører til, giver garantier for fuld datalagring i mere end 75 år.
Og det er et problem, men et udsat problem, som vore efterkommere vil have ansvar for at løse…
Digitale datalagringssystemer kan miste data ikke kun efter 75 år; fejl i data kan opstå når som helst, selv under deres optagelse. Disse forvridninger forsøger man at minimere ved brug af redundans og ved at rette dem med fejlkorrigerende systemer. Redundans og fejlkorrigerende systemer kan ikke altid genskabe tabt information, og hvis de gør, er der ingen garanti for, at genoprettelsesoperationen er udført korrekt.
Og det er også et stort problem, men ikke udsat, snarere aktuelt.
Moderne kompressorer, der bruges til arkivering af digitale data, er baseret på forskellige modifikationer af ordmetoden, og for sådanne arkiver vil tabet af et informationsfragment være en katastrofal begivenhed; der findes endda en veletableret term for en sådan situation — en «ødelagt» arkiv…
Den lave pålidelighed af informationlagring i arkiver med ordbogs kompression er relateret til strukturen af de komprimerede data. Informationen i et sådant arkiv indeholder ikke den oprindelige tekst; der opbevares indgangsnumre i ordbogen, som dynamisk modificeres af den aktuelle komprimerede tekst. Ved tab eller beskadigelse af et fragment af arkivet, kan alle efterfølgende poster i arkivet ikke identificeres hverken efter indhold eller længde af posten i ordbogen, da det ikke er klart, hvad ordbogsindgangsnummeret henviser til.
Det er umuligt at gendanne information fra et sådant "ødelagt" arkiv.
RTT-algoritmen er baseret på en mere pålidelig metode til opbevaring af komprimerede data. Den anvender en indeksmetode til at holde styr på gentagne fragmenter. Denne tilgang til kompression minimerer konsekvenserne af informationstab på mediet og kan i mange tilfælde automatisk korrigere de forvrængninger, der opstår under opbevaring af information.
Dette skyldes, at arkivfilen i tilfælde af indekskompression indeholder to felter:
- feltet for den oprindelige tekst med deleted gentagne sektioner;
- indeksfeltet.
Indeksfeltet, som er kritisk for gendannelse af information, er ikke stort i størrelse, og det kan duplikeres for at sikre datalagringens pålidelighed. Derfor, selv hvis et fragment af den oprindelige tekst eller indeksarrayet går tabt, vil al anden information blive gendannet uden problemer, ligesom på billedet med et "analogt" informationsmedie.
Ulemper ved algoritmen
Der er ingen fordele uden ulemper. Indeksmetoden for kompression komprimerer ikke gentagne sekvenser af lille længde. Dette skyldes begrænsningerne i indeksmetoden. Indekser har en størrelse på mindst 3 byte og kan være op til 12 byte. Hvis der findes en gentagelse med en størrelse, der er mindre end den beskrivende indeks, vil den ikke blive taget i betragtning, uanset hvor ofte sådanne gentagelser findes i den komprimerede fil.
Den traditionelle, ordsprogsbaserede komprimeringsmetode komprimerer effektivt gentagne korte sekvenser og opnår derfor en højere kompressionsfaktor end indeksbaseret komprimering. Dette opnås dog på bekostning af en høj belastning på CPU'en, da den ordsprogsbaserede metode må sænke databehandlingshastigheden til 10-20 megabyte per sekund på faktiske beregningssystemer ved maksimal CPU-belastning for at kunne komprimere data mere effektivt end den indeksbaserede metode.
Sådanne lave hastigheder er uacceptable for moderne lagringssystemer og repræsenterer mere akademisk interesse end praktisk anvendelse.
Kompressionsgraden af information vil blive væsentligt forbedret i den næste version af RTT-algoritmen (RTT-Max), som allerede er under udvikling.
Så som altid, fortsættelse følger…
Kilde: habr.com
