

Hej, habr.
Hvis nogen udnytter systemet og har stødt på problemer med lagringsydelsen (IO, diskplads der forbruges), så skal chancen for at have kigget på ClickHouse som en erstatning nærme sig én. Denne erklæring forudsætter, at en tredjepartsimplementering allerede bruges som metric daemon, for eksempel eller .
ClickHouse løser de beskrevne problemer godt. For eksempel, efter at have overført 2TiB data fra whisper, passerede de ind i 300GiB. Jeg vil ikke gå i detaljer med sammenligningen, der er masser af artikler om dette. Desuden var det ikke helt perfekt med vores ClickHouse-lager for nylig.
Problemer med pladsforbrug
Ved første øjekast skulle det hele fungere godt. I henhold til , opretter vi en konfiguration for metrics lagringsskema (herefter retention), og derefter opretter vi en tabel i henhold til anbefalingen fra den valgte backend til graphite-web: + eller , afhængigt af hvilken stak der bruges. Og... en tidsbombe aktiveres.
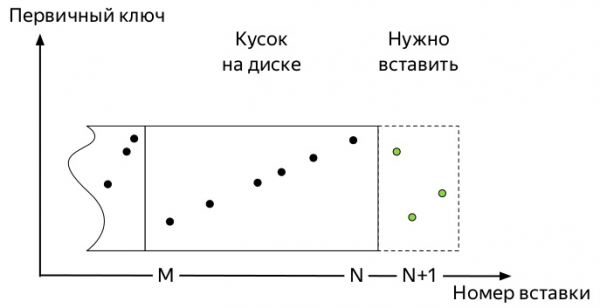
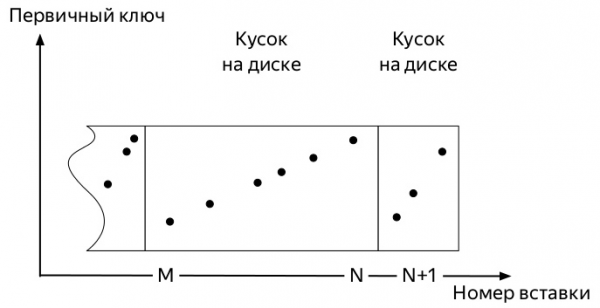
For at forstå hvilken, er det nødvendigt at vide, hvordan indsættelser fungerer og den videre livscyklus for data i *MergeTree*-familien tabellerne.MergeTree ClickHouse (diagrammer taget fra Aleksej Zatelepin):
- Et
datafalderi vores tilfælde, det kom ind som metrics.

- Hver sådan blok sorteres efter nøgle
ORDER BY, som angivet ved oprettelse af tabellen. - Efter sortering
,(parten del
- ) af dataene bliver skrevet til disk.
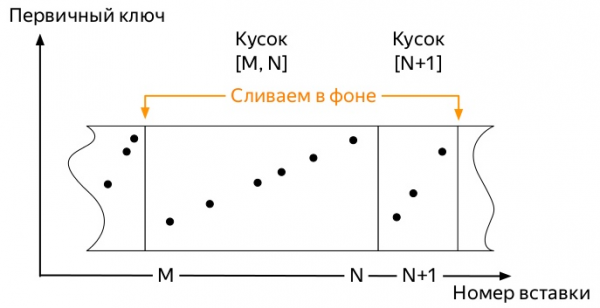
Serveren holder øje i baggrunden for at sikre, at der ikke er for mange sådanne dele, og starter baggrunds-(sammensluttesammensmeltninger
- , som så bliver mergen).
Serveren stopper med at starte mergen automatisk, når dataene stopper med at komme ind aktivt i(partition), men det er muligt at starte processen manuelt med kommandoenOPTIMIZE. - Hvis der kun er én del tilbage i partitionen, kan man ikke starte en mergen med den sædvanlige kommando, man skal bruge
OPTIMIZE ... FINAL
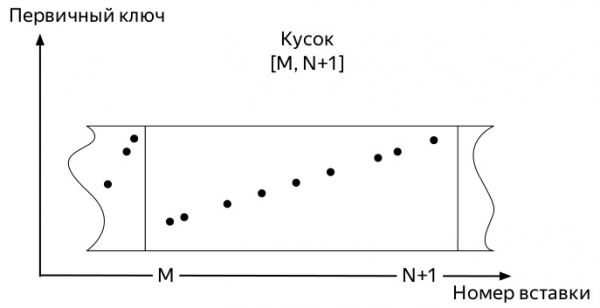
Så kommer de første metrics. Og de tager noget plads. Efterfølgende begivenheder kan variere en smule afhængigt af mange faktorer:
- Partitioneringsnøglen kan være meget lille (dag) eller meget stor (flere måneder).
- Retention-konfigurationen kan rumme flere betydelige tærskler for dataggregering inden for den aktive partition (hvor metrics bliver skrevet), eller det kan være tilfældet.
- Hvis der er meget data, vil de tidligste stykker, som kan være enorme på grund af baggrundssammenlægninger (ved at vælge en suboptimal partitioneringsnøgle), ikke blive sammenlagt med de friske små stykker.
Og det slutter altid på samme måde. Pladsen, der optages af metrikker i ClickHouse, vokser kun, hvis:
- man ikke anvender
OPTIMIZE ... FINALmanuelt eller - man ikke indsætter data i alle partitioner løbende for at før eller senere starte en baggrundssammenlægning
Den anden metode virker mest enkel at implementere, og derfor er den forkert og blev prøvet først.
Jeg skrev et ganske simpelt script i python, som sendte falske metrikker for hver dag de sidste 4 år og kørte hver time med cron.
Da hele arbejdet med ClickHouse DBMS er bygget på, at systemet før eller senere vil udføre alt baggrundsarbejde, men hvornår er ukendt, lykkedes det mig ikke at vente på, at gamle enorme stykker ville begynde at sammenlægge med nye små. Det blev klart, at jeg måtte finde en måde at automatisere tvungne optimeringer.
Oplysninger i systemtabellerne ClickHouse
Lad os se på strukturen af tabellen . Dette er udtømmende oplysninger om hver del af alle tabeller på ClickHouse-serveren. Inkluderer blandt andet følgende kolonner:
- database navn (
database); - tabelnavn (
table); - navn og ID for partition (
partition&partition_id); - hvornår stykket blev oprettet (
modification_time); - minimums- og maksimumsdatum i stykket (partitionering sker dagligt) (
min_date&max_date);
Der er også en tabel , med følgende interessante felter:
- database navn (
Tables.database); - tabelnavn (
Tables.table); - alder på metrikken, når den næste aggregation skal anvendes (
age);
Så:
- Vi har en tabel over stykker og en tabel over aggregationsregler.
- Vi kombinerer deres skæringspunkt og får alle tabellerne *GraphiteMergeTree.
- Vi leder efter alle partitioner, hvor:
- mere end ét stykke
- eller det er tid til at anvende den næste aggregationsregel, og
modification_timeældre end dette tidspunkt.
Implementering
Denne forespørgsel
VÆLG
    concat(p.database, '.', p.table) SOM tabel,
    p.partition_id SOM partition_id,
    p.partition SOM partition,
    -- Den "ældste" regel, der kan anvendes på
    -- partitionen, men ikke i fremtiden, se (*)
    max(g.age) SOM alder,
    -- Antal dele i partitionen
    countDistinct(p.name) SOM dele,
    -- Den ældste metrik i partitionen betragtes som 00:00:00 næste dag
    toDateTime(max(p.max_date + 1)) SOM max_tid,
    -- Hvornår partitionen skal optimeres
    max_tid + alder SOM rollup_tid,
    -- Hvornår den ældste del i partitionen blev opdateret
    min(p.modification_time) SOM modified_at
FRA system.parts SOM p
INNER JOIN
(
    -- Alle regler for alle tabeller *GraphiteMergeTree
    VÆLG
        Tables.database SOM database,
        Tables.table SOM table,
        alder
    FRA system.graphite_retentions
    ARRAY JOIN Tables
    GRUPPERE EFTER
        database,
        table,
        alder
) SOM g PÅ
    (p.table = g.table)
    OG (p.database = g.database)
HVOR
    -- Kun aktive dele
    p.active
    -- (*) Og kun rækker, hvor aggregeringsregler allerede skal anvendes
    OG ((toDateTime(p.max_date + 1) + g.age) < nu())
GRUPPERE EFTER
    tabel,
    partition
HAVING
    -- Kun partitioner, der er yngre end optimeringsmomentet
    (modified_at  1)
ORDNE EFTER
    tabel ASC,
    partition ASC,
    alder ASC
retur hver af partitionerne i tabellerne *GraphiteMergeTree, hvis sammensmeltning skal føre til frigivelse af diskplads. Det er kun et lille spørgsmål at gennemgå dem alle med en forespørgsel OPTIMIZE ... FINAL. I den endelige implementering er der også taget højde for, at partitioner med aktiv skrivning ikke behøver at blive berørt.
Det er netop det, projektet . Tidligere kolleger fra Yandex.Markets har testet det i produktion, resultatet kan ses nedenfor.
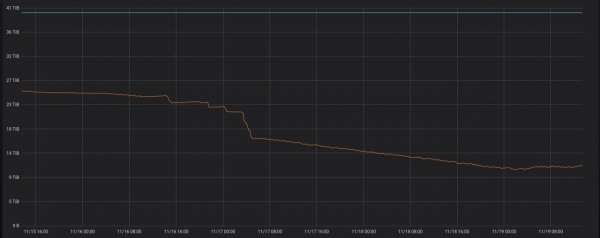
Hvis programmet kører på serveren med ClickHouse, vil det simpelthen begynde at køre i dæmontilstand. Hver time vil en forespørgsel blive udført for at kontrollere, om der er nye partitioner, der er ældre end tre dage, som kan optimeres.
I de nærmeste planer er det at levere, i det mindste deb-pakker, og om muligt også rpm.
Afslutning
I løbet af de mere end 9 måneder har jeg inden for mit selskab haft meget tid til at arbejde på grænsen mellem ClickHouse og graphite-web. Det har været en god oplevelse, hvilket resulterede i, at overgangen fra whisper til ClickHouse som metric storage snart er mulig. Jeg håber, at denne artikel er noget nær begyndelsen på en cyklus om de forbedringer, vi har foretaget i forskellige dele af denne stak, og hvad der vil blive gjort i fremtiden.
Det blev brugt flere liter øl og admin-dage på at udvikle forespørgslen sammen med , som jeg gerne vil udtrykke min taknemmelighed overfor. Og også for at gennemgå denne artikel.
Kilde: habr.com
