

Første del:
Hvad? En videokodek er en del af software/hardware, der komprimerer og/eller dekomprimerer digital video.
Hvorfor? På trods af visse begrænsninger mht. båndbredde
og lagerplads kræver markedet stadig video af højere kvalitet. Kan du huske, hvordan vi i det tidligere indlæg beregnede minimumsbehovet for 30 billeder pr. sekund, 24 bit pr. pixel, med opløsningen 480×240? Vi fik 82,944 Mbit/s uden komprimering. Komprimering er stadig den eneste måde at overføre HD/FullHD/4K til tv-skærme og internettet. Hvordan opnås dette? Lad os kort se på de vigtigste metoder.
Oversættelsen er lavet med støtte fra EDISON Software.Vi beskæftiger os med , samt .
Kodek vs Container
En almindelig fejl blandt begyndere er at forveksle videokodek og video container. En container er en slags format. En indpakning der indeholder metadata for video (og muligvis audio). Den komprimerede video kan betragtes som nyttelasten af containeren.
Som regel angiver video filens udvidelse dens variant af container. For eksempel er filen video.mp4 sandsynligvis en container MPEG-4 Part 14, og filen med navnet video.mkv er højst sandsynligt . For at være helt sikker på kodeken og containerformatet kan man bruge eller .
Lidt historie
Før vi går videre til Hvordan?, lad os dykke lidt ind i historien for bedre at forstå nogle gamle kodeker.
Videokodek H.261 blev introduceret i 1990 (teknisk set i 1988) og blev designet til en dataoverførselshastighed på 64 Kbit/s. Den benyttede allerede ideer som farvesubprøve, makroblokke osv. I 1995 blev standarden for videokodeken H.263, som blev udviklet indtil 2001.
I 2003 blev den første version af H.264/AVCfærdiggjort. Samme år udgav firmaet "TrueMotion" deres gratis videokodek, der komprimerer video med tab kaldet VP3. I 2008 købte Google dette firma og udgav VP8 samme år. I december 2012 udgav Google VP9, som understøttes af cirka ¾ af browsermarkedet (herunder mobile enheder).
AV1 – er en ny gratis videokodek med open source, udviklet af Alliancen for åbne medier (AOMedia), der består af velkendte virksomheder som: Google, Mozilla, Microsoft, Amazon, Netflix, AMD, ARM, NVidia, Intel og Cisco. Den første version af codec 0.1.0 blev offentliggjort den 7. april 2016.
Fødsel af AV1
I begyndelsen af 2015 arbejdede Google på VP10, Xiph (som tilhører Mozilla) arbejdede på Daala, mens Cisco lavede deres gratis videocodec kaldet Thor.
Dernæst MPEG LA meddelte først årlige grænser for HEVC (H.265) og gebyrer, der var 8 gange højere end for H.264, men kort efter ændrede de reglerne igen:
uden årlig grænse,
et gebyr for indhold (0,5 % af indtægterne) og
et produktgebyr omtrent 10 gange højere end for H.264.
Alliancen for åbne medier blev dannet af virksomheder fra forskellige områder: hardwareproducenter (Intel, AMD, ARM, Nvidia, Cisco), indholdsleverandører (Google, Netflix, Amazon), browserproducenter (Google, Mozilla) og andre.
Virksomhederne havde et fælles mål – en videocodec uden royalties. Derefter dukkede der op AV1 med en langt simplere patentlicens. Timothy B. Terriberry gav en fantastisk præsentation, der blev kilden til den nuværende koncept af AV1 og dens licensmodel.
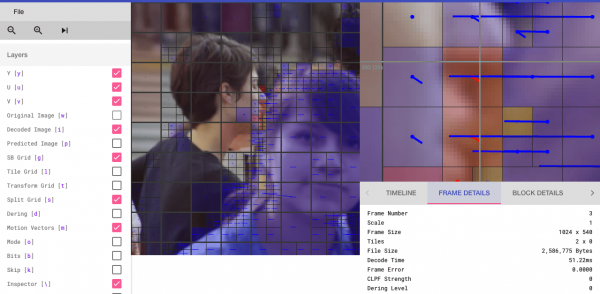
Du vil blive overrasket over at vide, at man kan analysere AV1 codec gennem en browser (interesserede kan gå til).
Universal codec
Lad os tage fat på de grundlæggende mekanismer, der ligger til grund for den universelle videocodec. De fleste af disse koncepter er nyttige og bruges i moderne codecs, såsom VP9, AV1 og HEVC. Jeg advarer om, at mange af de forklarede ting vil være forenklede. Nogle gange vil der blive brugt virkelige eksempler (som i tilfælde af H.264) til at demonstrere teknologier.
1. trin – opdeling af billedet
Det første trin er at opdele billedet i flere sektioner, undersektioner og videre.
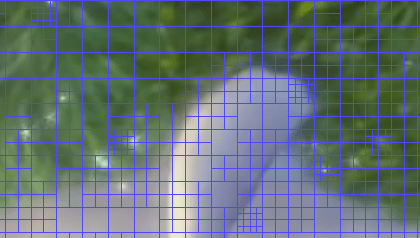
Hvorfor? Der er mange grunde. Når vi opdele billedet, kan vi bedre forudse bevægelsesvektoren ved at bruge små sektioner til små bevægende dele. Mens et statisk baggrund kan klare sig med større sektioner.
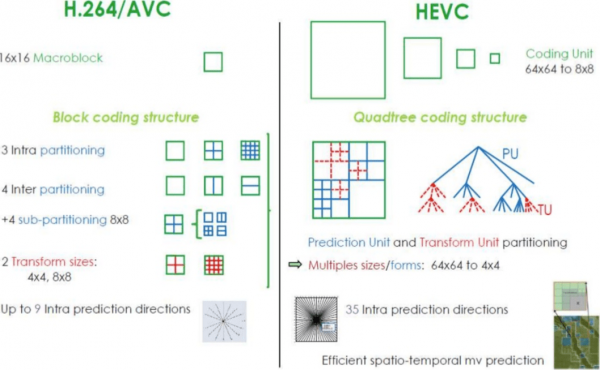
Normalt organiserer codecs disse sektioner i sektioner (eller fragmenter), makroblokke (eller kodetræblokke) og mange undersektioner. Den maksimale størrelse for disse sektioner varierer, HEVC sætter den til 64×64, mens AVC bruger 16×16, og undersektioner kan opdeles til størrelser på 4×4.
Husker I forskellige typer rammer fra den tidligere artikel?! Det samme kan anvendes til blokke, så vi kan have I-fragment, B-blok, P-makroblok osv.
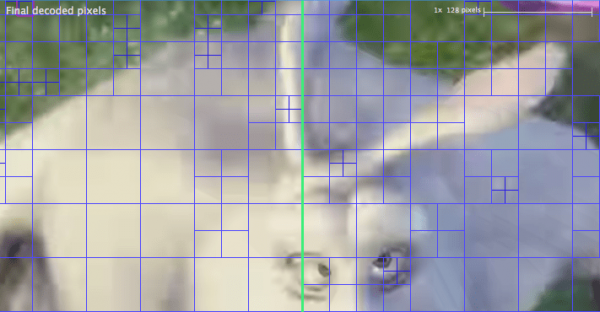
For dem der ønsker at øve sig — se hvordan billedet opdeles i sektioner og undersektioner. Du kan bruge den nævnte metode fra den tidligere artikel. (den betalte, men med en gratis prøveversion, som har en begrænsning på de første 10 rammer). Her er sektionerne analyseret. VP9:
2. trin — prognose
Når vi har sektionerne, kan vi lave astrologiske prognoser baseret på dem. Til INTER-prognoser er det nødvendigt at overføre bevægelsesvektorer og rest, mens til INTRA-prognoser sendes prognosens retning og rest.
3. trin — transformation
Når vi har den resterende blok (forudsagt sektion → reel sektion), kan vi transformere den på en måde, så vi ved, hvilke pixels vi kan kaste væk, mens vi bevarer den overordnede kvalitet. Der er nogle transformationer, der sikrer præcise resultater.
Der findes andre metoder, men lad os se nærmere på diskret cosinus-transformation (DCT — fra diskret cosinus-transform). DCTs hovedfunktioner:
- Transformerer pixelblokke til ensartede blokke af frekvenskoefficienter.
- Kompakter kraften, hvilket hjælper med at eliminere rumlig redundans.
- Sikrer reversibilitet.
Den 2. februar 2017 offentliggjorde Cintra, R.J. og Bayer, F.M. en artikel om DCT-lignende transformation til komprimering af billeder, som kun kræver 14 additioner.
Bare rolig, hvis du ikke forstod fordelene ved hvert punkt. Vi vil nu bekræfte deres reelle værdi med konkrete eksempler.
Lad os tage en pixelblok 8×8:
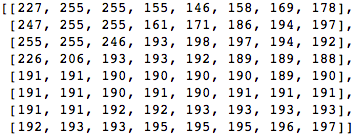
Denne blok gengives som følgende billede 8 på 8 pixels:
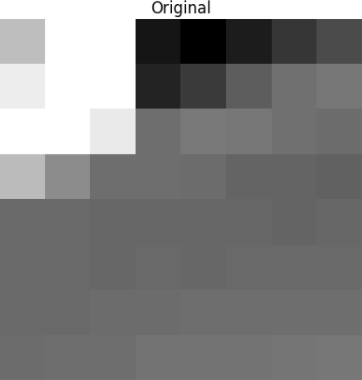
Vi anvender DCT på denne pixelblok og får en blok koefficienter i størrelsen 8×8:
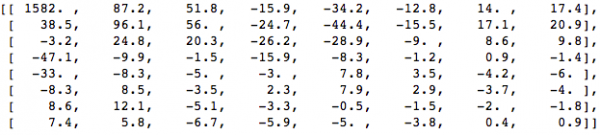
Og hvis vi gengiver denne blok af koefficienter, får vi dette billede:
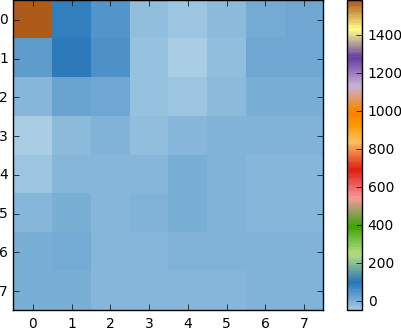
Som vi kan se, ligner det ikke det oprindelige billede. Det første koefficient skiller sig meget ud fra de andre. Denne første koefficient er kendt som DC-koefficienten, der repræsenterer alle prøver i inputmatricen, noget der ligner gennemsnitsværdien.
Denne koefficientblok har en interessant egenskab: den adskiller højfrekvente komponenter fra lavfrekvente.
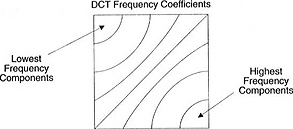
I billedet er størstedelen af kraften koncentreret ved de lavere frekvenser, så hvis man transformerer billedet til dets frekvenskomponenter og kasserer de højere frekvenser, kan man reducere mængden af data, der kræves for at beskrive billedet, uden at ofre for meget af billedkvaliteten.
Frekvens refererer til, hvor hurtigt signalet ændrer sig.
Lad os prøve at anvende den viden, vi fik i testeksemplet, ved at omdanne det oprindelige billede til dets frekvens (koefficientblokken) ved hjælp af DCT, og derefter kassere nogle af de mindst vigtige koefficienter.
Først konverterer vi det til frekvensområdet.
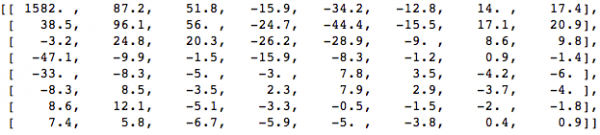
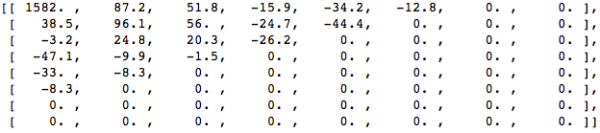
Dernæst kasserer vi en del (67%) af koefficienterne, primært i den nederste højre del.
Til slut genskaber vi billedet fra denne kasserede koefficientblok (huske, det skal være omvendeligt) og sammenligner med originalen.
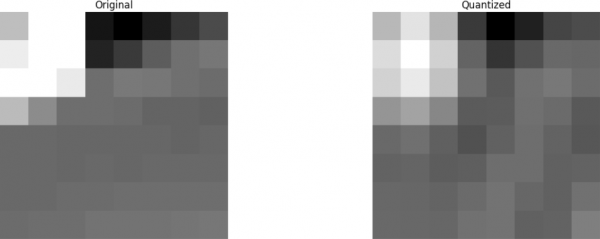
Vi ser, at det ligner det originale billede, men der er mange forskelle fra originalen. Vi har smidt 67,1875% væk og fik alligevel noget, der minder om kilden. Man kunne have været mere gennemtænkt med kasseringen af koefficienter for at få et billede af endnu bedre kvalitet, men det er et emne for en anden gang.
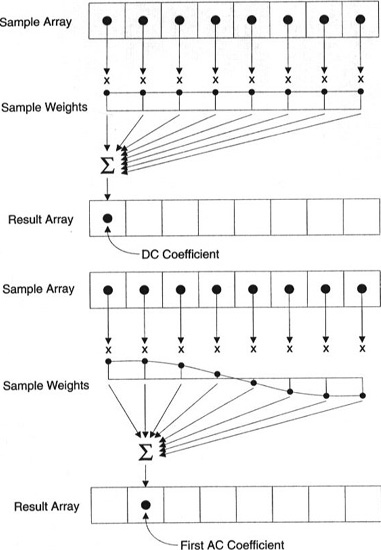
Hver koefficient dannes ved at bruge alle pixels.
Vigtigt: Hver koefficient svarer ikke direkte til en enkelt pixel, men repræsenterer en vægtet sum af alle pixels. Denne imponerende grafik viser, hvordan den første og anden koefficient beregnes ved hjælp af vægte, der er unikke for hver indeks.
Du kan også forsøge at visualisere DCT ved at se på en simpel dannelse af et billede baseret på det. For eksempel, her er symbolet A dannet ved hjælp af hver koefficientvægt:
Fjerde skridt – kvantisering
Efter at have kassere nogle koefficienter i det forrige skridt, udfører vi i det sidste skridt (transformationen) en særlig form for kvantisering. På dette trin er det acceptabelt at miste information. Eller, mere enkelt sagt, vi kvantiserer koefficienterne for at opnå kompression.
Hvordan kan vi kvantificere en blok af koefficienter? En af de enkleste metoder vil være jævn kvantificering, hvor vi tager blokken, deler den med en værdi (10) og afrunder det, vi har fået.
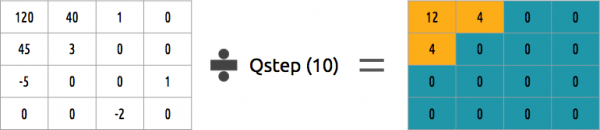
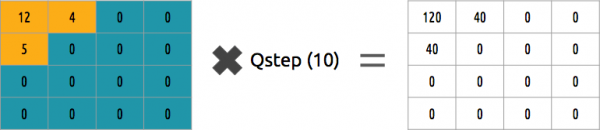
Kan vi omvende denne blok af koefficienter? Ja, det kan vi ved at multiplicere med den samme værdi, som vi delte med.
Denne tilgang er ikke den bedste, da den ikke tager højde for betydningen af hver koefficient. Vi kunne bruge en kvantificeringsmatrix i stedet for en enkelt værdi, og denne matrix kan drage fordel af DCT-egenskaberne ved at kvantificere de fleste nederste højre koefficienter og færre af de øverste venstre.
Trin 5 – Entropikodning
Efter at have kvantificeret dataene (billedblokke, fragmenter, rammer) kan vi stadig komprimere dem uden tab. Der findes mange algoritmiske metoder til datakomprimering. Vi vil kort præsentere nogle af dem, og for en dybere forståelse kan du læse bogen "Understanding Compression: Data Compression for Modern Developers".»).
Videokodning med VLC
Lad os antage, at vi har en strøm af tegn: en, e, r og t. Sandsynligheden (i intervallet fra 0 til 1) for, hvor ofte hvert tegn forekommer i strømmen, er præsenteret i denne tabel.
| en | e | r | t | |
|---|---|---|---|---|
| Sandsynlighed | 0,3 | 0,3 | 0,2 | 0,2 |
Vi kan tildele unikke binære koder (helst korte) til de mest sandsynlige, mens længere koder tildeles til de mindre sandsynlige.
| en | e | r | t | |
|---|---|---|---|---|
| Sandsynlighed | 0,3 | 0,3 | 0,2 | 0,2 |
| Binær kode | 0 | 10 | 110 | 1110 |
Vi komprimerer strømmen og antager, at vi ved afslutningen bruger 8 bits pr. tegn. Uden komprimering ville der kræves 24 bits pr. tegn. Hvis hvert tegn erstattes med sin kode, opnås der en besparelse!
Det første skridt er at kode tegnet e, som er lig med 10, og det andet tegn er en, som tilføjes (ikke på en matematisk måde): [10] [0], og endelig det tredje tegn t, hvilket gør vores endelige komprimerede bitstrøm til [10] [0] [1110] eller 1001110, som kræver i alt 7 bits (3,4 gange mindre plads end originalen).
Bemærk, at hver kode skal være en unik kode med et præfiks. hjælper med at finde disse cifre. Selvom denne metode ikke er uden fejl, findes der video codecs, som stadig tilbyder denne algoritmiske metode til komprimering.
Både koder og dekodere skal have adgang til symboltabellen med deres binære koder. Derfor er det også nødvendigt at sende tabellen med i inputdataene.
Aritmetisk kodning
Lad os antage, at vi har en strøm af tegn: en, e, r, s og t, og deres sandsynlighed præsenteres i denne tabel.
| en | e | r | s | t | |
|---|---|---|---|---|---|
| Sandsynlighed | 0,3 | 0,3 | 0,15 | 0,05 | 0,2 |
Med denne tabel opbygger vi intervaller, der indeholder alle mulige tegn, sorteret efter deres hyppighed.
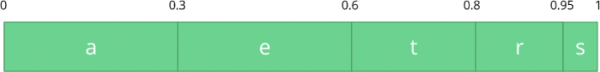
Lad os nu kode strømmen af tre tegn: eat.
Først vælger vi det første tegn e, som ligger inden for intervallet fra 0,3 til 0,6 (ikke inklusive). Vi tager dette delinterval og dividerer det igen i de samme proportioner som før, men for dette nye interval.
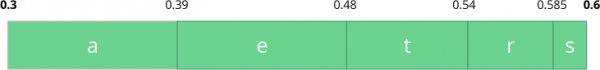
Lad os fortsætte med at kode vores strøm eat. Nu tager vi det andet tegn en, som ligger i det nye delinterval fra 0,3 til 0,39, og derefter tager vi vores sidste tegn t og, ved at gentage den samme proces, får vi det sidste delinterval fra 0,354 til 0,372.
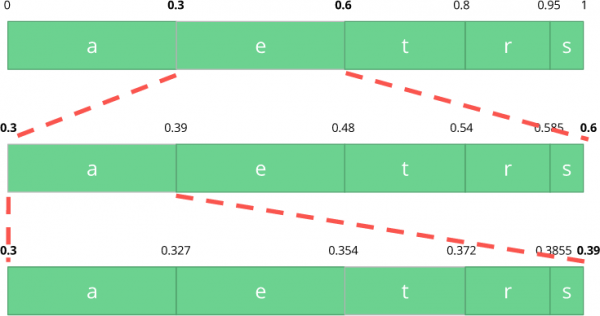
Vi skal blot vælge et tal i det sidste delinterval fra 0,354 til 0,372. Lad os vælge 0,36 (men vi kan vælge ethvert andet tal inden for dette interval). Kun med dette tal kan vi gendanne vores originale strøm. Det er som hvis vi tegnede en linje inden for intervallerne for at kode vores strøm.
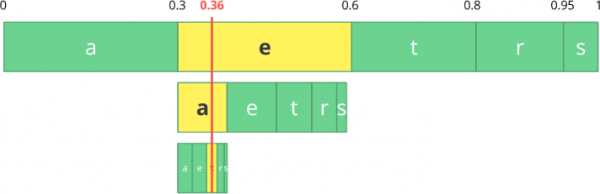
Den modsatte operation (det vil sige dekodning) er lige så enkel: med vores tal 0,36 og vores oprindelige interval kan vi køre den samme proces. Men nu, ved at bruge dette tal, identificerer vi strømmen, der er kodet med dette tal.
Med det første interval bemærker vi, at vores tal svarer til skæringen, så derfor er dette vores første tegn. Nu opdeler vi dette delinterval igen og udfører den samme proces som før. Her kan vi se, at 0,36 svarer til tegnet en, og efter at have gentaget processen er vi nået til det sidste tegn t (som danner vores oprindelige kodede strøm eat).
Både koderen og dekoderen skal have adgang til sandsynlighedstabellen for tegn, så det er nødvendigt at sende den med i inputdataene.
Ret elegant, ikke? Den, der opfandt denne løsning, var virkelig smart. Nogle videokodeker bruger denne teknik (eller tilbyder den i hvert fald som en mulighed).
Ideen er at komprimere den kvantiserede bitstrøm uden tab. Der mangler sikkert mange detaljer, grunde, kompromiser osv. i denne artikel. Men hvis du er udvikler, skal du vide mere. Nye codecs forsøger at anvende forskellige entropikodningsalgoritmer, såsom ANS.
Trin 6 - bitstreamformat
Efter at have gennemført alt dette, er det tid til at dekomprimere de komprimerede billeder i konteksten af de udførte trin. Decoder skal eksplicit informeres om de beslutninger, der blev truffet af encoder. Decoder skal have alle nødvendige oplysninger: bitdybde, farverum, opløsning, forudsigelsesinformation (bevægelighedsvektorer, rettet INTER-forudsigelse), profil, niveau, billedfrekvens, billedtype, billednummer osv.
Vi vil kort gennemgå bitstrømmen H.264. Vores første skridt er at skabe en minimal H.264 bitstream (FFmpeg tilføjer som standard alle kodningsparametre, såsom SEI NAL — som vi vil lære om senere). Vi kan gøre dette ved at bruge vores eget repository og FFmpeg.
./s/ffmpeg -i /files/i/minimal.png -pix_fmt yuv420p /files/v/minimal_yuv420.h264
Denne kommando vil generere en rå bitstrøm H.264 med et billede, en opløsning på 64×64, og et farverum YUV420. Som billede vil følgende blive brugt.

H.264 bitstrøm
Standarten AVC (H.264) definerer, at informationen vil blive sendt i makrobilleder (i netværksforstand), kaldet NAL (dette er et abstraktionsniveau i netværket). Hovedformålet med NAL er at give en "netværksvenlig" repræsentation af video. Denne standard skal fungere på fjernsyn (baseret på strømme) og internettet (baseret på pakker).

Der findes en synkroniseringsmarkør til at bestemme grænserne for NAL-elementer. Hver synkroniseringsmarkør indeholder værdien 0x00 0x00 0x01, undtagen den første, som er lig med 0x00 0x00 0x00 0x01. Hvis vi kører hexdump for den genererede H.264 bitstrøm, vil vi identificere mindst tre NAL-mønstre i begyndelsen af filen.
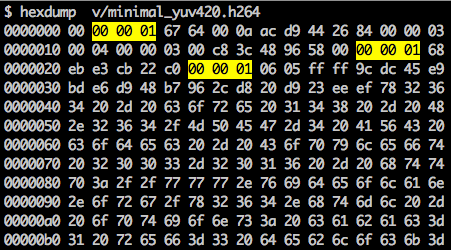
Som nævnt skal decoderen vide ikke bare billeddataene, men også videoens detaljer, billederne, farverne, de anvendte parametre og meget mere. Den første byte af hver NAL bestemmer dens kategori og type.
| NAL type-ID | Description |
|---|---|
| 0 | Ukendt type |
| 1 | Kodet billedfragment uden IDR |
| 2 | Kodet datasektion af skiver A |
| 3 | Kodet datasektion af skiver B |
| 4 | Kodet datasektion af skiver C |
| 5 | Kodet IDR-fragment af IDR-billede |
| 6 | Yderligere information om SEI-udvidelsen |
| 7 | Sæt af SPS-sekvensparametre |
| 8 | Sæt af PPS-billedparametre |
| 9 | Adgangsseparator |
| 10 | Slut på sekvens |
| 11 | Slut på strøm |
| … | … |
Det første NAL-bitstream er normalt SPS. Denne type NAL svarer til at informere om generelle kodningsvariable som profil, niveau, opløsning og andet.
Hvis den første synkroniseringsmarkør springes over, kan vi dekode det første byte for at finde ud af, hvilken type NAL det første er.
For eksempel, det første byte efter synkroniseringsmarkøren er 01100111, hvor det første bit (0) er i feltet forbidden_zero_bit. De næste 2 bit (11) fortæller os feltet nal_ref_idc, som angiver, om dette NAL er et referencefelt eller ej. Og de resterende 5 bit (00111) fortæller os feltet nal_unit_type, i dette tilfælde er det SPS-blok (7) NAL.
Det andet byte (binært=01100100, hex=0x64, dec=100) i SPS NAL er feltet profile_idc, som viser den profil, som encoder brugte. I dette tilfælde blev en begrænset høj profil brugt (dvs. en høj profil uden støtte til bidirektionel B-segment).
Hvis vi ser på specifikationen for bitstream H.264 for SPS NAL, finder vi mange værdier til navnet parameter, kategori og beskrivelse. For eksempel, lad os se på felterne pic_width_in_mbs_minus_1 og pic_height_in_map_units_minus_1.
| Navn på parameter | Kategori | Description |
|---|---|---|
| pic_width_in_mbs_minus_1 | 0 | ue(v) |
| pic_height_in_map_units_minus_1 | 0 | ue(v) |
Hvis vi udfører nogen matematiske operationer med værdierne i disse felter, får vi opløsningen. Man kan repræsentere 1920 x 1080 ved hjælp af pic_width_in_mbs_minus_1 med værdien 119 ((119 + 1) * macroblock_size = 120 * 16 = 1920). Igen, for at spare plads, i stedet for at kode 1920 gjorde vi det med 119.
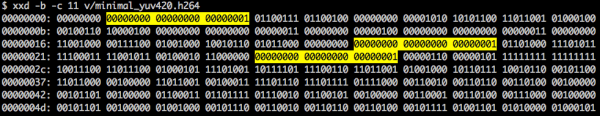
Hvis vi fortsætter med at kontrollere vores oprettede video i binært format (f.eks.: xxd -b -c 11 v/minimal_yuv420.h264), kan vi gå til den sidste NAL, som er selve billedet.

Her ser vi de første 6 byteværdier: 01100101 10001000 10000100 00000000 00100001 11111111. Da det er kendt, at det første byte angiver typen af NAL, i dette tilfælde (00101) er det IDR fragment (5), og vi kan derfor fortsætte med at undersøge det:
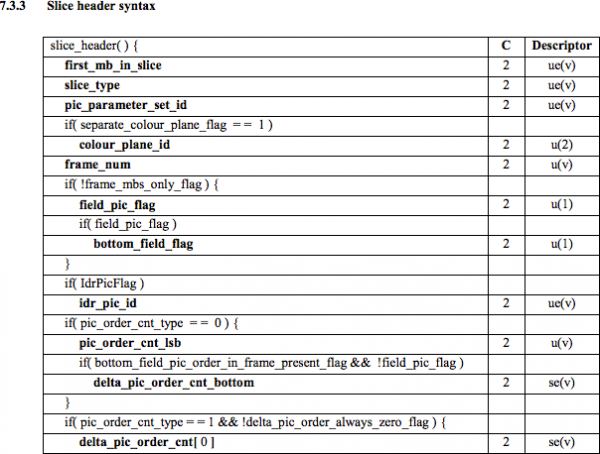
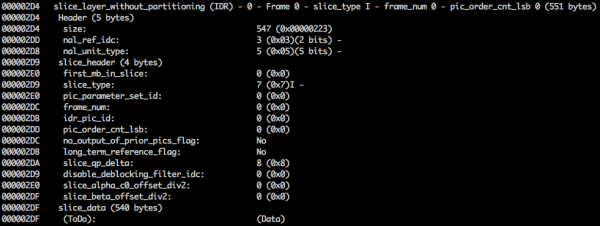
Ved at bruge informationen fra specifikationen kan vi dekode fragmenttypen (slice_type) og ramme nummeret (frame_num) blandt andre vigtige felter.
For at få værdierne for nogle felter (ue(v), me(v), se(v) eller te(v), skal vi dekode fragmentet ved hjælp af en specialiseret dekoder, baseret på . Denne metode er meget effektiv til kodning af variabelværdier, især når der er mange standardværdier.
Værdier slice_type og frame_num for denne video er 7 (I-fragment) og 0 (det første billede).
Bitstrømmen kan betragtes som en protokol. Ønsker du at lære mere om bitstrømmen, bør du se på specifikationen ITU H.264. Her er et diagram, der viser, hvor billeddataene findes (YUV i komprimeret form).
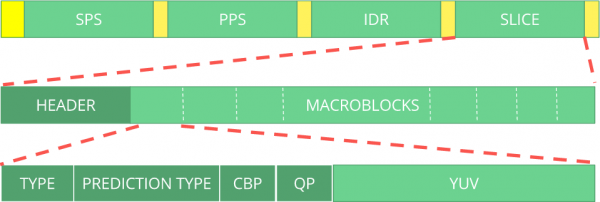
Du kan også udforske andre bitstrømme, såsom VP9, H.265 (HEVC) eller endda vores nye bedste bitstrøm AV1. Ligner de alle hinanden? Nej, men når du først har forstået en, bliver det meget lettere at forstå de andre.
Vil du øve dig? Udforsk H.264 bitstrømmen
Du kan generere en enkelt billedvideo og bruge MediaInfo til at undersøge bitstrømmen H.264. Faktisk er der intet der forhindrer dig i at se kildekoden, der analyserer bitstrømmen. H.264 (AVC).
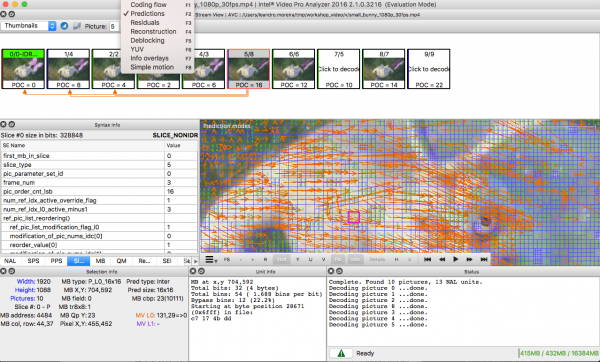
Til øvelse kan Intel Video Pro Analyzer bruges (jeg har måske nævnt, at programmet er betalingsbaseret, men der er en gratis prøveversion med 10 rammer?).
Oversigt
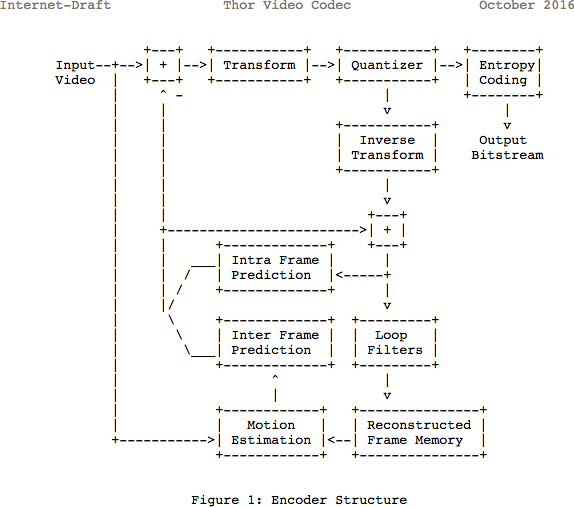
Det skal bemærkes, at mange moderne codec'er bruger den samme model, som vi lige har studeret. Lad os tage et kig på blokdiagrammet for videocodecen Thor. Det indeholder alle de skridt, vi har gennemgået. Hele ideen med denne note er, at du i det mindste bedre forstår innovationer og dokumentation inden for dette område.
Tidligere har vi beregnet, at der vil være brug for 139 GB diskplads til at gemme en video, der varer en time ved 720p og 30 fps. Hvis du bruger de metoder, vi har gennemgået i denne artikel (interframe og interne forudsigelser, transformation, kvantisering, entropisk kodning osv.), kan du opnå en video af rimelig kvalitet, der kun fylder 367,82 MB i stedet for 139 GB.
Hvordan opnår H.265 en bedre komprimeringsgrad end H.264?
Nu, hvor vi ved mere om, hvordan codec'er fungerer, er det lettere at forstå, hvordan nye codec'er kan levere højere opløsninger med færre bits.
Når man sammenligner AVC og HEVC, er det værd at huske, at det næsten altid er et valg mellem en større belastning på CPU'en og graden af kompression.
HEVC har flere sektioner (og undersektioner) end AVC, flere retninger for intern prognose, forbedret entropikodning og meget mere. Alle disse forbedringer har gjort H.265 i stand til at komprimere 50 % mere end H.264.
Første del:
Kilde: habr.com
