

Jeg har fået en opgave af følgende art. Det er nødvendigt at implementere en datalagringscontainer, der sikrer følgende funktionalitet:
- indsætte et nyt element
- fjerne et element efter dets rækkenummer
- hente et element efter dets rækkenummer
- data opbevares i sorteret rækkefølge
Data bliver konstant tilføjet og fjernet, så strukturen skal sikre hurtig drift. I starten prøvede jeg at implementere noget ved hjælp af standardcontainere fra std. Denne vej førte ikke til succes, og det blev klart, at jeg måtte implementere noget selv. Det eneste, der kom til at tænke på, var at bruge et binært søgetræ. Da det opfylder kravene til hurtig indsættelse, fjernelse og opbevaring af data i sorteret rækkefølge. Det var kun nødvendigt at finde ud af, hvordan man indekserer alle elementerne og genberegner indekserne, når træet ændrer sig.
struct node_s {
    data_t data;

    uint64_t weight; // vægt af noden

    node_t *left;
    node_t *right;

    node_t *parent;
};
Artiklen vil indeholde flere billeder og teori end kode. Koden kan ses via linket nedenfor.
Vægt
For dette blev træet udsat for en lille modification, hvor der blev tilføjet yderligere information om vægten af noden. Vægten af noden er antallet af efterkommere af denne node + 1 (vægt af en enkelt element).
Funktionen til at få vægten af noden:
uint64_t bntree::get_child_weight(node_t *node) {
    if (node) {
        return node->weight;
    }

    return 0;
}
For et blad er vægten derfor 0.
Lad os fortsætte med at vise et eksempel på et sådant træ. I sort vil nøglen for noden blive vist (værdien vises ikke, da der ikke er behov for det), i rødt — vægten af noden, i grønt — indekset af noden.
Når træet er tomt, er dets vægt 0. Lad os tilføje rod elementet:
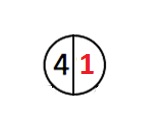
Vægten af træet bliver 1, vægten af rod elementet er 1. Vægten af rod elementet er vægten af træet.
Lad os tilføje et par flere elementer:
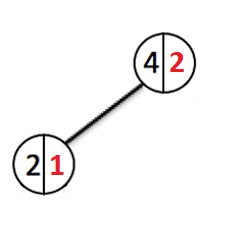
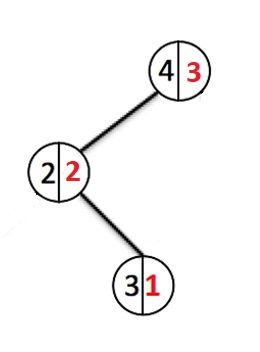
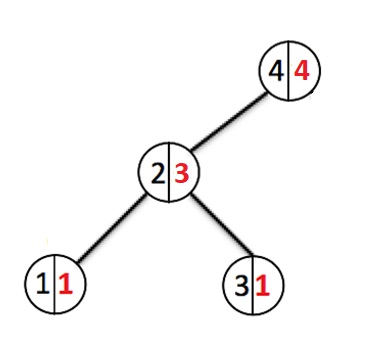
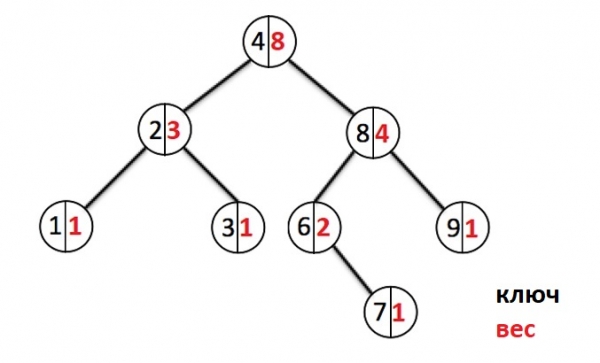
Hver gang vi tilføjer et nyt element, går vi ned gennem noderne og øger vægttælleren for hver node, vi passerer. Når et nyt noden oprettes, tildeles det en vægt 1. Hvis en node med denne nøgle allerede findes, opdaterer vi værdien og går tilbage til roden, mens vi annullerer ændringerne af vægten for alle de noder, vi har passeret.
Hvis der sker sletning af en node, går vi ned og dekremeterer vægten af de noder, vi passerer.
Indekser
Lad os nu se på, hvordan vi indekserer noder. Noderne gemmer tydeligvis ikke deres indeks; det beregnes baseret på noderne vægt. Hvis de gemte deres indeks, ville det kræve O(n) meget tid at opdatere indeksene for alle noder efter hver ændring i træet.
Lad os gå videre til en visuel repræsentation. Vores træ er tomt; lad os tilføje den første node:
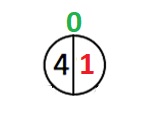
Den første node har indekset 0, og nu er der to mulige scenarier. I det første vil indekset af roden ændre sig, i det andet ikke.
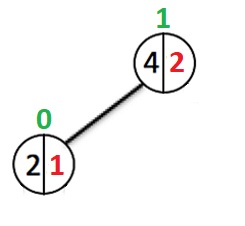
Rodens venstre undertræ vejer 1.
Andet tilfælde:
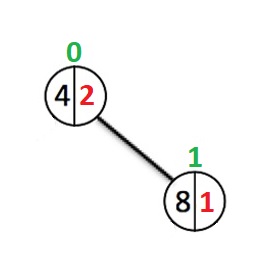
Rodens indeks er ikke ændret, da vægten af dens venstre undertræ forblev 0.
Hvordan indeks skal beregnes for en node, det er vægten af dens venstre undertræ + det tal, der er givet fra forælderen. Hvad er dette tal? Det er tælleren for indekser, der oprindeligt er lig med 0, da roden ikke har nogen forælder. Derefter afhænger alt af, hvor vi bevæger os hen: til venstre barn eller højre. Hvis vi går til venstre, tilføjes der ikke noget til tælleren. Hvis vi går til højre, tilføjer vi indeks for den nuværende node.
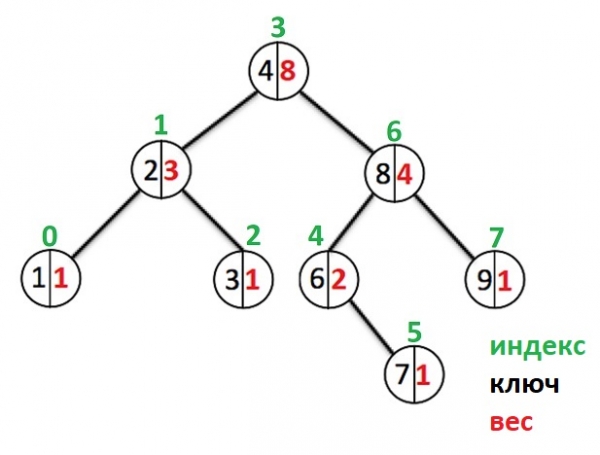
For eksempel, hvordan beregnes indekset for elementet med nøgle 8 (højre barn af roden)? Det er "Rodens indeks" + "vægt af venstre undertræ af noden med nøgle 8" + "1" == 3 + 2 + 1 == 6
Indekset for elementet med nøgle 6 vil være "Rodens indeks" + 1 == 3 + 1 == 4
Tilsvarende kræver det tid at få eller slette et element efter indeks O(log n), fordi for at få det ønskede element skal vi først finde det (gå fra roden til dette element).
Dybde
Baseret på vægten kan man også beregne dybden af træet. Dette er nødvendigt for at opnå balance.
For dette skal vægten af den aktuelle node rundes op til det første tal i eksponenten 2, som er større end eller lig med den givne vægt, og tage den binære logaritme af det. På denne måde får vi dybden af træet, forudsat at det er balanceret. Træet balanceres efter indsættelsen af et nyt element. Jeg vil ikke gå ind i teorien om, hvordan man balancerer træer. Funktionen til at balancere er præsenteret i kildekoderne.
Kode til konvertering af vægt til dybde.
/*
 * Возвращает первое число в степени 2, которое больше или ровно x
 */
uint64_t bntree::cpl2(uint64_t x) {
    x = x - 1;
    x = x | (x >> 1);
    x = x | (x >> 2);
    x = x | (x >> 4);
    x = x | (x >> 8);
    x = x | (x >> 16);
    x = x | (x >> 32);

    return x + 1;
}

/*
 * Двоичный логарифм от числа
 */
long bntree::ilog2(long d) {
    int result;
    std::frexp(d, &result);
    return result - 1;
}

/*
 * Вес к глубине
 */
uint64_t bntree::weight_to_depth(node_t *p) {
    if (p == NULL) {
        return 0;
    }

    if (p->weight == 1) {
        return 1;
    } else if (p->weight == 2) {
        return 2;
    }

    return this->ilog2(this->cpl2(p->weight));
}
Resumé
- Indsættelse af et nyt element sker på O(log n)
- Sletning af et element efter rækkefølge sker på O(log n)
- Hentning af et element efter rækkefølge sker på O(log n)
Hastighed O(log n) betaler vi for, at alle data opbevares i sorteret form.
Hvor en sådan struktur kan være nyttig - ved jeg ikke. Det er bare en øvelse for at forstå, hvordan træer fungerer. Tak for opmærksomheden.
Links
Projektet indeholder testdata til at kontrollere hastigheden. Træet udfyldes 1000000 elementer. Og der sker en sekventiel sletning, indsættelse og hentning af elementer 1000000 gange. Det vil sige 3000000 operationer. Resultatet viste sig at være ganske godt ~ 8 sekunder.
Kilde: habr.com
