

Vi er nu i 2019, og vi har stadig ikke en standardløsning til logaggregering i Kubernetes. I denne artikel vil vi gerne, ved hjælp af eksempler fra den virkelige verden, dele vores søgninger, de udfordringer, vi stødte på, og deres løsninger.
Dog vil jeg indledningsvis bemærke, at forskellige kunder forstår meget forskelligt vedrørende logindsamling:
- nogle ønsker at se sikkerheds- og revisionslogs;
- nogle ønsker centraliseret logning af hele infrastrukturen;
- og nogle er tilfredse med kun at indsamle applikationslogs, mens de for eksempel udelader balanceringsenheder.
Om hvordan vi implementerede forskellige "ønsker" og hvilke vanskeligheder vi stødte på, kan du læse mere om.
Teori: om værktøjer til logs
Baggrund om komponenterne i loggingssystemet
Logning har gennemgået en lang rejse, som har resulteret i metoder til indsamling og analyse af logs, som vi anvender i dag. Allerede i 1950'erne dukkede der i Fortran op en form for standardiserede input-output streams, der hjalp programmører med at debugge deres programmer. Dette var de første computerlogs, der lettede livet for programmører dengang. I dag ser vi den første komponent i loggingssystemet — kilden eller "producenten" (producer) af logs..
Datavidenskab har ikke stået stille: computernetværk, de første klynger... Komplekse systemer bestående af flere computere begyndte at operere. Nu blev systemadministratorer nødt til at indsamle logs fra flere maskiner, og i særlige tilfælde kunne de også tilføje beskeder fra operativsystemets kerne, hvis der skulle foretages en undersøgelse i tilfælde af systemfejl. For at beskrive systemer til centraliseret logindsamling udkom i begyndelsen af 2000'erne , som standardiserede remote_syslog. Så dukkede endnu en vigtig komponent op: logsamleren og deres opbevaring.
Med den stigende mængde logs og den omfattende implementering af webteknologier opstod spørgsmålet om, hvordan loggene skulle præsenteres på en brugervenlig måde. Enkeltstående konsolværktøjer (awk/sed/grep) blev afløst af mere avancerede logvisere — den tredje komponent.
Med den stigende mængde af logs er det blevet klart, at logs er nødvendige, men ikke alle. Desuden kræver forskellige logs forskellige niveauer af opbevaring: nogle kan tabes efter en dag, mens andre skal opbevares i 5 år. Så der blev tilføjet en filtrerings- og routingkomponent til logningssystemet – lad os kalde det filter.
Lagringssystemerne har også gjort et seriøst spring: fra almindelige filer er de gået over til relationelle databaser og derefter til dokumentorienterede lagre (for eksempel Elasticsearch). Så lagersystemet blev adskilt fra samleren.
I sidste ende er selve begrebet log blevet udvidet til at inkludere en eller anden form for abstraheret strøm af hændelser, som vi ønsker at gemme til historien. Mere præcist – i tilfælde af, at en undersøgelse skal foretages, eller et analytisk rapport skal udarbejdes…
Som et resultat er indsamlingen af logs, på relativt kort tid, blevet en vigtig delsubsystem, som med rette kan betragtes som en af underafdelingerne i Big Data.
Hvis man tidligere kunne nøjes med almindelige printmetoder til et "logningssystem", så er situationen nu ændret drastisk.
Kubernetes og logs
Da Kubernetes kom ind i infrastrukturen, undgik det ikke det eksisterende problem med logindsamling. På en måde blev det endda mere smertefuldt: styringen af infrastrukturplatformen blev ikke kun forenklet, men også samtidig gjort mere kompleks. Mange gamle tjenester begyndte at migrere til mikrotjeneste-arkitektur. I forbindelse med logs manifesterede dette sig i det stigende antal logkilder, deres specielle livscyklus og behovet for at spore interrelationerne mellem alle systemkomponenter gennem logs…
For at se fremad kan jeg konstatere, at der desværre i øjeblikket ikke findes en standardiseret logging-løsning for Kubernetes, som skiller sig positivt ud fra alle andre. De mest populære skemaer i samfundet falder tilbage til følgende:
- nogen sætter en EFK (Elasticsearch, Fluentd, Kibana);
- nogen – prøver den nyligt frigivne eller bruger ;
- os (og måske ikke kun os?..) meget tilfreds med egen udvikling — …
Som regel bruger vi sådanne kombinationer i K8s-klynger (til self-hosted-løsninger):
- ;
- .
Men vil ikke stoppe ved instruktioner til installation og konfiguration. I stedet vil jeg fokusere på deres ulemper og de mere overordnede konklusioner om logs generelt.
Praksis med logs i K8s
«Hverdagslogs», hvor mange er I?..
Centraliseret indsamling af logs fra en tilstrækkelig stor infrastruktur kræver en betydelig mængde ressourcer, som bruges til indsamling, lagring og behandling af logs. I løbet af driften af forskellige projekter er vi stødt på forskellige krav og de problemer, der følger med dem.
Lad os prøve ClickHouse
Lad os se på et centralt lager i et projekt med en applikation, der genererer logs ganske aktivt: mere end 5000 linjer pr. sekund. Vi begynder at arbejde med dens logs, ved at lægge dem i ClickHouse.
Når maksimal realtid kræves, vil en 4-kernet server med ClickHouse allerede være belastet i disksystemet:
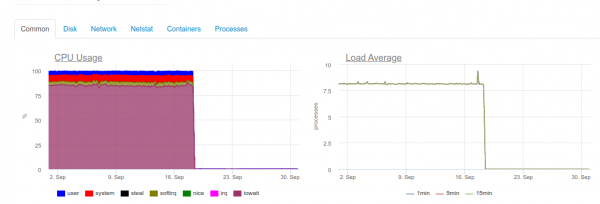
Denne type belastning skyldes, at vi forsøger at skrive så hurtigt som muligt til ClickHouse. Og databasen reagerer på dette med øget diskbelastning, hvilket kan medføre fejl som:
DB::Exception: For mange dele (300). Sammenlægninger behandles betydeligt langsommere end indsatser
Sagen er den, at i ClickHouse (hvor logs' data ligger) har deres egne vanskeligheder ved indsætningsoperationer. De data, der indsættes i dem, genererer en midlertidig partition, som derefter merges med hovedtabellen. Resultatet er, at indsættelse kræver meget fra disken, og der gælder også en grænse, som vi fik ovenfor: ikke mere end 300 sub-partitioner kan merges pr. sekund (faktisk svarer det til 300 insert's pr. sekund).
For at undgå sådan adfærd i så store portioner som muligt og ikke oftere end én gang hvert andet sekund. Men at skrive i store portioner kræver, at vi skriver sjældnere til ClickHouse. Dette kan på sin side føre til overbelastning af bufferen og tab af logs. Løsningen er at øge bufferen i Fluentd, men så vil også hukommelsesforbruget stige.
Bemærk: En anden problematisk side ved vores løsning med ClickHouse var relateret til, at partitionering i vores tilfælde (loghouse) er implementeret via eksterne tabeller, der er forbundet . Dette medfører, at der ved hentning af store tidsintervaller kræves overdreven RAM, da metatabellen gennemgår alle partitioner - også dem, der åbenlyst ikke indeholder de nødvendige data. Dog kan denne tilgang nu med sikkerhed erklæres for forældet for de aktuelle versioner af ClickHouse (c ).
Som et resultat bliver det klart, at ikke alle projekter har tilstrækkelige ressourcer til realtidslogning i ClickHouse (mere præcist, deres fordeling vil ikke være hensigtsmæssig). Derudover vil det være nødvendigt at bruge en akkumulator, som vi vender tilbage til. Den ovenfor beskrevne situation er faktisk. Og på det tidspunkt kunne vi ikke tilbyde en pålidelig og stabil løsning, som kunne tilfredsstille kunden og muliggøre logindsamling med minimal forsinkelse…
Og Elasticsearch?
Det er kendt, at Elasticsearch kan håndtere store belastninger. Lad os prøve det i det samme projekt. Nu ser belastningen således ud:
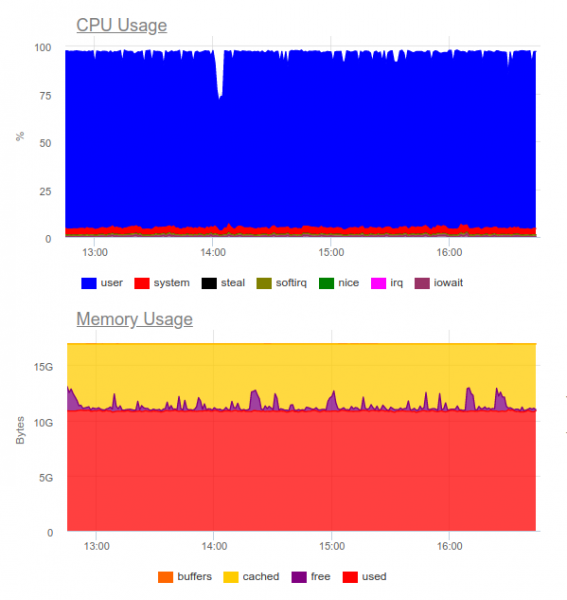
Elasticsearch kunne håndtere datastreamen, men at skrive sådanne mængder til det belaster CPU'en kraftigt. Dette løses ved at organisere et kluster. Rent teknisk er det ikke et problem, men det viser sig, at vi allerede bruger omkring 8 kerner kun for at få logningssystemet til at fungere og har en ekstra højt belastet komponent i systemet…
Konklusion: En sådan løsning kan være berettiget, men kun hvis projektet er stort, og ledelsen er villig til at investere betydelige ressourcer i et centraliseret logningssystem.
Så opstår det logiske spørgsmål:
Hvilke logs er virkelig nødvendige?
 Lad os prøve at ændre tilgangen: logs skal både være informative og ikke dække hvert begivenhed i systemet.
Lad os antage, at vi har en succesfuld onlinebutik. Hvilke logs er vigtige? At indsamle så meget information som muligt, for eksempel fra betalingsgatewayen - det er en fremragende idé. Men fra billedbehandlingsservicen i produktkataloget er vi kun interesserede i bestemte logs: det er nok med fejl og udvidet overvågning (for eksempel procentdelen af 500-fejl, som denne komponent genererer).
Her er vi kommet til det punkt, at centraliseret logning ikke altid er berettiget. Meget ofte ønsker kunden at samle alle logs ét sted, selvom der i virkeligheden kun kræves omkring 5% af beskederne fra hele loggen, som er kritiske for forretningen:
- Nogle gange er det tilstrækkeligt at justere størrelsen på containerloggen og fejlindsamleren (for eksempel Sentry).
- Til undersøgelse af hændelser er det ofte tilstrækkeligt med en fejlnotifikation og et stort lokalt log.
- Vi har haft projekter, hvor funktionelle tests og fejlindsamlingssystemer alene var tilstrækkelige. Udvikleren havde ikke brug for logs, da de kunne se alt via fejltrace.
Et eksempel fra virkeligheden
Et godt eksempel kan være en anden historie. Vi modtog en anmodning fra sikkerhedsteamet hos en af vores kunder, som allerede anvendte en kommerciel løsning, der var udviklet længe før implementeringen af Kubernetes.
Det var nødvendigt at 'venne' systemet til centraliseret logindsamling med virksomhedens problemdetektionssensor – QRadar. Dette system kan modtage logs via syslog-protokollen og hente dem via FTP. Men det lykkedes ikke straks at integrere det med remote_syslog-pluginet til fluentd. (som det viste sig, ). Problemerne med opsætningen af QRadar lå hos sikkerhedsteamet hos kunden.
Som et resultat blev nogle af de forretningskritiske logs sendt til QRadar via FTP, mens andre blev omdirigeret direkte fra noderne via remote syslog. For dette skrev vi endda — måske kan det hjælpe nogen med at løse en lignende opgave… Takket være denne opsætning fik kunden analyseret kritiske logs (ved hjælp af deres foretrukne værktøjer), og vi kunne reducere omkostningerne til loggingsystemet ved kun at opbevare logs for den seneste måned.
Et andet eksempel er ret illustrativt i forhold til, hvordan man ikke bør gøre. En af vores kunder lavede flere linjer af hver ustruktureret output information i loggen, når der kom begivenheder fra brugeren. Som man let kan gætte, var sådanne logs ekstremt vanskelige at læse og opbevare.
Kriterier for logs
Sådanne eksempler fører til konklusionen, at ud over valget af logindsamlingssystem skal man også designe selve loggene! Hvilke krav er der her?
- Loggene skal være i et maskinlæsbart format (for eksempel JSON).
- Loggene skal være kompakte med mulighed for at ændre logningsniveauet for at kunne fejlsøge eventuelle problemer. I produktionsmiljøer bør systemerne køres med et logningsniveau som Advarsel eller Fejl.
- Logfiler skal normaliseres, hvilket betyder, at alle strenge i logobjektet skal have samme felttype.
Ustrukturerede logfiler kan føre til problemer med indlæsning af logfiler i lageret og kan helt stoppe deres behandling. Et eksempel er en fejl 400, som mange har stødt på i logfiler fra fluentd:
2019-10-29 13:10:43 +0000 [warn]: dump an error event: error_class=Fluent::Plugin::ElasticsearchErrorHandler::ElasticsearchError error="400 - Rejected by Elasticsearch"
Fejlen betyder, at du sender et felt til en indeks med en eksisterende mapping, hvor typen er ustabil. Et simpelt eksempel er et felt i nginx-loggen med variablen $upstream_status. Det kan være både et tal og en streng. For eksempel:
{ "ip": "1.2.3.4", "http_user": "-", "request_id": "17ee8a579e833b5ab9843a0aca10b941", "time": "29\/Oct\/2019:16:18:57 +0300", "method": "GET", "uri": "\/staffs\/265.png", "protocol": "HTTP\/1.1", "status": "200", "body_size": "906", "referrer": "https:\/\/example.com\/staff", "user_agent": "Mozilla\/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit\/537.36 (KHTML, like Gecko) Chrome\/78.0.3904.70 Safari\/537.36", "request_time": "0.001", "cache_status": "-", "upstream_response_time": "0.001, 0.007", "upstream_addr": "127.0.0.1:9000", "upstream_status": "200", "upstream_response_length": "906", "location": "staff"}
 { "ip": "1.2.3.4", "http_user": "-", "request_id": "47fe42807f2a7d8d5467511d7d553a1b", "time": "29\/Oct\/2019:16:18:57 +0300", "method": "GET", "uri": "\/staff", "protocol": "HTTP\/1.1", "status": "200", "body_size": "2984", "referrer": "-", "user_agent": "Mozilla\/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit\/537.36 (KHTML, like Gecko) Chrome\/78.0.3904.70 Safari\/537.36", "request_time": "0.010", "cache_status": "-", "upstream_response_time": "0.001, 0.007", "upstream_addr": "10.100.0.10:9000, 10.100.0.11:9000", "upstream_status": "404, 200", "upstream_response_length": "0, 2984", "location": "staff"}
I logfilerne kan man se, at serveren 10.100.0.10 svarede med en 404-fejl, og forespørgslen blev sendt til et andet indholdslager. Som et resultat blev værdien i logfilerne sådan her:
"upstream_response_time": "0.001, 0.007"
Denne situation er så almindelig, at den endda er blevet omtalt med .
Hvad med pålideligheden?
Der er situationer, hvor det er livsvigtigt at have alle logfiler uden undtagelse. Og med de typiske logindsamlingsskemaer for K8s, som er nævnt/overvejet ovenfor, er der problemer.
For eksempel kan fluentd ikke indsamle logfiler fra kortlivede containere. I et af vores projekter levede en container med database-migrering i mindre end 4 sekunder, før den blev slettet - i henhold til den relevante annotation:
"helm.sh/hook-delete-policy": hook-succeeded
Som følge heraf blev loggen for migreringen ikke gemt i lageret. Her kan en politik som before-hook-creation.
Et andet eksempel er rotation af Docker-logfiler. Antag, at der er en applikation, der aktivt skriver til logfiler. Under normale forhold når vi at behandle alle logfiler, men så snart der opstår et problem - som beskrevet ovenfor med det forkerte format - stopper behandlingen, og Docker roterer filen. Resultatet er, at kritiske forretningslogfiler kan gå tabt.
Netop derfor Det er vigtigt at adskille logstrømme, ved at integrere sendingen af de mest værdifulde direkte i applikationen for at sikre deres opbevaring. Desuden ville det ikke skade at oprette en slags log "akkumulator", der kan overleve en kortvarig utilgængelighed af lageret, mens kritiske meddelelser opbevares.
Endelig skal man ikke glemme, at det er vigtigt at monitorere ethvert subsystem effektivt. Ellers er det nemt at ende i en situation, hvor fluentd er i en tilstand CrashLoopBackOff og ikke sender noget, hvilket kan betyde tab af vigtig information.
Konklusioner
I denne artikel diskuterer vi ikke SaaS-løsninger som Datadog. Mange af de problemer, der er beskrevet her, er allerede løst af kommercielle virksomheder, der specialiserer sig i logindsamling, men ikke alle kan bruge SaaS af forskellige grunde. (de primære er omkostninger og overholdelse af 152-FZ).
Centraliseret logindsamling ser i starten ud som en enkel opgave, men det er slet ikke tilfældet. Det er vigtigt at huske, at:
- Det er kun kritiske komponenter, der skal logges detaljeret, mens overvågning og fejlsamling kan indstilles for de øvrige systemer.
- Logs i produktion bør være minimale for ikke at overbelaste systemet.
- Logs skal være maskinlæsbare, normaliserede og have et strengt format.
- Virkelig kritiske logs bør sendes i en separat strøm, der skal være adskilt fra de primære.
- Det er værd at overveje en logbuffer, der kan redde os fra højbelastningsspidser og gøre belastningen på lagringen mere jævn.
Disse enkle regler, hvis de anvendes overalt, ville gøre det muligt for de beskrevede ordninger at fungere — selvom de mangler vigtige komponenter (bufferen). Hvis man ikke overholder sådanne principper, vil opgaven nemt føre dig og infrastrukturen til endnu en højbelastet (og samtidig ineffektiv) komponent i systemet.
P.S.
Læs også på vores blog:
- «»;
- «»;
- «».
Kilde: habr.com
