

Artiklen består af to dele:
- En kort beskrivelse af nogle netværksarkitekturer til objektdetektion på billeder og segmentering af billeder med de mest forståelige links til ressourcer. Jeg har forsøgt at vælge video forklaringer, gerne på russisk.
- Den anden del handler om at forstå udviklingen af arkitekturer inden for neurale netværk og teknologier baseret på dem.
Figur 1 – At forstå arkitekturer af neurale netværk er ikke ligetil
Alt begyndte med, at jeg lavede to demo-applikationer til klassificering og objektdetektion på en Android-telefon:
- , hvor data behandles på serveren og sendes til telefonen. Klassificering af billeder (image classification) af tre typer bjørne: brune, sorte og teddy.
- , hvor data behandles direkte på telefonen. Objektdetektion (object detection) af tre typer: hasselnød, figen og dadel.
Der er forskel på opgaverne for klassificering af billeder, objektdetektion og . Derfor opstod behovet for at finde ud af, hvilke arkitekturer af neurale netværk der kan opdage objekter på billeder, og hvilke der kan segmentere. Jeg fandt følgende eksempler på arkitekturer med de mest forståelige links til ressourcer:
- En serie arkitekturer baseret på R-CNN (Regions med Convolution Neuro Nnetværk træk): R-CNN, Fast R-CNN, , . For at opdage et objekt på et billede ved hjælp af mekanismen Region Proposal Network (RPN) fremhæves begrænsede regioner (bounding boxes). Oprindeligt blev en langsommere mekanisme Selective Search anvendt i stedet for RPN. Derefter sendes de fremhævede begrænsede regioner ind i et almindeligt neurale netværk til klassificering. I R-CNN-arkitekturen er der synlige "for"-løkker til iterering over de begrænsede regioner, op til 2000 gennemgange gennem det interne netværk AlexNet. På grund af de synlige "for"-løkker sænkes billedbehandlingshastigheden. Antallet af synlige løkker og gennemgange gennem det interne neurale netværk reduceres med hver ny version af arkitekturen, og der foretages også mange andre ændringer for at øge hastigheden og for at ændre opgaven fra objektdetektion til objeksegmentering i Mask R-CNN.
- (You Dnly Look Dnce) – det første neurale netværk, der genkendte objekter i realtid på mobile enheder. En karakteristisk egenskab: skelnen mellem objekter i én gennemgang (det er nok at se én gang). Det vil sige, at der i YOLO-arkitekturen ikke er åbenlyse "for"-løkker, hvilket gør, at netværket arbejder hurtigt. For eksempel kan man drage den analogi, at der i NumPy ved matrixoperationer heller ikke er åbenlyse "for"-løkker, som i NumPy implementeres på lavere niveauer i arkitekturen gennem programmeringssproget C. YOLO bruger et gitter af foruddefinerede vinduer. For at et og samme objekt ikke identificeres flere gange, anvendes et overlapsningskoefficient (IoU, Intersection over Union). Denne arkitektur fungerer i et bredt spænd og har høj : modellen kan trænes på fotografier, men fungerer også godt på tegnede billeder.
- (Angreb op til 1,2ingle Angreb op til 1,2hot MultiBox Detector) – de mest vellykkede "hacks" af YOLO-arkitekturen (for eksempel non-maximum suppression) anvendes, og nye tilføjes, så neurale netværk arbejder hurtigere og mere præcist. En karakteristisk egenskab: skelnen mellem objekter i én gennemgang ved hjælp af et givet vinduesgitter (default box) på billedernes pyramide. Billedepyramiden er kodet i konvolutions-tensorer ved sekventielle konvolutions- og pooling-operationer (under max-pooling-minskes den rumlige dimension). På denne måde identificeres både store og små objekter i én gennemgang af netværket.
- MobileSSD (MobilNetV2 + SSD) – en kombination af to arkitekturer for neurale netværk. Det første netværk arbejder hurtigt og øger genkendelsesnøjagtigheden. MobileNetV2 anvendes i stedet for VGG-16, som oprindeligt blev brugt i . Det andet netværk SSD bestemmer placeringen af objekter på billedet.
- – et meget lille, men præcist neuralt netværk. Selve netværket løser ikke opgaven med objektgenkendelse. Men det kan anvendes i kombination med forskellige arkitekturer. Og bruges på mobile enheder. En karakteristisk egenskab er, at data først komprimeres til fire 1×1 konvolutionsfiltre, og derefter udvides til fire 1×1 og fire 3×3 konvolutionsfiltre. En sådan iteration af kompression-udvidelse af data kaldes en "Fire Module".
- (Semantic Image Segmentation with Deep Convolutional Nets) – segmentering af objekter på et billede. Et kendetegn ved arkitekturen er den sparse (dilated convolution) konvolution, som bevarer den rumlige opløsning. Herefter følger en postbehandlingsfase, hvor resultaterne behandles ved hjælp af en grafisk sandsynlighedsmodel (conditional random field), hvilket muliggør fjernelse af små støj i segmenteringen og forbedrer kvaliteten af det segmenterede billede. Bag det skræmmende navn «grafisk sandsynlighedsmodel» gemmer sig et almindeligt Gauss-filter, der er approksimeret over fem punkter.
- Prøvede at finde ud af, hvordan det fungerer (Single-Shot Refinement Neural Network for Object Detection), men forstod ikke meget.
- Så så jeg, hvordan teknologien «attention» fungerer: , , . Et kendetegn ved «attention» arkitekturen er automatisk fremhævelse af regioner med høj opmærksomhed på billedet (RoI, Regions of Interest) ved hjælp af et neuralt netværk kaldet Attention Unit. Regioner med høj opmærksomhed ligner begrænsede regioner (bounding boxes), men i modsætning til dem er de ikke faste på billedet og kan have sløres kanter. Derefter udtages funktioner (features) fra regionerne med høj opmærksomhed, som «foderes» til rekursive neurale netværk med arkitekturer . Rekursive neurale netværk kan analysere forholdet mellem funktioner i en sekvens. Rekursive neurale netværk blev oprindeligt brugt til oversættelse af tekst til andre sprog, men nu også til at oversætte og .
Efter at have studeret disse arkitekturer forstod jeg, at jeg ikke forstod noget. Og det handler ikke om, at mit neurale netværk har problemer med attention-mekanismen. At skabe alle disse arkitekturer ligner en kæmpe hackathon, hvor forfatterne konkurrerer i hacks. Hack – en hurtig løsning på et svært programmeringsproblem. Det vil sige, at der ikke er nogen synlig og forståelig logisk forbindelse mellem alle disse arkitekturer. Alt, hvad de har til fælles, er et sæt af de mest vellykkede hacks, som de låner fra hinanden, plus en fælles (tilbagespredning af fejl, backpropagation). Der er ! Det er uklart, hvad der skal ændres og hvordan man optimerer de eksisterende resultater.
Som resultatet af manglen på logisk forbindelse mellem hacks er de ekstremt svære at huske og anvende i praksis. Det er fragmenteret viden. I bedste fald huskes et par interessante og overraskende punkter, men det meste af det forståede og uforståede forsvinder fra hukommelsen allerede efter et par dage. Det ville være godt, hvis man efter en uge kun kunne huske navnet på arkitekturen. Og der er blevet brugt adskillige timer og endda dage af arbejdstid på at læse artikler og se oversigtvideoer!
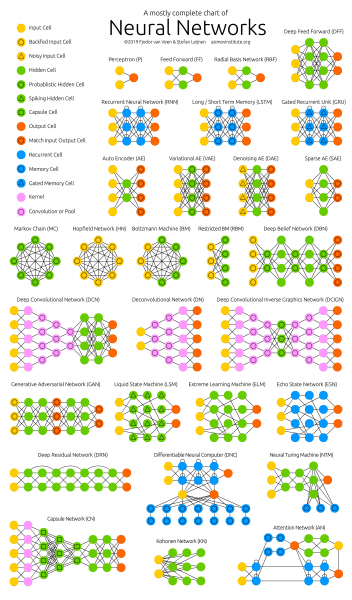
Figur 2 –
De fleste forfattere af videnskabelige artikler, efter min mening, gør alt, hvad de kan, for at selv denne fragmenterede viden ikke bliver forstået af læserne. Men gerundialer i ti linjer lang sætninger med formler, der er taget "fra loftet" – det er et emne for en separat artikel (problemet ).
Af denne grund opstod behovet for at systematisere informationen om neurale netværk og dermed øge kvaliteten af forståelsen og hukommelsen. Derfor blev hovedtemaet for analysen af de enkelte teknologier og arkitekturer af kunstige neurale netværk den følgende opgave: at finde ud af, hvor det hele bevæger sig hen, ikke en søgning efter konstruktionen af et bestemt neuralt netværk.
Hvor bevæger det hele sig hen. Hovedresultater:
- Antallet af startups inden for maskinlæring er i de sidste to år . En mulig årsag: "neurale netværk er ikke længere noget nyt".
- Enhver vil kunne skabe et fungerende neuralt netværk til at løse en simpel opgave. For dette vil man tage en færdig model fra "modeller zoen" (model zoo) og træne det sidste lag af det neurale netværk () på de tilgængelige data fra eller fra i det gratis .
- Store producenter af neurale netværk er begyndt at skabe "modelzoos" (model zoo). Med dem kan man hurtigt lave en kommerciel applikation: til TensorFlow, til PyTorch, til Caffe2, til Chainer og .
- Neurale netværk, der fungerer i real-time (real-time) på mobile enheder. Fra 10 til 50 billeder pr. sekund.
- Anvendelsen af neurale netværk i telefoner (TF Lite), i browsere (TF.js) og i (IoT, Iinternet of Tting). Især i telefoner, der allerede understøtter neurale netværk på hardware-niveau (neuroacceleratorer).
- «Hver enhed, beklædningsgenstande og måske endda mad vil have IP-v6 adresse og kommunikere med hinanden» – .
- Væksten i antallet af publikationer inden for maskinlæring er begyndt (fordobling hver andet år) siden 2015. Det er åbenlyst, at der er behov for neurale netværk til artikelanalyse.
- Følgende teknologier vinder popularitet:
- PyTorch – populariteten vokser hurtigt og synes at overhale TensorFlow.
- Automatisk hyperparameteroptimering AutoML – populariteten vokser gradvist.
- Gradvis reduktion af nøjagtighed og øgning af beregningshastighed: , algoritmer , unøjagtige (approksimerede) beregninger, kvantisering (hvor vægtene i neurale netværk omsættes til hele tal og kvantiseres), neuroacceleratorer.
- Oversættelse og .
- Oprettelse , nu i realtid.
- Det grundlæggende i DL er en masse data, men det er ikke nemt at indsamle og mærke dem. Derfor udvikles automatisering af mærkning () til neurale netværk ved hjælp af neurale netværk.
- Med neurale netværk er Computer Science pludselig blevet en eksperimentel videnskab og der opstod .
- IT-penge og populariteten af neurale netværk dukkede op samtidig, da beregning blev en markedsværdi. Økonomien skifter fra guld-valuta til guld-valuta-beregning.. Se min artikel om og årsagen til IT-penge.
En ny (Maskinlæring & Dyb Læring) er gradvist ved at opstå, som er baseret på at præsentere et program som en samling af trænede neurale netværksmodeller.
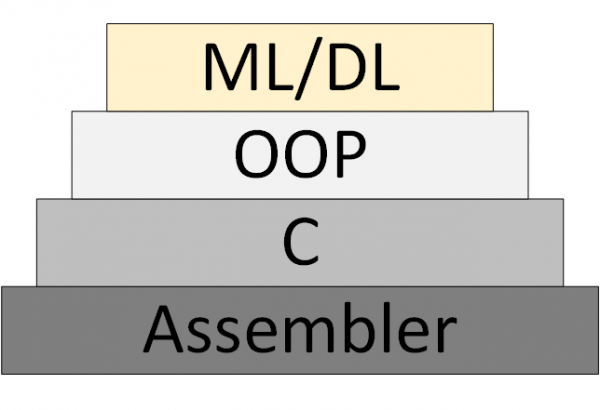
Figur 3 – ML/DL som en ny metodologi for programmering
Men der er stadig ikke dukket op «teorien om neurale netværk», inden for hvilken man kan tænke og arbejde systematisk. Det, der i øjeblikket kaldes «teori», er faktisk eksperimentelle, heuristiske algoritmer.
Links til mine og andre ressourcer:
- Nyhedsbrev om Data Science. For det meste om billedbehandling. Hvis nogen ønsker at modtage, så send venligst en e-mail (foobar167<snak-snakk>gmail<punkt>com). Links til artikler og videoer sendes, efterhånden som materialet hober sig op.
- Generel , som jeg har gennemført og som jeg gerne ville tage.
- , som man bør starte med at studere neurale netværk. Plus en brochure .
- , hvor alle kan finde noget interessant for sig selv.
- Det var yderst nyttigt, videokanaler om gennemgang af videnskabelige artikler inden for Data Science. Find dem, abonner på dem, og del linksene med dine kolleger og mig også. Eksempler på disse er:
- aka med trin-for-trin instruktioner og åben kildekode.
Tak for din opmærksomhed!
Kilde: habr.com
