

Vi har vellykket designet strukturen af vores PostgreSQL-database til opbevaring af korrespondance, og nu, et år senere, fylder brugerne aktivt i den, så der er allerede millioner af poster, og… noget begynder at hakke.
- Del 2: sektionering "live"
Sagen er den, at med væksten i tabellens størrelse vokser også "dybden" af indeksene — selvom det er logaritmisk. Men over tid tvinger dette serveren til at behandle mange flere datablade, end i starten.
Her kommer partitionering.
Jeg bemærker, at jeg ikke taler om sharding, dvs. fordeling af data mellem forskellige databaser eller servere. For selvom du deler dataene på flere serverne, vil du ikke slippe af med problemet med "oppustede" indekser over tid. Det er klart, at hvis du har råd til at sætte en ny server i drift hver dag, vil dine problemer ligge på et helt andet niveau end den specifikke database.
Vi vil ikke se på specifikke scripts til at implementere partitionering "i hardwaren", men snarere på tilgangen — hvad og hvordan man skal "skære i skiver", og hvad en sådan ønsket effekt fører til.
Konceptet
Lad os endnu engang definere vores mål: vi ønsker at sikre, at mængden af læsbare PostgreSQL-data for enhver læse-/skrivningsoperation forbliver nogenlunde den samme, både i dag, i morgen og om et år.
For enhver kronologisk akkumulere data (beskeder, dokumenter, logfiler, arkiver, …) er den naturlige valg som partitioneringsnøgle dato/tidspunkt for begivenheden. I vores tilfælde er en sådan begivenhed tidspunktet for afsendelse af beskeden.
Vi bemærker, at brugere næsten altid kun arbejder med "de seneste" sådanne data — de læser de seneste beskeder, analyserer de seneste logfiler,… Nej, de kan selvfølgelig også bladre længere tilbage i tiden, men de gør det meget sjældent.
Ud fra disse begrænsninger bliver det indlysende, at den optimale løsning for beskeder vil være "dagsbaserede" sektioner — for næsten altid vil vores bruger læse det, som kom til ham "i dag" eller "i går".
Hvis vi i løbet af dagen skriver og læser næsten udelukkende i én sektion, giver det os også en mere effektiv udnyttelse af hukommelse og disk — da alle indekser i sektionen let kan passe i RAM, i modsætning til "store og fedtede" over hele tabellen.
trinvise
Generelt lyder alt det ovenstående som én stor profit. Og den er opnåelig, men for det kræver det, at vi gør en stor indsats – fordi beslutningen om at sektionere en af enhederne fører til behovet for at »opdele« også de relaterede.
Besked, dens egenskaber og projektioner
Når vi har besluttet at opdele beskeder efter datoer, giver det også mening at dele de afhængige egenskaber (vedhæftede filer, liste over modtagere) og også efter beskedens dato.
Da en af vores typiske opgaver netop er at gennemgå registrene for beskeder (ulæste, indgående, alle), er det også logisk at »trække« dem ind i sektioneringen efter beskedernes datoer.
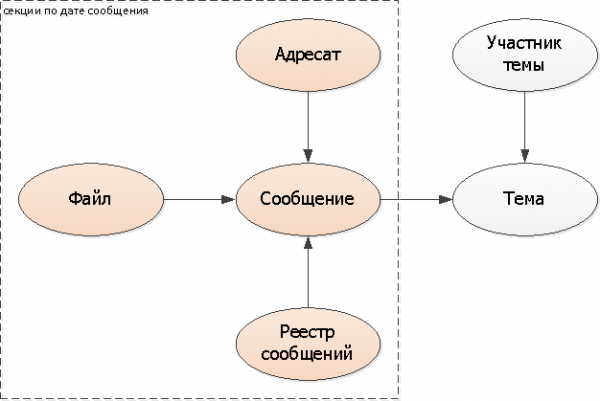
Vi tilføjer sektioneringsnøglen (beskedens dato) til alle tabeller: modtagere, fil, registre. I selve beskeden kan man undlade at tilføje det og bruge eksisterende DatoTid.
Temaer
Da emnet er det samme for flere beskeder, kan vi ikke »opdele« det i den samme model, det er nødvendigt at basere sig på noget andet. I vores tilfælde passer det perfekt den første besked i korrespondancen – altså tidspunktet for oprettelsen af emnet.
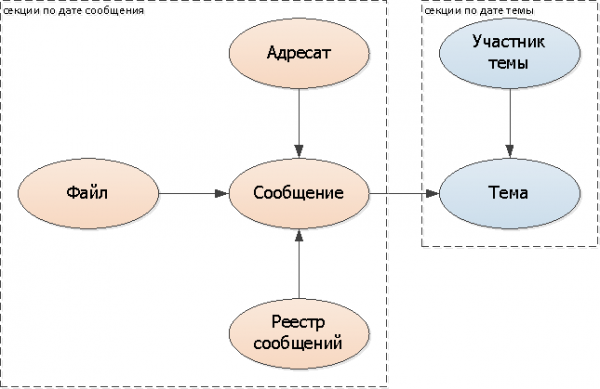
Vi tilføjer sektioneringsnøglen (emnets dato) til alle tabeller: emne, deltager.
Men nu opstår der straks to problemer:
- hvilken sektion skal vi søge beskeder efter emne?
- hvilken sektion skal vi søge emnet fra beskeden?
Man kan selvfølgelig fortsætte med at lede i alle sektioner, men det vil være meget trist og vil annullere alle vores gevinster. Derfor, for at vide, hvor vi konkret skal lede, laver vi logiske links/referencer til sektionerne:
- vi tilføjer i beskeden et felt med emnets dato
- til emnet tilføjer vi sættet af besked datoer for denne korrespondance (kan gøres som en separat tabel eller som et array af datoer)
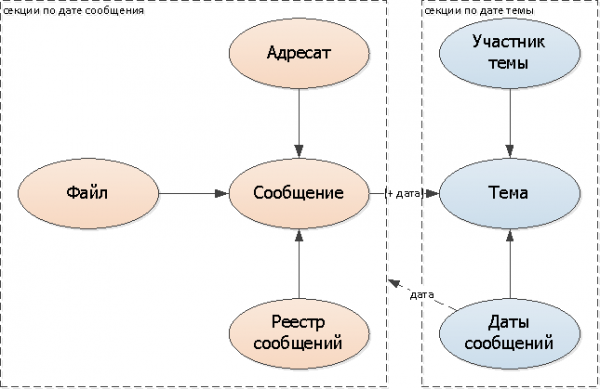
Da modifikationerne af listen over besked datoer for hver enkelt korrespondance vil være få (næsten alle beskeder falder i 1-2 nærliggende dage), vil jeg stoppe op med denne løsning.
I alt har strukturen af vores database taget følgende form under hensyntagen til sektioneringen:
Tabeller : RU, ved modvilje mod kyrillik i tabeller/kolonner, er det bedst ikke at se
-- sektioner efter beskeddato
CREATE TABLE "Besked_YYYYMMDD"(
  "Besked"
    uuid
      PRIMARY KEY
, "Emne"
    uuid
, "DatoEmne"
    date
, "Forfatter"
    uuid
, "DatoTid" -- bruges som dato
    timestamp
, "Tekst"
    text
);

CREATE TABLE "Modtager_YYYYMMDD"(
  "DatoBesked"
    date
, "Besked"
    uuid
, "Person"
    uuid
, PRIMARY KEY("Besked", "Person")
);

CREATE TABLE "Fil_YYYYMMDD"(
  "DatoBesked"
    date
, "Fil"
    uuid
      PRIMARY KEY
, "Besked"
    uuid
, "BLOB"
    uuid
, "Navn"
    text
);

CREATE TABLE "RegistreringsBeskeder_YYYYMMDD"(
  "DatoBesked"
    date
, "Ejer"
    uuid
, "RegistreringsType"
    smallint
, "DatoTid"
    timestamp
, "Besked"
    uuid
, PRIMARY KEY("Ejer", "RegistreringsType", "Besked")
);
CREATE INDEX ON "RegistreringsBeskeder_YYYYMMDD"("Ejer", "RegistreringsType", "DatoTid" DESC);

-- sektioner efter emnedato
CREATE TABLE "Emne_YYYYMMDD"(
  "DatoEmne"
    date
, "Emne"
    uuid
      PRIMARY KEY
, "Dokument"
    uuid
, "Titel"
    text
);

CREATE TABLE "DeltagerEmne_YYYYMMDD"(
  "DatoEmne"
    date
, "Emne"
    uuid
, "Person"
    uuid
, PRIMARY KEY("Emne", "Person")
);

CREATE TABLE "DatoerBeskederEmne_YYYYMMDD"(
  "DatoEmne"
    date
, "Emne"
    uuid
      PRIMARY KEY
, "Dato"
    date
);
Sparer en lille skilling
Men hvis vi ikke bruger den baseret på værdifordeling af feltet (gennem triggers og arv eller PARTITION BY), men "manuelt" på applikationsniveau, så kan man bemærke, at værdien af partitioneringsnøglen allerede opbevares i selve tabelnavnet.
Så hvis du er så bekymret for mængden af opbevarede data, kan disse "overflødige" felter også fjernes, og man kan henvende sig direkte til specifikke tabeller. Dog må alle forespørgsler fra flere sektioner i dette tilfælde så udføres på applikationssiden.
Kilde: habr.com
