

Den 9. januar blev Pandas 1.0.0rc udgivet. Den tidligere version af biblioteket var 0.25.
Den første større udgivelse indeholder mange fantastiske nye funktioner, herunder forbedret automatisk summering af dataframes, flere outputformater, nye datatyper og endda et nyt dokumentationssite.
Alle ændringer kan ses , i artiklen vil vi dog begrænse os til en kortere, mindre teknisk oversigt over de vigtigste punkter.
Biblioteket kan installeres som vanligt med pip, men da Pandas 1.0 stadig er release candidate, skal versionen angives tydeligt:
pip install --upgrade pandas==1.0.0rc0Vær forsigtig: da dette er en major release, kan opdateringen bryde gammel kode!
For resten er understøttelsen af Python 2 helt ophørt med denne version (hvilket kan være en god anledning til — bemærk fra overs.). Pandas 1.0 kræver mindst Python 3.6+, så hvis du er i tvivl, så tjek hvilken version du har installeret:
$ pip --version
pip 19.3.1 fra /usr/local/lib/python3.7/site-packages/pip (python 3.7)

$ python --version
Python 3.7.5
Det er nemmest at tjekke Pandas versionen sådan her:
>>> import pandas as pd
>>> pd.__version__
1.0.0rc0
Forbedret automatisk summering med DataFrame.info
Min yndlingsnyhed er opdateringen af metoden DataFrame.info. Funktionen er blevet meget mere læsbar, hvilket gør dataundersøgelsen endnu lettere:
>>> df = pd.DataFrame({
...:   'A': [1,2,3],
...:   'B': ["farvel", "grusom", "verden"],
...:   'C': [False, True, False]
...:})
>>> df.info()

RangeIndex: 3 entries, 0 to 2
Data columns (total 3 columns):
 #   Column  Non-Null Count  Dtype
---  ------  --------------  -----
 0   A       3 non-null      int64
 1   B       3 non-null      object
 2   C       3 non-null      object
dtypes: int64(1), object(2)
memory usage: 200.0+ bytes
Output af tabeller i Markdown-format
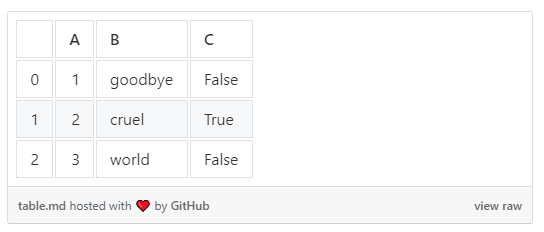
En anden positiv nyhed er muligheden for at eksportere dataframes til Markdown-tabeller ved hjælp af DataFrame.to_markdown.
>>> df.to_markdown()
|    |   A | B       | C     |
|---:|----:|:--------|:------|
|  0 |   1 | farvel  | False |
|  1 |   2 | grusom  | True  |
|  2 |   3 | verden   | False |
Dette forenkler betydeligt publiceringen af tabeller på websteder som Medium ved hjælp af GitHub gists.
Nye typer for strenge og booleske værdier
I Pandas 1.0 er der også blevet tilføjet nye eksperimentelle typer. Deres API kan stadig ændre sig, så brug dem med forsigtighed. Generelt anbefaler Pandas at bruge de nye typer overalt, hvor det giver mening.
Indtil videre skal konverteringen udføres eksplicit:
>>> B = pd.Series(["goodbye", "cruel", "world"], dtype="string")
>>> C = pd.Series([False, True, False], dtype="bool")
>>> df.B = B, df.C = C
>>> df.info()

RangeIndex: 3 entries, 0 to 2
Data columns (total 3 columns):
 #   Column  Non-Null Count  Dtype
---  ------  --------------  -----
 0   A       3 non-null      int64
 1   B       3 non-null      string
 2   C       3 non-null      bool
dtypes: int64(1), object(1), string(1)
memory usage: 200.0+ bytes
Vær opmærksom på, hvordan kolonnen Dtype viser nye typer — string og bool.
Den mest nyttige funktion ved den nye strengtype er muligheden for at vælge kun strengkolonner fra dataframes. Dette kan væsentligt forenkle analysen af tekstdata:
df.select_dtypes("string")Tidligere kunne strengkolonner ikke vælges uden at angive navne eksplicit.
Du kan læse mere om de nye typer .
Tak fordi du læste med! Den komplette liste over ændringer kan ses som nævnt .
Kilde: habr.com
