

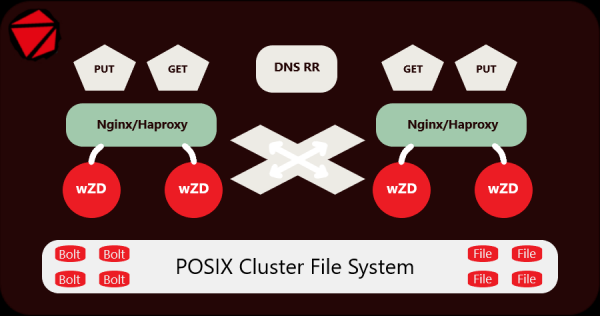
Kære fællesskab, denne artikel vil fokusere på effektiv opbevaring og udlevering af hundredvis af millioner små filer. På nuværende tidspunkt præsenteres der en endelig løsning for POSIX-kompatible filsystemer med fuld understøttelse af låse, herunder klyngelåse, og angiveligt uden brug af hurtigfikser.
Derfor har jeg skrevet min egen specialiserede server til dette formål.
Under implementeringen af denne opgave lykkedes det at løse det primære problem og samtidig opnå besparelser på diskplads og RAM, som vores klyngedrevne filsystem ellers forbrugte ukontrolleret. En sådan mængde filer er skadelig for ethvert klyngedrevet filsystem.
Idéen er sådan:
Kort sagt, små filer uploades via serveren, de gemmes direkte i arkivet og læses også derfra, mens store filer placeres ved siden af. Skema: 1 mappe = 1 arkiv, hvilket resulterer i flere millioner arkiver med små filer i stedet for flere hundrede millioner filer. Og alt dette er implementeret fuldstændigt, uden brug af scripts eller opdeling af filer i tar/zip-arkiver.
Jeg vil forsøge at være kortfattet, og jeg beklager på forhånd, hvis indlægget bliver omfangsrigt.
Det hele startede med, at jeg ikke kunne finde en passende server i verden, der kunne gemme data modtaget via HTTP-protokollen direkte i arkiver, så der ikke ville være ulemper forbundet med almindelige arkiver og objektlagre. Årsagen til søgningen var en oprindelig klynge bestående af 10 servere, der voksede sig stor, og som allerede havde samlet 250.000.000 små filer, og tendensen til vækst skulle ikke stoppe.
Til dem, der ikke kan lide at læse artikler, er her en kortere dokumentation:
og .
Og Docker samtidig, der er i øjeblikket kun en mulighed for dette med Nginx indeni for sikkerheds skyld:
docker run -d --restart=always -e host=localhost -e root=\/var\/storage
-v \/var\/storage:\/var\/storage --name wzd -p 80:80 eltaline\/wzd
Næste:
Hvis der er mange filer, kræves der betydelige ressourcer, og det mest frustrerende er, at en del af dem går til spilde. For eksempel, ved brug af et klyngesystem til filhåndtering (i dette tilfælde - MooseFS), optager en fil, uanset dens faktiske størrelse, altid minimum 64 KB. Det betyder, at for filer på 3, 10 eller 30 KB, kræves der stadig 64 KB plads på disken. Hvis der er en kvart milliard filer, mister vi mellem 2 til 10 terabyte. Det vil ikke være muligt uendeligt at oprette nye filer, da der i MooseFS er en grænse: højst 1 milliard med én kopi af hver fil.
Efterhånden som antallet af filer stiger, kræves der meget RAM til metadataene. Hyppige store dumps af metadata bidrager også til slid på SSD-diskene.
Server wZD. Vi rydder op på diskene.
Serveren er skrevet i Go. Først og fremmest havde jeg brug for at reducere antallet af filer. Hvordan gør man det? Ved at arkivere, men i dette tilfælde uden kompression, da mine filer er fuldstændig komprimerede billeder. BoltDB kom til hjælp, som jeg også måtte rette nogle mangler ved, hvilket er beskrevet i dokumentationen.
I alt er der i mit tilfælde kun blevet 10 millioner Bolt-arkiver tilbage i stedet for en kvart milliard filer. Hvis jeg havde mulighed for at ændre den nuværende struktur for udfyldning af mapper med filer, kunne man måske reducere det til cirka 1 million filer.
Alle små filer pakkes i Bolt-arkiver, som får navne automatisk baseret på de mapper, de ligger i, mens alle store filer forbliver tæt på arkiverne; det giver ikke mening at pakke dem, og det er konfigurerbart. Små filer arkiveres, store filer forbliver uændrede. Serveren fungerer problemfrit med både typer.
Arkitektur og funktioner af serveren wZD.
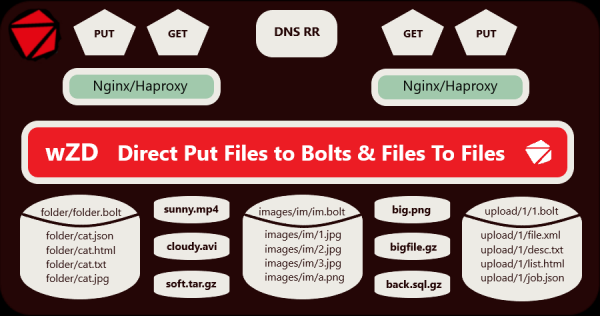
Serveren fungerer under styresystemerne Linux, BSD, Solaris og OSX. Jeg har kun testet det for AMD64-arkitekturen under Linux, men det burde også fungere for ARM64, PPC64, MIPS64.
Hovedfunktionerne:
- Multitrådning;
- Multiserveropsætning, der sikrer fejl tolerance og belastningsbalancering;
- Maksimal gennemsigtighed for brugerne eller udvikleren;
- Understøttede HTTP-metoder: GET, HEAD, PUT og DELETE;
- Styring af adfærd ved læsning og skrivning gennem klientoverskrifter;
- Understøttelse af fleksibelt konfigurerbare virtuelle værter;
- Understøttelse af CRC-integritet ved skrivning/læsning;
- Halvdynamiske buffere for minimal hukommelsesforbrug og optimal justering af netværksydelse;
- Forsinket komprimering af data;
- Der tilbydes desuden en multitrådet arkiveringsløsning wZA til migrering af filer uden nedetid for tjenesten.
Reelle erfaringer:
Jeg har udviklet og testet serveren og arkivsystemet med live data i et stykke tid, og det fungerer nu tilfredsstillende på et cluster bestående af 250.000.000 små filer (billeder) placeret i 15.000.000 mapper på forskellige SATA-diske. Clusteren bestående af 10 servere fungerer som en origin-server, der er placeret bag et CDN-netværk. Til betjening bruges 2 Nginx-servere + 2 wZD-servere.
For dem, der overvejer at bruge denne server, giver det mening at planlægge mappestrukturen på forhånd, hvis det er relevant. Jeg skal straks sige, at serveren ikke er beregnet til at putte alt i ét Bolt-arkiv.
Ydelsestest:
Jo mindre størrelsen på den arkiverede fil er, desto hurtigere udføres GET- og PUT-operationer på den. Lad os sammenligne den samlede tid til at skrive via HTTP-klienter til almindelige filer og Bolt-arkiver, samt læsning. Der sammenlignes arbejde med filer af størrelserne 32 KB, 256 KB, 1024 KB, 4096 KB og 32768 KB.
Når der arbejdes med Bolt-arkiver, kontrolleres dataintegriteten for hver fil (CRC anvendes), der sker aflæsning on-the-fly før og efter skrivning, og dette medfører naturligvis forsinkelser, men det vigtigste er datasikkerheden.
Jeg udførte ydelsestests på SSD-drev, da tester på SATA-diske ikke viste nogen klar forskel.
Diagrammer baseret på testresultater:
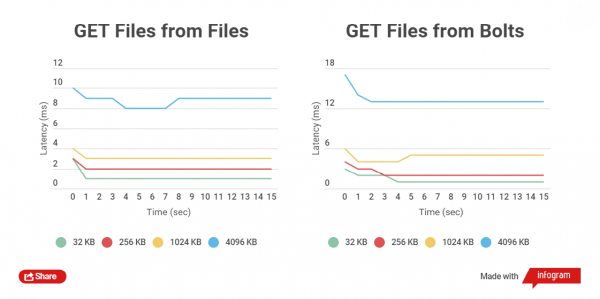
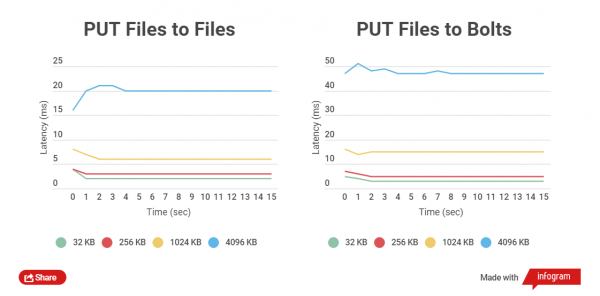
Som det fremgår, er forskellen i tid til læsning og skrivning mellem arkiverede og ikke-arkiverede filer ubetydelig for små filer.
Vi får et helt andet billede ved testen af læsning og skrivning af filer på 32 MB:
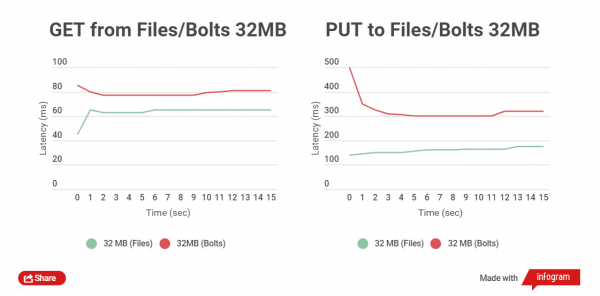
Forskellen i tid mellem læsning af filer er mellem 5-25 ms. Med skrivning ser det værre ud, forskellen er omkring 150 ms. Men i dette tilfælde er det ikke nødvendigt at uploade store filer; det giver simpelthen ikke mening, de kan eksistere separat fra arkiverne.
*Teknisk set kan denne server også bruges til opgaver, der kræver NoSQL.
De grundlæggende metoder til arbejde med wZD-serveren:
Upload af en almindelig fil:
curl -X PUT --data-binary @test.jpg http://localhost/test/test.jpgUpload af en fil til et Bolt-arkiv (hvis serverparameteren fmaxsize, der bestemmer den maksimale størrelse på en fil, der kan inkluderes i arkivet, ikke overskrides, ellers vil filen blive uploadet normalt ved siden af arkivet):
curl -X PUT -H "Archive: 1" --data-binary @test.jpg http://localhost/test/test.jpgHentning af filen (hvis der er filer med samme navn på disken og i arkivet, gives der som standard prioritet til filen, der ikke er komprimeret):
curl -o test.jpg http://localhost/test/test.jpgTvangsmæssig hentning af fil fra Bolt-arkiv:
curl -o test.jpg -H "FromArchive: 1" http://localhost/test/test.jpgBeskrivelse af andre metoder findes i dokumentationen.
Serveren understøtter kun HTTP-protokollen i øjeblikket; HTTPS fungerer endnu ikke. POST-metoden understøttes heller ikke (det er stadig ikke afklaret, om det er nødvendigt).
Den, der graver i kildekoden, vil finde et slik, ikke alle kan lide det, men jeg har ikke bundet hovedkoden til webframeworkets funktioner, bortset fra behandleren for afbrydelser, så jeg kan hurtigt omskrive til næsten enhver motor senere.
ToDo:
- Udvikling af en egen replikator og distributør + geo for mulighed for brug i store systemer uden kluster-FS (alt sammen professionelt)
- Mulighed for fuld reversibel gendannelse af metadata ved fuld tab (ved brug af distributør)
- Nativ protokol for mulighed for brug af permanente netværksforbindelser og drivere til forskellige programmeringssprog
- Udvidede muligheder for brug af NoSQL komponenten
- Komprimering af forskellige typer (gzip, zstd, snappy) for filer eller værdier inden for Bolt-arkiver og for almindelige filer
- Kryptering af forskellige typer for filer eller værdier inden for Bolt-arkiver og for almindelige filer
- Forsinket server video konvertering, inklusiv på GPU
Det var alt, jeg håber denne server vil være nyttig for nogen, BSD-3 licens, dobbelt copyright, da jeg ikke ville have skrevet serveren, hvis ikke for virksomheden, hvor jeg arbejder. Jeg er udvikler i ental. Jeg ville sætte pris på at få rapporteret fejl og funktionsanmodninger.
Kilde: habr.com
