

Hej alle sammen! Jeg er backend-udvikler, jeg skriver mikrotjenester i Java + Spring. Jeg arbejder i et af udviklingsteams, der udvikler interne produkter i Tinkoff.
I vores team opstår spørgsmålet om optimering af forespørgsler i DBMS ofte. Man ønsker altid at være lidt hurtigere, men man kan ikke altid nøjes med gennemtænkte indekser — man bliver nødt til at finde alternative løsninger. Under et af sådanne søgninger efter rimelige optimeringer til arbejdet med databaser, fandt jeg , forfatter af bogen SQL Performance Explained. Det er den slags sjældne blog, hvor man kan læse alle artikler i rækkefølge.
Jeg vil oversætte en lille artikel af Markus for jer. Den kan kaldes en form for manifest, der søger at henlede opmærksomheden på det gamle, men stadig aktuelle problem med ydeevnen ved offset-operationen i SQL-standarden.
I nogle steder vil jeg tilføje forfatterens forklaringer og bemærkninger. Alle sådanne steder vil jeg markere som «præm.» for større klarhed.
En lille introduktion
Jeg tror, mange ved, hvor problematisk og langsom arbejdet med paginerede selects via offset kan være. Men ved du, at det ret enkelt kan erstattes med en mere effektiv konstruktion?
Så, det nøgleord offset angiver, at databasen skal springe de første n poster over i forespørgslen. Men databasen skal stadig læse disse første n poster fra disken i den angivne rækkefølge (præm.: anvende sortering, hvis det er angivet), og først derefter vil det være muligt at returnere posterne, der begynder fra n+1 og videre. Det mest interessante er, at problemet ikke ligger i den specifikke implementering i DBMS, men i den oprindelige definition ifølge standarden:
…the rows are first sorted according to the and then limited by dropping the number of rows specified in the from the beginning…
-SQL:2016, Part 2, 4.15.3 Derived tables (præm.: lige nu den mest anvendte standard)
Den nøglepunkt her er, at offset tager et enkelt parameter — antallet af poster, der skal springes over, og alt. Ved at følge sådan en definition kan DBMS kun hente alle poster, og derefter smide unødvendige væk. Det er åbenlyst, at sådan en definition af offset tvinger til unødvendigt arbejde. Og det er ikke engang vigtigt, om det er SQL eller NoSQL.
Endnu lidt smerte
Offset-problemerne stopper ikke her, og det er derfor. Hvis en anden operation indsætter en ny post mellem læsning af to datasider fra disken, hvad vil der så ske i dette tilfælde?
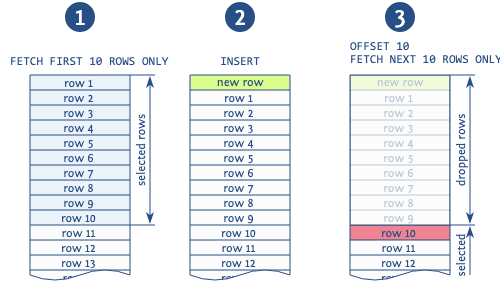
Når der bruges offset til at springe poster over fra tidligere sider, vil man i situationen med at tilføje en ny post mellem læsningen af forskellige sider højst sandsynligt få dubletter (notat: dette kan ske, når vi læser side-for-side med brug af en order by-konstruktion, så en ny post kan ende midt i vores resultat).
Illustrationen viser tydeligt en sådan situation. Databasen læser de første 10 poster, hvorefter der indsættes en ny post, som forskyder alle læste poster med 1. Derefter tager databasen den nye side med de næste 10 poster og begynder ikke med den 11., som den burde, men med den 10., hvilket medfører en dublet. Der er også andre anomalier relateret til brugen af dette udtryk, men denne er den mest almindelige.
Som vi allerede har afdækket, er det ikke et problem for en specifik DBMS eller deres implementeringer. Problemet ligger i definitionen af paginering efter SQL-standarden. Vi beder DBMS'en om at hente en bestemt side eller hvor mange poster der skal sprang over. Databasen har simpelthen ikke mulighed for at optimere en sådan forespørgsel, da den har for lidt information.
Det er også vigtigt at præcisere, at dette problem ikke er relateret til et specifikt nøgleord, men snarere til semantikken i forespørgslen. Der er flere identiske syntakser, der udviser samme problematik:
- Nøgleordet offset, som nævnt tidligere.
- Konstruktionen med to nøgleord limit [offset] (selv om limit i sig selv ikke er så dårlig).
- Filtrering baseret på laveste grænser, bygget på række nummerering (f.eks. row_number(), rownum osv.).
Alle disse udtryk angiver blot, hvor mange rækker der skal springes over, uden yderligere information eller kontekst.
I denne artikel bruges nøgleordet offset som en generalisering af alle disse varianter.
Livet uden OFFSET
Og nu forestil dig, hvordan vores verden ville se ud uden alle disse problemer. Tilsyneladende er livet uden offset ikke så kompliceret: man kan vælge de rækker, vi endnu ikke har set med en select (notat: det vil sige dem, der ikke var på den forrige side), ved hjælp af en betingelse i where.
I dette tilfælde tager vi udgangspunkt i det faktum, at selects udføres over en sorteret samling (den gamle gode order by). Da vi har en sorteret samling, kan vi anvende en ret simpel filter for kun at hente de data, der ligger bag den sidste post fra den forrige side:
    SELECT ...
    FROM ...
    WHERE ...
    AND id < ?last_seen_id
    ORDER BY id DESC
    FETCH FIRST 10 ROWS ONLY
Og det er hele princippet i denne tilgang. Selvfølgelig bliver det mere interessant, når der sorteres efter flere kolonner, men idéen er den samme. Det er vigtigt at bemærke, at denne konstruktion er anvendelig mange steder -løsninger.
Denne tilgang kaldes seek method eller keyset pagination. Den løser problemet med flydende resultater (bemærk: situationen med poster mellem sideindlæsninger, beskrevet tidligere) og, som vi alle elsker, fungerer hurtigere og mere stabilt end klassisk offset. Stabiliteten ligger i, at behandlingstiden for forespørgslen ikke stiger proportionelt med nummeret på den anmodede tabel (bemærk: hvis du ønsker at vide mere om forskellige tilgange til pagination, kan du . Der kan du også finde sammenlignende benchmarks for forskellige metoder).
Et af diasene , at pagination efter nøgler, naturligvis, ikke er almægtig — den har sine begrænsninger. Den mest væsentlige er, at den ikke har mulighed for at læse tilfældige sider (bemærk: ikke-sekventielt). Men i en tid med uendelig scrolling (bemærk: på frontend) er det ikke et så stort problem. At angive sidetallet for klik - er i hvert fald en dårlig løsning ved UI-udvikling (bemærk: forfatterens mening).
Og hvad med værktøjerne?
Pagination på nøgler passer ofte ikke på grund af mangel på værktøjsunderstøttelse af denne metode. De fleste udviklingsværktøjer, herunder forskellige frameworks, giver ikke mulighed for at vælge, hvilken metode pagination vil blive udført med.
Situation bliver yderligere kompliceret af, at den beskrevne metode kræver en gennemgående støtte i de anvendte teknologier - fra databasen til udførelsen af AJAX-anmodninger i browseren ved uendelig scrolling. I stedet for blot at angive sidetallet, skal man nu angive et sæt af nøgler for alle sider på en gang.
Antallet af rammer, der understøtter paginering med nøgler, vokser dog gradvist. Her er hvad der findes på nuværende tidspunkt:
- til Java;
- til Ruby;
- og til Django;
- til Python;
- — criteria API til JPA-implementeringer;
- til Perl;
- , мапер для Node.js .
(Bemærk: nogle links blev fjernet, fordi nogle biblioteker ikke var blevet opdateret siden 2017—2018 på tidspunktet for oversættelsen. Hvis du er interesseret, kan du tjekke kilden.)
Lige præcis på dette tidspunkt har jeg brug for din hjælp. Hvis du udvikler eller vedligeholder en ramme, der på nogen måde bruger paginering, beder jeg, jeg opfordrer, jeg beder dig om at gøre nativ støtte til paginering med nøgler. Hvis du har spørgsmål eller har brug for hjælp, vil jeg gerne hjælpe (, , ) (bemærk: baseret på min erfaring med Markus kan jeg sige, at han virkelig er entusiastisk omkring at udbrede dette emne).
Hvis du derimod bruger færdige løsninger, som du mener fortjener at have støtte til paginering med nøgler, så opret en request eller også tilbyd en færdig løsning, hvis det er muligt. Du kan også nævne denne artikel i linket.
Konklusion
Årsagen til, at en så simpel og nyttig tilgang som paginering med nøgler ikke er så udbredt, er ikke, at det er teknisk vanskeligt eller kræver store bestræbelser. Hovedårsagen er, at mange er vant til at se og arbejde med offset – denne tilgang dikteres af selve standarden.
Som konsekvens tænker få på at ændre tilgangen til paginering, og derfor udvikles den værktøjsmæssige støtte fra rammer og biblioteker langsomt. Så hvis du er tilhænger af idéen og målet om offset-fri paginering, så hjælp med at sprede det!
Kilde:
Forfatter: Markus Winand
Kilde: habr.com
