

Denne artikel er en oversættelse af min artikel på Medium — , som viste sig at være ret populær, måske på grund af sin enkelhed. Derfor besluttede jeg at skrive den på dansk og tilføje lidt, så almindelige mennesker, der ikke er eksperter i databehandling, kan forstå, hvad et datalager (DW) er, hvad et Data Lake er, og hvordan de to eksisterer sammen.
Hvorfor ville jeg skrive om Data Lakes? Jeg har arbejdet med data og analyser i over 10 år, og i øjeblikket arbejder jeg bestemt med store data i Amazon Alexa AI i Cambridge, der ligger i Boston, selvom jeg bor på Vancouver Island i Victoria og ofte besøger både Boston, Seattle og Vancouver, og nogle gange endda taler til konferencer i Moskva. Jeg skriver også fra tid til anden, men jeg skriver primært på engelsk, og jeg har allerede skrevet , jeg har også et behov for at dele analyserelaterede trends fra Nordamerika, og jeg skriver nogle gange på .
Jeg har altid arbejdet med datalagre, og siden 2015 har jeg arbejdet intensivt med Amazon Web Services, og jeg er generelt gået over til cloud-analyse (AWS, Azure, GCP). Jeg har overvåget udviklingen af analyse-løsninger siden 2007 og har endda arbejdet hos en leverandør af datalagre, Teradata, og implementeret det i Sberbank, det var dengang Big Data med Hadoop kom frem. Alle begyndte at sige, at æraen for datalagre var forbi, og nu var det hele på Hadoop, og derefter begyndte man at tale om Data Lakes, igen med påstanden om, at nu var datalagerets tid virkelig forbi. Men heldigvis (måske desværre for dem, der tjente mange penge på at sætte Hadoop op) er datalageret ikke forsvundet.
I denne artikel vil vi se på, hvad et Data Lake er. Artiklen er rettet mod mennesker, der har lidt eller ingen erfaring med datalagre.
På billedet er Lake Bled, det er en af mine yndlingssøer, selvom jeg kun har været der én gang, men jeg husker det for livet. Men vi skal tale om en anden type sø — data lake. Måske har mange af jer allerede hørt om dette begreb flere gange, men endnu en definition vil ikke skade.
Først og fremmest er her de mest populære definitioner af Data Lake:
«et filsystem til alle typer rå data, der er tilgængelige for analyse af hvem som helst i organisationen» — Martin Fowler.
«Hvis du tror, at et datavarehus er som en flaske vand — renset, pakket og portioneret til nem forbrug, så er et datalake vores enorme reservoir med vand i sin naturlige tilstand. Brugere kan hente vand til sig selv, dykke ned i dybden og udforske» — James Dickson.
Nu ved vi præcist, at et datalake handler om analyse; det gør det muligt for os at opbevare store mængder data i deres oprindelige form, og vi har nem adgang til dataene.
Jeg elsker ofte at forenkle ting, hvis jeg kan forklare et komplekst begreb med simple ord, så har jeg for mig selv forstået, hvordan det fungerer, og hvad det er nødvendigt for. For eksempel, jeg fandt på at undersøge iPhone i fotogalleriet, og jeg indså, at det er et rigtigt datalake; jeg lavede endda et slide til konferencer:
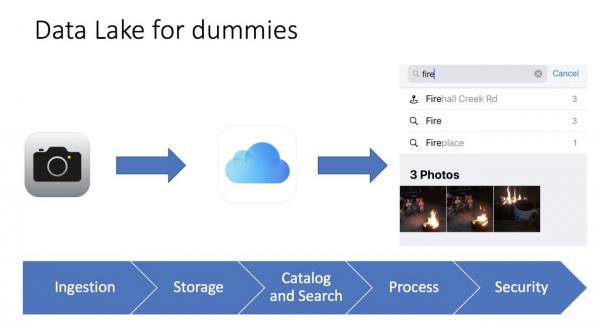
Det er meget enkelt. Vi tager et billede med telefonen, billedet gemmes på telefonen og kan også gemmes i iCloud (cloud-lager). Telefonen indsamler også metadata om billedet: hvad der er afbilledet, geotag, tidspunkt. Som resultat kan vi bruge det praktiske interface på iPhone til at finde vores billede, og vi kan endda se indikatorer; for eksempel når jeg søger efter billeder med ordet ild (fire), finder jeg 3 billeder af et bål. For mig er det ligesom et Business Intelligence-værktøj, der fungerer meget hurtigt og præcist.
Og selvfølgelig må vi ikke glemme sikkerhed (autorisation og autentifikation), ellers kan vores data nemt blive offentliggjort. Der er mange nyheder om store virksomheder og startups, som har fået deres data offentliggjort på grund af udvikleres forsømmelighed og manglende overholdelse af enkle regler.
Selv et så simpelt billede hjælper os med at forstå, hvad et datalake er, dets forskelle fra traditionelle datalagre og dets vigtigste elementer:
- Indlæsning af data (Ingestion) — en nøglekomponent i et datalake. Data kan komme ind i datalageret på to måder — batch (overførsel med intervaller) og streaming (dataflow).
- Cloud-lager (Storage) — hovedkomponenten i Datalake. Vi har brug for, at lageret er let skalerbart, ekstremt pålideligt og omkostningseffektivt. For eksempel er det S3 i AWS.
- Katalog og Søgning (Katalog og søgning) — for at undgå datasyge (som er når vi samler alle data i én bunke, og derefter er det umuligt at arbejde med dem), er vi nødt til at oprette et lag med metadata til klassificering af data, så brugerne nemt kan finde de data, de har brug for til analyse. Derudover kan der anvendes ekstra søgningsløsninger, som for eksempel ElasticSearch. Søgning hjælper brugeren med at finde de nødvendige data gennem en brugervenlig grænseflade.
- Behandling (Proces) — dette skridt ansvarer for behandling og transformation af data. Vi kan transformere data, ændre deres strukturer, rense dem og meget mere.
- Sikkerhed (Sikkerhed) — det er vigtigt at bruge tid på at designe sikkerheden i løsningen. For eksempel kryptering af data under opbevaring, behandling og overførsel. Det er vigtigt at anvende autentificerings- og autorisationsmetoder. Afslutningsvis er et revisionsværktøj nødvendigt.
Fra et praktisk synspunkt kan vi karakterisere datalageret med tre attributter:
- Indsaml og opbevar hvad som helst — datalageret indeholder alle data, både rå, ubehandlede data fra enhver tidsperiode samt behandlede/rensede data.
- Dybtgående analyse — datalageret gør det muligt for brugerne at udforske og analysere data.
- Fleksibel adgang — datalageret giver fleksibel adgang til forskellige data og forskellige scenarier.
Nu kan vi tale om forskellen mellem datalager og datalager. Folk spørger ofte:
- Hvad med datalageret?
- Er vi på vej til at erstatte datalageret med datalageret, eller udvider vi det?
- Kan vi overhovedet klare os uden datalager?
Kort sagt, der er ikke et klart svar. Det afhænger af den specifikke situation, færdighederne i teamet og budgettet. For eksempel migration af datalageret til Oracle i AWS og oprettelse af et datalager af Amazons datterselskab — Woot — .
På den anden side hævder leverandøren Snowflake, at du ikke længere behøver at tænke på datalager, da deres dataplatform (indtil 2020 var det datalager) gør det muligt at kombinere både datalager og datalager. Jeg har arbejdet lidt med Snowflake, og det er virkelig et unikt produkt, der kan gøre det. Prisen er et andet spørgsmål.
Afslutningsvis mener jeg, at vi stadig har behov for et datalager som den primære datakilde til vores rapportering, og alt hvad der ikke passer ind, opbevarer vi i datalaget. Hele formålet med analytik er at give nem adgang til forretningen for at træffe beslutninger. Uanset hvordan man ser på det, arbejder forretningsbrugere mere effektivt med et datalager end med et datalag; for eksempel i Amazon findes der Redshift (et analytisk datalager) og Redshift Spectrum/Athena (SQL-interface til datalaget i S3 baseret på Hive/Presto). Det samme gælder for andre moderne analytiske datalager.
Lad os se på en typisk datalagerarkitektur:
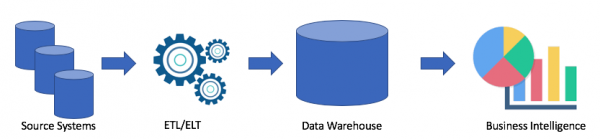
Dette er en klassisk løsning. Vi har kildesystemer, og ved hjælp af ETL/ELT kopierer vi data til det analytiske datalager og forbinder det til Business Intelligence-løsningen (min favorit er Tableau, hvad med din?).
Denne løsning har følgende ulemper:
- ETL/ELT-operationer kræver tid og ressourcer.
- Som regel er opbevaring af data i det analytiske datalager ikke billigt (for eksempel Redshift, BigQuery, Teradata), da vi skal købe et helt cluster.
- Forretningsbrugere har adgang til rensede og ofte aggregerede data, og de har ikke mulighed for at få rå data.
Selvfølgelig afhænger alt af din case. Hvis du ikke har problemer med dit datalager, så har du slet ikke brug for et datalag. Men når der opstår problemer med mangel på plads, kapacitet eller omkostningerne er afgørende, kan det være værd at overveje et datalag. Derfor er datalag meget populært. Her er et eksempel på arkitekturen for et datalag:
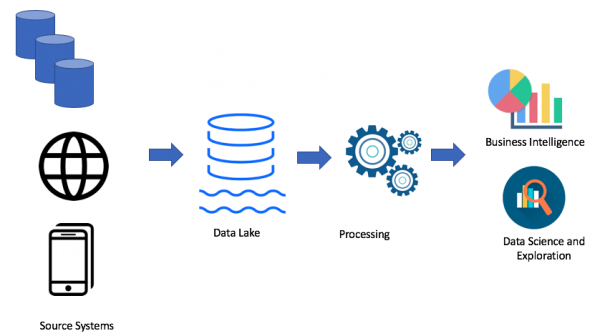
Ved at bruge datalagtilgangen indlæser vi rå data i vores datalag (batch eller streaming), hvorefter vi behandler dataene efter behov. Datalaget giver forretningsbrugere mulighed for at oprette deres egne datatransformationer (ETL/ELT) eller analysere data i Business Intelligence-løsninger (hvis der er den nødvendige driver).
Målet med enhver analytisk løsning er at tjene forretningsbrugerne. Derfor skal vi altid arbejde ud fra forretningskravene. (Hos Amazon er dette et af principperne — working backwards).
Ved at arbejde med både datalager og datalag kan vi sammenligne begge løsninger:
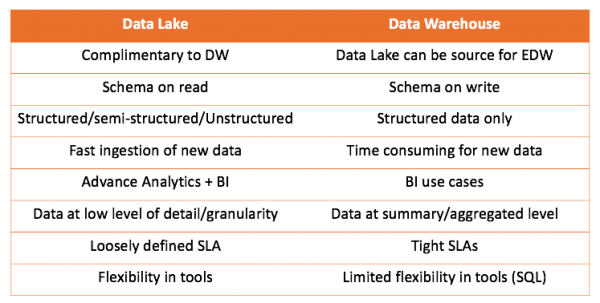
Den vigtigste konklusion, man kan drage, er, at datalagring ikke konkurrerer med datalogen, men snarere supplerer den. Men det er op til dig at beslutte, hvad der passer til dit tilfælde. Det er altid interessant at prøve selv og drage de rigtige konklusioner.
Jeg vil også gerne fortælle om et af de tilfælde, hvor jeg begyndte at bruge dataloge-tilgangen. Det er ret banalt, jeg forsøgte at bruge et ELT-værktøj (vi havde Matillion ETL) og Amazon Redshift; min løsning fungerede, men levede ikke op til kravene.
Jeg havde brug for at tage web-logs, transformere dem og aggregere dem for at levere data til 2 tilfælde:
- Marketingteamet ønskede at analysere bot-aktivitet for SEO
- IT ville gerne se metrikker omkring webstedsydelse
Meget enkle, meget simple logs. Her er et eksempel:
https 2018-07-02T22:23:00.186641Z app/my-loadbalancer/50dc6c495c0c9188
192.168.131.39:2817 10.0.0.1:80 0.086 0.048 0.037 200 200 0 57
"GET https://www.example.com:443/ HTTP/1.1" "curl/7.46.0" ECDHE-RSA-AES128-GCM-SHA256 TLSv1.2
arn:aws:elasticloadbalancing:us-east-2:123456789012:targetgroup/my-targets/73e2d6bc24d8a067
"Root=1-58337281-1d84f3d73c47ec4e58577259" "www.example.com" "arn:aws:acm:us-east-2:123456789012:certificate/12345678-1234-1234-1234-123456789012"
1 2018-07-02T22:22:48.364000Z "authenticate,forward" "-" "-"
En fil vejede 1-4 megabyte.
Men der var én udfordring. Vi havde 7 domæner verden over, og der blev skabt 7000 filer på én dag. Det er ikke så stort, i alt 50 gigabyte. Men størrelsen på vores Redshift-kluster var også lille (4 noder). Indlæsningen af en fil på den traditionelle måde tog ca. et minut. Således blev opgaven ikke løst direkte. Og det var i denne situation, at jeg besluttede at bruge dataloge-tilgangen. Løsningen så omtrent sådan ud:
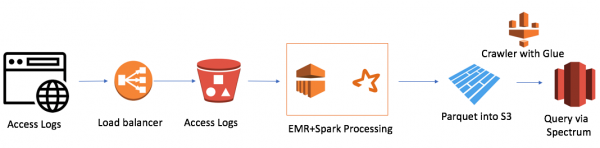
Den er ret simpel (jeg vil bemærke, at fordelen ved at arbejde i skyen er enkeltheden). Jeg brugte:
- AWS Elastic Map Reduce (Hadoop) som beregningskraft
- AWS S3 som filopbevaring med mulighed for datakryptering og adgangsbegrænsning
- Spark som InMemory beregningskraft og PySpark til logik og datatransformation
- Parquet som resultat af Sparks arbejde
- AWS Glue Crawler som metadata indsamler om nye data og partitioner
- Redshift Spectrum som SQL-interface til datalogen for eksisterende Redshift-brugere
Det mindste EMR+Spark-kluster behandlede alle filerne på 30 minutter. Der er også andre tilfælde for AWS, især mange relateret til Alexa, hvor der er meget data.
For nylig blev jeg opmærksom på en af ulemperne ved datalakes – GDPR. Problemet opstår, når en kunde beder om at få sine data slettet, og dataene er gemt i en af filerne, hvor vi ikke kan bruge Data Manipulation Language og DELETE-kommandoen, som vi ville gøre med en database.
Jeg håber, at artiklen har afklaret forskellen mellem datalagre og datalakes. Hvis den var interessant, kan jeg oversætte flere af mine artikler eller artikler fra professionelle skribenter, jeg følger. Jeg kan også fortælle om de løsninger, jeg arbejder med, og deres arkitektur.
Kilde: habr.com
