

For a complete understanding of Kubernetes, one must know various ways to scale cluster resources: according to , this is one of the main tasks of Kubernetes. We have prepared a high-level overview of horizontal and vertical autoscaling mechanisms and resizing clusters, as well as recommendations on how to use them effectively.
The article was translated by the team that implemented autoscaling in .
Why it is important to think about scaling
— a tool for managing resources and orchestration. Of course, it is nice to dabble with cool features of deployment, monitoring, and pod management (a pod is a group of containers launched in response to a request).
However, one should also consider the following questions:
- How to scale modules and applications?
- How to keep containers running and efficient?
- How to respond to constant changes in code and user workloads?
Configuring Kubernetes clusters for resource and performance balancing can be a complex task; it requires expert knowledge of how Kubernetes works internally. The workload on your application or services can fluctuate throughout the day or even within the hour, so it’s best to view balancing as an ongoing process.
Kubernetes Autoscaling Levels
Effective autoscaling requires coordination between two levels:
- The pod level, which includes horizontal (Horizontal Pod Autoscaler, HPA) and vertical autoscaling (Vertical Pod Autoscaler, VPA). This scales existing resources for your containers.
- The cluster level, managed by the cluster autoscaling system (Cluster Autoscaler, CA), which increases or decreases the number of nodes within the cluster.
Horizontal Autoscaler (HPA)
As the name suggests, the HPA scales the number of pod replicas. As triggers for changing the number of replicas, most DevOps use CPU and memory load. However, the system can also be scaled based on , their eller endda .
High-level scheme of how HPA works:
- HPA overvåger kontinuerligt de metrikværdier, der er angivet ved installationen, med en standardinterval på 30 sekunder.
- HPA forsøger at øge antallet af moduler, hvis den angivne grænse er nået.
- HPA opdaterer antallet af repliker inden for deployments-/replikationskontrolleren.
- Deployment-/replikationskontrolleren deployer derefter alle nødvendige ekstra moduler.
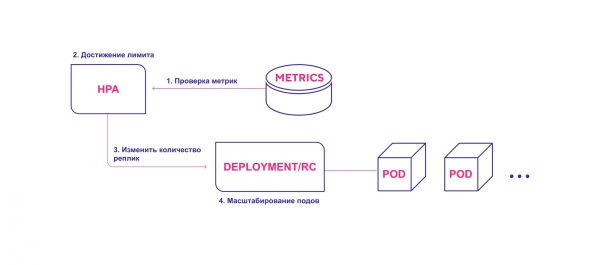
HPA starter udrulningsprocessen for moduler, når metrikgrænsen er nået.
Ved brug af HPA, overvej følgende:
- Den standard HPA-tjekinterval er 30 sekunder. Det er indstillet af flaget horizontal-pod-autoscaler-sync-period i controller manager.
- Den relative fejlmargin er som standard 10%.
- Efter den sidste stigning i antallet af moduler venter HPA på stabilisering af metrikkerne i tre minutter. Dette interval er indstillet af flaget horizontal-pod-autoscaler-upscale-delay.
- Efter den sidste reduktion i antallet af moduler venter HPA på stabilisering i fem minutter. Dette interval er indstillet af flaget horizontal-pod-autoscaler-downscale-delay.
- HPA fungerer bedst med deploymentsobjekter, ikke med replikationskontrollere. Horisontal skalering er ikke kompatibel med rullende opdateringer (rolling updates), som direkte manipulerer replikationskontrollere. Ved deployment afhænger antallet af repliker direkte af deploymentsobjekterne.
Vertikal skalering af pods
Vertikal skalering (VPA) tildeler mere (eller mindre) CPU- eller hukommelsestid til eksisterende pods. Den er velegnet til stateful pod'er eller stateless, men er primært designet til stateful-tjenester. Du kan dog også anvende VPA til stateless-moduler, hvis du har brug for automatisk at justere mængden af oprindeligt tildelte ressourcer.
VPA reagerer også på OOM-begivenheder (out of memory, utilstrækkelig hukommelse). For at ændre CPU-tid og mængden af hukommelse kræves genstart af pods. Ved genstart overholder VPA fordelingsbudgettet (), for at sikre det minimumsbehovte antal moduler.
Du kan angive et minimum og maksimum for ressourcerne for hver modul. For eksempel kan du begrænse den maksimale tildeling af hukommelse til 8 GB. Dette er nyttigt, hvis de nuværende noder ikke kan tildele mere end 8 GB hukommelse til containeren. Detaljerede specifikationer og arbejdsmetoder er beskrevet i .
Desuden har VPA en interessant anbefalingsfunktion (VPA Recommender). Den overvåger ressourceforbruget og OOM-hændelserne for alle moduler for at foreslå nye værdier for hukommelse og CPU-tid baseret på en intelligent algoritme, der tager højde for historiske målinger. Der er også et API, der accepterer en pod-deskriptor og returnerer de foreslåede ressourceværdier.
Det er værd at bemærke, at VPA Recommender ikke overvåger "grænsen" for ressourcer. Dette kan føre til, at et modul monopoliserer ressourcerne inden for noderne. Det er bedre at sætte en grænse i namespace-niveauet for at undgå enorme forbrug af hukommelse eller CPU-tid.
Højniveau diagram over VPA's drift:
- VPA kontrollerer løbende de metrikværdier, der er angivet ved installationen, med en standardinterval på 10 sekunder.
- Hvis den angivne tærskel er nået, forsøger VPA at ændre det tildelte antal ressourcer.
- VPA opdaterer antallet af ressourcer i deployment-/replication-controlleren.
- Når modulerne genstartes, anvendes alle nye ressourcer på de oprettede instanser.
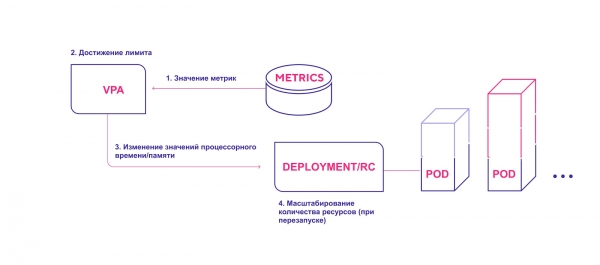
VPA tilføjer det nødvendige antal ressourcer
Overvej følgende punkter, når du bruger VPA:
- Skalering kræver, at pod'en genstartes. Dette er nødvendigt for at undgå ustabil drift efter ændringerne. For pålidelighed genstarter modulerne og distribuerer dem på noderne baseret på de nye tildelte ressourcer.
- VPA og HPA er i øjeblikket ikke kompatible med hinanden og kan ikke køre på de samme pod'er. Hvis du anvender begge skaleringsmekanismer i et enkelt cluster, skal du sikre dig, at indstillingerne ikke tillader dem at aktivere på de samme objekter.
- VPA justerer containeranmodninger om ressourcer baseret udelukkende på tidligere og nuværende brug. Den fastsætter ikke brugslimitter. Der kan opstå problemer med, at applikationer uregelmæssigt begynder at optage flere ressourcer, hvilket vil medføre, at Kubernetes lukker denne pod.
- VPA er stadig i en tidlig udviklingsfase. Vær forberedt på, at systemet kan ændre sig i den nærmeste fremtid. Du kan læse om og . Således er der planer om at implementere samarbejde mellem VPA og HPA samt at implementere moduler sammen med en politik for vertikal autoskalering for dem (f.eks. en speciel etiket 'requires VPA').
Autoskalering af Kubernetes-klynger
Autoskalering af klynger (Cluster Autoscaler, CA) justerer antallet af noder baseret på antallet af ventende pod-moduler. Systemet kontrollerer regelmæssigt for ventende moduler og øger størrelsen på klyngen, hvis der kræves flere ressourcer, og hvis klyngen ikke overstiger de fastsatte grænser. CA interagerer med cloud-udbyderen for at anmode om yderligere noder eller frigive inaktive. Den første offentlige version af CA blev præsenteret i Kubernetes 1.8.
Overordnet arbejdsschema for CA:
- CA tjekker for moduler i ventende tilstand med en standardinterval på 10 sekunder.
- Hvis en eller flere moduler er i ventende tilstand, fordi der ikke er tilstrækkelige tilgængelige ressourcer i klyngen til at fordele dem, forsøger den at forberede en eller flere ekstra noder.
- Når cloud-udbyderen tildeler den nødvendige node, tilsluttes den klyngen og er klar til at betjene pod-moduler.
- Kubernetes-planlæggeren fordeler de ventende moduler til den nye node. Hvis nogle moduler stadig forbliver i ventende tilstand, gentages processen, og der tilføjes nye noder til klyngen.
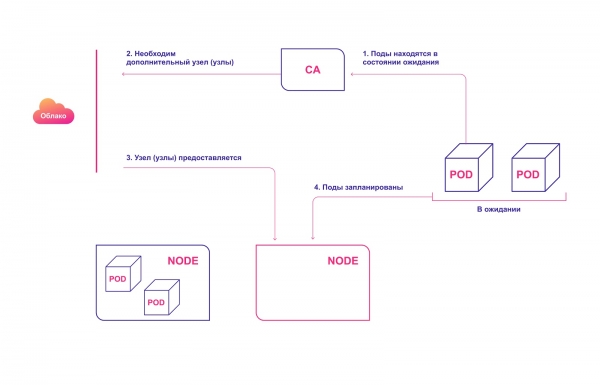
Automatisk tildeling af klynge noder i skyen
Tag hensyn til følgende, når du bruger CA:
- CA sikrer, at alle moduler i klyngen har plads til at køre, uanset belastningsniveauet på processoren. Derudover forsøger det at sikre, at der ikke er unødvendige noder i klyngen.
- CA registrerer behovet for skalering efter cirka 30 sekunder.
- Når en node bliver overflødig, venter CA som standard 10 minutter, før den skalerer systemet.
- I autoskaleringen er der begrebet expanders. Det er forskellige strategier til at vælge en gruppe noder, hvor nye vil blive tilføjet.
- Anvend indstillingen ansvarligt cluster-autoscaler.kubernetes.io/safe-to-evict (true). Hvis du opsætter mange pods, eller hvis mange af dem er spredt over alle noder, vil du i høj grad miste muligheden for at reducere størrelsen af klyngen.
- Brug , for at forhindre fjernelse af pods, som kan få en del af din applikation til at svigte helt.
Hvordan Kubernetes-autoskaleringssystemer interagerer med hinanden
For perfekt harmoni bør autoskaleringsfunktioner anvendes både på pod-niveau (HPA/VPA) og på klynge-niveau. De interagerer relativt let:
- HPA eller VPA opdaterer replikaerne af pods eller ressourcerne tildelt til eksisterende pods.
- Hvis der ikke er nok noder til den planlagte skalering, bemærker CA, at der er pods i ventende tilstand.
- CA tildeler nye noder.
- Modulerne fordeles over de nye noder.
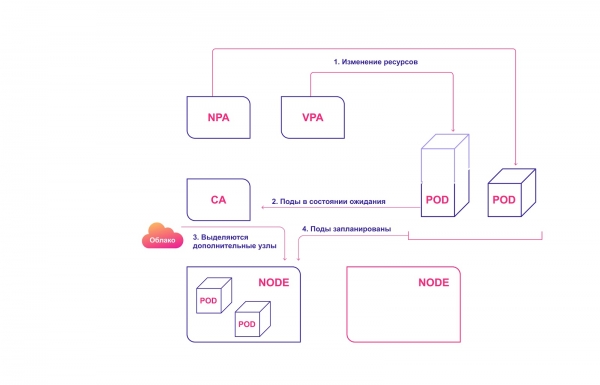
Det fælles system for Kubernetes-skalering
Typiske fejl i Kubernetes-autoskaleringsprocessen
Der er flere typiske problemer, som devops står overfor, når de forsøger at implementere autoskalering.
HPA og VPA er afhængige af metrics og nogle historiske data. Hvis der er tildelt for få ressourcer, vil modulerne blive lukket ned og ikke kunne generere metrics. I dette tilfælde vil autoskaleringsprocessen aldrig finde sted.
Selve skaleringseffekten er tidssensitiv. Vi ønsker, at modulerne og klyngen skaleres hurtigt — inden brugerne bemærker problemer og nedbrud. Derfor skal man tage højde for den gennemsnitlige tid til skalering af pods og klyngen.
Det ideelle scenario er 4 minutter:
- 30 sekunder. Opdatering af målmetrics: 30-60 sekunder.
- 30 sekunder. HPA kontrollerer metricsværdier: 30 sekunder.
- Mindre end 2 sekunder. Pods oprettes og går ind i ventende tilstand: 1 sekund.
- Mindre end 2 sekunder. CA ser de ventende pods og sender anmodninger om at forberede noderne: 1 sekund.
- 3 minutter. Cloud-udbyderen tildeler noder. K8s venter på, at de er klar: op til 10 minutter (afhængig af flere faktorer).
Det værste (mere realistiske) scenarie — 12 minutter:
- 30 sekunder. Opdatering af målmetrics.
- 30 sekunder. HPA tjekker metrikværdier.
- Mindre end 2 sekunder. Pod-modulerne er oprettet og går ind i ventetilstand.
- Mindre end 2 sekunder. CA ser ventende moduler og sender anmodninger om at klargøre noder.
- 10 minutter. Cloud-udbyderen tildeler noder. K8s venter, indtil de er klar. Ventetiden afhænger af flere faktorer, såsom leverandørens latenstid, OS-latenstid og drift af hjælpeværktøjer.
Forveksl ikke cloud-udbydernes skaleringsmekanismer med vores CA. Sidstnævnte arbejder inden for Kubernetes-klyngen, mens cloud-udbyderens mekanisme arbejder på at fordele noder. Den ved ikke, hvad der sker med dine pod'er eller applikationen. Disse systemer arbejder parallelt.
Hvordan man styrer skaleringsprocessen i Kubernetes
- Kubernetes er et værktøj til ressourceforvaltning og orkestrering. Operationerne til forvaltning af pod'er og klynge-ressourcer er en central milepæl i at mestre Kubernetes.
- Forstå logikken bag pod-skalerbarhed med hensyn til HPA og VPA.
- CA skal kun bruges, hvis du forstår behovene for dine pod'er og containere godt.
- For optimal konfiguration af klyngen er det nødvendigt at forstå, hvordan de forskellige skaleringssystemer arbejder sammen.
- Når du vurderer tid til skaleringsprocessen, skal du tage højde for det værste og bedste scenarie.
Kilde: habr.com
