

Periodisk opstår behovet for at finde relaterede data baseret på et sæt nøgler, indtil vi når det nødvendige samlede antal poster..
Et af de mest 'livagtige' eksempler er at trække de 20 ældste opgaver, der er på medarbejderlisten (for eksempel inden for et eneste afdeling). For forskellige ledelsesmæssige 'dashboards' med korte uddrag om arbejdsområder kræves et lignende emne ret ofte.
I denne artikel vil vi se på implementeringen i PostgreSQL af en 'naiv' løsning på dette problem, en 'smartere' og en helt kompleks algoritme af 'cirklen' i SQL med et udgangsbetingelser baseret på de fundne data,som kan være nyttig både til generel læring og til anvendelse i andre lignende situationer.
Lad os tage et testdatasæt fra . For at undgå at de viste poster 'springer' fra gang til gang ved sammenfald af sorterede værdier, udvider vi det emnerelaterede indeks ved at tilføje den primære nøgle,. Dette vil straks give det en unik karakter og garantere os entydigheden af sorteringsrækkefølgen:
CREATE INDEX ON task(owner_id, task_date, id);
-- og vi sletter det gamle
DROP INDEX task_owner_id_task_date_idx;
Som man siger, så skriver man det.
Lad os først skitsere den enkleste forespørgsel ved at videregive ID'erne til udførende :
SELECT
  *
FROM
  task
WHERE
  owner_id = ANY('{1,2,4,8,16,32,64,128,256,512}'::integer[])
ORDER BY
  task_date, id
LIMIT 20; 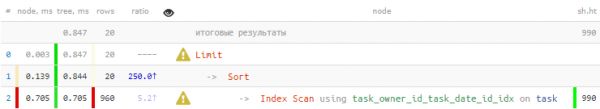
Det er lidt trist - vi bestilte kun 20 poster, men Index Scan returnerede 960 rækker,, som vi også måtte sortere… Lad os prøve at læse færre.
unnest + ARRAY
Den første overvejelse, som kan hjælpe os, er - hvis vi skal have kun 20 sorterede poster, er det nok at læse højst 20 sorterede i den samme rækkefølge for hver nøgle. Heldigvis, har vi det passende indeks (owner_id, task_date, id).
Vi vil bruge den samme mekanisme til at hente og 'vende i kolonner' den whole table record,, som i . Og vi vil også anvende en samling til array med funktionen ARRAY():
WITH T AS (
  SELECT
    unnest(ARRAY(
      SELECT
        t
      FROM
        task t
      WHERE
        owner_id = unnest
      ORDER BY
        task_date, id
      LIMIT 20 -- begrænser her...
    )) r
  FROM
    unnest('{1,2,4,8,16,32,64,128,256,512}'::integer[])
)
SELECT
  (r).*
FROM
  T
ORDER BY
  (r).task_date, (r).id
LIMIT 20; -- ... og her - også 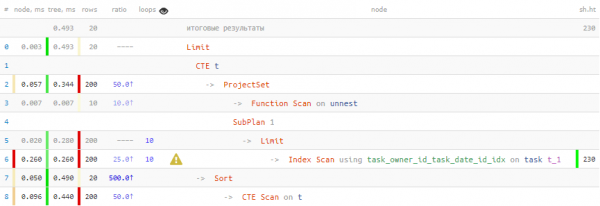
Åh, meget bedre allerede! 40% hurtigere, og 4,5 gange færre data, vi måtte læse.
Materialisering af tabelposter gennem CTEJeg vil påpege, at i nogle tilfælde et forsøg på straks at arbejde med databasens felter efter at have fundet dem i en underforespørgsel, uden "indpakning" i CTE, kan føre til "multiplikation" af InitPlan proportionalt med antallet af netop disse felter:
SELECT
  ((
    SELECT
      t
    FROM
      task t
    WHERE
      owner_id = 1
    ORDER BY
      task_date, id
    LIMIT 1
  ).*);
Resultat (omkostninger=4.77..4.78 rækker=1 bredde=16) (aktuel tid=0.063..0.063 rækker=1 loop=1)
Buffere: shared hit=16
InitPlan 1 (returnerer $0)
-> Limit (omkostninger=0.42..1.19 rækker=1 bredde=48) (aktuel tid=0.031..0.032 rækker=1 loop=1)
Buffere: shared hit=4
-> Index Scanning ved brug af task_owner_id_task_date_id_idx på opgave t (omkostninger=0.42..387.57 rækker=500 bredde=48) (aktuel tid=0.030..0.030 rækker=1 loop=1)
Index Betingelse: (owner_id = 1)
Buffere: shared hit=4
InitPlan 2 (returnerer $1)
-> Limit (omkostninger=0.42..1.19 rækker=1 bredde=48) (aktuel tid=0.008..0.009 rækker=1 loop=1)
Buffere: shared hit=4
-> Index Scanning ved brug af task_owner_id_task_date_id_idx på opgave t_1 (omkostninger=0.42..387.57 rækker=500 bredde=48) (aktuel tid=0.008..0.008 rækker=1 loop=1)
Index Betingelse: (owner_id = 1)
Buffere: shared hit=4
InitPlan 3 (returnerer $2)
-> Limit (omkostninger=0.42..1.19 rækker=1 bredde=48) (aktuel tid=0.008..0.008 rækker=1 loop=1)
Buffere: shared hit=4
-> Index Scanning ved brug af task_owner_id_task_date_id_idx på opgave t_2 (omkostninger=0.42..387.57 rækker=500 bredde=48) (aktuel tid=0.008..0.008 rækker=1 loop=1)
Index Betingelse: (owner_id = 1)
Buffere: shared hit=4"
InitPlan 4 (returnerer $3)
-> Limit (omkostninger=0.42..1.19 rækker=1 bredde=48) (aktuel tid=0.009..0.009 rækker=1 loop=1)
Buffere: shared hit=4
-> Index Scanning ved brug af task_owner_id_task_date_id_idx på opgave t_3 (omkostninger=0.42..387.57 rækker=500 bredde=48) (aktuel tid=0.009..0.009 rækker=1 loop=1)
Index Betingelse: (owner_id = 1)
Buffere: shared hit=4
Den samme post blev "fundet" 4 gange… Indtil PostgreSQL 11 var denne adfærd almindelig, og løsningen var "indpakning" i CTE, som er en ubestridelig grænse for optimereren i disse versioner.
Rekursiv akkumulator
I den forrige version læste vi samlet set 200 rækker for de nødvendige 20. Ikke længere 960, men stadig mindre — kan vi?
Lad os forsøge at udnytte den viden, at vi kun har brug for i alt 20 poster. Det vil sige, at vi kun vil iterere dataindsamlingen indtil det ønskede antal er nået.
Trin 1: startlisten
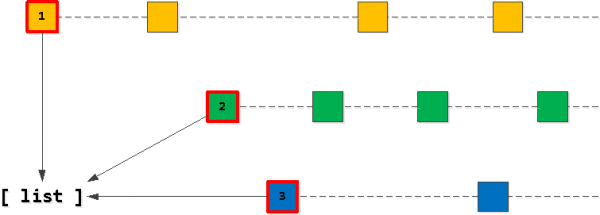
Det er tydeligt, at vores "mål" liste på 20 poster skal starte med "de første" poster baseret på en af vores owner_id-nøgler. Derfor lad os først finde sådanne "de tidligste" for hver af nøglerne og tilføje dem til listen, sorteret i den rækkefølge, vi ønsker — (task_date, id).
Trin 2: finder de "næste" poster
Nu, hvis vi tager den første post fra vores liste og begynder at "træde" videre ind i indekset med bevarelse af owner_id-nøglen, så er alle fundne poster netop de næste i resultatudvalget. Selvfølgelig kun indtil vi krydser den anvendte nøgle den anden post i listen.
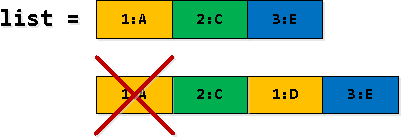
Hvis det er tilfældet, at vi "krydser" den anden post, så den senest læste post skal tilføjes til listen i stedet for den første (med samme owner_id), hvorefter listen igen skal sorteres.
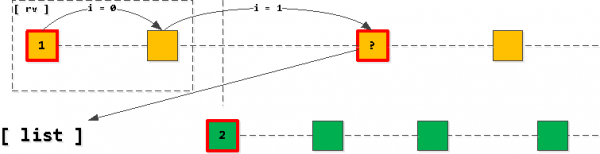
Det vil sige, at vi hele tiden har, at der i listen højst er én post pr. nøgle (hvis postene er udløbet, og vi ikke "krydser", så vil den første post blot forsvinde fra listen, og der tilføjes ikke noget), og de er altid sorteret i stigende rækkefølge efter den anvendte nøgle (task_date, id).
Trin 3: filtrer og "udfold" postene
I nogle rækker af vores rekursive valg filtreres visse post rv dubleres — først finder vi dem, som "krydser grænsen for 2. post i listen", og derefter indsætter vi dem som den 1. i listen. Så det første tilfælde skal filtreres.
Forfærdelig slutforespørgsel
MED REKURSIV T SOM (
  -- #1 : indsætter "de første" poster for hver af nøglerne i sættet
  MED wrap SOM ( -- "materialiserer" posterne, så adgang til felterne ikke forårsager multiplikation af InitPlan/SubPlan
    MED T SOM (
      VÆLG
        (
          VÆLG
            r
          FRA
            task r
          HVOR
            owner_id = unnest
          BESTIL EFTER
            task_date, id
          GRÆNSE 1
        ) r
      FRA
        unnest('{1,2,4,8,16,32,64,128,256,512}'::integer[])
    )
    VÆLG
      array_agg(r BESTIL EFTER (r).task_date, (r).id) liste -- sorterer listen i den ønskede rækkefølge
    FRA
      T
  )
  VÆLG
    liste
  , liste[1] rv
  , FALSE not_cross
  , 0 størrelse
  FRA
    wrap
UNION ALL
  -- #2 : læser posterne i rækkefølge for den første nøgle, indtil vi overskrider den anden
  VÆLG
    SAG
      -- hvis intet blev fundet for nøgle 1. post
      NÅR X._r ER IKKE DISTINKT FRA NULL SÅ
        T.liste[2:] -- fjerner den fra listen
      -- hvis VI IKKE har krydset den anvendte nøgle for 2. post
      NÅR X.not_cross SÅ
        T.liste -- trækker bare den samme liste uden ændringer
      -- hvis der ikke er nogen 2. post i listen
      NÅR T.liste[2] ER NULL SÅ
        -- returnerer bare en tom liste
        '{}'
      -- sorter ordbogen om, fjern 1. post og tilføj den sidste fundne
      ELLERS (
        VÆLG
          coalesce(T.liste[2] || array_agg(r BESTIL EFTER (r).task_date, (r).id), '{}')
        FRA
          unnest(T.liste[3:] || X._r) r
      )
    SLUT
  , X._r
  , X.not_cross
  , T.størrelse + X.not_cross::integer
  FRA
    T
  , LATERAL(
      MED wrap SOM ( -- "materialiserer" posten
        VÆLG
          SAG
            -- hvis vi faktisk "har overskredet" 2. posten
            NÅR IKKE T.not_cross
              -- så er den nødvendige post - den første fra listen
              SÅ T.liste[1]
            ELLERS ( -- hvis vi ikke er krydset, er nøglen forblevet som i den Forrige post - vi baserer os på den
              VÆLG
                _r
              FRA
                task _r
              HVOR
                owner_id = (rv).owner_id OG
                (task_date, id) > ((rv).task_date, (rv).id)
              BESTIL EFTER
                task_date, id
              GRÆNSE 1
            )
          SLUT _r
      )
      VÆLG
        _r
      , SAG
          -- hvis 2. posten allerede ikke er i listen, men vi har fundet noget
          NÅR liste[2] ER NULL OG _r ER IKKE DISTINKT FRA NULL SÅ
            TRUE
          ELLERS -- intet fundet eller "har krydset"
            coalesce(((_r).task_date, (_r).id) < ((liste[2]).task_date, (liste[2]).id), FALSE)
        SLUT not_cross
      FRA
        wrap
    ) X
  HVOR
    T.størrelse < 20 OG -- begrænser her antal
    T.liste ER IKKE DISTINKT FRA '{}' -- eller indtil listen er slut
)
-- #3 : "udfolder" posterne - rækkefølgen er garanteret ved konstruktion
VÆLG
  (rv).*
FRA
  T
HVOR
not_cross; -- tager kun "ikke-krydsende" poster 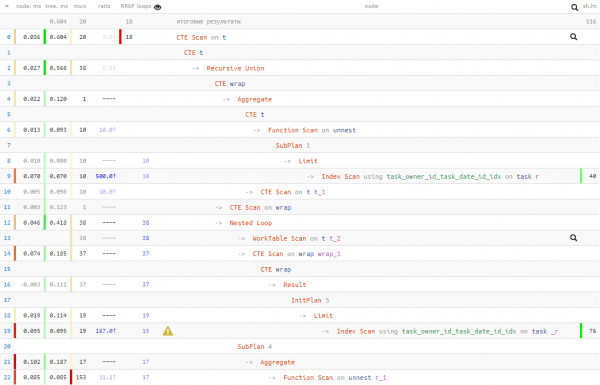
Således har vi byttet 50% af datalæsningsbehovet ud med 20% af udførelsestid. Det vil sige, at hvis du har grund til at tro, at læsning kan tage lang tid (for eksempel hvis dataene ofte ikke er i cachen, og du er nødt til at hente dem fra disken), kan du være mindre afhængig af læsning på denne måde.
Under alle omstændigheder blev udførelsestiden bedre end i den 'naive' første version. Men hvilken af disse 3 varianter du skal bruge — det er op til dig at vælge.
Kilde: habr.com
