

Hej, Habr.
For nylig delte jeg om hvilke parametre vi oftest bruger i teamet til Kafka Producer og Consumer for at nærme os garanteret levering. I denne artikel vil jeg fortælle, hvordan vi organiserede genoptagelsen af en begivenhed modtaget fra Kafka som følge af midlertidig utilgængelighed af et eksternt system.
Moderne applikationer fungerer i et meget komplekst miljø. Forretningslogik pakket ind i en moderne teknologistak, der kører i en Docker-image, som styres af en orkestrator som Kubernetes eller OpenShift, og kommunikerer med andre applikationer eller enterprise-løsninger gennem en kæde af fysiske og virtuelle routere. I et sådant miljø kan der altid opstå problemer, derfor er genoptagelse af begivenheder i tilfælde af utilgængelighed af et eksternt system en vigtig del af vores forretningsprocesser.
Hvordan det var før Kafka
Tidligere i projektet brugte vi IBM MQ til asynkron levering af beskeder. Ved enhver fejl i serviceprocessen kunne den modtagne besked blive placeret i en dead-letter-queue (DLQ) for manuel behandling. DLQ blev oprettet ved siden af den indkommende kø, og flytningen af beskeden skete inden for IBM MQ.
Hvis fejlen var midlertidig, og vi kunne identificere det (f.eks. ResourceAccessException ved HTTP-kald eller MongoTimeoutException ved forespørgsel til MongoDb), trådte strategien for genkaldelser i kraft. Uanset hvordan applikationens logik grenes, blev den oprindelige besked flyttet til enten en systemkø for forsinket levering eller til en separat applikation, der engang blev lavet til genlevering af beskeder. Heri skrives nummeret på genleveringen i beskedens header, hvilket er knyttet til forsinkelsesintervallet eller slutningen af strategien på applikationsniveau. Hvis vi når slutningen af strategien, men det eksterne system stadig er utilgængeligt, placeres beskeden i DLQ til manuel behandling.
Søgning efter løsning
, kan man finde følgende . Hvis man skal opsummere, foreslås det at oprette et emne for hver forsinkelse og implementere Consumers på applikationssiden, som vil læse beskeder med den nødvendige forsinkelse.
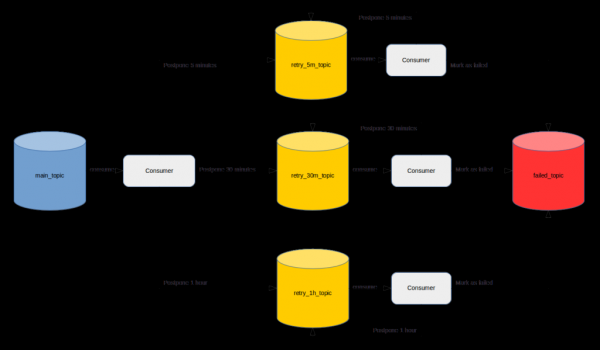
På trods af det store antal positive anmeldelser virker det ikke helt vellykket for mig. Først og fremmest fordi udvikleren, udover at implementere forretningskravene, vil skulle bruge meget tid på at implementere den beskrevne mekanisme.
Derudover, hvis adgangskontrol er aktiveret på Kafka-klyngen, vil der gå noget tid med at oprette emner og sikre de nødvendige adgange til dem. Udover dette skal den rette parameter retention.ms vælges for hver af retry-emnerne, så beskederne når at blive sendt igen og ikke går tabt. Implementeringen og anmodningen om adgange skal gentages for hver eksisterende eller ny service.
Lad os nu se på, hvilke mekanismer der tilbydes af spring til genbehandling af beskeder generelt og af spring-kafka specifikt. Spring-kafka har en transitive afhængighed til spring-retry, som tilbyder abstraktioner til at styre forskellige BackOffPolicy. Dette er et ret fleksibelt værktøj, men dets betydelige ulempe er, at beskeder til gensendelse opbevares i applikationens hukommelse. Det betyder, at genstart af applikationen på grund af opdateringer eller fejl under drift vil føre til tab af alle beskeder, der venter på genbehandling. Da dette punkt er kritisk for vores system, besluttede vi ikke at overveje det yderligere.
Selve spring-kafka tilbyder flere implementeringer af ContainerAwareErrorHandler, for eksempel , som gør det muligt at behandle en besked senere uden at flytte offset i tilfælde af en fejl. Fra version 2.3 af spring-kafka er det blevet muligt at angive BackOffPolicy.
Denne tilgang lader genbehandlede beskeder overleve genstart af applikationen, men mekanismen DLQ mangler stadig. Det var netop denne løsning, vi valgte i starten af 2019, optimistisk i troen på, at DLQ ikke ville være nødvendigt (vi var heldige, og det blev faktisk ikke nødvendigt i flere måneder med drift af applikationen med dette system til genbehandling). Midlertidige fejl førte til aktivering af SeekToCurrentErrorHandler. Andre fejl blev udskrevet i loggen, førte til flytning af offset, og behandlingen fortsatte med den næste besked.
Den endelige løsning
Implementeringen baseret på SeekToCurrentErrorHandler har tilskyndet os til at udvikle vores egen mekanisme til genudsendelse af meddelelser.
Først og fremmest ønskede vi at udnytte eksisterende erfaring og udvide den afhængigt af applikationens logik. For en applikation med lineær logik ville det være optimalt at stoppe med at læse nye meddelelser i en kort periode, fastsat i genudsendelsesstrategien. For de andre applikationer ønskede vi at have et enkelt punkt, der ville sikre udførelsen af genudsendelsesstrategien. Derudover skulle dette enhedspunkt have funktionalitet til DLQ for begge tilgange.
Selve genudsendelsesstrategien skal være gemt i applikationen, der er ansvarlig for at modtage det næste interval ved opståen af en midlertidig fejl.
Stop af Consumer'en for applikationen med lineær logik
Når man arbejder med spring-kafka, kan koden til at stoppe Consumer'en se omtrent sådan ud:
public void pauseListenerContainer(MessageListenerContainer listenerContainer,
                                   Instant retryAt) {
        if (nonNull(retryAt) && listenerContainer.isRunning()) {
            listenerContainer.stop();
            taskScheduler.schedule(() -> listenerContainer.start(), retryAt);
            return;
        }
        // til DLQ
    }
I eksemplet er retryAt det tidspunkt, hvor MessageListenerContainer skal genstartes, hvis det stadig er i gang. Genstarten vil finde sted i en separat tråd, der er startet i TaskScheduler, hvis implementering også leveres af spring.
Værdien af retryAt finder vi på følgende måde:
- Værdien af genudsendelsestælleren søges.
- I overensstemmelse med værdien af tælleren findes det aktuelle forsinkelsesinterval i genudsendelsesstrategien. Strategien erklæres i selve applikationen; til opbevaring har vi valgt JSON-formatet.
- Det fundne interval i JSON-arrayet indeholder antallet af sekunder, hvorefter behandlingen skal gentages. Dette antal sekunder lægges til den aktuelle tid, hvilket danner værdien for retryAt.
- Hvis intervallet ikke findes, er værdien af retryAt null, og meddelelsen vil blive sendt til DLQ til manuel gennemgang.
Med denne tilgang er det kun muligt at gemme antallet af genkald for hver besked, der i øjeblikket er under behandling, for eksempel i applikationens hukommelse. At gemme antallet af forsøg i hukommelsen er ikke kritisk for denne tilgang, da en applikation med lineær logik ikke kan udføre behandlingen som helhed. I modsætning til spring-retry vil en genstart af applikationen ikke føre til tab af alle beskeder til genbehandling, men blot genstarte strategien.
Denne tilgang hjælper med at reducere belastningen på det eksterne system, som muligvis ikke er tilgængeligt på grund af en meget høj belastning. Med andre ord har vi udover genbehandling opnået implementeringen af et mønster. .
I vores tilfælde er fejltærsklen kun 1, og for at minimere systemets nedetid på grund af midlertidige netværksproblemer anvender vi en meget granular strategi for genkald med små ventetider. Dette er måske ikke egnet til alle applikationer i koncernen, så forholdet mellem fejltærsklen og størrelsen på intervallet skal tilpasses baseret på systemets egenskaber.
En særskilt applikation til behandling af beskeder fra applikationer med nondeterministisk logik
Her er et kodeeksempel, der sender en besked til en sådan applikation (Retryer), som vil forsøge at sende igen til emnet DESTINATION, når tiden RETRY_AT er nået:
public  void retry(ConsumerRecord record, String retryToTopic,
                         Instant retryAt, String counter, String groupId, Exception e) {
        Headers headers = ofNullable(record.headers()).orElse(new RecordHeaders());
        List arrayOfHeaders =
            new ArrayList(Arrays.asList(headers.toArray()));
        updateHeader(arrayOfHeaders, GROUP_ID, groupId::getBytes);
        updateHeader(arrayOfHeaders, DESTINATION, retryToTopic::getBytes);
        updateHeader(arrayOfHeaders, ORIGINAL_PARTITION,
                     () -> Integer.toString(record.partition()).getBytes());
        if (nonNull(retryAt)) {
            updateHeader(arrayOfHeaders, COUNTER, counter::getBytes);
            updateHeader(arrayOfHeaders, SEND_TO, "retry"::getBytes);
            updateHeader(arrayOfHeaders, RETRY_AT, retryAt.toString()::getBytes);
        } else {
            updateHeader(arrayOfHeaders, REASON,
                         ExceptionUtils.getStackTrace(e)::getBytes);
            updateHeader(arrayOfHeaders, SEND_TO, "backout"::getBytes);
        }
        ProducerRecord messageToSend =
            new ProducerRecord(retryTopic, null, null, record.key(), record.value(), arrayOfHeaders);
        kafkaTemplate.send(messageToSend);
    }
Eksemplet viser, at der overføres meget information i headerne. Værdien RETRY_AT findes ligeledes som for mekanismen til gentagelse via stoppet af Consumer’en. Udover DESTINATION og RETRY_AT overfører vi:
- GROUP_ID, som vi bruger til at gruppere meddelelser til manuel analyse og forenkling af søgningen.
- ORIGINAL_PARTITION, for at forsøge at bevare den samme Consumer til genbehandling. Denne parameter kan være lig med null, i så fald vil en ny partition blive opnået baseret på nøgle record.key() fra den originale meddelelse.
- Det opdaterede værdig COUNTER, så vi kan følge strategien for gentagelser.
- SEND_TO — en konstant, der angiver, om meddelelsen skal sendes til gentagelse, når RETRY_AT nås, eller om den skal placeres i DLQ.
- REASON — årsagen til, at behandlingen af meddelelsen blev afbrudt.
Retryer gemmer meddelelser til genudsendelse og manuel gennemgang i PostgreSQL. En opgave starter med et tidsur, der finder meddelelser med nået RETRY_AT og sender dem tilbage til partitionen ORIGINAL_PARTITION i DESTINATION-topikken med nøglen record.key().
Efter at meddelelsen er sendt, fjernes de fra PostgreSQL. Den manuelle gennemgang af meddelelser sker i en simpel UI, der interagerer med Retryer via REST API. Dens vigtigste funktioner inkluderer genudsendelse eller sletning af meddelelser fra DLQ, visning af fejloplysninger og søgning af meddelelser, eksempelvis efter fejlens navn.
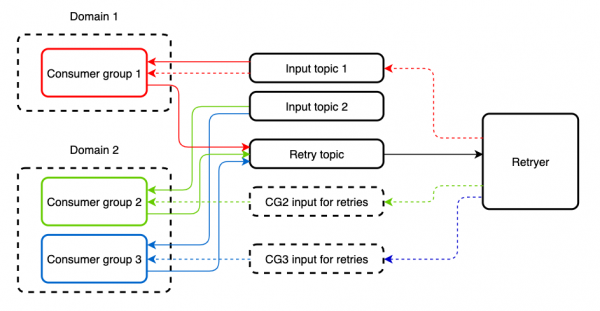
Da adgangsstyring er aktiveret på vores klynger, er det nødvendigt at anmode om adgang til den topik, som Retryer lytter til, og give Retryer mulighed for at skrive til DESTINATION-topikken. Dette er besværligt, men i modsætning til tilgangen med en interval-topik får vi en fuldgyldig DLQ og UI til at administrere den.
Der er tilfælde, hvor den indgående topik læses af flere forskellige consumer-grupper, hvis applikationer implementerer forskellig logik. Genbehandling af meddelelsen gennem Retryer for en af disse applikationer vil føre til en duplikat i en anden. For at beskytte os mod dette opretter vi en separat topik til genbehandling. Den indgående og retry-topik kan læses af den samme Consumer uden begrænsninger.
Som standard giver denne tilgang ikke mulighed for circuit breaker, men det kan tilføjes i applikationen ved hjælp af eller den nye , ved at indkapsle opkald til eksterne tjenester i de relevante abstraktioner. Derudover åbnes der mulighed for at vælge strategi for mønstre, hvilket også kan være nyttigt. For eksempel kan det i spring-cloud-netflix være en trådgruppe eller et semaphore.
Output
Som resultat har vi fået en separat applikation, der gør det muligt at gentage behandlingen af en besked, når en ekstern system midlertidigt ikke er tilgængelig.
En af de vigtigste fordele ved applikationen er, at eksterne systemer, der kører på den samme Kafka-klynge, kan bruge den uden betydelige ændringer på deres side! Sådan en applikation har kun brug for at få adgang til retry-topikken, udfylde nogle Kafka-headere og sende beskeden til Retryer. Der er ikke behov for at oprette yderligere infrastruktur. For at reducere antallet af beskeder, der overføres fra applikationen til Retryer og tilbage, har vi adskilt applikationer med lineær logik og gjort dem i stand til at gentage behandling gennem stop af Consumer.
Kilde: habr.com
