

Den næste HighLoad++ konference finder sted den 6. og 7. april 2020 i Sankt Petersborg.
Detaljer og billetter . HighLoad++ Siberia 2019. Sal "Krasnoyarsk". 25. juni, 12:00. Abstracts og .
Nogle gange kan praktiske krav komme i konflikt med teorien, hvor vigtige aspekter for et kommercielt produkt ikke er taget i betragtning. I dette foredrag præsenteres processen med at vælge og kombinere forskellige tilgange til at skabe komponenter til Causal consistency baseret på akademisk forskning i overensstemmelse med kravene til det kommercielle produkt. Lytterne vil blive informeret om de eksisterende teoretiske tilgange til logiske ure, afhængighedssporing, system sikkerhed, tids synkronisering, og hvorfor MongoDB valgte de specifikke løsninger.
Mikhail Tyulenev (herefter – MT): – Jeg vil tale om Causal consistency – en funktion, vi har arbejdet på i MongoDB. Jeg arbejder i gruppen for distribuerede systemer, og vi udviklede den for cirka to år siden.
I processen blev det nødvendigt at sætte sig ind i en stor mængde akademisk forskning, da denne funktion er temmelig velundersøgt. Det viste sig, at ingen af artiklerne passede ind i, hvad der kræves i produktionen, databasen taget i betragtning de ret specifikke krav, der findes i nærmest alle produktionsapplikationer.
Jeg vil tale om, hvordan vi, som forbrugere af akademisk forskning, forbereder noget, som vi senere kan præsentere for vores brugere som en færdigret, der er komfortabel og sikker at bruge.
Causal consistency. Lad os definere begreberne
For det første vil jeg gerne overordnet sige, hvad Causal consistency er. Der er to karakterer – Leonard og Penny (fra serien "The Big Bang Theory"):
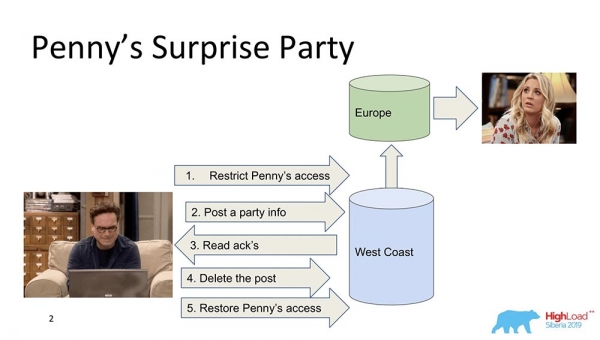
Lad os antage, at Penny er i Europa, og Leonard ønsker at lave en overraskelse for hende, en fest. Og han kan ikke finde på bedre end at fjerne hende fra vennelisten og sende alle vennerne en opdatering på feedet: "Lad os glæde Penny!" (Hun er i Europa, mens hun sover, ser ikke det hele og kan ikke se det, fordi hun ikke er der). I sidste ende sletter han dette indlæg, fjerner det fra "Feedet" og gendanner adgangen, så hun ikke bemærker noget, og der ikke opstår en skandale.
Det er alt sammen godt, men lad os antage, at systemet er distribueret, og begivenhederne forløb ikke helt som forventet. For eksempel kan det ske, at adgangen til Penny blev begrænset efter, at dette indlæg blev oprettet, hvis begivenhederne ikke er forbundet med årsagssammenhænge. Faktisk er dette et eksempel på, hvornår der er brug for Causal consistency for at udføre en forretningsfunktion (i dette tilfælde).
I virkeligheden er dette ret ikke-trivielle egenskaber ved databaser – meget få af dem understøtter dem. Lad os gå videre til modellerne.
Konsistensmodeller (Consistency Models)
Hvad er egentlig en konsistensmodel i databaser? Det er nogle garantier, som et distribueret system giver vedrørende, hvilke data og i hvilken rækkefølge klienten kan få dem.
Grundlæggende set reduceres alle konsistensmodeller til, hvor meget et distribueret system ligner et system, der f.eks. kører på en enkelt node på en laptop. Og i hvor høj grad et system, der kører på tusinder af geospatialt distribuerede 'noder', ligner en laptop, hvor alle disse egenskaber principielt udføres automatisk.
Derfor gælder konsistensmodeller kun for distribuerede systemer. Alle systemer, der tidligere eksisterede og fungerede med vertikal skalering, oplevede ikke disse problemer. Der var ét Buffer Cache, og alt blev altid læst derfra.
Model Strong
Den allerførste model er Strong (eller line rise ability, som den ofte kaldes). Det er en konsistensmodel, der garanterer, at hver ændring, så snart den bekræftes, bliver synlig for alle brugere af systemet.
Dette skaber en global rækkefølge af alle begivenheder i databasen. Det er en meget stærk konsistensegenskab, og den er overhovedet meget kostbar. Ikke desto mindre understøttes den rigtig godt. Det er bare meget dyrt og langsomt – derfor bruges den sjældent. Det kaldes rise ability.
Der er også en anden, stærkere egenskab, der understøttes i 'Spanner' – det kaldes External Consistency. Vi vil tale om det lidt senere.
Causal
Det følgende er Causal, som jeg netop talte om. Mellem Strong og Causal findes der flere underniveauer, som jeg ikke vil tale om, men de handler alle om Causal. Dette er en vigtig model, fordi den er den stærkeste af alle modeller, det er den mest robuste konsistens i tilfælde af netværk eller partitioner.
Causals er faktisk den situation, hvor begivenheder er forbundet med en årsagssammenhæng. De opfattes ofte som Read your on rights fra kundens synspunkt. Hvis kunden har observeret nogle værdier, kan han ikke se de værdier, som var i fortiden. Han begynder allerede at se præfiks-læsninger. Det hele handler om det samme.
Causals som konsistensmodel er en delvis rækkefølge af begivenheder på serveren, hvor begivenheder fra alle klienter observeres i den samme sekvens. I dette tilfælde - Leonard og Penny.
Eventual
Den tredje model er Eventual Consistency. Dette er noget, som alle distribuerede systemer understøtter, den minimale model, der overhovedet giver mening. Det betyder følgende: når vi foretager nogle ændringer i dataene, bliver de på et tidspunkt konsistente.
I det øjeblik siger den ikke noget, ellers ville den være blevet til External Consistency - det ville have været en helt anden historie. Ikke desto mindre er dette en meget populær model, den mest almindelige. Som standard bruger alle brugere af distribuerede systemer faktisk Eventual Consistency.
Jeg vil gerne give nogle sammenlignende eksempler:
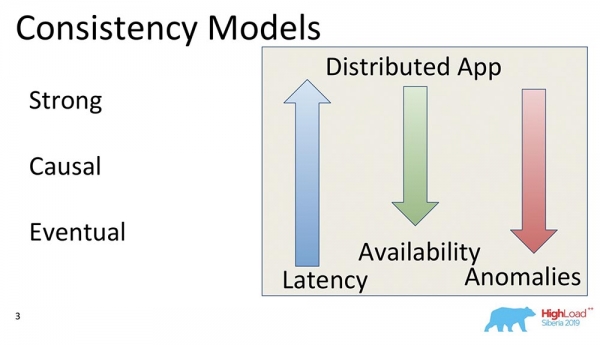
Hvad betyder disse pile?
- Latency. Når styrken af konsistensen øges, bliver den større af åbenlyse grunde: Det er nødvendigt at lave flere optegnelser, få bekræftelse fra alle værter og noder, der deltager i klyngen, om at dataene allerede er der. Derfor er det hurtigst i Eventual Consistency, fordi man i reglen kan committe lige i hukommelsen og det vil grundlæggende være tilstrækkeligt.
- Availability. Hvis dette forstås som systemets evne til at svare i tilfælde af netværksafbrydelser, partitioner eller nogle fejl - stigende fejlmodstand ved faldende konsistensmodel, da det er tilstrækkeligt, at én vært lever og stadig udleverer nogle data. Eventual Consistency garanterer i virkeligheden slet ikke noget om dataene - det kan være hvad som helst.
- Anomalies. Når det kommer til det, stiger antallet af anomalier selvfølgelig. I Strong Consistency bør der næsten ikke være nogen, mens Eventual Consistency kan have dem i alle former. Spørgsmålet opstår: hvorfor vælger folk Eventual Consistency, når den indeholder anomalier? Svaret ligger i, at Eventual Consistency-modeller er anvendelige, og at anomalier for eksempel kun eksisterer i kort tid; der er mulighed for at bruge en master til at læse og få mere eller mindre konsistente data; ofte er der også mulighed for at bruge stærke konsistensmodeller. Praktisk fungerer det, og ofte er antallet af anomalier tidsbegrænset.
CAP-teoremet
Når du ser ordene consistency, availability – hvad tænker du så på? Rigtigt – CAP-teoremet! Jeg vil nu gerne aflive en myte... Det er ikke mig – det er Martin Kleppmann, der har skrevet en fremragende artikel, en fremragende bog.
CAP-teoremet er et princip, der blev formuleret i 2000'erne, om at Consistency, Availability, Partitions: tag nogen to, og du kan ikke vælge tre. Dette var en slags princip. Det blev bevist som et teorem nogle år senere af Gilbert og Lynch. Derefter blev det brugt som en mantra – systemer blev delt op i CA, CP, AP og så videre.
Dette teorem blev faktisk bevist for disse tilfælde... For det første blev Availability ikke betragtet som en kontinuerlig værdi fra nul til hundrede (0 – systemet er 'dødt', 100 – svarer hurtigt; vi er vant til at betragte det sådan), men som en egenskab ved algoritmen, der garanterer, at den ved alle sine executioner returnerer data.
Der er overhovedet ikke noget om responstid! Der er en algoritme, der returnerer data efter 100 år – en helt fantastisk available-algoritme, der er en del af CAP-teoremet.
For det andet blev teoremet bevist for ændringer i værdierne af den samme nøgle, og disse ændringer er en resizable linje. Dette betyder, at de faktisk næsten ikke bruges, fordi der er andre modeller som Eventual Consistency, Strong Consistency (måske).
Hvad gør vi med alt dette? At CAP-teoremet i den form, det er bevist, stort set ikke er anvendeligt, sjældent bruges. I teoretisk form begrænser det på en eller anden måde alt. Det resulterer i et princip, der er intuitivt sandt, men som ikke er bevist på nogen måde.
Causal consistency – den stærkeste model
Det, der sker nu, er, at man kan opnå alle tre ting: Konsistens, Tilgængelighed kan opnås ved hjælp af Partitioner. Især Causal konsistens – den stærkeste model for konsistens, der stadig fungerer ved tilstedeværelsen af Partitioner (netværksbrud). Derfor er den så interessant, og derfor har vi beskæftiget os med den.
For det første forenkler det arbejdet for applikationsudviklere. Især er der stor support fra serveren: når alle optegnelser, som finder sted inden for en enkelt klient, garanteret kommer i den rigtige rækkefølge til en anden klient. For det andet kan den modstå partitioner.
Det indre arbejde i MongoDB
Husk på, at vi skal til frokost, så lad os bevæge os ind i køkkenet. Jeg vil fortælle om systemmodellen, nemlig hvad MongoDB er for dem, der hører om denne database for første gang.
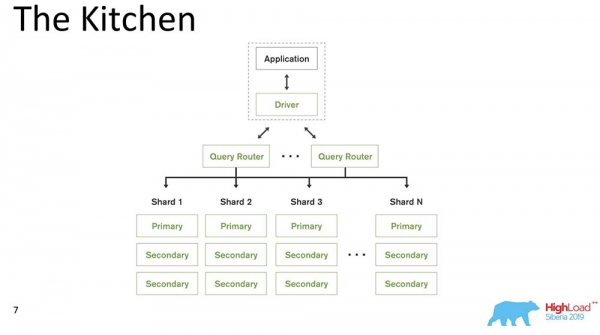
MongoDB (herefter – 'MongoDB') er et distribueret system, der understøtter horisontal skalering, hvilket vil sige sharding; og inden for hver shard understøtter det også datarækkefølge, det vil sige replikering.
Sharding i 'MongoDB' (ikke-relateret database) udfører automatisk belastningsbalancering, det vil sige, at hver dokumentkollektion (eller 'tabel' i termerne fra relationelle data) opdeles i stykker, og serveren bevæger dem automatisk mellem sharder.
Query Router, der distribuerer fores requests, er for klienten en slags klient, som han arbejder igennem. Den ved allerede, hvor og hvilke data der ligger, og dirigerer alle fores requests til den rigtige shard.
Endnu et vigtigt punkt: MongoDB er en enkelt master. Der er én Primary – den kan tage optegnelser, der understøtter de nøgler, den indeholder. Multi-master write er ikke muligt.
Vi har udgivet version 4.2 – der er kommet nye interessante ting. Især er Lucene blevet lagt ind – søgning – altså executable java direkte i 'Mongo', og det er nu muligt at udføre søgning gennem Lucene, præcis som i 'Elasticsearch'.
Og vi har lavet et nyt produkt – Charts, som også er tilgængeligt på 'Atlas' (Mongo's egen Cloud). De har en Free Tier – man kan lege med det. Jeg var meget glad for Charts – datavisualisering, meget intuitiv.
Ingredienserne til Causal konsistens
Jeg har talt mig frem til cirka 230 artikler, der er blevet publiceret om dette emne – fra Leslie Lampert. Nu vil jeg fra hukommelsen viderebringe nogle dele af disse materialer til jer.
Det hele begyndte med en artikel af Leslie Lampert, skrevet i 1970'erne. Som I kan se, er der stadig forskning i dette emne i gang. I dag oplever kausal konsistens en renæssance sammen med udviklingen af distribuerede systemer.
Begrænsninger
Hvilke begrænsninger findes der? Dette er faktisk et af de vigtigste punkter, for begrænsningerne, som produktionssystemer pålægger, adskiller sig betydeligt fra de begrænsninger, der findes i akademiske artikler. Ofte er de ret kunstige.
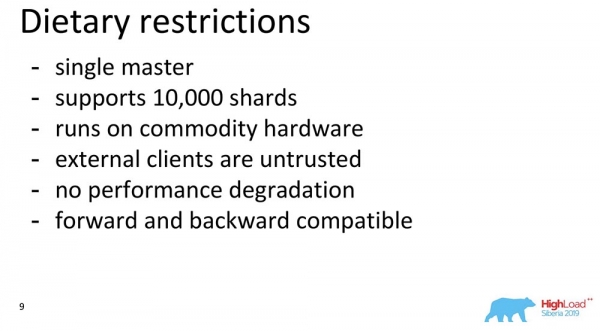
- For det første er 'MongoDB' en single master, som jeg allerede har nævnt (det forenkler det meget).
- Vi mener, at systemet skal kunne understøtte omkring 10.000 shards. Vi kan ikke træffe arkitektoniske beslutninger, der klart vil begrænse denne værdi.
- Vi har en cloud-løsning, men vi mener, at en bruger skal have mulighed for at downloade en binary, køre den på sin laptop, og så fungerer det hele perfekt.
- Vi antager, at det, der sjældent anvendes i forskning: eksterne kunder kan gøre hvad som helst. 'MongoDB' er open source. Derfor kan kunderne være meget kloge, og onde – de kan være interesserede i at bryde alt. Vi forudser, at byzantinske fejlsituationer kan forekomme.
- For eksterne kunder, der befinder sig uden for perimeteren – en vigtig begrænsning: hvis denne funktion er deaktiveret, skal der ikke observeres nogen performance degradation.
- Et andet aspekt – helt imod akademiske principper: kompatibilitet mellem tidligere og fremtidige versioner. Gamle drivere skal understøtte nye opdateringer, og databasen skal understøtte gamle drivere.
Generelt pålægger alt dette begrænsninger.
Komponenter af kausal konsistens
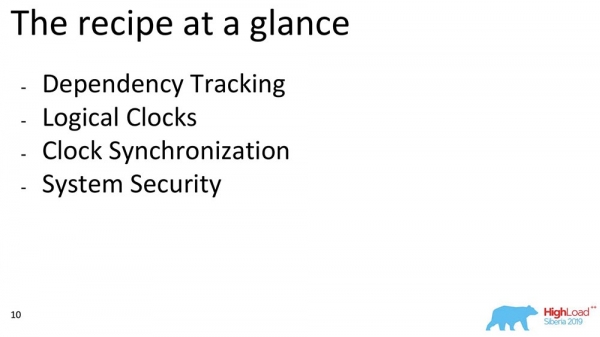
Jeg vil nu fortælle om nogle komponenter. Hvis man ser på kausal konsistens i det hele taget, kan man identificere blokke. Vi har udvalgt fra arbejde, der relaterer til en given blok: Dependency Tracking, valg af tid, hvordan disse ure kan synkroniseres med hinanden, og hvordan vi sikrer sikkerhed – det er en skitse af, hvad jeg vil tale om.
Fuldt afhængighedssporing (Full Dependency Tracking)
Hvad er det nødvendigt for? For at når data replikeres - hver post, hver ændring af data indeholder information om, hvilke ændringer det afhænger af. Den allerførste og naiveste ændring er, når hver besked, der indeholder en post, indeholder information om de tidligere beskeder:
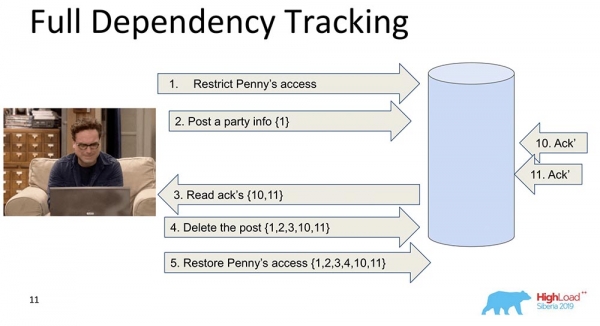
I dette eksempel er nummeret i krøllede parenteser - dette er postnumre. Nogle gange overføres disse poster med værdier endda helt, andre gange overføres nogle versioner. Essensen er, at hver ændring indeholder information om den tidligere (den bærer alt dette eksplicit).
Hvorfor besluttede vi ikke at bruge denne tilgang (fuld sporbarhed)? Årsagen er åbenlys: denne tilgang er upraktisk: enhver ændring i et socialt netværk afhænger af alle tidligere ændringer i dette sociale netværk, og det ville betyde at overføre "Facebook" eller "Vkontakte" i hver opdatering. Alligevel er der mange undersøgelser vedrørende Full Dependency Tracking - det er præ-sosiale netværk, og i nogle situationer fungerer det virkelig.
Eksplisit sporingsafhængigheder (Explicit Dependency Tracking)
Den næste - mere begrænset. Her overvejes også overførsel af information, men kun den, der afhænger eksplicit. Hvad der afhænger af hvad, bestemmes typisk allerede af applikationen. Når data replikeres, gives der kun svar, når de tidligere afhængigheder er blevet opfyldt, det vil sige vist. Det er essensen af, hvordan Causal consistency fungerer.
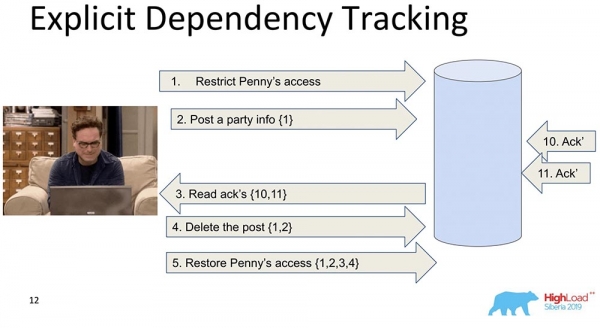
Det kan se, at post 5 afhænger af posterne 1, 2, 3, 4 – derfor venter den, før klienten får adgang til de ændringer, der er foretaget ved rækkefølgen for adgang fra Penny, når alle tidligere ændringer allerede er gennemført i databasen.
Dette er heller ikke acceptabelt for os, fordi der stadig er for meget information, og det vil bremse systemet. Der er en anden tilgang…
Lamport Ur (Lamport Clock)
De er meget gamle. Lamport Clock indebærer, at disse afhængigheder komprimeres til en skalarfunktion, som kaldes Lamport Clock.
En skalar funktion er et abstrakt tal. Det kaldes ofte logisk tid. Ved hver hændelse øges denne counter. Den counter, som i øjeblikket er kendt af processen, sender hver besked. Det er klart, at processerne kan være desynkroniserede, og de kan have helt forskellig tid. Ikke desto mindre balancerer systemet på en eller anden måde klokkens tid gennem denne beskedudveksling. Hvad sker der i dette tilfælde?
Jeg har delt den store shard i to for at gøre det klart: Friends kan leve i en node, som rummer en del af samlingen, mens Feed – kan være i en helt anden node, der indeholder en del af denne samling. Hvordan kan de så undgå at blive i rækkefølge? Først vil Feed sige: "Replikeret", og så – Friends. Hvis systemet ikke sikrer, at Feed ikke vises, før afhængighederne fra Friends i samlingen af Friends også er leveret, så får vi netop den situation, som jeg nævnte.
Du kan se, hvordan den logiske tid counter på Feed’en øges:
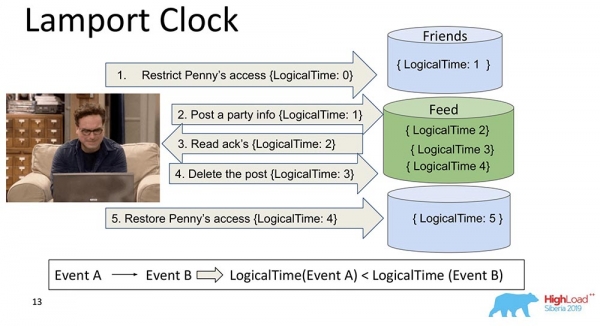
Dermed er den grundlæggende egenskab ved dette Lamport Clock og Causal consistency (forklaret gennem Lamport Clock) følgende: hvis vi har hændelser A og B, og hændelse B afhænger af hændelse A *, så følger det, at LogicalTime for Event A er mindre end LogicalTime for Event B.
* Nogle gange siges det også, at A indtraf før B, altså A skete før B – det er et forhold, der delvist ordner hele mængden af hændelser, der overhovedet er sket.
Den omvendte vej er ikke korrekt. Dette er faktisk en af de grundlæggende ulemper ved Lamport Clock – delvis rækkefølge. Der er et begreb om samtidige hændelser, dvs. hændelser, hvor hverken (A skete før B) eller (A skete efter B) holder. Et eksempel kunne være, når Leonard parallel tilføjer nogen som ven (eller endda Sheldon, for eksempel).
Dette er den egenskab, som ofte bruges ved arbejde med Lamport-ure: man ser netop på funktionen og drager derudfra konklusionen – måske er disse hændelser afhængige. Fordi det er korrekt i en retning: hvis LogicalTime A er mindre end LogicalTime B, så kan B ikke være sket før A; og hvis det er større, kan det være.
Vektor ure (Vector Clock)
Den logiske udvikling af Lamport-uret er Vektor ure. De adskiller sig ved, at hver node, der findes her, indeholder sine egne, separate ure, og de sendes som et vektorsystem.
I dette tilfælde ser du, at den nul-indeks vektor svarer til Feed, mens den første indeks vektor svarer til Friends (hver af disse noder). Og nu vil de begynde at stige: nul-indekset for "Feed" stiger med én, to, tre:
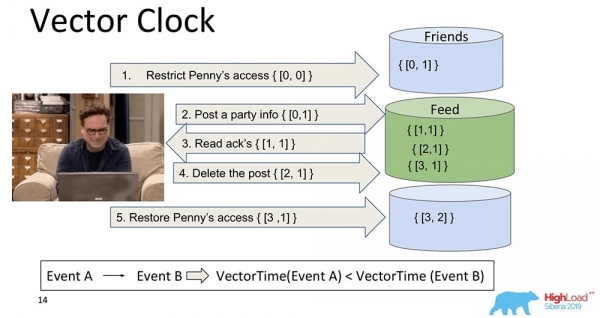
Hvad gør Vektor Timer bedre? De hjælper med at afklare, hvilke hændelser der er samtidige, og hvornår de sker på forskellige noder. Dette er meget vigtigt for shardingsystemet, såsom "MongoDB". Men vi valgte ikke det, selvom det er en fremragende løsning, der fungerer godt, og det ville sandsynligvis have været en god pasform for os ...
Hvis vi har 10.000 shards, kan vi ikke overføre 10.000 komponenter, selv hvis vi komprimerer, og finder på noget andet - nyttelasten vil stadig være mange gange mindre end omfanget af hele denne vektor. Derfor, med tungt hjerte og gennem sammenbidte tænder, har vi opgivet denne tilgang og gik videre til en anden.
Spanner TrueTime. Atomure
Jeg nævnte, at der vil være en tale om "Spanner". Det er en fantastisk ting, virkelig fra det 21. århundrede: atomure, GPS-synkronisering.
Hvad er ideen? "Spanner" er et Google-system, som for nylig er blevet gjort tilgængeligt for folk (de har tilføjet SQL til det). Hver transaktion har et bestemt tidsstempel. Da tiden er synchroniseret*, kan hver hændelse tildeles et bestemt tidspunkt - atomure har en ventetid, hvorefter et andet tidspunkt garanteres at "forekomme".
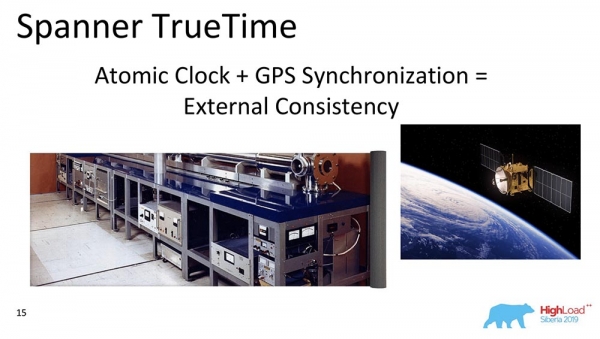
På denne måde, ved blot at skrive til databasen og vente et stykke tid, garanteres automatisk Serializability for hændelsen. De har den stærkeste konsistensmodel, der overhovedet kan forestilles - den er ekstern konsistens.
* Dette er det grundlæggende problem med Lamport-ure - de er aldrig synkroniserede på distribuerede systemer. De kan divergere, selv med NTP fungerer de stadig ikke særlig godt. "Spanner" har atomure og synkronisering, ser det ud til, i mikrosekunder.
Hvorfor valgte vi ikke det? Vi antager ikke, at vores brugere har indbyggede atomure. Når de bliver tilgængelige, indbygget i hver laptop, vil der være en super cool GPS-synkronisering - så ja ... Men indtil da er det bedste, der er muligt - "Amazon", base stationer - for entusiasterne ... Så vi brugte andre ure.
Hybrid Clock (Hybridur)
Det er faktisk det, der tikker i «MongoDB» ved sikring af kausal konsistens. Hvad er de hybride i? Hybrid er en skalar værdi, men den består af to komponenter:
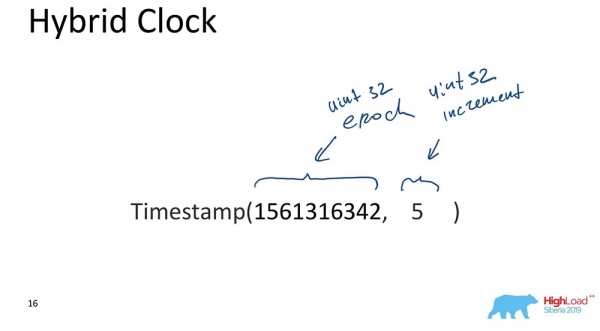
- Den første er Unix-epoken (hvor mange sekunder der er gået siden «computverdenens begyndelse»).
- Den anden er et inkrement, også 32-bit unsigned int.
Det er faktisk det hele. Der er en tilgang: den del, der håndterer tiden, synkroniseres hele tiden med klokken; hver gang der sker en opdatering, synkroniseres denne del med klokken, og det resulterer i, at tiden altid er mere eller mindre korrekt, mens inkrementet gør det muligt at skelne mellem hændelser, der fandt sted på samme tid.
Hvorfor er det vigtigt for «MongoDB»? Fordi det gør det muligt at udføre nogle backup-gendannelser på et bestemt tidspunkt, hvilket betyder, at en hændelse indekseres med tid. Dette er vigtigt, når specifikke hændelser er påkrævet; for databasen er hændelser ændringer i databasen, der fandt sted inden for bestemte tidsrammer.
Den vigtigste grund vil jeg kun fortælle dig (vær venlig ikke at sige det til andre)! Vi gjorde det sådan, fordi det er, hvordan ordnede, indekserede data ser ud i MongoDB OpLog. OpLog er en datastruktur, der indeholder alle ændringer i databasen: de går først ind i OpLog og anvendes derefter konkret på Storage, når det er replikeret data eller shardet.
Det var den vigtigste grund. Der findes dog også praktiske krav til udviklingen af databasen, hvilket betyder, at det skal være enkelt – så lidt kode som muligt, og så få defekte ting, der skal skrives om og testes. At vores oplogs viste sig at være indekseret med hybride tidsfiler har virkelig hjulpet og gjort det muligt at træffe de rigtige valg. Det viste sig virkelig at give mening og fungerede på en eller anden måde magisk i den første prototype. Det var virkelig sejt!
Tidsynkronisering
Der er flere måder at synkronisere på, som beskrevet i videnskabelig litteratur. Jeg taler om synkronisering, når vi har to forskellige shards. Hvis der er et replica-set, er der ingen synkronisering nødvendig: det er "single-master"; vi har en OpLog, hvor alle ændringer lander – i dette tilfælde er alt allerede sekventielt ordnet i selve "OpLog". Men hvis vi har to forskellige shards, er tids-synkronisering vigtigt. Her har de vektoriske ure været til stor hjælp! Men dem har vi ikke.
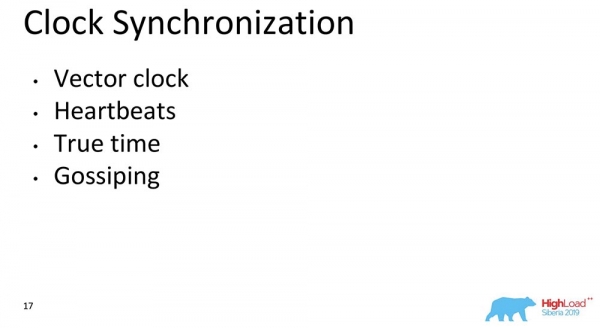
Den anden metode er "Heartbeats". Man kan udveksle nogle signaler, der sker med en bestemt tidsinterval. Men "Heartbeats" er for langsomme, vi kan ikke sikre acceptable latenstider for vores kunder.
True time – det er selvfølgelig en vidunderlig ting. Men igen, det er nok fremtiden... Selvom man i "Atlas" allerede kan gøre det, der er allerede hurtige "Amazon" tids-synkronisatorer. Men det vil ikke være tilgængeligt for alle.
Gossiping – det er, når alle beskeder inkluderer tid. Det er omtrent det, vi anvender. Hver besked mellem noderne, drivere, routere for data-noder, absolut alt for "MongoDB" – er nogle elementer, databaskomponenter, der indeholder ure, som kører. De har alle et hybridt tidsværd, som sendes. 64 bit? Det er muligt, det kan lade sig gøre.
Hvordan fungerer det hele sammen?
Her ser jeg på et enkelt replica-set for at gøre det lidt lettere. Der er en Primary og en Secondary. Secondary foretager replikering og er ikke altid fuldstændig synkroniseret med Primary.
Der sker en indsættelse (insert) i "Primary" med en bestemt tidsværdi. Denne indsættelse øger den interne tæller med 11, hvis det er maks. Ellers vil den kontrollere tidsværdierne og synkronisere ifølge urene, hvis tidsværdierne er større. Dette tillader tidsmæssig orden.
Efter at han laver skrivningen, sker der et vigtigt øjeblik. Urene i "MongoDB" inkrementeres kun, hvis der er en skrivning i "OpLog". Dette er begivenheden, der ændrer systemets tilstand. I alle klassiske artikler betragtes en begivenhed som en besked, der når en node: beskeden er ankommet – så har systemet ændret sin tilstand.
Det hænger sammen med, at man ikke helt kan forstå, hvordan denne meddelelse vil blive fortolket, når man undersøger det. Vi ved helt sikkert, at hvis det ikke er afspejlet i "Oplogen", vil det slet ikke blive fortolket, og en ændring af systemets tilstand er kun en indtastning i "Oplogen". Dette gør det hele enklere for os: både modellen bliver simplere, og det tillader os at opretholde orden inden for et enkelt replikaset, samt flere andre nyttige ting.
Der returneres en værdi, der allerede er indtastet i "Oplogen" - vi ved, at denne værdi allerede ligger i "Oplogen", og dens tid er 12. Nu, lad os sige, at læsningen starter fra en anden node (Secondary), og den sender allerede afterClusterTime i selve meddelelsen. Den siger: "Jeg har brug for alt, hvad der skete mindst efter 12 eller på tidspunktet tolv" (se fig. ovenfor).
Dette kaldes Causal a consistent (CAT). Der er et sådant begreb i teorien, at dette er et tidsudsnit, der er konsistent i sig selv. I dette tilfælde kan man sige, at dette er systemets tilstand, der blev observeret på tidspunktet 12.
Der er endnu ikke noget her, fordi det ligesom imiterer en situation, hvor Secondary skal replikere data fra Primary. Den venter... Og nu er dataene kommet - returnerer disse værdier tilbage.
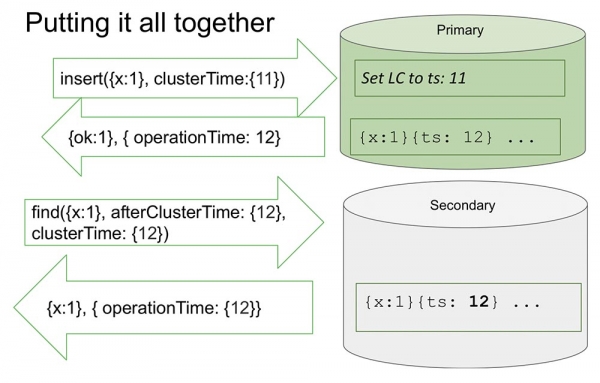
Sådan fungerer det cirka. Næsten.
Hvad betyder "næsten"? Lad os antage, at der er en person, der har læst og forstået, hvordan det hele fungerer. Forstået, at hver gang der sker ClusterTime, opdaterer den de interne logiske ure, og så øger den næste indtastning med én. Denne funktion tager 20 linjer. Antag, at denne person sender det maksimalt store 64-bit tal minus én.
Hvorfor "minus én"? Fordi de interne ure vil blive anvendt i denne værdi (åbenbart det største mulige og større end den nuværende tid), så vil der blive en indtastning i "Oplogen", og uret vil blive inkrementeret med endnu en - og det vil allerede være den absolut maksimale værdi (der er simpelthen alle enere, der er ikke mere at tilføje, unsaint int'ere).
Det er klart, at efter dette bliver systemet absolut utilgængeligt for noget som helst. Det kan kun eksporteres, rengøres - meget manuelt arbejde. Fuldt tilgængelighed:
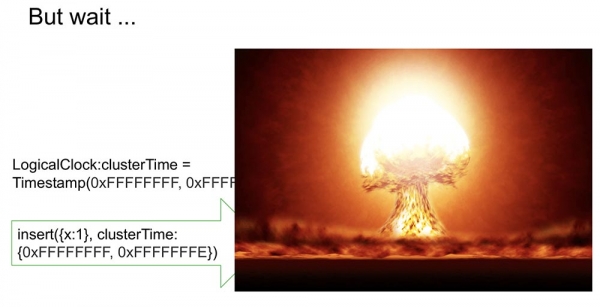
Når dette replikeres et andet sted, kan hele klyngen gå ned. En absolut uacceptabel situation, som enhver kan skabe meget hurtigt og nemt! Derfor betragtede vi dette aspekt som et af de vigtigste. Hvordan kan vi forhindre det?
Vores løsning er at underskrive clusterTime
Det sendes i beskeden (indtil den blå tekst). Men vi begyndte også at generere en signatur (blå tekst):
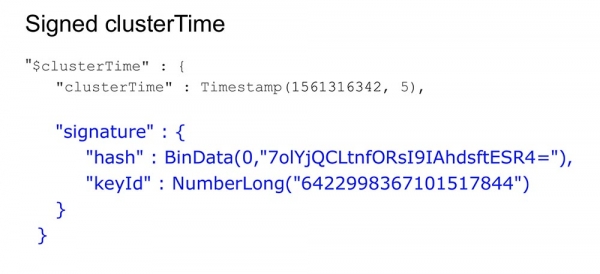
Signaturen genereres med en nøgle, der opbevares inden for databasen, inden for en sikret perimeter; den genereres og opdateres (brugerne ser ikke dette). En hash genereres, og hver besked underskrives, når den oprettes, og valideres, når den modtages.
Måske stiller folk spørgsmålet: "Hvor meget bremser det her?" Jeg har sagt, at det skal fungere hurtigt, især uden denne funktion.
Hvad betyder det at bruge Causal consistency i dette tilfælde? Det er at vise afterClusterTime-parameteren. Uden dette vil den simpelthen sende værdier uanset hvad. Gossiping har kørt konstant siden version 3.6.
Hvis vi lader signaturen genereres konstant, vil det bremse systemet selv uden funktionaliteten, hvilket ikke stemmer overens med vores tilgang og krav. Hvad gjorde vi?
Gør det hurtigt!
Det er en ganske enkel ting, men et interessant trick – jeg vil dele det, måske finder nogen det interessant.
Vi har en hash, hvor de underskrevne data opbevares. Alle data går gennem cachen. Cachen underskriver ikke specifikt tid, men Range. Når en værdi kommer ind, genererer vi et Range, masker de sidste 16 bits, og denne værdi skal vi underskrive:
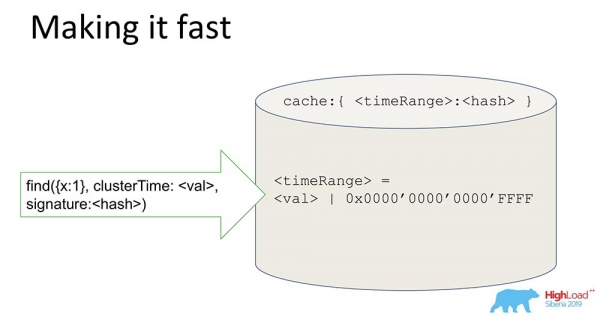
Ved at få en sådan signatur kan vi (teoretisk) accelerere systemet 65.000 gange. Det fungerer fantastisk: når vi satte eksperimenterne op, blev tiden virkelig reduceret med 10.000 gange, når vi havde sekventiel opdatering. Det er klart, at når de er ude af sync, fungerer det ikke. Men i de fleste praktiske tilfælde fungerer det. Kombinationen af signaturer med Range sammen med signaturen løste sikkerhedsproblemet.
Hvad har vi lært?
Lektionerne, vi har trukket herfra:
- Det er nødvendigt at læse materialer, historier, artikler, fordi vi har mange spændende ting at dele. Når vi arbejder på en funktion (især nu, hvor vi har arbejdet med transaktioner osv.), er det vigtigt at læse og sætte sig ind i tingene. Det tager tid, men det er faktisk meget nyttigt, fordi det bliver klart, hvor vi står. Vi har ikke fundet på noget nyt – vi har blot taget ingredienserne.
Der er generelt en forskel i tænkningen, når der er en akademisk konferencen (som f.eks. «Sigmon») – der fokuserer alle på nye idéer. Hvad er nyheden i vores algoritme? Der er ikke meget nyhed her. Nyheden ligger snarere i, hvordan vi har blandet eksisterende tilgange sammen. Derfor er det første skridt – at læse klassikere, startende med Lamport.
- I produktion er kravene helt andre. Jeg er sikker på, at mange af jer ikke står overfor «sferiske» databaser i et abstrakt vakuum, men overfor normale, virkelige ting, som har problemer med tilgængelighed, latenstid og fejltolerance.
- Det sidste er, at vi måtte overveje forskellige idéer og kombinere flere vidt forskellige artikler til en samlet tilgang. Ideen om signaturer kom f.eks. fra en artikel, der betragtede Paxos-protokollen, som er til ikke-bizantinske fejl i en autorisationsprotokol, og for bizantinske fejl – uden for autorisationsprotokollen… Dette er præcist, hvad vi i sidste ende gjorde.
Der er absolut intet nyt her! Men så snart vi blandede det hele sammen... Det er som at sige, at opskriften på Olivier-salat ikke er noget særligt, fordi æg, mayonnaise og agurker allerede har været opfundet… Det er omtrent den samme historie.
Jeg afslutter hermed. Tak!
Spørgsmål
Spørgsmål fra salen (herefter – S): – Tak, Mikhail, for præsentationen! Emnet om tid er interessant. Du bruger Gossiping. Du sagde, at alle har deres egen tid, og alle kender deres lokale tid. Jeg forstod det sådan, at vi har drivere – der kan være mange kunder med drivere, også mange query-planlæggere, og også mange shards… Hvad sker der med systemet, hvis der pludselig opstår uoverensstemmelse: nogen mener, at de er et minut foran, nogen – et minut bagud? Hvor vil vi ende?
MT: – Et virkelig godt spørgsmål! Jeg ville lige tage fat i shards. Hvis jeg forstår spørgsmålet korrekt, har vi denne situation: der er shard 1 og shard 2, og læsningerne sker fra disse to shards – de er ikke synkroniserede, fordi de kender forskellige tidspunkter, især det tidspunkt, de eksisterer på i oploggerne.
Lad os sige, at shard 1 har lavet en million optegnelser, mens shard 2 ikke har lavet nogen. Hvis en forespørgsel kommer til begge shards, og shard 1 har afterClusterTime på mere end en million, så vil shard 2 aldrig svare i denne situation, som jeg forklarede.
Q: – Jeg ville gerne vide, hvordan de synkroniseres og vælger et logisk tidspunkt?
MT: – De synkroniseres meget enkelt. Når en shard modtager afterClusterTime og ikke finder tiden i oploggen – initierer den no approved. Det betyder, at den manuelt justerer sin tid op til dette niveau. Dette betyder, at den ikke har nogen begivenheder, der svarer til denne forespørgsel. Den skaber denne begivenhed kunstigt og bliver dermed Causal Consistent.
Q: – Hvad nu hvis der efterfølgende kommer nogle begivenheder, som er forsvundet et sted i netværket?
MT: – Shard er sådan indrettet, at de ikke vil komme, fordi det er single master. Hvis den allerede har skrevet, vil de ikke komme, men vil komme bagefter. Det kan ikke ske, at noget har hængt, så laver den no write, og derefter kommer disse begivenheder – og Causal consistency bliver brudt. Når den laver no write, skal de alle komme videre (den vil vente på dem).
Q: – Jeg har nogle spørgsmål omkring køer. Causal consistency forudsætter, at der er en bestemt rækkefølge af handlinger, der skal udføres. Hvad sker der, hvis vi mister en pakke? Her kom 10., 11... 12. forsvandt, men alle de andre venter på, at den bliver udført. Hvis vores maskine pludselig dør, kan vi ikke gøre noget. Er der en maksimal længde på køen, der akkumuleres, før den udføres? Hvad for en fatal fejl opstår ved tab af en enkelt tilstand? Desuden, hvis vi skriver, at der er en tidligere tilstand, så må vi jo basere os på den? Men vi er ikke baseret på den!
MT: – Også et glimrende spørgsmål! Hvad gør vi? I MongoDB er der en forståelse af quorum-optegnelser, quorum-læsninger. Under hvilke omstændigheder kan en besked forsvinde? Når optegnelsen ikke er quorum-baseret, eller når læsningen ikke er quorum-baseret (kan også medføre en del junk).
Vi har udført en omfattende eksperimentel undersøgelse af Causal consistency, som viste, at når både skrivning og læsning er non-quorum, opstår der overtrædelser af Causal consistency. Præcis det, du nævner!
Vores råd: brug i det mindste quorum-læsning ved anvendelse af Causal consistency. På den måde går der ikke noget tabt, også selvom quorum-skrivningen forsvinder... Dette er en orthogonal situation: hvis en bruger ikke ønsker at miste data, skal der anvendes quorum-skrivning. Causal consistency giver ikke garantier for holdbarhed. Holdbarhed garanteres af replication og det udstyr, der er relateret til replication.
Q: – Når vi opretter en instans, der udfører sharding (ikke master, men slave derfor), baserer den sig på tidsstemplet fra dens egen maskine eller tiden fra "master"; synkroniseres det første gang eller periodisk?
MT: – Jeg vil præcisere. En shard (dvs. en horisontal partition) har altid en Primary. Og i en shard kan der være "master" og der kan være replikaer. Men shard'en skal altid understøtte skrivning, fordi den skal opretholde et bestemt domæne (der står en Primary i shard'en).
Q: – Så alt afhænger fuldstændigt af "master"? Bruges der altid "master"-tid?
MT: – Ja. Man kan metaforisk sige: uret tikker, når der skrives til "master", i "Optog".
Q: – Vi har en kunde, der forbinder sig, og det er ikke nødvendigt for ham at vide noget om tiden?
MT: – Overhovedet ikke! Hvis vi taler om, hvordan det fungerer for klienten: når kunden ønsker at bruge Causal consistency, skal han åbne en session. Lige nu er alt der: transaktioner i sessionen og retrieve a rights... En session er en rækkefølge af logiske hændelser, der sker for klienten.
Hvis han åbner denne session og siger, at han ønsker Causal consistency (hvis sessionen som standard understøtter Causal consistency), fungerer alt automatisk. Driveren husker dette tidspunkt og øger det, når den modtager en ny meddelelse. Den husker, hvilket svar den tidligere modtog fra serveren, der returnerede data. Næste forespørgsel vil indeholde afterCluster ("tid større end dette").
Kunden behøver slet ikke at vide noget! Det er helt uklar for dem. Hvis folk bruger disse funktioner, hvad kan de så gøre? For det første kan man sikkert læse fra secondaries: man kan skrive til Primary og læse fra geografisk replikerede secondaries og være sikker på, at det fungerer. Samtidig kan sessioner, der er optaget på Primary, overføres til Secondary, altså kan man bruge flere sessioner i stedet for kun én.
Q: – Med Eventual consistency er der tæt forbindelse til et nyt område inden for datalogi – CRDT (Conflict-free Replicated Data Types). Har I overvejet at integrere disse datatyper i databasen, og hvad kan I sige om dette?
MT: – Godt spørgsmål! CRDT giver mening i tilfælde af konflikter ved skrivning: i MongoDB – single master.
Q: – Jeg har et spørgsmål fra devops. I den virkelige verden er der situationer, hvor byzantinsk fejl opstår, og onde mennesker inden for det beskyttede område begynder at pille i protokollen ved at sende specielt tilpassede pakker?
MT: – Onde mennesker inde i perimeteren er som en trojansk hest! Onde mennesker inde i perimeteren kan gøre mange dårlige ting.
Q: – Det er klart, at det er forkert at lade en slags åbning i serveren, hvorigennem man kan presse en zoo af elefanter og nedbryde hele klyngen for altid… Det vil tage tid at genoprette manuelt… Det er mildt sagt forkert. På den anden side er det interessant at spørge: i det virkelige liv møder vi situationer, hvor sådanne indre angreb virkelig finder sted?
MT: – Da jeg sjældent støder på security breaches i det virkelige liv, kan jeg ikke sige – måske sker de. Men hvis vi taler om udviklerfilosofien, så mener vi: vi har en perimeter, der beskytter dem, der laver sikkerhed – det er låsen, muren; og inden for perimeteren kan man gøre, hvad man vil. Det er klart, at der er brugere, der kun kan se, og brugere, der kan slette kataloget.
Afhængig af rettighederne kan den skade, brugerne kan forårsage, være som med en mus, og nogle gange som med en elefant. Det er klart, at en bruger med fulde rettigheder kan gøre hvad som helst. En bruger med begrænsede rettigheder kan forårsage væsentligt mindre skade. Specifikt kan han ikke bryde systemet.
Q: – I den beskyttede perimeter prøver nogen at formulere uventede protokoller for serveren, så serveren kan sættes i knæ, og hvis de er heldige, måske hele klyngen… Er det nogensinde "godt" nok?
MT: – Jeg har aldrig hørt om sådanne ting. At det er muligt på den måde at overbelaste serveren – det er ikke en hemmelighed. At overbelaste den indefra, som en godkendt bruger, der kan skrive noget ind i beskeden… Det kan egentlig ikke lade sig gøre, fordi det stadig vil blive verificeret. Der er mulighed for at slukke for denne autentificering for brugere, der ikke ønsker det – så er det deres problem; de har groft sagt selv revet væggene ned, og man kan putte en elefant ind, der vil trampe… Men generelt kan man klæde sig som en reparationstekniker, komme ind og trække den ud!
Q: – Tak for præsentationen. Sergey ("Yandex"). I "Mongo" er der en konstant, der limiterer antallet af stemmende medlemmer i Replica Set, og denne konstant er lig med 7 (syv). Hvorfor er det en konstant? Hvorfor er det ikke en parameter af en slags?
MT: – Vi har Replica Set, der kan have op til 40 noder. Der er altid et flertal. Jeg ved ikke, hvilken version…
Q: – I en Replica Set kan man køre ikke-stemmende medlemmer, men stemmende – højst 7. Hvordan skal vi klare et nedbrud i dette tilfælde, hvis vores Replica Set er fordelt over 3 datacentre? Et datacenter kan sagtens gå ned, og en maskine falder også ud.
MT: – Det ligger allerede lidt uden for præsentationen. Det er et generelt spørgsmål. Måske kan jeg fortælle det senere.
Lidt reklame 🙂
Tak fordi du bliver hos os. Kan du lide vores artikler? Ønsker du at se flere interessante materialer? Støt os ved at bestille eller anbefale os til dine bekendte, , en unik analog til entry-level servere, som vi har designet til dig: (tilgængelige muligheder med RAID1 og RAID10, op til 24 kerner og op til 40 GB DDR4).
Dell R730xd til halv pris i datacenteret Equinix Tier IV i Amsterdam? Kun hos os i Holland! Dell R420 - 2x E5-2430 2.2GHz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB - fra 99 $! Læs om hvordan
Kilde: habr.com
