

Hej, Habrovtjane. Traditionelt fortsætter vi med at dele interessant materiale i takt med starten på nye kurser. I dag har vi for jer oversat en artikel om Google Cloud Spanner, i forbindelse med lanceringen af kurset. .
Oprindeligt offentliggjort i .
Som en virksomhed, der tilbyder en række cloud-baserede POS-løsninger til detailhandlere, restaurantfolk og online-sælgere verden over, bruger Lightspeed flere forskellige typer databaseplatforme til mange transaktionelle, analytiske og søgekoncepter. Hver af disse databaseplatforme har sine egne styrker og svagheder. Derfor, da Google introducerede Cloud Spanner på markedet - med lovende funktioner, der ikke er set i verden af relationelle databaser, såsom praktisk talt ubegribelig horisontal skalerbarhed og en SLA på 99,999% - kunne vi ikke lade denne mulighed gå os forbi!
For at give en omfattende oversigt over vores erfaring med Cloud Spanner samt de evalueringskriterier, vi har brugt, vil vi se på følgende emner:
- Vores evalueringskriterier
- Cloud Spanner i korte træk
- Vurdering
- Vores konklusioner
1. Vores evalueringskriterier
Før vi dykker ned i funktionerne i Cloud Spanner, dens ligheder og forskelle med andre løsninger på markedet, lad os først tale om de vigtigste use cases, vi havde i tankerne, da vi overvejede, hvor vi skulle implementere Cloud Spanner i vores infrastruktur:
- Som en erstatning for (det dominerende) traditionelle SQL-database løsning
- Som OLTP-løsning med OLAP-support
Bemærk: For enkelhedens skyld sammenligner denne artikel Cloud Spanner med MySQL-varianter af GCP Cloud SQL og Amazon AWS RDS.
Brugen af Cloud Spanner som erstatning for traditionelle SQL-database løsninger
I et miljø af traditionelle databaser, når svartiden for databaseanmodninger nærmer sig eller endda overstiger forhåndsdefinerede tærskelværdier for applikationen (for det meste på grund af stigende antal brugere og/eller anmodninger), er der flere metoder til at reducere svartiden til acceptable niveauer. Dog kræver de fleste af disse løsninger manuel indgriben.
For eksempel er det første skridt, man skal tage, at se på forskellige databaserelaterede parametre, der vedrører ydeevne, og justere dem, så de bedst muligt passer til brugsmønstrene for applikationer. Hvis dette ikke er tilstrækkeligt, kan man vælge at skalere databasen vertikalt eller horisontalt.
Vertikal skalering af en applikation indebærer at opgradere serverinstansen, vanligvis ved at tilføje flere processorer/kerner, mere RAM, hurtigere lager osv. Tilføjelse af flere hardware-ressourcer fører til en forbedring af databasens ydeevne, målt i hovedsageligt transaktioner pr. sekund og transaktioners forsinkelse for OLTP-systemer. Relationelle databasesystemer (som bruger en multitrådet tilgang), såsom MySQL, skalerer godt vertikalt.
Denne tilgang har nogle ulemper, men den mest åbenlyse er den maksimale størrelse af servere på markedet. Når man når grænsen for den største serverinstans, er der kun én vej tilbage: horisontal skalering.
Horisontal skalering er en tilgang, hvor der tilføjes flere servere til klyngen for ideelt set at øge ydeevnen lineært med antallet af tilføjede servere. De fleste af traditionelle databasesystemer skalerer dårligt horisontalt eller slet ikke. For eksempel kan MySQL skaleres horisontalt til læseoperationer ved at tilføje slave-læsere, men kan ikke skaleres horisontalt til skriveoperationer.
Derimod, på grund af sin natur kan Cloud Spanner let skaleres horisontalt med minimal indblanding.
Fuldfunktions- DBMS som en service skal vurderes fra flere vinkler. Som grundlag har vi taget den mest populære DBMS i skyen — for Google, GCP Cloud SQL, og for Amazon, AWS RDS. I vores vurdering har vi fokuseret på følgende kategorier:
- Sammenligning af funktioner: SQL, DDL, DML; forbindelsesbiblioteker/connectorer, support for transaktioner osv.
- Udviklingssupport: lethed ved udvikling og test.
- Administration Support: management of instances – for example, scaling up/down and upgrading instances; SLA, backup and restoration; security/access control.
Using Cloud Spanner as an OLTP solution with OLAP support
Although Google does not explicitly state that Cloud Spanner is intended for analytical processing, it shares some attributes with other mechanisms, such as Apache Impala & Kudu and YugaByte, which are designed for OLAP workloads.
Even if there were only a slight chance that Cloud Spanner included a horizontally scalable HTAP (Hybrid Transactional/Analytical Processing) engine with a (more or less) usable set of OLAP features, we believe it would deserve our attention.
With this in mind, we looked at the following categories:
- Data loading, indexes, and partitioning support
- Query performance and DML
2. Cloud Spanner in Brief
Google Spanner is a clustered relational database management system (RDBMS) that Google uses for several of its own services. Google made it publicly available for users of Google Cloud Platform in early 2017.
Here are some of the attributes of Cloud Spanner:
- Strongly consistent scalable cluster RDBMS: uses hardware time synchronization to ensure data consistency.
- Support for cross-table transactions: transactions can span multiple tables – not necessarily limited to a single table (unlike Apache HBase or Apache Kudu).
- Primary key-based tables: all tables must have a declared primary key (PK), which can consist of multiple columns of the table. Tabular data is stored in PK order, making it very efficient and fast for searching by PK. Like other primary key-based systems, the implementation must be modeled with careful consideration of well-thought-out use cases to achieve .
- Skiftende tabeller: tabeller kan have fysiske afhængigheder af hinanden. Rækkerne i den underordnede tabel kan matches med rækkerne i den overordnede tabel. Denne tilgang fremskynder søgningen efter relationer, der kan defineres på datamodelleringsstadiet, for eksempel ved at sammenlægge kunder og deres fakturaer.
- Indekser: Cloud Spanner understøtter sekundære indekser. Et indeks består af de indekserede kolonner og alle kolonner af primærnøgle. Hvis ønskes, kan indekset også inkludere andre ikke-indekserede kolonner. Indekset kan defineres sammen med den overordnede tabel for at fremskynde forespørgsler. Der gælder flere begrænsninger for indekser, såsom det maksimale antal ekstra kolonner, der kan gemmes i indekset. Også forespørgsler gennem indekser kan være mindre ligetil end i andre RDBMS.
Cloud Spanner vælger kun indekset automatisk i sjældne tilfælde. Især vælger Cloud Spanner ikke automatisk et sekundært indeks, hvis forespørgslen anmoder om nogen kolonner, der ikke er gemt i ».
- Service Level Agreement (SLA): implementering i én region med SLA på 99,99%; multiregionale implementeringer med SLA på 99,999%. Selvom selve service level agreement blot er en aftale og ikke en garanti, mener jeg, at Google-medarbejdere faktisk har nogle præcise data til at lave sådanne alvorlige udsagn. (Til reference betyder 99,999% 26,3 sekunder utilgængelighed af tjenesten om måneden.)
- Mere:
Bemærk: Apache Tephra-projektet tilføjer udvidet support til transaktioner i Apache HBase (som nu også implementeres i Apache Phoenix i beta-version).
3. Vores vurdering
Så vi har alle læst Googles påstande om fordelene ved Cloud Spanner – stort set ubegribelig horisontal skalering samtidig med høj konsistens og meget høj SLA. Selvom disse krav i alle tilfælde er ekstremt svære at opnå, var vores mål ikke at modbevise dem. I stedet lad os fokusere på andre aspekter, der bekymrer de fleste databasebrugere: enkelhed og brugervenlighed.
Vi har vurderet Cloud Spanner som en erstatning for Sharded MySQL
Google Cloud SQL og Amazon AWS RDS, de to mest populære OLTP-databaser på cloud-markedet, har et meget stort funktionssæt. For at skalere disse databaser ud over størrelsen af en enkelt node, skal du imidlertid opdeles applikationer. Denne tilgang skaber yderligere kompleksitet både for applikationer og administration. Vi har set på, hvordan Spanner passer ind i scenariet for at kombinere flere segmenter til én instans, og hvilke funktioner (hvis de findes), man måske må give afkald på.
Understøttelse af SQL, DML og DDL samt en connector og biblioteker?
For det første, når man arbejder med en hvilken som helst database, er det nødvendigt at oprette en datamodel. Hvis du tror, at du kan koble JDBC Spanner til dit foretrukne SQL-værktøj, vil du opdage, at du kan forespørge dine data med det, men ikke kan bruge det til at oprette tabeller eller ændringer (DDL) eller nogen indsættelses-/opdaterings-/sletningsoperationer (DML). Googles officielle JDBC understøtter hverken det ene eller det andet.
«I øjeblikket understøtter driverne ikke DML- eller DDL-kommandoer».
Spanner-dokumentation
Med GCP-konsollen er situationen ikke bedre – du kan kun sende SELECT-forespørgsler. Heldigvis findes der en JDBC-driver med støtte til DML og DDL fra fællesskabet, herunder transaktioner. . Selvom denne driver er ekstremt nyttig, vækker manglen på en egen JDBC-driver fra Google undren. Heldigvis tilbyder Google en ret omfattende understøttelse af klientbiblioteker (baseret på gRPC): C#, Go, Java, node.js, PHP, Python og Ruby.
Det næsten obligatoriske brug af brugerdefinerede API'er for Cloud Spanner (på grund af manglen på DDL og DML i JDBC) medfører nogle begrænsninger for relaterede kodeområder, såsom forbindelsespuljer eller databinding frameworks (f.eks. Spring MVC). Generelt kan du med JDBC frit vælge den foretrukne forbindelsespulje (f.eks. HikariCP, DBCP, C3PO m.fl.), som er testet og fungerer godt. I tilfælde af brugerdefinerede Spanner-API'er må vi stole på de frameworks/puljer/SESSIONER, som vi selv har oprettet.
Den primære nøgle-fokuserede konstruktion (PK) gør det muligt for Cloud Spanner at være utroligt hurtig til at tilgå data via PK, men det medfører også nogle udfordringer for forespørgsler.
- Du kan ikke opdatere værdien af primærnøglen; du skal først slette posten med den originale PK og indsætte den igen med den nye værdi. (Dette ligner andre PK-orienterede databaser/lager mekanismer.)
- Alle UPDATE- og DELETE-udtryk skal angive PK i WHERE, derfor kan der ikke være tomme DELETE all-udtryk — der skal altid være en underforespørgsel, for eksempel: UPDATE xxx WHERE id IN (SELECT id FROM table1)
- Mangel på auto-increment mulighed eller noget der ligner, der angiver sekvensen for PK-feltet. For at dette kan fungere, skal det tilsvarende værdi oprettes på applikationssiden.
Sekundære indekser?
Google Cloud Spanner har indbygget support til sekundære indekser. Dette er en meget god funktion, som ikke altid er til stede i andre teknologier. Apache Kudu understøtter pt. ikke sekundære indekser overhovedet, og Apache HBase understøtter indekser ikke direkte, men kan tilføje dem gennem Apache Phoenix.
Indekser i Kudu og HBase kan modelleres som en separat tabel med en anden sammensætning af primære nøgler, men atomariteten for operationerne udført med forældretabellen og de tilknyttede indeks-tabeller skal sikres på applikationsniveau og er ikke trivielt i en korrekt implementering.
Som nævnt i oversigten over Cloud Spanner, kan dens indekser adskille sig fra MySQL-indekser. Derfor skal man være særlig forsigtig ved opbygningen af forespørgsler og profilering for at sikre, at den rigtige indeks anvendes, hvor det er nødvendigt.
Visninger?
En meget populær og nyttig objekt i databasen er visninger. De kan være nyttige til mange forskellige brugsscenarier; mine to favoritter er logisk abstraheringsniveau og sikkerhedsniveau. Desværre understøtter Cloud Spanner IKKE visninger. Men det begrænser os kun delvist, da der ikke er detaljeret adgang til kolonneniveau, hvor visninger kan være en acceptabel løsning.
I dokumentationen for Cloud Spanner er der et afsnit, der beskriver kvoter og begrænsninger (), er der især en, der kan være problematisk for nogle applikationer: Cloud Spanner har en standardbegrænsning på maksimum 100 databaser pr. instans. Det er tydeligt, at dette kan blive en alvorlig hindring for en database, der er designet til at skalere til mere end 100 databaser. Heldigvis, efter at have talt med vores tekniske repræsentant fra Google, fandt vi ud af, at denne grænse kan øges til næsten enhver værdi via Google Support.
Understøtter udvikling?
Cloud Spanner tilbyder ganske anstændig support til programmeringssprog, der arbejder med dens API. Officielt understøttede biblioteker inkluderer C#, Go, Java, node.js, PHP, Python og Ruby. Dokumentationen er ret detaljeret, men ligesom med andre avancerede teknologier er samfundet ret lille sammenlignet med de mest populære database teknologier, hvilket kan føre til længere tid brugt på at løse mindre almindelige anvendelsestilfælde eller problemer.
Hvad med support til lokal udvikling?
Vi fandt ikke en måde at oprette en Cloud Spanner instans i et lokalt miljø. Det tætteste, vi kom, var et Docker-billede. , som i princippet ligner, men i praksis adskiller sig meget. For eksempel kan CockroachDB bruge PostgreSQL JDBC. Da udviklingsmiljøet skal være så tæt som muligt på produktionsmiljøet, er Cloud Spanner ikke ideelt, da man skal stole på en fuld Spanner instans. For at spare omkostninger kan du vælge en instans i ét region.
Understøttelse af administration?
Det er meget enkelt at oprette en Cloud Spanner instans. Du skal blot vælge mellem at oprette en multiregion eller en instans i én region, angive region(er) og antal noder. På mindre end et minut vil instansen være startet og klar til brug.
Flere grundlæggende metrikker er direkte tilgængelige på Spanner-siden i Google Console. Mere detaljerede visninger er tilgængelige via Stackdriver, hvor du også kan indstille tærskelværdier for metrikker og alarmpolitikker.
Adgang til ressourcer?
MySQL tilbyder omfattende og meget detaljerede indstillinger for brugerrettigheder/roller. Det er nemt at konfigurere adgang til en bestemt tabel eller endda blot et delmængde af dens kolonner. Cloud Spanner bruger Google Identity & Access Management (IAM) værktøjet, som gør det muligt at fastsætte politikker og tilladelser kun på et meget højt niveau. Den mest detaljerede mulighed er database-niveau tilladelse, som ikke passer ind i de fleste produktionsscenarier. Denne begrænsning tvinger dig til at tilføje ekstra sikkerhedsforanstaltninger i din kode, infrastruktur eller begge dele for at forhindre uautoriseret brug af Spanner-ressourcer.
Backups?
For at sige det simpelt, findes der ingen backups i Cloud Spanner. Selvom Googles høje SLA-krav kan garantere, at du ikke mister data på grund af hardware- eller databasefejl, gælder det ikke ved menneskelige fejl, applikationsfejl osv. Vi kender alle reglen: høj tilgængelighed er ikke en erstatning for en fornuftig backup-strategi. Lige nu er den eneste måde at lave backups på at streame dataene fra databasen til et separat lagringsmiljø.
Forespørgselsydelse?
Til dataloading og test af forespørgsler anvendte vi Yahoo! Cloud Serving Benchmark. Tabellen nedenfor viser B YCSB arbejdsbyrden med et læseforhold på 95% og et skriveforhold på 5%.
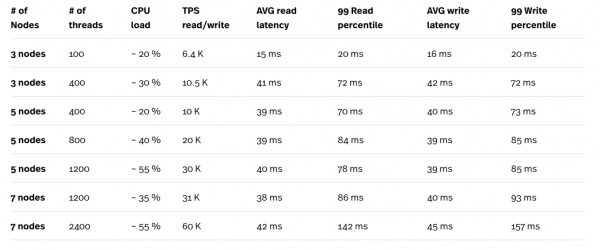
* Belastningstesten blev udført på Compute Engine (CE) n1-standard-32 (32 vCPU, 120 GB RAM), og testinstansen var aldrig flaskehalsen i testene.
** Det maksimale antal tråde i en enkelt YCSB-instans er 400. Det var nødvendigt at køre seks parallelle instanser af YCSB-testene for at opnå i alt 2400 tråde.
Når vi ser på testresultaterne, især kombinationen af CPU-belastning og TPS, kan vi tydeligt se, at Cloud Spanner skalerer ret godt. Den store belastning, der skabes af mange tråde, kompenseres af det store antal noder i Cloud Spanner-klassen. Selvom forsinkelsen ser ret høj ud, især når der arbejdes med 2400 tråde, kan gentagne tests med 6 mindre instanser af beregningsmotoren være nødvendige for at få mere præcise tal. Hver instans vil køre én YCSB-test i stedet for én stor CE-instans med 6 parallelle tests. Dette vil gøre det lettere at skelne mellem Cloud Spanner-forespørgselers forsinkelse og forsinkelsen tilføjet af netværksforbindelsen mellem Cloud Spanner og CE-instansen, hvor testen kører.
Hvordan performer Cloud Spanner som OLAP?
Partitionering?
Opdelingen af data i fysisk og/eller logisk uafhængige segmenter, kaldet partitioner, er et meget populært koncept, der er karakteristisk for de fleste OLAP-mekanismer. Partitioner kan betydeligt forbedre forespørgselsydelsen og vedligeholdelsen af databasen. En dyberegående analyse af partitioner ville kræve en separat artikel, så lad os blot nævne vigtigheden af at have en partitionerings- og sub-partitioneringsskema. Muligheden for at opdele data i partitioner og endda videre til sub-partitioner er nøglen til ydeevnen af analytiske forespørgsler.
Cloud Spanner understøtter ikke partitioner som sådan. Den opdeler data internt i såkaldte split-ter baseret på intervallet af den primære nøgle. Opdelingen sker automatisk for at balancere belastningen i Cloud Spanner-klassen. En meget praktisk funktion ved Cloud Spanner er opdelingen af den grundlæggende belastning fra forældretabellen (den tabel, der ikke overlapper med en anden). Spanner bestemmer automatisk, om split dataene læses oftere end dataene i andre split-ter, og kan træffe beslutning om yderligere opdeling. På denne måde kan flere noder involveres i forespørgslen, hvilket også effektivt øger båndbredden.
Indlæsning af data?
Cloud Spanner-metoden til store data er den samme som ved almindelig indlæsning. For at opnå den bedste ydeevne skal du følge nogle anbefalinger, herunder:
- Sorter dine data efter primærnøglen.
- Del dem op i 10*antal noder separate sektioner.
- Opret et sæt arbejdsopgaver, der indlæser data parallelt.
Ved sådan datalæsning bruges alle noder i Cloud Spanner.
Vi brugte arbejdsbelastningen A YCSB til at generere et datasæt på 10M rækker.
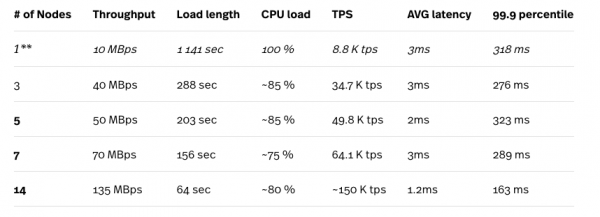
* Belastningstesten blev udført på compute engine n1-standard-32 (32 vCPU, 120 GB hukommelse), og testinstansen var aldrig et flaskehals i testene.
** Konfiguration med 1 node anbefales ikke til nogen produktionsbelastning.
Som nævnt tidligere håndterer Cloud Spanner automatisk delinger afhængigt af deres belastning, så resultaterne forbedres efter flere på hinanden følgende test. Resultaterne præsenteret her er de bedste resultater, vi fik. Ved at se på tallene ovenfor kan vi se, hvordan Cloud Spanner (godt) skalerer med et stigende antal noder i klyngen. Tallene, der fremhæves, repræsenterer ekstremt lave gennemsnitlige latenser, som står i kontrast til resultaterne fra blandede arbejdsbelastninger (95% til læsning og 5% til skrivning), som beskrevet i afsnittet ovenfor.
Skalering?
At øge og mindske antallet af Cloud Spanner-noder er en opgave, der udføres med ét klik. Hvis du hurtigt vil indlæse data, kan du overveje at booste instansen til maksimum (i vores tilfælde var det 25 noder i regionen US-EAST), og derefter mindske antallet af noder til det, der passer til din sædvanlige belastning, efter at alle data er i databasen, og med det i mente grænsen på 2 TB/node.
Vi blev mindet om denne grænse selv med en meget mindre database. Efter flere kørsel af belastningstest havde vores database en størrelse på omkring 155 GB, og ved at nedskalere til en instans med 1 node fik vi følgende fejl:
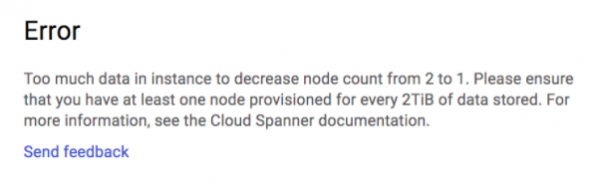
Vi kunne mindske skalaen fra 25 til 2 instanser, men vi sad fast på to noder.
Automatisering af op- og nedskalering af antallet af noder i Cloud Spanner-klyngen kan udføres ved hjælp af REST API. Dette kan være særligt nyttigt til at mindske den øgede belastning på systemet i travle perioder.
Ydelse af OLAP forespørgsler?
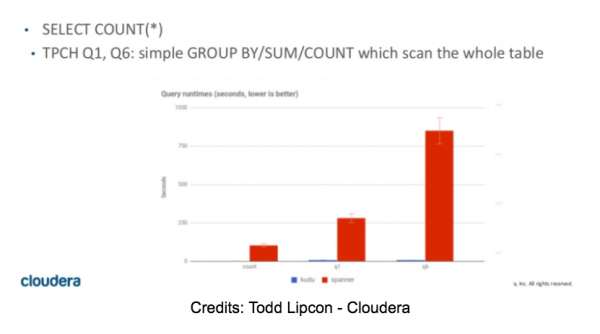
Oprindeligt havde vi planlagt at bruge betydelig tid på vores evaluering af Spanner i denne del. Efter flere SELECT COUNT indså vi hurtigt, at testningen ville være kortvarig, og at Spanner IKKE ville være en passende OLAP-motor. Uanset antallet af noder i klyngen tog en simpel forespørgsel om antallet af rækker i en tabel med 10M rækker mellem 55 og 60 sekunder. Derudover resulterede enhver forespørgsel, der krævede mere hukommelse til at gemme mellemliggende resultater, i en OOM-fejl.
SELECT COUNT(DISTINCT(field0)) FROM usertable; — (10M distinkte værdier)-> SpoolingHashAggregateIterator løb tør for hukommelse under ny række.
Nogle tal for TPC-H forespørgsler kan findes i artiklen af Todd Lipkone , slides 42 og 43. Disse tal stemmer overens med vores egne resultater (desværre).
4. Vores konklusioner
I betragtning af den nuværende tilstand af funktionerne i Cloud Spanner er det svært at forestille sig, at det vil kunne erstatte eksisterende OLTP-løsninger, især når dine behov overstiger det. Det ville kræve betydelig tid at opbygge en løsning, der tager højde for manglerne i Cloud Spanner.
Da vi begyndte at evaluere Cloud Spanner, forventede vi, at dets administrationsfunktioner ville være på niveau eller i det mindste ikke så langt fra andre Google SQL-løsninger. Men vi blev overrasket over den fuldstændige mangel på sikkerhedskopier og den meget begrænsede kontrol over ressourcerne. Ikke at tale om fraværet af visninger, manglen på en lokal udviklingsmiljø, ikke-understøttede sekvenser, JDBC uden støtte for DML og DDL og så videre.
Så, hvor skal man gå hen, når man skal skalere en transaktionsdatabase? Det ser ud til, at der endnu ikke findes én enkelt løsning på markedet, der passer til alle anvendelsesscenarier. Der er mange løsninger med både lukket og åbent kildekode (nogle af dem nævnes i denne artikel), hver med sine egne styrker og svagheder, men ingen af dem tilbyder SaaS med SLA på 99,999% og høj konsistens. Hvis et højt niveau af SLA er dit primære mål, og du ikke har lyst til at bygge din egen løsning til flere cloud-miljøer, kan Cloud Spanner være det, du leder efter. Men du skal være klar over alle dets begrænsninger.
For retfærdighedens skyld bør det nævnes, at Cloud Spanner først blev offentlig tilgængelig i foråret 2017, så det er rimeligt at forvente, at nogle af de nuværende mangler i sidste ende kan forsvinde (forhåbentlig), og når det sker, kan det ændre spillet. I sidste ende er Cloud Spanner ikke bare et tredjepartsprojekt for Google. Google bruger det som grundlag for andre Google-produkter. Og da Google for nylig erstattede Megastore i Google Cloud Storage med Cloud Spanner, gjorde det Google Cloud Storage strengt konsistent for objektlister globalt (hvilket stadig ikke gælder for ).
Så der er stadig håb... vi håber.
Det var alt. Ligesom artikelens forfatter fortsætter vi også med at håbe, hvad mener du om det? Skriv dine tanker i kommentarerne.
Alle interesserede er inviteret til at besøge vores hvor vi vil fortælle om kurset i detaljer fra OTUS.
Kilde: habr.com
