

Opdateringsprocessen for din Kubernetes-klynge
På et tidspunkt, når du bruger din Kubernetes-klynge, opstår der et behov for at opdatere de aktive noder. Dette kan inkludere opdateringer af pakker, opdatering af kernen eller implementering af nye billeder af virtuelle maskiner. I Kubernetes-terminologi kaldes dette .
Dette indlæg er en del af en cyklus på 4 indlæg:
- Dette indlæg.
- Korrekt nedlukning af pods i Kubernetes-klyngen
- Forsinket nedlukning af en pod ved dens sletning
- Hvordan man undgår nedetid i Kubernetes-klyngen ved hjælp af PodDisruptionBudgets
(note til oversætteren - oversættelser af de øvrige artikler i cyklen kan forventes snart)
I denne artikel vil vi beskrive alle de værktøjer, som Kubernetes tilbyder for at opnå nul nedetid for de noder, der kører i din klynge.
Definere problemet
I starten vil vi bruge en naiv tilgang til at definere problemerne og vurderer de potentielle risici ved denne tilgang og samle viden til at løse hvert af de problemer, vi møder i løbet af cyklen. Som resultat vil vi opnå en konfiguration, der bruger lifecycle hooks, readiness probes og Pod disruption budgets for at nå vores nul nedetid.
For at starte vores rejse, lad os tage et konkret eksempel. Antag, at vi har en Kubernetes-klynge bestående af to noder, hvor en applikation kører med to pods, der er bag Service:
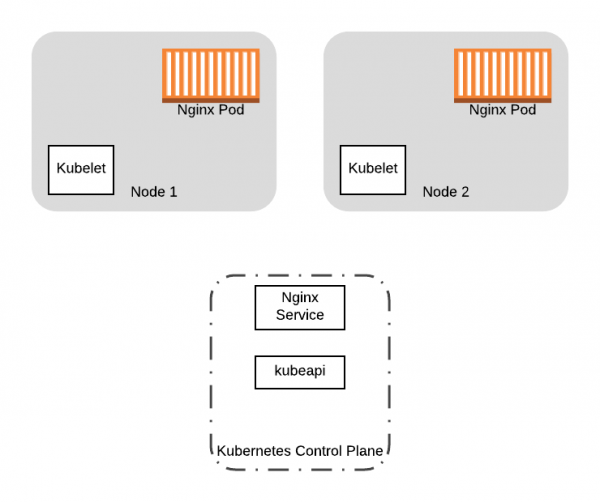
Lad os begynde med to pods med Nginx og Service, der kører på vores to noder i Kubernetes-klyngen.
Vi ønsker at opdatere kerneversionen på de to arbejdende noder i vores klynge. Hvordan gør vi det? En simpel løsning ville være at starte nye noder med den opdaterede konfiguration og derefter slukke for de gamle noder, samtidig med at de nye startes. Selvom dette vil fungere, vil der være nogle problemer med denne tilgang:
- Når du slukker for de gamle noder, vil de kørende pods også blive slukket. Hvad hvis pods skal ryddes for korrekt afbrydelse? Virtualiseringssystemet, du bruger, venter måske ikke på, at rydningsprocessen er færdig.
- Hvad hvis du slukker for alle noder samtidig? Du vil opleve en betydelig nedetid, mens pods flytter til de nye noder.
Vi har brug for en måde at migrere pods korrekt fra de gamle noder, samtidig med at vi er sikre på, at ingen af vores arbejdsprocesser er i gang, mens vi foretager ændringer for noden. Eller når vi laver en fuldstændig udskiftning af klyngen, som i eksemplet (dvs. vi erstatter VM-billederne), ønsker vi at flytte aktive applikationer fra de gamle noder til de nye. I begge tilfælde ønsker vi at forhindre planlægning af nye pods på de gamle noder, og derefter fjerne alle kørende pods fra dem. For at opnå disse mål kan vi bruge kommandoen kubectl drain.
Flytning af alle pods fra noden
Drain-operationen tillader os at flytte alle pods fra noden. Under udførelsen af drain bliver noden markeret som unschedulable (flag i kubectl. Angiv nøgle og værdi, og derefter en taint såsom). Dette forhindrer nye pods i at blive planlagt på den. Derefter begynder drain at fjerne pods fra noden, afslutter arbejdet i de containere, der i øjeblikket kører på noden ved at sende signalet TERM til containere i pod'en.
Selvom kubectl drain Selvom den klarer at fjerne pods, er der yderligere to faktorer, som kan resultere i, at drain-operationen mislykkes:
- Din applikation skal kunne afsluttes korrekt, når der sendes
TERMet signal. Når pods flyttes, sender Kubernetes et signalTERMtil containerne og venter et angivet tidsrum på, at de stopper, hvorefter de, hvis de ikke er stoppet, afsluttes med tvang. Uanset hvad, hvis din container ikke reagerer korrekt på signalet, kan du stadig slukke for pods inkorrekt, hvis de i det specifikke øjeblik kører (f.eks. hvis der er en transaktion i databasen). - Du mister alle pods, der indeholder din applikation. Den kan være utilgængelig, når de nye containere startes på de nye noder, eller hvis dine pods er blevet distribueret uden controllere, kan de måske slet ikke genstartes.
Undgå nedetid
For at minimere nedetiden fra frivillig forstyrrelse, som f.eks. fra drain-operationen for noden, giver Kubernetes følgende muligheder for fejlhåndtering:
I de øvrige dele af cyklussen vil vi bruge disse Kubernetes-funktioner til at mindske konsekvenserne ved flytning af pods. For at følge hovedideen lettere, vil vi bruge vores ovenstående eksempel med følgende ressourcekonfiguration:
---
apiVersion: apps/v1
kind: Deployment
metadata:
 name: nginx-deployment
 labels:
   app: nginx
spec:
 replicas: 2
 selector:
   matchLabels:
     app: nginx
 template:
   metadata:
     labels:
       app: nginx
   spec:
     containers:
     - name: nginx
       image: nginx:1.15
       ports:
       - containerPort: 80
---
kind: Service
apiVersion: v1
metadata:
 name: nginx-service
spec:
 selector:
   app: nginx
 ports:
 - protocol: TCP
   targetPort: 80
   port: 80
Denne konfiguration er et minimalt eksempel Deployment, der styrer nginx pods i klyngen. Desuden beskriver konfigurationen en ressource Service, som kan bruges til at tilgå nginx pods i klyngen.
I løbet af cyklen vil vi iterativt udvide denne konfiguration, så den til sidst inkluderer alle de funktioner, som Kubernetes tilbyder for at reducere nedetid.
For at få en fuldt implementeret og testet version af opdateringerne til Kubernetes-klyngen for nul nedetid på AWS og andre ressourcer, besøg .
Læs også andre artikler på vores blog:
Kilde: habr.com
