

Bem. overs.: I denne artikel deler Banzai Cloud et eksempel på brugen af deres specialværktøjer til at lette driften af Kafka i Kubernetes. De angivne instruktioner illustrerer, hvordan man kan bestemme den optimale størrelse på infrastrukturen og konfigurere Kafka for at opnå den ønskede gennemstrømning.
Apache Kafka er en distribueret streamingplatform til oprettelse af pålidelige, skalerbare og højtydende realtids-streamingsystemer. Dets imponerende funktioner kan udvides med Kubernetes. Til dette har vi udviklet og et værktøj kaldet . De muliggør kørsel af Kafka i Kubernetes og brug af dens forskellige funktioner, såsom finjustering af broker-konfiguration, skalering baseret på metrics med rebalance, rack awareness, 'bløde' (graceful) opdateringer osv.
Prøv Supertubes i din klynge:
curl https://getsupertubes.sh | sh og supertubes install -a --no-democluster --kubeconfigEller kontakt . Du kan også læse om nogle af de funktioner i Kafka, som er automatiseret ved hjælp af Supertubes og Kafka-operatoren. Det har vi allerede skrevet i bloggen:
- ;
- ;
- ;
- ;
- ;
- ;
- .
Når du beslutter at implementere en Kafka-klynge i Kubernetes, vil du sandsynligvis støde på udfordringen ved at bestemme den optimale størrelse af den underliggende infrastruktur og behovet for finjustering af Kafka-konfigurationen for at imødekomme kravene til gennemstrømningskapacitet. Den maksimale ydeevne af hver broker bestemmes af ydeevnen af de infrastrukturelle komponenter, den er baseret på, såsom hukommelse, processor, diskhastighed, netværksbåndbredde osv.
Ideelt set bør brokerkonfigurationen være sådan, at alle infrastrukturkomponenter udnyttes maksimalt. Men i virkeligheden er en sådan opsætning ganske kompleks. Det er mere sandsynligt, at brugere vil konfigurere brokerne for at maksimere brugen af én eller to komponenter (disk, hukommelse eller processor). Generelt viser en broker maksimal ydeevne, når dens konfiguration gør det muligt at udnytte den langsomste komponent "fuldt ud". Således kan vi få et omtrentligt indtryk af den belastning, en enkelt broker kan håndtere.
Teoretisk set kan vi også estimere antallet af brokere, der er nødvendige for at håndtere en given belastning. Men i praksis er der så mange konfigurationsmuligheder på forskellige niveauer, at det er svært (om ikke umuligt) at vurdere den potentielle ydeevne af en given konfiguration. Med andre ord er det meget udfordrende at planlægge en konfiguration baseret på en bestemt ydeevne.
For brugere af Supertubes anvender vi typisk følgende tilgang: vi starter med en vis konfiguration (infrastruktur + indstillinger), måler dens ydeevne, justerer brokerindstillingerne og gentager processen. Dette sker, indtil potentialet i den langsomste infrastrukturkomponent er fuldt udnyttet.
På denne måde får vi et klarere billede af, hvor mange brokerne der er nødvendige for klyngen til at håndtere en bestemt belastning (antallet af brokerne afhænger også af andre faktorer, såsom minimum antal meddelelse-replikker for at sikre robusthed, antal partition-ledere osv.). Derudover får vi indsigt i, hvilken infrastrukturkomponent der kræver vertikal skalering.
I denne artikel vil vi tale om de skridt, vi tager for at "trække det maksimale" ud af de langsomste komponenter i de indledende konfigurationer og måle gennemstrømningen i Kafka-klyngen. En højtilgængelig konfiguration kræver, at der er mindst tre fungerende brokere.min.insync.replicas=3), som er fordelt over tre forskellige tilgængelighedszoner. Til opsætning, skalering og overvågning af Kubernetes-infrastrukturen bruger vi vores egen containerstyringsplatform til hybride cloudløsninger — . Den understøtter on-premise (bare metal, VMware) og fem cloudtyper (Alibaba, AWS, Azure, Google, Oracle), samt alle deres kombinationer.
Overvejelser vedrørende infrastruktur og konfiguration af Kafka-klyngen
For eksemplerne nedenfor har vi valgt AWS som cloudtjenesteudbyder og EKS som Kubernetes-distribution. En lignende konfiguration kan implementeres ved hjælp af — en Kubernetes-distribution fra Banzai Cloud, der er CNCF-certificeret.
Disk
Amazon tilbyder forskellige . I bunden af gp2 og io1 ligger SSD-diske, men for at sikre høj gennemstrømning gp2 forbruger opsparede kreditter (I/O credits), så vi foretrak den type io1, der tilbyder stabil høj gennemstrømning.
Instance-typer
Ydelsen fra Kafka afhænger i høj grad af operativsystemets sidecache, så vi har brug for instanser med tilstrækkelig hukommelse til mæglere (JVM) og sidecache. Instansen c5.2xlarge — er et godt udgangspunkt, da den har 16 GB hukommelse og . Dens ulempe er, at den kan levere maksimal ydelse i højst 30 minutter hver 24. time. Hvis arbejdsbyrden kræver maksimal ydelse over en længere periode, bør man overveje andre instanstyper. Det er netop, hvad vi gjorde, ved at vælge c5.4xlarge. Den sikrer maksimal gennemstrømning på 593,75 MB/s. Den maksimale gennemstrømning af EBS-volumenet io1 er højere end for instansen c5.4xlarge, så det langsomste element i infrastrukturen ser ud til at være I/O-gennemstrømningen for denne instans type (hvilket også bør bekræftes af resultaterne fra vores belastningstests).
Netværk
Netværkets gennemstrømning skal være stor nok sammenlignet med ydelsen af VM-instansen og disken, ellers bliver netværket en flaskehals. I vores tilfælde understøtter netværksgrænsefladen c5.4xlarge hastigheder op til 10 Gbps, hvilket er betydeligt højere end I/O-gennemstrømningen for VM-instansen.
Implementering af mæglere
Brokere skal implementeres (planlægges i Kubernetes) på dedikerede noder for at undgå konkurrence med andre processer om ressourcer som CPU, hukommelse, netværk og disk.
Java-version
Et logisk valg er Java 11, da den er kompatibel med Docker på den måde, at JVM korrekt identificerer de processorer og den hukommelse, der er tilgængelig for den container, hvori brokeren kører. Da processorbegrænsninger er vigtige, indstiller JVM internt og transparent antallet af GC-tråde og JIT-kompilatortråde. Vi har brugt billedet Kafka banzaicloud/kafka:2.13-2.4.0, som inkluderer version Kafka 2.4.0 (Scala 2.13) på Java 11.
Hvis du ønsker at lære mere om Java/JVM på Kubernetes, se venligst følgende vores publikationer:
- ;
- .
Brokers hukommelseskonfiguration
Der er to nøgleaspekter ved konfigurationen af brokers hukommelse: indstillinger for JVM og for Kubernetes pod'en. Hukommelsesgrænsen, der er indstillet for pod'en, skal være større end den maksimale heap-størrelse, så der for JVM er plads til Java's metaplas, som befinder sig i sin egen hukommelse, og til operativsystemets sidecache, som Kafka aktivt bruger. I vores tests har vi kørt Kafka-brokere med indstillingerne -Xmx4G -Xms2G, mens hukommelsesgrænsen for pod'en var 10 Gi. Vær opmærksom på, at hukommelsesindstillinger for JVM automatisk kan opnås via -XX:MaxRAMPercentage og -X:MinRAMPercentage, baseret på hukommelsesgrænsen for pod'en.
Brokers processorindstillinger
Generelt kan produktiviteten øges ved at øge parallelismen ved at øge antallet af tråde, der bruges af Kafka. Jo flere processorer der er tilgængelige for Kafka, jo bedre. I vores test startede vi med en grænse på 6 processorer og steg gradvist (iterativt) op til 15. Derudover satte vi num.network.threads=12 i brokerens indstillinger for at øge antallet af tråde, der modtager data fra netværket og sender dem. Da vi straks opdagede, at sekventielle brokere ikke kunne modtage replikaer hurtigt nok, hævede vi num.replica.fetchers til 4 for at øge hastigheden, hvormed sekventielle brokere replikerede meddelelser fra ledere.
Belastningsgenereringsværktøj
Det skal sikres, at potentialet for den valgte belastningsgenerator ikke udtømmes, før Kafka-klusteret (den benchmark, der udføres) når sin maksimale belastning. Med andre ord er det nødvendigt at lave en forhåndsvurdering af belastningsgenereringsværktøjets kapaciteter samt vælge instans-typer med tilstrækkeligt antal processorer og hukommelse. I dette tilfælde vil vores værktøj producere mere belastning, end Kafka-klusteret kan håndtere. Efter mange forsøg er vi endt på tre instanser c5.4xlarge, hvor hver har haft generatoren kørende.
Benchmarking
Ydelsesmåling er en iterativ proces, der inkluderer følgende faser:
- opsætning af infrastrukturen (EKS kluster, Kafka kluster, belastningsgenereringsværktøjet, samt Prometheus og Grafana);
- generering af belastning i en bestemt periode for at filtrere tilfældige udsving i de indsamlede præstationsdata;
- justering af infrastrukturen og konfigurationen af broker baseret på de observerede præstationsdata;
- gentagelse af processen, indtil det krævede niveau af båndbredde i Kafka-klusteret er nået. Det skal være stabilt reproducérbart og vise minimale variationer i båndbredden.
I følgende sektion beskrives de trin, der blev udført i benchmarking-processen for testklusteret.
Værktøjer
For hurtig implementering af basisopsætning, generering af belastning og måling af ydeevne blev følgende værktøjer brugt:
- til oprettelse af EKS klusteret fra Amazon med (til indsamling af Kafka og infrastruktur metrics) og (til visualisering af disse metrics). Vi benyttede os af integrerede i tjenester, der tilbyder fødereret overvågning, centraliseret logindsamling, sårbarhedsscanning, genopretning efter fejl, sikkerhed i virksomhedsklasse og meget mere.
- — værktøj til belastningstest af Kafka-klusteret.
- Grafana paneler til visualisering af Kafka- og infrastrukturmetrics: , .
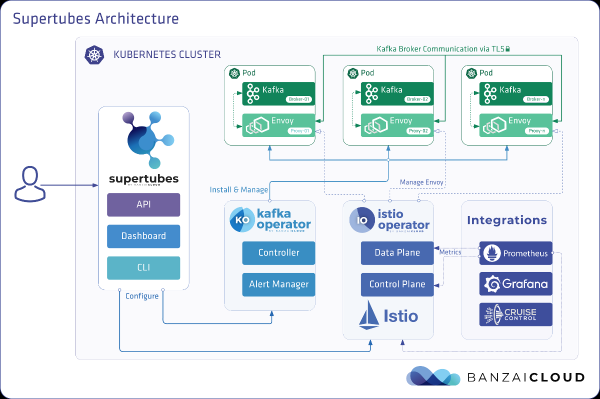
- Supertubes CLI til maks simpel konfiguration af et Kafka-kluster i Kubernetes. Zookeeper, Kafka-operator, Envoy og mange andre komponenter er installeret og korrekt konfigureret til at køre et produktionsklar Kafka-kluster i Kubernetes.
- For installation supertubes CLI følg vejledningen i .
EKS-kluster
Forbered EKS-klusteret med dedikerede arbejdstagere c5.4xlarge i forskellige tilgængelighedszoner for pod'ene med Kafka-brokkere, samt dedikerede noder til belastningstesteren og overvågningsinfrastrukturen.
banzai cluster create -f https://raw.githubusercontent.com/banzaicloud/kafka-operator/master/docs/benchmarks/infrastructure/cluster_eks_202001.jsonNår EKS-klusteret er oppe at køre, skal du aktivere den integrerede — den vil implementere Prometheus og Grafana i klusteret.
Kafka-systemkomponenter
Installer Kafka-systemkomponenterne (Zookeeper, kafka-operator) i EKS ved hjælp af supertubes CLI:
supertubes install -a --no-democluster --kubeconfigKafka-kluster
Som standard anvendes EBS-volumener af typen gp2, så det er nødvendigt at oprette en særskilt lagerklasse baseret på volumener io1 til Kafka-klusteret:
kubectl create -f - <<EOF
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: fast-ssd
provisioner: kubernetes.io/aws-ebs
parameters:
  type: io1
  iopsPerGB: "50"
  fsType: ext4
volumeBindingMode: WaitForFirstConsumer
EOF
Sæt en parameter for brokeren min.insync.replicas=3 og implementer pod'ene med brokere på noder i tre forskellige tilgængelighedszoner:
supertubes cluster create -n kafka --kubeconfig -f https://raw.githubusercontent.com/banzaicloud/kafka-operator/master/docs/benchmarks/infrastructure/kafka_202001_3brokers.yaml --wait --timeout 600Emner
Vi kørte samtidig tre instanser af belastningstesteren. Hver af dem skriver til sit eget emne, dvs. vi har i alt brug for tre emner:
supertubes cluster topic create -n kafka --kubeconfig  -f -<<EOF
apiVersion: kafka.banzaicloud.io/v1alpha1
kind: KafkaTopic
metadata:
  name: perftest1
spec:
  name: perftest1
  partitions: 12
  replicationFactor: 3
  retention.ms: '28800000'
  cleanup.policy: delete
EOF

supertubes cluster topic create -n kafka --kubeconfig  -f -<<EOF
apiVersion: kafka.banzaicloud.io/v1alpha1
kind: KafkaTopic
metadata:
    name: perftest2
spec:
  name: perftest2
  partitions: 12
  replicationFactor: 3
  retention.ms: '28800000'
  cleanup.policy: delete
EOF

supertubes cluster topic create -n kafka --kubeconfig  -f -<<EOF
apiVersion: kafka.banzaicloud.io/v1alpha1
kind: KafkaTopic
metadata:
  name: perftest3
spec:
  name: perftest3
  partitions: 12
  replicationFactor: 3
  retention.ms: '28800000'
  cleanup.policy: delete
EOF
For hvert emne er replikeringsfaktoren 3 — den minimum anbefalede værdi for højt tilgængelige produktionssystemer.
Belastningsgenereringsværktøj
Vi startede tre instanser af belastningsgeneratoren (hver skrev til et separat emne). For pod'erne til belastningsgeneratoren er det nødvendigt at angive node affinity, så de kun planlægges på de dedikerede noder:
apiVersion: extensions/v1beta1
kind: Deployment
metadata:
  labels:
    app: loadtest
  name: perf-load1
  namespace: kafka
spec:
  progressDeadlineSeconds: 600
  replicas: 1
  revisionHistoryLimit: 10
  selector:
    matchLabels:
      app: loadtest
  strategy:
    rollingUpdate:
      maxSurge: 25%
      maxUnavailable: 25%
    type: RollingUpdate
  template:
    metadata:
      creationTimestamp: null
      labels:
        app: loadtest
    spec:
      affinity:
        nodeAffinity:
          requiredDuringSchedulingIgnoredDuringExecution:
            nodeSelectorTerms:
            - matchExpressions:
              - key: nodepool.banzaicloud.io/name
                operator: In
                values:
                - loadgen
      containers:
      - args:
        - -brokers=kafka-0:29092,kafka-1:29092,kafka-2:29092,kafka-3:29092
        - -topic=perftest1
        - -required-acks=all
        - -message-size=512
        - -workers=20
        image: banzaicloud/perfload:0.1.0-blog
        imagePullPolicy: Always
        name: sangrenel
        resources:
          limits:
            cpu: 2
            memory: 1Gi
          requests:
            cpu: 2
            memory: 1Gi
        terminationMessagePath: /dev/termination-log
        terminationMessagePolicy: File
      dnsPolicy: ClusterFirst
      restartPolicy: Always
      schedulerName: default-scheduler
      securityContext: {}
      terminationGracePeriodSeconds: 30
Nogle punkter, der er værd at bemærke:
- Belastningsgeneratoren genererer meddelelser af 512 byte og publicerer dem i Kafka i partier på 500 meddelelser.
- Ved hjælp af argumentet
-required-acks=allanses publiceringen for at være vellykket, når alle synkroniserede replikaer af meddelelsen er blevet modtaget og bekræftet af Kafka-brokere. Det betyder, at vi i benchmarket målte ikke kun hastigheden på lederne, der modtog meddelelser, men også deres efterfølgere, der replikerede meddelelser. Formålet med denne test er ikke at vurdere forbrugerens hastighed (consumers) af nyligt modtagne meddelelser, der stadig er i OS's sidecache, og sammenligne det med hastigheden for at læse meddelelser, der er gemt på disken. - Belastningsgeneratoren kører samtidig 20 workere (
-workers=20). Hver worker indeholder 5 producenter, som deler forbindelsen fra workeren til Kafka-klusteret. I alt har hver generator 100 producenter, og de sender alle meddelelser til Kafka-klusteret.
Overvågning af klusterets tilstand
Under load testing of the Kafka cluster, we also monitored its health to ensure no pod restarts, desynchronized replicas, and maximum throughput with minimal fluctuations.
- The load generator reports standard statistics on the number of published messages and error rates. The error percentage should remain at
0,00%. - , deployed by the kafka-operator, provides a monitoring dashboard where we can also observe the state of the cluster. To view this dashboard, run:
supertubes cluster cruisecontrol show -n kafka --kubeconfig - ISR level (the number of 'in-sync' replicas) shrink and expansion equals 0.
Measurement results
3 brokers, message size — 512 bytes
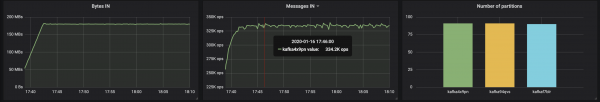
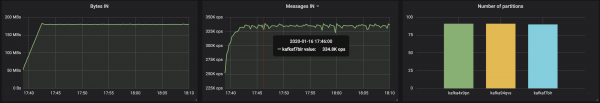
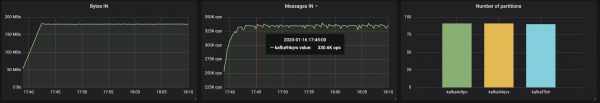
With partitions evenly distributed across three brokers, we were able to achieve a performance of ~500 MB/s (approximately 990 thousand messages per second):
The JVM virtual machine's memory consumption did not exceed 2 GB:
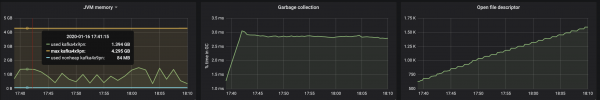
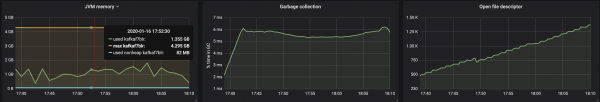
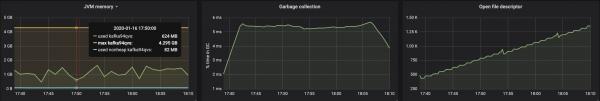
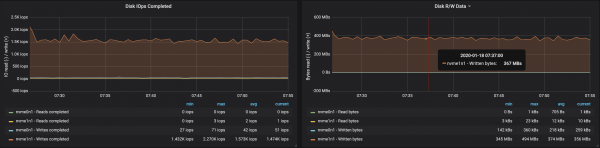
The disk throughput reached the maximum I/O capacity of the node on all three instances where the brokers were running:
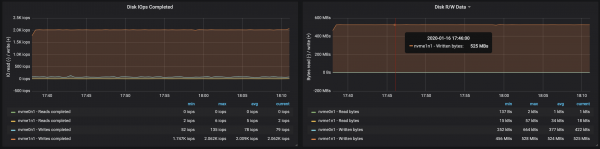
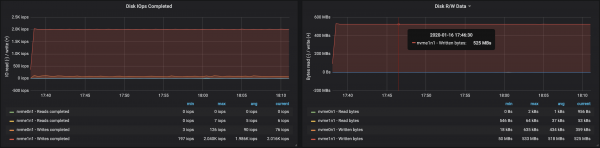
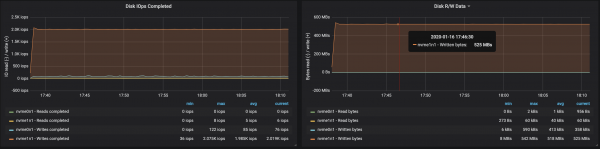
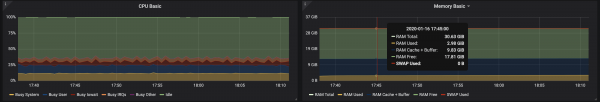
From the memory usage data on the nodes, it appears that system buffering and caching took up ~10-15 GB:
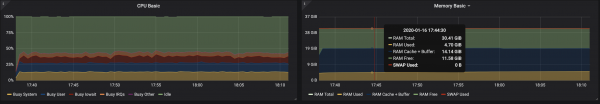
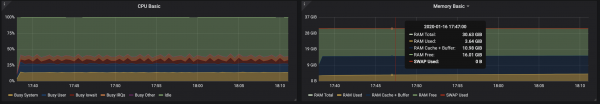
3 brokers, message size — 100 bytes
With the decrease in message size, the throughput drops by approximately 15-20% due to the time spent processing each message. Additionally, CPU load nearly doubled.
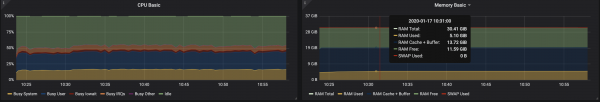
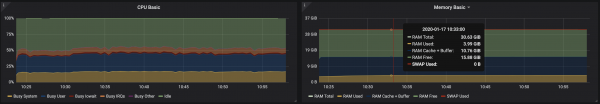
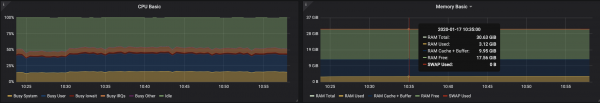
Since the broker nodes still have unused cores, performance can be improved by adjusting the Kafka configuration. This is a challenging task, so for increased throughput, it is better to work with larger messages.
4 brokers, message size — 512 bytes
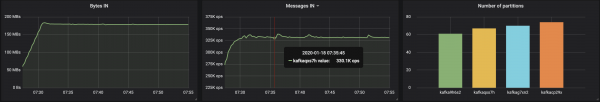
Cluster performance can be easily increased by simply adding new brokers and maintaining a balance of partitions (this ensures an even distribution of traffic among brokers). In our case, after adding a broker, the cluster's throughput increased to ~580 MB/s (~1.1 million messages per second). The increase was less than expected; primarily explained by the imbalance of partitions (not all brokers are operating at peak capability).
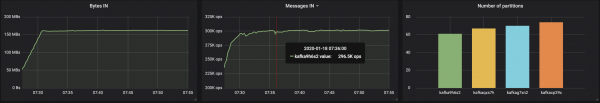
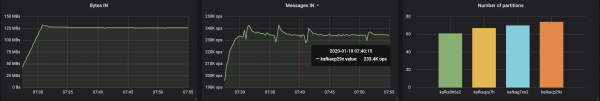
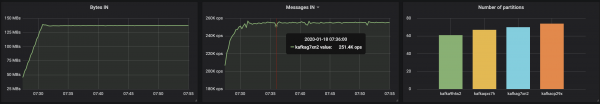
JVM-maskinens hukommelsesforbrug forbliver under 2 GB:
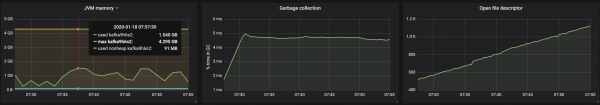
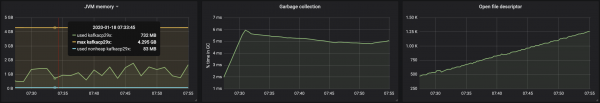
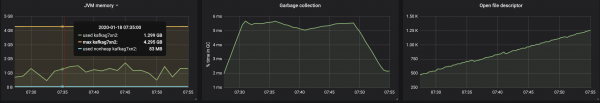
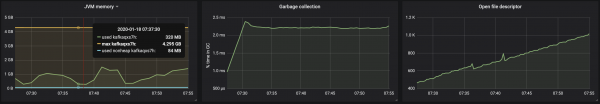
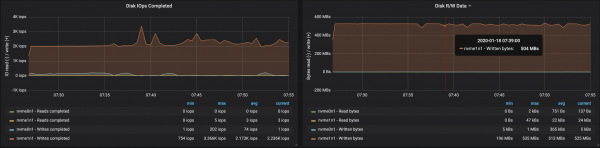
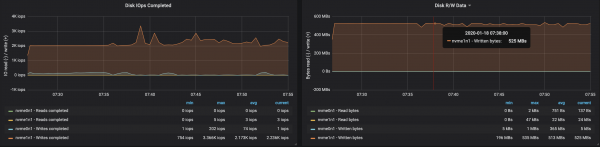
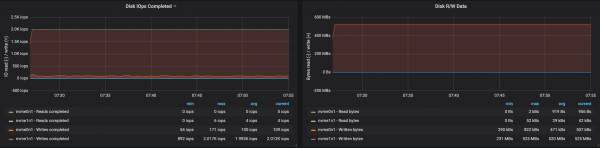
Brokerne blev påvirket af ubalancen i partitionerne:
Konklusioner
Den iterative tilgang præsenteret ovenfor kan udvides til at dække mere komplekse scenarier, der involverer hundreder af forbrugere, repartitionering, rullende opdateringer, genstart af pods osv. Alt dette gør det muligt for os at vurdere grænserne for Kafka-klusterets ydeevne under forskellige forhold, identificere flaskehalse i dets drift og finde løsninger på dem.
Vi har udviklet Supertubes til hurtig og nem implementering af klusteret, konfiguration, tilføjelse/fjernelse af brokere og emner, reaktion på advarsler og sikring af korrekt drift af Kafka i Kubernetes som helhed. Vores mål er at hjælpe med at fokusere på den primære opgave ("generere" og "forbruge" Kafka-beskeder), mens alt det tunge arbejde overlades til Supertubes og Kafka-operatøren.
Hvis du er interesseret i teknologi og Open Source-projekter fra Banzai Cloud, så følg virksomheden på , eller .
P.S. fra oversætteren
Læs også på vores blog:
- «»;
- «»;
- «».
Kilde: habr.com
