

Oversættelsen er specielt udarbejdet til studerende på kurset .
I de seneste par uger har vi tilføjet til det binære streamingsformat, som supplerer det eksisterende random access/IPC filformat. Vi har implementeringer i Java og C++ samt Python-bindings. I denne artikel vil jeg forklare, hvordan formatet fungerer, og vise, hvordan man kan opnå en meget høj datagennemstrømning for pandas DataFrame.
Streaming af kolonnebaserede data
Et almindeligt spørgsmål, jeg får fra Arrow-brugere, er om de høje omkostninger ved at overføre store sæt tabulære data fra række- eller postorienteret format til kolonneformat. For multigigabyte datasæt kan transponering i hukommelsen eller på disken være en umulig opgave.
Til data streaming, uanset om de oprindelige data er række- eller kolonnebaserede, er en mulighed at sende små pakker af rækker, hvor hver indeholder en kolonnebaseret opstilling.
I Apache Arrow kaldes en samling af kolonne-arrays i hukommelsen, der repræsenterer en chunk af en tabel, en record batch. For at repræsentere en ensartet datastruktur for en logisk tabel kan flere record batches samles.
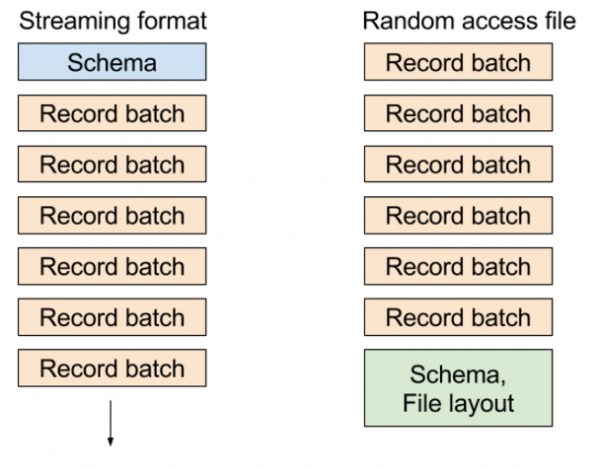
I det eksisterende random access filformat skriver vi metadata, der indeholder tabellens schema og placeringen af blokke i slutningen af filen, hvilket giver dig mulighed for at vælge enhver record batch eller kolonne fra datasættet meget billigt. I stream formatet sender vi en serie af beskeder: schemaet og derefter en eller flere record batches.
De forskellige formater ser omtrent sådan ud, som vist på dette billede:
Data streaming i PyArrow: Anvendelse
For at vise dig, hvordan dette fungerer, vil jeg oprette et eksempel datasæt, der repræsenterer en streaming chunk:
import time
import numpy as np
import pandas as pd
import pyarrow as pa

def generate_data(total_size, ncols):
    nrows = int(total_size / ncols / np.dtype('float64').itemsize)
    return pd.DataFrame({
        'c' + str(i): np.random.randn(nrows)
        for i in range(ncols)
    })
Nu, lad os antage, at vi ønsker at skrive 1 GB data bestående af chunks på 1 MB hver, i alt 1024 chunks. Lad os starte med at oprette den første DataFrame på 1 MB med 16 kolonner:
KILOBYTE = 1 << 10
MEGABYTE = KILOBYTE * KILOBYTE
DATA_SIZE = 1024 * MEGABYTE
NCOLS = 16

df = generate_data(MEGABYTE, NCOLS)
Derefter konverterer jeg dem til pyarrow.RecordBatch:
batch = pa.RecordBatch.from_pandas(df) Nu vil jeg oprette en output-stream, der skriver til RAM, og jeg vil oprette StreamWriter:
sink = pa.InMemoryOutputStream()
stream_writer = pa.StreamWriter(sink, batch.schema)
Derefter skriver vi 1024 chunks, hvilket i alt vil udgøre 1 GB af datasættet:
for i in range(DATA_SIZE // MEGABYTE):
    stream_writer.write_batch(batch)
Da vi har skrevet til RAM, kan vi få hele streamen i én buffer:
In [13]: source = sink.get_result()

In [14]: source
Out[14]:

In [15]: source.size
Out[15]: 1074750744
Da disse data er i hukommelsen, er læsning af Arrow-records zero-copy operation. Jeg åbner StreamReader og læser dataene ind i pyarrow.Table, og derefter konverterer jeg dem til DataFrame pandas:
In [16]: reader = pa.StreamReader(source)

In [17]: table = reader.read_all()

In [18]: table
Out[18]:

In [19]: df = table.to_pandas()

In [20]: df.memory_usage().sum()
Out[20]: 1073741904
Alt dette er selvfølgelig godt, men du har måske spørgsmål. Hvor hurtigt sker det? Hvordan påvirker chunk-størrelsen ydelsen ved at hente DataFrame pandas?
Ydelse ved streaming data
Når chunk-størrelsen mindskes, stiger omkostningerne ved at rekonstruere en kontinuerlig kolonneframe af DataFrame i pandas på grund af ineffektive cache-adgangsmønstre. Der er også nogle overhead omkostninger ved at arbejde med C++ datakonstruktioner og deres hukommelsesbuffer.
For 1 MB, som nævnt ovenfor, får jeg på min bærbare computer (Quad-core Xeon E3-1505M):
In [20]: %timeit pa.StreamReader(source).read_all().to_pandas()
10 loops, best of 3: 129 ms per loop
Så effektiv båndbredde er 7,75 GB/s for at genskabe en DataFrame på 1 GB fra 1024 chunks af 1 MB. Hvad sker der, hvis vi bruger større eller mindre chunks? Her er resultaterne:
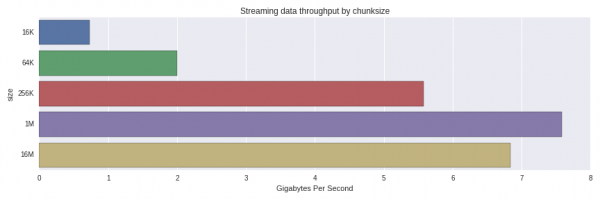
Ydelsen falder markant fra 256K til 64K chunks. Jeg var overrasket over, at chunks på 1 MB blev behandlet hurtigere end 16 MB. Det kan være værd at gennemføre en grundigere undersøgelse for at forstå, om dette er en normal fordeling, eller om der er andre faktorer på spil.
I den nuværende implementering af formatet komprimeres dataene ikke overhovedet, så størrelsen i hukommelsen og 'i kablerne' er nogenlunde den samme. I fremtiden kan kompression blive en yderligere mulighed.
Resultat
Streaming af kolonnedata kan være en effektiv måde at overføre store datamængder til kolonneanalytiske værktøjer som pandas ved hjælp af små chunks. Datatjenester, der bruger rækkeorienterede lagre, kan overføre og transponere små datachunks, som er mere effektive for L2 og L3 cachen i din processor.
Fuld kode
import time
import numpy as np
import pandas as pd
import pyarrow as pa

def generate_data(total_size, ncols):
    nrows = total_size // ncols // np.dtype('float64').itemsize
    return pd.DataFrame({
        'c' + str(i): np.random.randn(nrows)
        for i in range(ncols)
    })

KILOBYTE = 1 << 10
MEGABYTE = KILOBYTE * KILOBYTE
DATA_SIZE = 1024 * MEGABYTE
NCOLS = 16

def get_timing(f, niter):
    start = time.clock_gettime(time.CLOCK_REALTIME)
    for i in range(niter):
        f()
    return (time.clock_gettime(time.CLOCK_REALTIME) - start) / NITER

def read_as_dataframe(klass, source):
    reader = klass(source)
    table = reader.read_all()
    return table.to_pandas()
NITER = 5
results = []

CHUNKSIZES = [16 * KILOBYTE, 64 * KILOBYTE, 256 * KILOBYTE, MEGABYTE, 16 * MEGABYTE]

for chunksize in CHUNKSIZES:
    nchunks = DATA_SIZE // chunksize
    batch = pa.RecordBatch.from_pandas(generate_data(chunksize, NCOLS))

    sink = pa.InMemoryOutputStream()
    stream_writer = pa.StreamWriter(sink, batch.schema)

    for i in range(nchunks):
        stream_writer.write_batch(batch)

    source = sink.get_result()

    elapsed = get_timing(lambda: read_as_dataframe(pa.StreamReader, source), NITER)

    result = (chunksize, elapsed)
    print(result)
    results.append(result)
Kilde: habr.com
