

Hello, Habr!
Vi minder om, at vi har offentliggjort endnu en ekstremt interessant og nyttig om Kubernetes-mønstre. Det begyndte alt sammen med "" af Brendan Burns, og arbejdet inden for dette område er . I dag tilbyder vi dig at læse et blogindlæg fra MinIO, der kortlægger tendenserne og specifikationerne for datalagringsmønstre i Kubernetes.
Kubernetes har fundamentalt ændret de traditionelle mønstre for udvikling og implementering af applikationer. Nu kan teamet bruge kun få dage på at udvikle, teste og implementere en applikation – i forskellige miljøer, alt sammen inden for Kubernetes-klynger. Arbejde med teknologi fra tidligere generationer tog normalt hele uger, hvis ikke flere måneder.
Denne acceleration er blevet muliggjort takket være den abstraktion, som Kubernetes tilbyder – det vil sige, at Kubernetes selv håndterer interaktionen med de lavere niveauer af fysiske eller virtuelle maskiner, hvilket gør det muligt for brugerne at angive blandt andre parametre den nødvendige processor, den nødvendige mængde hukommelse, og antallet af containerinstanser. Da et enormt fællesskab er involveret i vedligeholdelsen af Kubernetes, og anvendelsen af Kubernetes konstant udvides, fører det klart blandt alle containerorkestreringsplatforme.
I takt med at brugen af Kubernetes vokser, stiger forvirringen omkring de anvendte datalagringsmønstre.
I den udbredte konkurrence om en del af kagen Kubernetes (det vil sige, om datalagring), når det kommer til datalagring, drukner signalet i det stærke støj.
Kubernetes repræsenterer den moderne model for udvikling og implementering af applikationer samt for deres administration. Denne moderne model adskiller datalagring fra beregning. For fuldt ud at forstå denne adskillelse i konteksten af Kubernetes, skal man også forstå, hvad applikationer, der arbejder med tilstand og uden tilstand, er, samt hvordan datalagring passer ind i dette. Her har REST API-tilgangen, der anvendes af S3, klare fordele i forhold til POSIX/CSI-tilgangen, som er karakteristisk for andre løsninger.
I denne artikel vil vi tale om datalagringsmønstre i Kubernetes og særligt berøre debatten om applikationer, der kører med og uden vedvarende tilstand, for bedre at forstå forskellen mellem dem, og hvorfor den er vigtig. Artiklen vil se på applikationer og de anvendte datalagringsmønstre i lyset af bedste praksis for arbejde med containere og Kubernetes.
Containere uden vedvarende tilstand
Containere er iboende letvægts og efemeriske. De kan nemt stoppes, slettes eller implementeres på en anden node - alt dette tager kun få sekunder. I et stort containers orchestrationssystem sker sådanne operationer konstant, og brugerne bemærker ikke engang disse ændringer. Dog er flytninger kun mulige, hvis containeren ikke har nogen afhængigheder fra den node, den befinder sig på. Disse containere siges at fungere uden vedvarende tilstand.
Containere med vedvarende tilstand
Hvis en container gemmer data på lokalt tilsluttede enheder (eller på et bloklager), skal datalagringsmediet, som den befinder sig på, flyttes til den nye node sammen med selve containeren i tilfælde af fejl. Dette er vigtigt, da applikationen, der kører i containeren, ellers ikke kan fungere korrekt, fordi den skal tilgå de data, der er gemt på de lokale medier. Disse containere siges at fungere med vedvarende tilstand.
Rent teknisk kan containere med vedvarende tilstand også flyttes til andre noder. Dette sikres typisk ved hjælp af distribuerede filsystemer eller block storage-netværk tilsluttet alle noder, hvor containere kører. På denne måde får containere adgang til volumener til vedvarende datalagring, og informationen gemmes på diske, der er spredt over hele netværket. Jeg vil kalde denne metode "container-tilgangen med vedvarende tilstand", og i resten af artiklen vil jeg referere til den på denne måde for ensartethed.
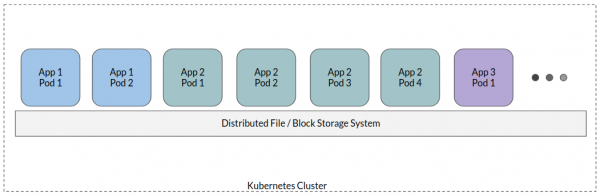
I et typisk container-baseret tilgang med vedholdenhed knyttes alle applikations-pods til et fælles distribueret filsystem - hvilket skaber en slags delt lager, hvor alle applikationsdata findes. Selvom der kan være visse variationer, er dette en overordnet tilgang.
Lad os nu se på, hvorfor den container-baserede tilgang med vedholdenhed i en cloud-venlig verden er et antipattern.
Cloud-orienteret applikationsdesign
Traditionelt brugte applikationer databaser til struktureret opbevaring af information og lokale diske eller distribuerede filsystemer, hvor alle ustrukturerede eller endda semi-strukturerede data blev gemt. Efterhånden som volumenerne af ustrukturerede data voksede, indså udviklerne, at POSIX var for "snakkesalig", forbundet med betydelige omkostninger og til sidst hæmmede applikationens funktion, når den skulle skalere til reelle store størrelser.
Dette bidrog hovedsageligt til fremkomsten af en ny datalagringsstandard, nemlig cloud-orienterede lagre, der primært opererer baseret på REST API'er og frigør applikationen fra den byrdefulde vedligeholdelse af lokalt datalager. I så fald arbejder applikationen reelt uden vedholdenhed (da tilstanden er i det fjerntliggende lager). Moderne applikationer bygges fra bunden med dette aspekt i tankerne. Generelt er enhver moderne applikation, der håndterer data af forskellige slags (logs, metadata, blobs osv.), bygget efter et cloud-orienteret paradigme, hvor tilstanden overføres til et dedikeret software-system til opbevaring af dette.
Den container-baserede tilgang med vedholdenhed tvinger hele denne paradigm til at tilbagegå til det, hvor det startede!
Når der anvendes POSIX-grænseflader til datalagring, fungerer applikationerne på samme måde, som hvis de gemte tilstand, og derfor fraviger de de mest centrale postulater i skydesign, nemlig muligheden for at variere størrelserne af applikationernes arbejdstråde afhængigt af den indkommende belastning, at bevæge sig til en ny node, så snart den aktuelle node fejler, og så videre.
Ved at se nærmere på denne situation opdager vi, at når vi vælger datalagring, står vi igen og igen over for dilemmaet "POSIX versus REST API", MEN med en yderligere forværring af problemsituationer med POSIX, der skyldes den distribuerede natur af Kubernetes-miljøer. Især,
- POSIX er snakkesalig: semantikken i POSIX kræver at associere metadata og filbeskrivere med hver operation, som hjælper med at opretholde status for operationen. Dette medfører betydelige omkostninger uden reel værdi. API'er til objektlagring, især S3 API, har afskaffet disse krav og gør det muligt for applikationen at handle og derefter "glemme" opkaldet. Lagerets respons angiver, om en given handling er udført med succes eller ej. I tilfælde af fejl kan applikationen forsøge igen.
- Netværksbegrænsninger: I et distribueret system antages det, at der kan eksistere mange applikationer, der forsøger at skrive data til det samme vedhæftede medium. Derfor, udover at applikationer vil konkurrere med hinanden om båndbredde (for at sende data til mediet), vil selve datalagringssystemet også konkurrere om denne båndbredde ved at sende data over fysiske diske. På grund af POSIX's snakkesl ger antallet af netværksopkald stiger flere gange. På den anden side sikrer S3 API en klar opdeling af netværksopkald mellem dem, der kommer fra klienten til serveren, og dem, der finder sted inden for serveren.
- Sikkerhed: POSIX-sikkerhedsmodellen er designet til aktiv menneskelig deltagelse: administratorer konfigurerer specifikke adgangsniveauer for hver bruger eller gruppe. Denne paraply er svært at tilpasse den skybaserede verden. Moderne applikationer afhænger af sikkerhedsmodeller, der er bundet til API'er, hvor adgangsrettigheder defineres som et sæt politikker, og servicekonti, midlertidige legitimationsoplysninger osv. tildeles.
- Håndterbarhed: Tilstande med vedholdende containere medfører visse omkostninger i relation til administration. Det handler om synkronisering af parallel adgang til data, sikring af dataintegritet; alt dette kræver omhyggelig overvejelse af, hvilke datatilgangsmønstre der skal bruges. Det er nødvendigt at installere, overvåge og konfigurere ekstra programmer, for ikke at nævne de ekstra kræfter, der bruges til udviklingen.
Container data-storage interface
Mens container storage interface (CSI) har været en stor hjælp til udbredelsen af Kubernetes-volumeniveauet, delvist ved at delegere det til tredjeparts datalagringsudbydere, har det også utilsigtet bidraget til overbevisningen om, at den vedholdende container-tilgang er den anbefalede metode til datalagring i Kubernetes.
CSI blev designet som en standard for levering af vilkårlige blokerings- og filopbevaringssystemer til arveapplikationer, når der arbejdes med Kubernetes. Og som vist i denne artikel, er den eneste situation, hvor den vedholdende container-tilgang (og CSI i sin nuværende form) er rimelig – når selve applikationen er et arvesystem, hvor det er umuligt at tilføje API-understøttelse af objektlagringssystemer.
Det er vigtigt at forstå, at når vi bruger CSI i sin nuværende form, dvs. ved at montere volumener, når vi arbejder med moderne applikationer, vil vi støde på cirka de samme problemer, som opstod i systemer, hvor datalagring blev organiseret på POSIX-måde.
En mere kvalitetsorienteret tilgang
I denne sammenhæng er det vigtigt at forstå, at de fleste applikationer i deres grundlæggende form ikke er designet til at arbejde med vedvarende eller ikke-vedvarende tilstand. Denne adfærd afhænger af den overordnede systemarkitektur og de specifikke valg, der er truffet under designprocessen. Lad os tale lidt om applikationer, der bevarer tilstand.
I princippet kan alle applikationsdata opdeles i flere brede kategorier:
- Logdata
- Tidsstemplingsdata
- Transaktionsdata
- Metadata
- Containerbilleder
- Blobdata (store binære objekter)
Alle disse datatyper understøttes meget godt på moderne datalagringsplatforme, og der findes flere cloud-orienterede platforme, der er tilpasset til at levere data i hver af disse specifikke formater. For eksempel kan transaktionsdata og metadata være i en moderne cloud-orienteret database som CockroachDB, YugaByte mv. Containerbilleder eller blobdata kan opbevares i et docker-register baseret på MinIO. Tidsstemplingsdata kan gemmes i en tidsseriedatabase, såsom InfluxDB mv. Lad os ikke gå i dybden med hver datatypes detaljer og de tilhørende applikationer, men den overordnede idé er at undgå vedvarende datalagring baseret på lokal diskmontering.
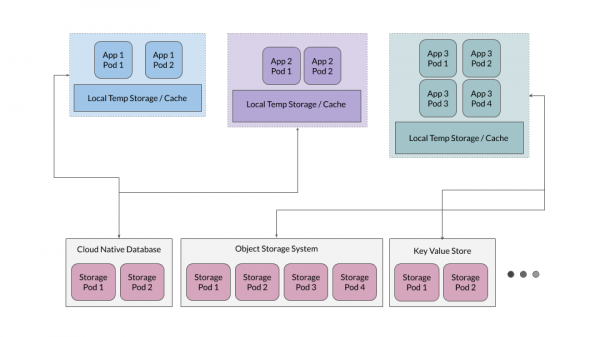
Desuden viser det sig ofte at være effektivt at tilbyde et niveau af midlertidig caching, der fungerer som et slags lager for midlertidige filer for applikationerne, men applikationerne må ikke være afhængige af dette niveau som sandhedens kilde.
Opbevaring for applikationer med vedvarende tilstand
Mens det i de fleste tilfælde er nyttigt at holde applikationer uden vedvarende tilstand, skal de applikationer, der er designet til at gemme data - for eksempel databaser, objektlagre, nøgleværdilagre - bevare tilstand. Lad os forstå, hvorfor disse applikationer udrulles på Kubernetes. Som eksempel kan vi tage MinIO, men lignende principper gælder også for andre store cloud-orienterede datalagringssystemer.
Cloud-native applikationer er designet til at maksimere den fleksibilitet, som containere tilbyder. Det betyder, at der ikke gøres nogen antagelser om det miljø, hvor de vil blive implementeret. For eksempel bruger MinIO en indbygget mekanisme til erasure coding, som sikrer, at systemet forbliver funktionsdygtigt, selvom halvdelen af diske fejler. MinIO håndterer også integriteten og sikkerheden af data ved hjælp af sit eget hashing og kryptering på serversiden.
For sådanne cloud-native applikationer er lokale persistente volumener (PV) de mest praktiske som backup-opbevaring. Lokale PV'er giver mulighed for lagring af rådata, mens applikationer, der kører ovenpå disse PV'er, selv indsamler information, som gør det muligt at skalere dataene og håndtere voksende datakrav.
Denne tilgang er meget enklere og skalerer betydeligt bedre end CSI-baserede PV'er, som tilføjer deres egne datastyrings- og redundanslag til systemet; dette skyldes, at disse lag ofte konflikterer med applikationer designet til tilstandsløs drift.
Sikre skridt mod at adskille data fra beregninger
I denne artikel har vi diskuteret, hvordan applikationer omdirigeres mod at arbejde uden tilstand, eller med andre ord, hvordan datalagring adskilles fra beregningerne over dem. Til sidst vil vi se på nogle virkelige eksempler på denne tendens.
, den berømte platform til dataanalyse, har traditionelt været brugt med tilstand og med implementering i HDFS-filsystemet. Men efterhånden som Spark bevæger sig mod en cloud-native verden, bliver denne platform i stigende grad brugt uden tilstand ved hjælp af `s3a`. Spark anvender s3a til at overføre tilstand til andre systemer, mens selve Spark-containere kører helt uden tilstand. Andre store enterprise-aktører inden for big data-analyse, især, , , går også over til at arbejde med adskillelse af datalagring og beregninger.
Lignende mønstre ses også på andre store analyseplatforme, såsom Presto, Tensorflow til R, Jupyter. Ved at eksportere tilstand til fjerndrevne cloud-lagringssystemer bliver det meget lettere at administrere din applikation og skalere den. Desuden fremmer det bærbarheden af applikationen i forskellige miljøer.
Kilde: habr.com
