

Mikhail Salosin (hereinafter - MS): – Hej alle sammen! Mit navn er Mikhail. Jeg arbejder som backend-udvikler hos MC2 Software, og jeg vil fortælle om brugen af Go i backend for mobilappen 'Smtori+'.
Er der nogen her, der kan lide hockey?
Så er denne app noget for dig. Den er til Android og iOS og bruges til at se livestreams af forskellige sportsbegivenheder online og on-demand. Appen indeholder også forskellige statistikker, tekstlivestreams, tabeller for konferencer, turneringer og anden information, der er nyttig for fans.
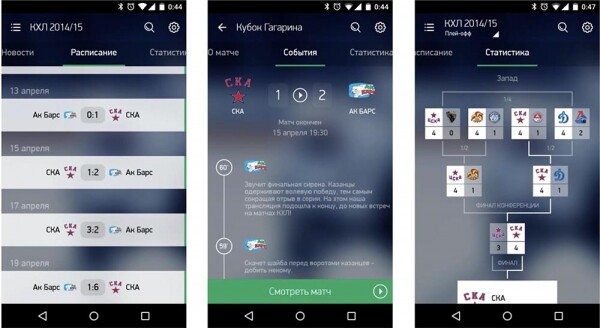
Appen indeholder også en funktion kaldet videomomenter, dvs. du kan se de spændende øjeblikke fra kampene (mål, slagsmål, straffekast osv.). Hvis du ikke vil se hele livestreamen, kan du finde kun det mest interessante.
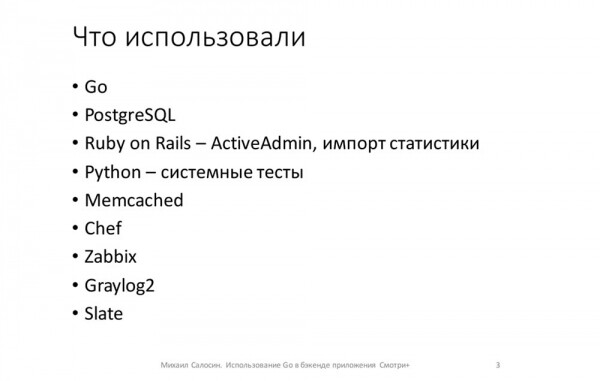
Hvad blev der brugt i udviklingen?
Hovedparten blev skrevet i Go. Den API, som mobilklienterne kommunikerede med, blev skrevet i Go. Der blev også skrevet en service i Go til at sende push-notifikationer til mobiltelefonerne. Desuden måtte vi skrive vores eget ORM, som vi måske en dag vil fortælle om. Og der blev skrevet nogle små tjenester i Go: resizing og upload af billeder til redaktørernes brug...
Vi brugte PostgreSQL som database. Infrastrukturen for redaktørerne blev skrevet i Ruby on Rails ved hjælp af gemmet ActiveAdmin. Importen af statistik fra statistikleverandøren blev også skrevet i Ruby.
Til systemtest af API'et benyttede vi Pythons unittest. Memcached anvendes til throttling af API-betalinger, Chef bruges til konfigurationskontrol, Zabbix til at samle og overvåge interne statistiske data fra systemet. Graylog2 bruges til logindsamling, Slate er API-dokumentationen til kunderne.
Valg af protokol
Det første problem, vi stødte på: vi skulle vælge en protokol til kommunikationen mellem backend og mobilklienter, baseret på følgende punkter…
- Det vigtigste krav: dataene på klienterne skal opdateres i realtid. Det vil sige, at alle, der ser livestreamen i øjeblikket, skal modtage opdateringer næsten med det samme.
- For at forenkle antog vi, at de data, der synkroniseres med klienterne, ikke slettes, men skjules ved hjælp af specielle flag.
- Alle sjældne forespørgsler (som statistikker, holdopstillinger, holdstatistikker) får vi som almindelige GET-forespørgsler.
- Desuden skulle systemet kunne håndtere 100.000 brugere samtidigt uden problemer.
Baseret på dette havde vi to protokolmuligheder:
- Websockets. Men vi havde ikke brug for kanaler fra klienten til serveren. Vi havde kun brug for at sende opdateringer fra serveren til klienten, så websockets var en overflødig løsning.
- Server-Sent Events (SSE) passede perfekt! Det er ret simpelt og opfylder i princippet alt, hvad vi har brug for.
Server-Sent Events
Et par ord om, hvordan denne ting fungerer…
Det fungerer over http-forbindelsen. Klienten sender en forespørgsel, hvorefter serveren svarer med Content-Type: text/event-stream og lukker ikke forbindelsen med klienten, men fortsætter med at skrive data til forbindelsen:
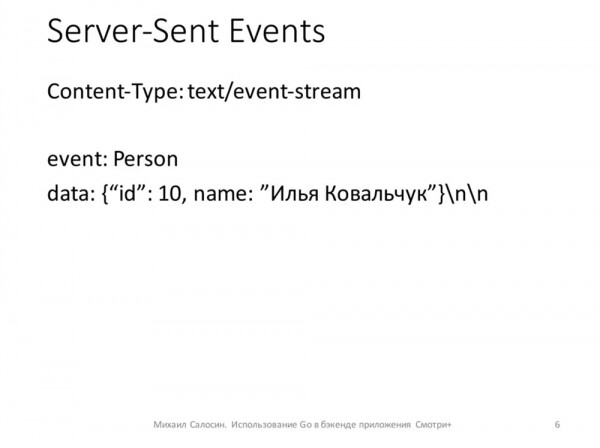
Data kan sendes i et format, der er aftalt med klienterne. I vores tilfælde sendte vi det på denne måde: i feltet event blev navnet på den ændrede struktur (person, spiller) sendt, og i feltet data – JSON med de nye, ændrede felter for spilleren.
Nu om, hvordan selve interaktionen fungerer.
- Først og fremmest bestemmer klienten, hvornår der sidst blev synkroniseret med servicen: han ser i sin lokale database og bestemmer datoen for den sidst registrerede ændring.
- Han sender en forespørgsel med denne dato.
- Som svar sender vi ham alle opdateringer, der er sket siden denne dato.
- Herefter opretter han forbindelse til live-kanalen og lukker den ikke, før han ikke længere har brug for disse opdateringer:
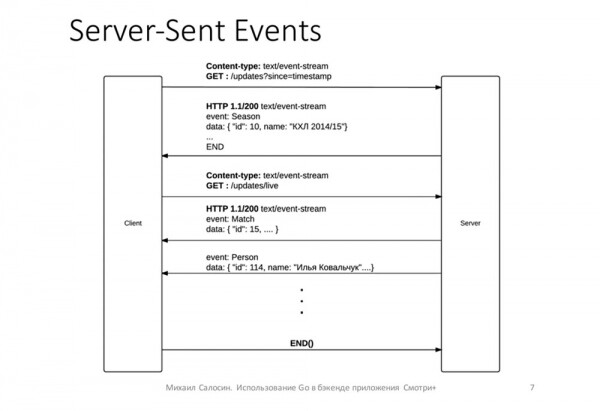
Vi sender ham en liste over ændringer: hvis nogen scorer et mål – ændrer vi kampens score, hvis nogen bliver skadet – bliver det også sendt i realtid. På den måde får klienterne straks de aktuelle data i kampens hændelsesstrøm. Regelmæssigt, for at klienten kan forstå, at serveren ikke er død, og at der ikke er sket noget med den, sender vi hvert 15. sekund et timestamp – så han ved, at alt er i orden, og at han ikke behøver at genoprette forbindelsen.
Hvordan vedligeholdes live-forbindelsen?
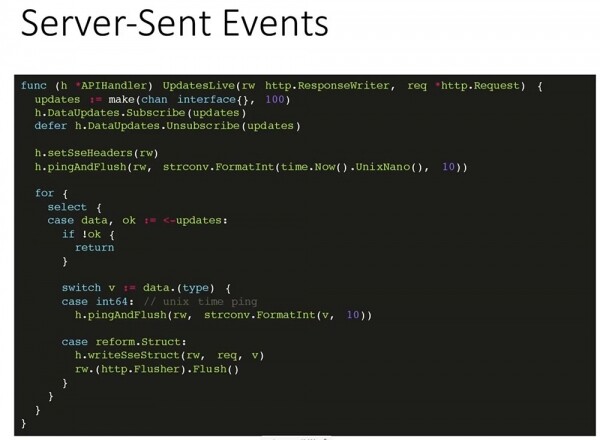
- Først opretter vi en kanal, som opdateringerne vil komme ind i med en buffer.
- Derefter tilmelder vi denne kanal til at modtage opdateringer.
- Vi sætter den rigtige header, så klienten ved, at alt er ok.
- Vi sender det første ping. Vi registrerer blot det aktuelle timestamp for forbindelsen.
- Derefter læser vi i en løkke fra kanalen, indtil opdateringskanalen lukkes. Kanalen modtager periodisk enten det aktuelle tidsstempel eller ændringer, som vi allerede registrerer i åbne forbindelser.
Det første problem, vi stødte på, var følgende: for hver åben forbindelse med klienten oprettede vi en timer, der tikker hvert 15. sekund – så hvis vi havde 6.000 åbne forbindelser til én maskine (til én API-server), blev der oprettet 6.000 timere. Det førte til, at maskinen ikke kunne håndtere den nødvendige belastning. Problemet var ikke så åbenlyst for os, men vi fik lidt hjælp, og vi løste det.
I sidste ende kommer ping nu fra den samme kanal, som opdateringen kommer fra.
Der er derfor kun én timer, der tikker hvert 15. sekund.
Her er nogle hjælpefunktioner – sending af header, ping og selve strukturen. Det vil sige, her sendes navnet på tabellen (person, match, sæson) og selve informationen om denne post:

Mekanismen til at sende opdateringer
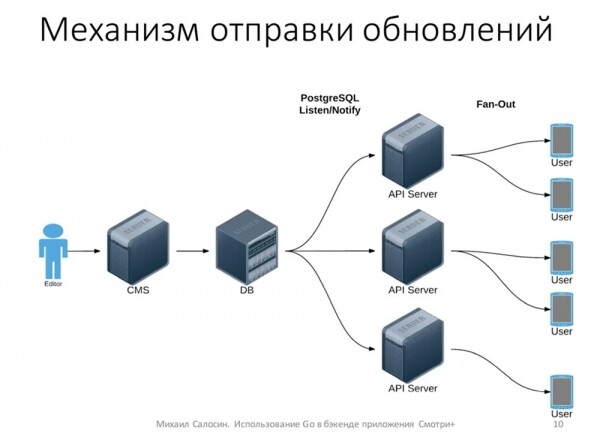
Nu lidt om, hvor ændringerne kommer fra. Vi har flere personer, redaktører, der ser streamen i realtid. De skaber alle begivenheder: nogen er blevet fjernet, nogen har fået en skade, der er en udskiftning...
Gennem CMS rammer dataene databasen. Derefter informerer databasen med listen/notify mekanismen API-serverne. API-serverne distribuerer derefter denne information til klienterne. Dermed er der i praksis kun få servere tilsluttet databasen, og der er ikke nogen særlig belastning på databasen, fordi klienten ikke interagerer direkte med databasen:
PostgreSQL: Listen/Notify
Listen/Notify mekanismen i PostgreSQL gør det muligt at informere abonnenter om begivenheder, når en eller anden post i databasen er blevet ændret – når der er oprettet en post. Til dette har vi skrevet en simpel trigger og funktion:
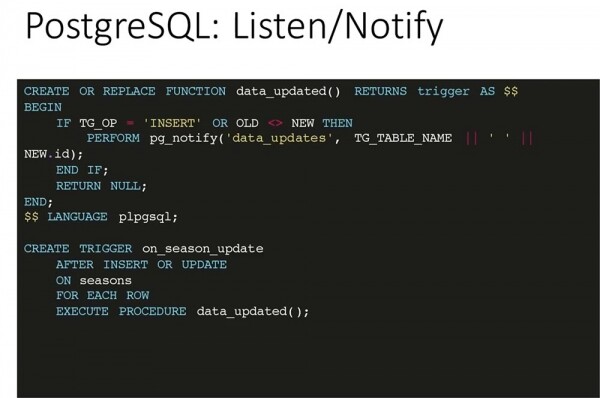
Ved insert eller ændring af en post kalder vi notify-funktionen på kanalen data_updates, hvor vi sender navnet på tabellen og id'et på den post, der er blevet ændret eller indsat.
For alle tabeller, der skal synkroniseres med klienten, definerer vi en trigger, der efter ændring/opdatering af en post kalder den funktion, der er angivet på diaset nedenfor.
Hvordan abonnerer API'en på disse ændringer?
Der Fanout-mekanisme oprettes – det sender beskeder til klienterne. Det samler alle klientkanaler og sender opdateringerne, som den har modtaget via disse kanaler:
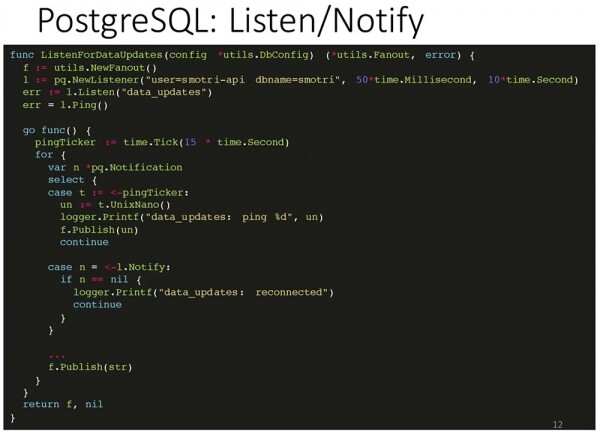
Her er den standardbibliotek pq, som forbinder til databasen og angiver, at den ønsker at lytte til kanalen (data_updates), tjekker, at forbindelse er åben, og at alt fungerer. Jeg udelader fejlkontrol for at spare plads (at springe fejlkontrol over kan være risikabelt).
Derefter angiver vi asynkront en Ticker, som sender ping hvert 15. sekund, og begynder at lytte til den kanal, vi har abonneret på. Hvis vi modtager en ping, publicerer vi denne ping. Hvis vi modtager en optegnelse, publicerer vi denne optegnelse til alle abonnenter af denne Fanout.
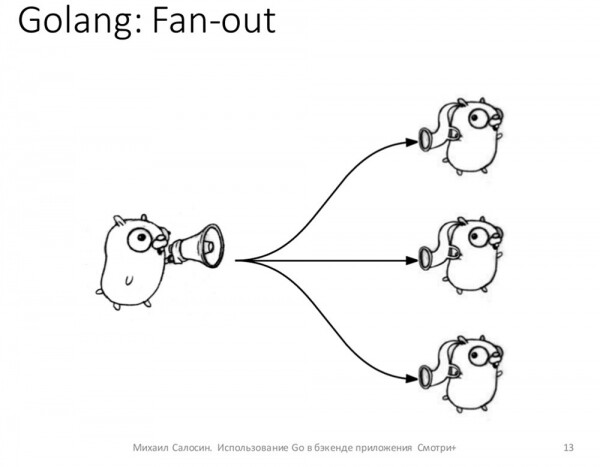
Hvordan fungerer Fan-out?
På dansk oversættes det som "fordeler". Vi har et enkelt objekt, der registrerer abonnenter, som ønsker at modtage opdateringer. Og så snart en opdatering til dette objekt ankommer, distribuerer det denne opdatering til alle nuværende abonnenter. Ret enkelt:
Hvordan er det implementeret i Go:
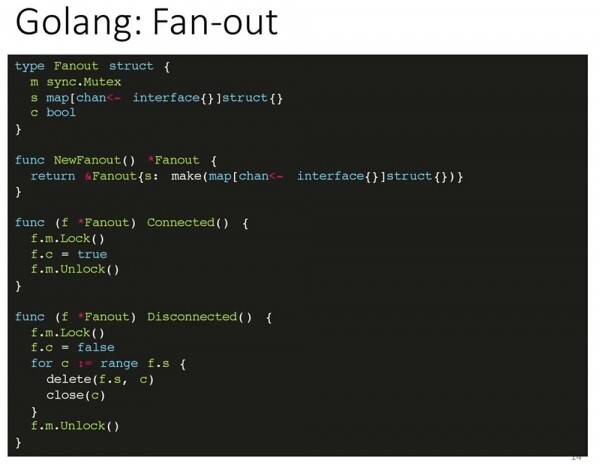
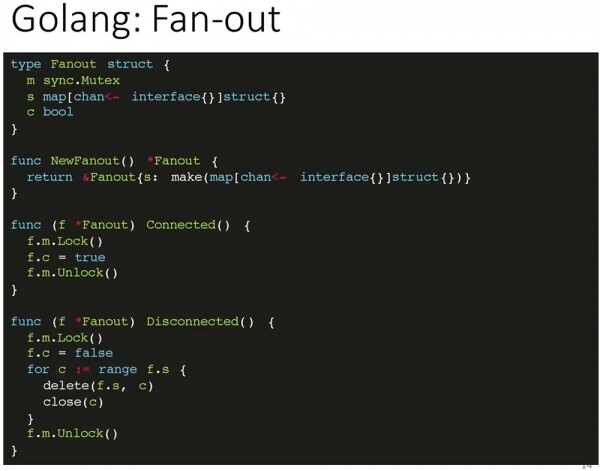
Der er en struktur, som synkroniseres ved hjælp af Mutex'er. Den har et felt, der gemmer Fanouts forbindelse til databasen, dvs. i øjeblikket lytter den og vil modtage opdateringer samt listen over alle nuværende kanaler - en map, hvor nøglen er kanalen og en struct i form af værdier (i princippet bruges den ikke til noget).
To metoder - Connected og Disconnected - tillader Fanout at vide, at vi har forbindelse til databasen, at det er kommet og at forbindelsen til databasen er blevet afbrudt. I sidstnævnte tilfælde skal alle klienter frakobles og informeres om, at de ikke længere kan lytte og at de skal genoprette forbindelsen, fordi forbindelsen til dem er lukket.
Der er også en metode Subscribe, som tilføjer kanalen til "lytterne":
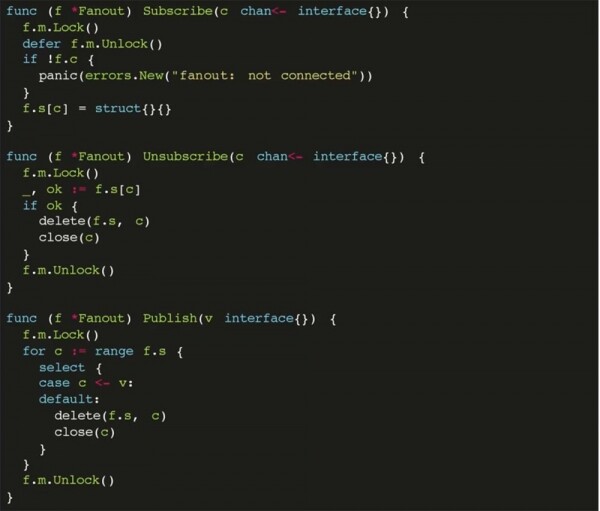
Der er en metode Unsubscribe, som fjerner kanalen fra de lyttende, hvis klienten har frakoblet, samt en metode Publish, der gør det muligt at sende en besked til alle abonnenter.
Spørgsmål: - Hvad overføres der på denne kanal?
MS: - Der overføres en model, som er ændret, eller en ping (i bund og grund blot et tal, integer).
MS: - Man kan sende hvad som helst, enhver struktur, offentliggøre - den bliver bare omformateret til JSON og så videre.
MS: – Vi modtager en notifikation fra "Postgres" – den indeholder navnet på tabellen og identifikatoren. Ud fra tabelnavnet får vi identifikatoren, og vi henter den ønskede post, som vi så sender til offentliggørelse.
Infrastruktur
Hvordan ser det ud fra et infrastruktursynspunkt? Vi har 7 fysiske servere: én er helt dedikeret til databasen, mens de øvrige seks kører virtuelle maskiner. Der er 6 kopier af API'et: hver virtuel maskine med API'et kører på en separat fysisk server – dette er for pålidelighedens skyld.
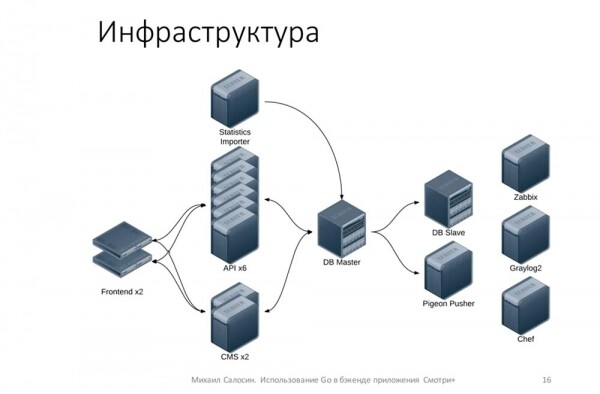
Vi har to frontends, hvor Keepalived er installeret for at forbedre tilgængeligheden, så i tilfælde af problemer kan én frontend erstatte den anden. Der er også to kopier af CMS.
Der findes også en statistikimportør. Der er en DB Slave, som der jævnligt tages backups fra. Der er Pigeon Pusher – den applikation, der sender pushes til kunderne, samt infrastrukturelle værktøjer: Zabbix, Graylog2 og Chef.
Faktisk er denne infrastruktur overflødig, fordi 100.000 kan betjenes med færre servere. Men hardware var tilgængelig – vi brugte den (vi fik at vide, at det var muligt – hvorfor ikke).
Fordele ved Go
Efter vi har arbejdet med denne applikation, er der dukket nogle åbenlyse fordele ved Go op.
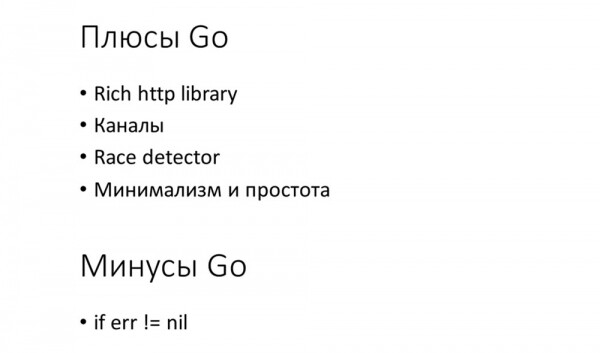
- En fantastisk http-bibliotek. Med den kan man skabe meget "out of the box".
- Derudover, kanaler, som gjorde det meget nemt for os at implementere et mekanisme til at sende notifikationer til kunderne.
- Den fantastiske Race detector gjorde det muligt for os at eliminere flere kritiske bugs (staging-infrastrukturen). Alt, hvad der kører på staging, er startet, kompileret med Race-flaget; og vi kan dermed se på staging-infrastrukturen, hvilke potentielle problemer vi har.
- Minimalisme og enkelhed i sproget.
Vi søger udviklere! Hvis nogen er interesseret – er I velkomne.
Spørgsmål
Spørgsmål fra publikum (herefter – S): – Jeg synes, du har overset et vigtigt punkt om Fan-out. Forstår jeg korrekt, at når du sender et svar til kunden, bliver du blokeret, hvis kunden ikke ønsker at læse?
MS: – Nej, vi bliver ikke blokeret. For det første er alt dette bag nginx, så vi har ingen problemer med langsomme kunder. For det andet har kunden en buffering-kanal – vi kan i princippet lægge op til hundrede opdateringer der... Hvis vi ikke kan skrive til kanalen, sletter den den. Hvis vi ser, at kanalen er blevet blokeret, lukker vi bare kanalen, og så er det hele – kunden genforbinder, hvis der opstår et problem. Så her opstår der grundlæggende ikke blokeringer.
Q: – Kunne man ikke have sendt til Listen/Notify optagelsen med det samme, i stedet for tabel-id?
MS: – Listen/Notify har en begrænsning på 8.000 byte på preload, som den sender. I princippet kunne man sende, hvis vi havde med en lille mængde data at gøre, men jeg mener, at den måde, vi gør det på, er mere pålidelig. Begrænsningerne ligger i selve "PostgreSQL".
Q: – Får kunderne opdateringer om kampe, som de ikke er interesserede i?
MS: – Generelt ja. Som regel er der 2-3 kampe der parallelt, og det er sjældent. Hvis en kunde ser noget, ser de normalt den kamp, der kører. Derefter har kunden en lokal database, hvor alle disse opdateringer gemmes, og selv uden internetforbindelse kan kunden se alle tidligere kampe, for hvilke de har opdateringer. I princippet synkroniserer vi vores database på serveren med kundens lokale database, så de kan arbejde offline.
Q: – Hvorfor lavede I jeres egen ORM?
Aleksej (en af udviklerne af "Se+" ): – På det tidspunkt (det var for et år siden) var der færre ORM'er, end der er nu, når der er ret mange. Jeg bryder mig mest om, at de fleste eksisterende ORM'er arbejder med tomme interfaces. Det vil sige, metoderne i disse ORM'er er klar til at tage imod alt muligt: struktur, strukturpeger, tal, noget der slet ikke har noget med det at gøre...
Vores ORM genererer strukturer baseret på datamodellen. Selv. Og derfor er alle metoder specifikke, bruger ikke refleksion osv. De modtager strukturer og forventer at bruge de strukturer, der kommer.
Q: – Hvor mange mennesker deltog?
MS: – I den indledende fase deltog to personer. Omkring juni begyndte vi, i august var hoveddelen klar (første version). I september var der release.
Q: – Der, hvor du beskriver SSE, bruger du ikke timeout. Hvorfor sådan?
MS: – Hvis vi skal tale helt klart, så er SSE stadig en html5-protokol: standarden for SSE er designet til kommunikation med browsere, så vidt jeg forstår. Den har ekstra funktioner, så browserne kan genoprette forbindelsen (og andet), men det er ikke noget, vi har brug for, fordi vi har haft kunder, der kunne implementere enhver forbindelseslogik og hente information. Vi har lavet noget, der ligner SSE, men ikke rent faktisk er det. Det er ikke selve protokollen.
Der var ikke behov for det. Så vidt jeg forstår, implementerede kunderne forbindelsesmekanismen praktisk talt fra bunden. De var i princippet ligeglade.
Q: – Hvilke ekstra værktøjer brugte I?
MS: – Vi brugte især govet og golint for at have en ensartet stil, samt gofmt. Vi brugte ikke noget andet.
Q: – Hvordan foretog I fejlfinding?
MS: – Fejlfinding foregik stort set ved hjælp af tests. Vi brugte ingen debugger eller GOP.
Q: – Kan du vise sliden, hvor funktionen Publish er implementeret? Bekymrer du dig ikke om enkeltbogstavsvariabelnavne?
MS: – Nej. De har en ret "snæver" synlighed. De bruges ikke nogen steder udenfor dette, bare her (udover indholdet af denne klasse), og den er meget kompakt – den fylder kun 7 linjer.
Q: – Det virker stadig ikke intuitivt...
MS: – Nej, nej, det er virkelig kode! Det handler ikke om stilen. Det er bare en meget utilitaristisk, helt lille klasse – den har kun 3 felter inden i klassen...
MS: – Stort set ændres alle de data, der synkroniseres med kunderne (sæsonkampe, spillere), ikke. Groft sagt, hvis vi skulle lave en anden sportsgren, hvor det ville være nødvendigt at ændre kampene, ville vi simpelthen tage højde for det i den nye version af klienten, og de gamle versioner af klienten ville blive blokkeret.
Q: – Er der nogen tredjepartsbiblioteker til afhængighedshåndtering?
MS: – Vi brugte go dep.
Q: – I emnet for præsentationen var der noget om video, men der er ingen video i præsentationen.
MS: – Nej, jeg har ikke noget om video i emnet. Det hedder "Se+" – det er navnet på applikationen.
Q: – Du sagde, at det streames til kunderne?..
MS: – Vi har ikke arbejdet med streamingvideo. Det blev helt og holdent lavet af "MegaFon". Ja, jeg sagde ikke, at det er en MegaFon-applikation.
MS: – Go – til at sende alle data – om regningen, om kampbegivenheder, statistik… Go – er helt backend til ansøgningen. Klienten skal på en eller anden måde finde ud af, hvilken link han skal bruge til spilleren, så brugeren kan se kampen. Vi har links til video og streams, der er forberedt.
Lidt reklame 🙂
Tak fordi du bliver hos os. Kan du lide vores artikler? Ønsker du at se flere interessante materialer? Støt os ved at bestille eller anbefale os til dine bekendte, , en unik analog til entry-level servere, som vi har designet til dig: (tilgængelige muligheder med RAID1 og RAID10, op til 24 kerner og op til 40 GB DDR4).
Dell R730xd til halv pris i datacenteret Equinix Tier IV i Amsterdam? Kun hos os i Holland! Dell R420 - 2x E5-2430 2.2GHz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB - fra 99 $! Læs om hvordan
Kilde: habr.com
