

Standardbetingelse for implementering af CI/CD i Kubernetes: applikationen skal være i stand til at afvise nye klientanmodninger, før den stoppes helt, og vigtigst af alt — succesfuldt afslutte eksisterende anmodninger.
Overholdelse af dette krav muliggør nul nedetid under deployment. Men selv ved brug af meget populære kombinationer (som NGINX og PHP-FPM) kan man støde på vanskeligheder, der fører til et væld af fejl under hver deployment…
Teori. Hvordan en pod lever
Vi har allerede offentliggjort detaljer om livscyklussen for en pod. I den kontekst, vi ser på, er vi interesserede i følgende: i det øjeblik, hvor en pod går ind i tilstanden Terminating, stopper den med at modtage nye anmodninger (pod'en fra listen over endpoints for tjenesten). Derfor er det tilstrækkeligt for os at løse problemet med korrekt stoppelse af applikationen for at undgå nedetid under deployment.
Det skal også huskes, at grace-perioden som standard er : efter dette vil pod'en blive termineret, og applikationen skal nå at behandle alle anmodninger inden for denne periode. Bemærk: selvom enhver anmodning, der tager mere end 5-10 sekunder, allerede er problematisk, og en graceful shutdown vil ikke hjælpe her…
For bedre at forstå, hvad der sker, når pod'en afslutter sit arbejde, er det tilstrækkeligt at studere følgende diagram:
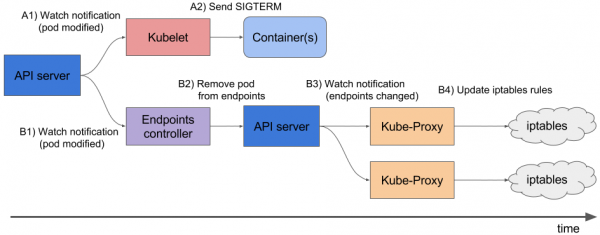
A1, B1 — Modtagelse af ændringer i pod'ens tilstand
A2 — Afsendelse af SIGTERM
B2 — Fjernelse af pod'en fra endpoints
B3 — Modtagelse af ændringer (listen over endpoints er ændret)
B4 — Opdatering af iptables-reglerne
Bemærk: fjernelse af pod'ens endpoint og afsendelse af SIGTERM sker ikke sekventielt, men parallelt. Og fordi Ingress ikke modtager den opdaterede liste over endpoints med det samme, vil nye anmodninger fra kunder blive sendt til pod'en, hvilket vil forårsage 500-fejl under termineringen af pod'en. (mere detaljeret materiale om dette spørgsmål har vi ). Problemet skal løses på følgende måder:
- Afsendelse af Connection: close i svaroverskrifterne (hvis det omhandler en HTTP-applikation).
- Hvis der ikke er mulighed for at ændre koden, beskrives der senere i artiklen en løsning, der gør det muligt at behandle anmodninger indtil slutningen af grace-perioden.
Teori. Hvordan NGINX og PHP-FPM afslutter deres processer
NGINX
Lad os starte med NGINX, da alt er mere eller mindre klart med det. Når vi dykker ned i teorien, finder vi ud af, at NGINX har én master-proces og flere "workere" - det er datterprocesser, der håndterer klientanmodninger. Der er en praktisk mulighed: ved hjælp af kommandoen nginx -s kan man afslutte processerne enten i mode for hurtig nedlukning eller i blid nedlukning. Det er tydeligt, at vi er interesseret i den sidste mulighed.
Derefter er det simpelt: vi skal tilføje til en kommando, der sender et signal om blid nedlukning. Dette kan gøres i Deployment, i containerblokken:
       lifecycle:
          preStop:
            exec:
              command:
              - /usr/sbin/nginx
              - -s
              - quit
Nu, når pod'en afsluttes, vil vi se følgende i NGINX containerens logs:
2018/01/25 13:58:31 [notice] 1#1: signal 3 (SIGQUIT) received, shutting down
2018/01/25 13:58:31 [notice] 11#11: gracefully shutting down
Og det vil betyde det, vi har brug for: NGINX venter på at fuldføre anmodningerne, hvorefter det dræber processen. Under alle omstændigheder vil en almindelig problemstilling også blive behandlet nedenfor, hvor selv med kommandoen nginx -s quit processen afsluttes ikke korrekt.
Og på dette stadium har vi afsluttet med NGINX: i det mindste kan vi forstå ud fra logs, at alt fungerer, som det skal.
Hvordan står det til med PHP-FPM? Hvordan håndterer det blid nedlukning? Lad os finde ud af det.
PHP-FPM
I tilfældet med PHP-FPM er informationen lidt mindre. Hvis man ser på for PHP-FPM, vil den fortælle, at der modtages følgende POSIX-signaler:
-
SIGINT,SIGTERM— hurtig nedlukning; -
SIGQUIT— blid nedlukning (det, vi har brug for).
De andre signaler er ikke nødvendige for denne opgave, så vi vil springe deres gennemgang over. For at afslutte processen korrekt vil det være nødvendigt at skrive følgende preStop-hook:
        lifecycle:
          preStop:
            exec:
              command:
              - /bin/kill
              - -SIGQUIT
              - "1"
Ved første øjekast er dette alt, hvad der kræves for at udføre blid nedlukning i begge containere. Ikke desto mindre er opgaven mere kompliceret end den ser ud. Nedenfor diskuteres to tilfælde, hvor blid nedlukning ikke virkede og forårsagede kortvarig utilgængelighed af projektet under deployment.
Praksis. Mulige problemer med blid nedlukning
NGINX
Det er nyttigt at huske: ud over at udføre kommandoen nginx -s quit der er endnu et trin, som det er værd at være opmærksom på. Vi har stødt på et problem, hvor NGINX i stedet for SIGQUIT-signal stadig sendte SIGTERM, hvilket medførte, at anmodninger ikke blev afsluttet korrekt. Lignende tilfælde kan findes, for eksempel, . Desværre har vi ikke været i stand til at fastslå den specifikke årsag til denne adfærd: der var mistanke om NGINX-versioner, men det blev ikke bekræftet. Symptomerne var, at der i NGINX-containerens logs blev observeret meddelelser «open socket #10 left in connection 5», hvorefter pod'en stoppede.
Vi kan observere et sådant problem, for eksempel, i svarene fra den ønskede Ingress:
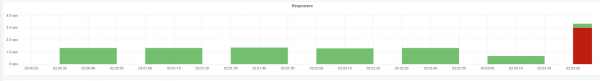
Statuskode-målinger i deploy-øjeblikket
I dette tilfælde får vi netop 503-fejl fra Ingress selv: den kan ikke kontakte NGINX-containeren, da den allerede ikke er tilgængelig. Hvis vi ser i logs fra NGINX-containeren, er der følgende:
[alert] 13939#0: *154 open socket #3 left in connection 16
[alert] 13939#0: *168 open socket #6 left in connection 13
Efter ændringen af stop-signalet begynder containeren at stoppe korrekt: dette bekræftes af, at 503-fejl ikke længere observeres.
Hvis du møder et lignende problem, giver det mening at finde ud af, hvilket stop-signal der bruges i containeren, og hvordan preStop-hooket præcist ser ud. Det er helt muligt, at årsagen lige netop ligger her.
PHP-FPM… og ikke kun
Problemet med PHP-FPM beskrives trivielt: det venter ikke på afslutningen af børneprocesserne, terminerer dem, hvilket fører til 502-fejl under deploy og andre operationer. Der har siden 2005 været flere fejlrapporter på bugs.php.net (for eksempel, og ), hvor dette problem beskrives. Og i logs vil du sandsynligvis ikke se noget: PHP-FPM erklærer sin proces afsluttet uden nogen fejl eller eksterne notifikationer.
Det skal præciseres, at selve problemet kan variere i mindre eller større grad afhængigt af selve applikationen og ikke nødvendigvis vise sig i overvågningen. Hvis du alligevel støder på det, kommer et simpelt workaround straks i tankerne: tilføj et preStop-hook med sleep(30). Det vil tillade at afslutte alle anmodninger, der var før dette (og vi modtager ikke nye, da pod'en allerede er i tilstand Terminating), og efter 30 sekunder afslutter pod'en sig selv med signalet SIGTERM.
Det viser sig, at lifecycle for containeren vil se således ud:
    lifecycle:
      preStop:
        exec:
          command:
          - \/bin\/sleep
          - "30"
Men på grund af angivelsen af 30 sekunder sleep vi er det nødvendigt at øge deploymenttiden, da hver pod vil blive termineret mindst 30 sekunder, hvilket er problematisk. Hvad kan der gøres ved dette?
Lad os henvende os til den side, der er ansvarlig for den direkte udførelse af applikationen. I vores tilfælde er det PHP-FPM, som som standard ikke følger op på udførelsen af sine child-processer: masterprocessen termineres straks. Dette adfærd kan ændres ved hjælp af direktivet process_control_timeout, som angiver tidsgrænser for venten på signaler fra master til child-processer. Hvis værdien indstilles til 20 sekunder, vil det dække de fleste anmodninger, der udføres i containeren, og efter deres afslutning vil masterprocessen blive stoppet.
Med denne viden vender vi tilbage til vores seneste problem. Som nævnt er Kubernetes ikke en monolitisk platform: der kræves lidt tid til interaktionen mellem dens forskellige komponenter. Dette er særligt relevant, når vi overvejer arbejdet med Ingress’er og andre relaterede komponenter, da en sådan forsinkelse under deployment nemt kan føre til en stigning i 500-fejl. For eksempel kan en fejl opstå på scenen, hvor anmodningen sendes til upstream, men selve "tidsforsinkelsen" i interaktionen mellem komponenterne er temmelig kort — under et sekund.
Derfor, sammen med det allerede nævnte direktiv process_control_timeout kan vi anvende følgende konstruktion til lifecycle:
lifecycle:
  preStop:
    exec:
      command: ["/bin/bash","-c","/bin/sleep 1; kill -QUIT 1"]
I så fald kompenserer vi for forsinkelsen med kommandoen sleep og øger ikke væsentligt deploymenttiden: for der er en mærkbar forskel mellem 30 sekunder og én?.. I bund og grund" udføres "hovedarbejdet" af process_control_timeout, og lifecycle bruges kun som en "sikkerhedsforanstaltning" i tilfælde af lag.
Generelt set, den beskrevne adfærd og den tilsvarende workaround vedrører ikke kun PHP-FPM. En lignende situation kan opstå ved brug af andre programmeringssprog/rammer. Hvis det ikke er muligt at rette op på graceful shutdown på andre måder — for eksempel ved at omskrive koden, så applikationen korrekt håndterer afslutningssignaler — kan den beskrevne metode anvendes. Selvom den ikke er den smukkeste, så fungerer den.
Praksis. Belastningstest for at kontrollere pod'ens funktion
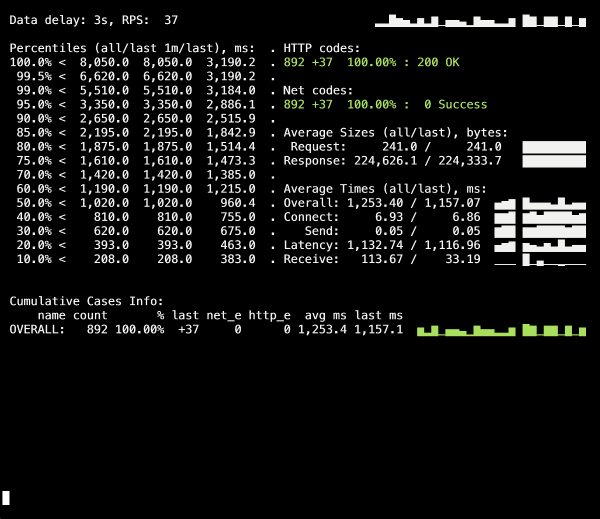
Belastningstestning er en måde at kontrollere, hvordan en container fungerer, da denne procedure simulerer reelle kampforhold, når brugere besøger hjemmesiden. For at teste de ovenfor nævnte anbefalinger kan man gøre brug af : den dækker perfekt alle vores behov. Nedenfor er tips og anbefalinger til at udføre testning med en visuel fremstilling — takket være grafikkerne fra Grafana og Yandex.Tank — baseret på vores erfaring.
Det vigtigste her er at kontrollere ændringerne trin for trin. Efter at have tilføjet en ny rettelse, skal du køre testen og se, om resultaterne har ændret sig i forhold til det tidligere kørsel. Ellers vil det være svært at identificere ineffektive løsninger, og på sigt kan det endda skade (for eksempel øge deploymenttiden).
En anden nuance er at overvåge containerens logs under dens terminering. Bliver der registreret information om en graceful shutdown? Er der fejl i loggene, når man forsøger at tilgå andre ressourcer (for eksempel den nabostående PHP-FPM container)? Fejl i selve applikationen (som i det ovenfor beskrevne tilfælde med NGINX)? Jeg håber, at den indledende information fra denne artikel vil hjælpe med at forstå, hvad der egentlig sker med containeren under dens terminering.
Så den første testkørsel fandt sted uden lifecycle og uden yderligere direktiver for applikationsserveren (process_control_timeout i PHP-FPM). Målet med denne test var at identificere det omtrentlige antal fejl (og om der overhovedet er nogle). Det skal også nævnes, at den gennemsnitlige deploymenttid for hver pod var omkring 5-10 sekunder, indtil den var helt klar. Resultaterne er som følger:
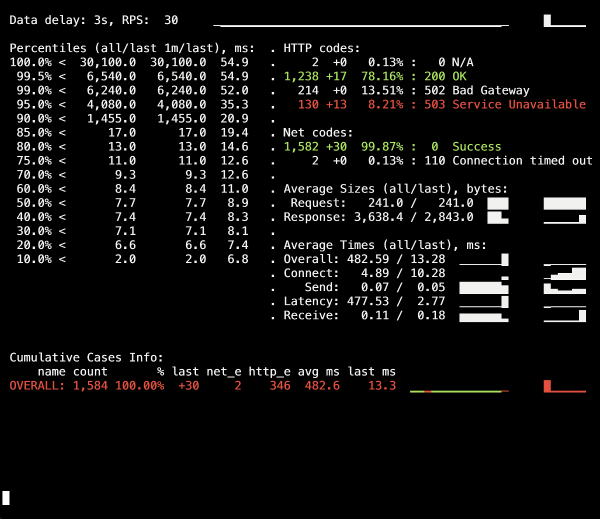
På informationspanelet i Yandex.Tank ses der et spike i 502-fejl, som opstod i forbindelse med deployment og varede i gennemsnit op til 5 sekunder. Dette skyldes muligvis, at eksisterende anmodninger til den gamle pod blev afbrudt, da den blev termineret. Derefter opstod der 503-fejl, hvilket var et resultat af den stoppede NGINX-container, som også afbrød forbindelser på grund af backend-problemer (hvilket gjorde, at ingressen ikke kunne oprette forbindelse).
Lad os se, hvordan process_control_timeout i PHP-FPM kan hjælpe os med at vente på, at child-processer afsluttes, det vil sige rette sådanne fejl. Gentagen deployment allerede med brug af dette direktiv:
Der er ikke længere 500-fejl under deployment! Deployeringen forløber uden problemer, og graceful shutdown fungerer.
Men man bør huske på, at der kan være et lille procentdel af fejl i Ingress-containere på grund af midlertidige lag. For at undgå dette kan vi tilføje en konstruktion med sleep og gentage deployment. I vores specifikke tilfælde kunne der dog ikke ses ændringer (der er stadig ingen fejl).
Konklusion
For at afslutte processen korrekt forventer vi følgende adfærd fra applikationen:
- At vente et par sekunder og derefter stoppe med at modtage nye forbindelser.
- At vente på at afslutte alle anmodninger og lukke alle keepalive-forbindelser, som ikke udfører anmodninger.
- At afslutte sin proces.
Men ikke alle applikationer kan arbejde sådan. En af løsningerne på problemet i Kubernetes-verdenen er:
- tilføjelsen af en pre-stop hook, der vil vente et par sekunder;
- gennemgangen af konfigurationsfilen for vores backend for relevante opsætningsparametre.
Eksemplet med NGINX hjælper os med at forstå, at selv den applikation, der oprindeligt skal kunne håndtere afslutningssignaler korrekt, måske ikke gør dette, derfor er det vigtigt at kontrollere for 500-fejl under applikationsdeployeringen. Det giver også mulighed for at se problemet i et bredere perspektiv og ikke kun fokusere på en enkelt pod eller container, men på hele infrastrukturen som helhed.
Som et værktøj til testning kan man bruge Yandex.Tank i kombination med et overvågningssystem (i vores tilfælde blev der brugt data fra Grafana med en backend i form af Prometheus). Problemer med graceful shutdown bliver tydeligt under høj belastning, som kan genereres af benchmark, og overvågningen hjælper med at analysere situationen mere detaljeret under eller efter testen.
Til feedback omkring artiklen: det er værd at nævne, at problemer og løsninger her beskrives i forhold til NGINX Ingress. Der findes andre løsninger til andre tilfælde, som vi muligvis vil se nærmere på i kommende materialer i serien.
P.S.
En anden fra K8s tips & tricks:
- «»;
- «»;
- «»;
- «».
Kilde: habr.com
