

Tusindvis af salgschefer fra kontorer over hele landet registrerer i dagligt titusinder af kontakter — fakta om kommunikation med potentielle eller allerede eksisterende kunder. For at finde denne kunde skal man først finde dem, og helst hurtigt. Dette sker oftest efter navn.
Derfor er det ikke overraskende, at da jeg endnu en gang gennemgik de 'tunge' forespørgsler fra en af de mest belastede databaser – vores egen , opdagede jeg 'øverst' på listen en forespørgsel til 'hurtig' søgning efter navn til organisationskort.
Desuden viste videre undersøgelser et interessant eksempel af først optimering og derefter nedgradering af ydeevnen af forespørgslen under dens sekventielle udvikling af flere teams, hvor hver arbejdede udelukkende med de bedste intentioner.
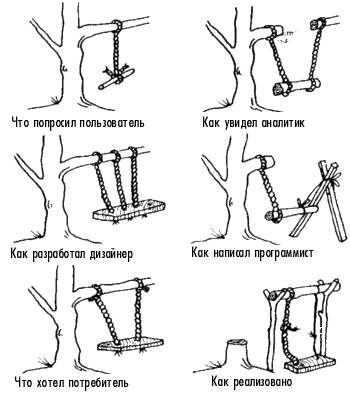
0: hvad ønskede brugeren
 [KDPV ]
Hvad mener man generelt, når brugeren taler om 'hurtig' søgning efter navn? Det er sjældent, at det viser sig at være en 'ærlig' søgning efter en delstreng som ... LIKE '%rose%' — for så ville resultaterne også inkludere 'Roselia' og 'Butik Rose', men også 'Grose' og endda 'Mor rose'.
Brugeren forventer dog på et praktisk niveau, at du kan sikre søgning på starten af ordet i titlen og vise de mere relevante resultater, der begynder med det indtastede. Og at gøre det næsten øjeblikkeligt — ved delvis indtastning.
1: afgrænse opgaven
Og slet ikke vil nogen med vilje indtaste 'rose butik', så hver eneste ord skal søges med prefix. Nej, brugeren reagerer hurtigere på en hurtig foreslået afslutning for det sidste ord end aktivt 'at mangle' de tidligere — se, hvordan enhver søgemaskine håndterer det.
Generelt er det vigtigt at formulere kravene til opgaven korrekt — mere end halvdelen af løsningen. Nogle gange kan en grundig analyse af brugstilfælde .
Hvad gør den abstrakte udvikler?
1.0: ekstern søgemaskine
Åh, søgning er svært, det er slet ikke sjovt — lad os give det til devops! Lad dem opsætte et eksternt søgesystem i forhold til databasen: Sphinx, ElasticSearch,…
Det er en arbejdskrævende, men alligevel effektiv løsning i forhold til synkronisering og hastighed af ændringer. Men ikke i vores tilfælde, da søgningen kun udføres inden for de data, der tilhører hver enkelt kundes konto. Og dataene har en betydelig grad af foranderlighed — hvis manageren nu tilføjede en post 'Rosa Butik', så kan han allerede efter 5-10 sekunder huske, at han glemte at angive en email og ønsker at finde og rette den.
Så lad os søge "direkte i databasen". Heldigvis tillader PostgreSQL os at gøre dette, og ikke med kun én metode — vi vil undersøge dem alle.
1.1: " ægte " understreng
Lad os tage fat i ordet "understreng". Og netop til indeksbaseret søgning efter understrenge (og endda ved hjælp af regulære udtryk!) er der en fremragende ! Men senere skal vi sortere det korrekt.
Lad os for enkelhedens skyld tage en sådan tabel:
CREATE TABLE firms(
  id
    serial
      PRIMARY KEY
, name
    text
);
Vi indlæser 7,8 millioner optegnelser for faktiske organisationer og indekserer dem:
CREATE EXTENSION pg_trgm;
CREATE INDEX ON firms USING gin(lower(name) gin_trgm_ops);
Lad os finde de første 10 optegnelser til understrengssøgning:
SELECT
  *
FROM
  firms
WHERE
  lower(name) ~ ('(^|s)' || 'rosa')
ORDER BY
  lower(name) ~ ('^' || 'rosa') DESC -- først "der starter med"
, lower(name) -- resten alfabetisk
LIMIT 10;
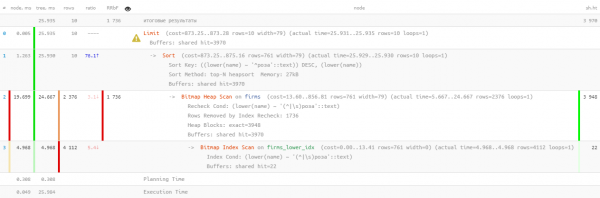
Nå, noget sådant ... 26ms, 31MB læste data og mere end 1,7K filtrerede optegnelser — for 10 forespurgt. Omkostningerne er for høje, kan vi ikke gøre det mere effektivt?
1.2: søgning efter tekst? det er jo FTS!
Faktisk giver PostgreSQL en meget kraftfuld (Full Text Search), herunder mulighed for præfiks søgning. En fremragende mulighed, selv ekstra moduler behøver ikke at installeres! Lad os prøve:
CREATE INDEX ON firms USING gin(to_tsvector('simple'::regconfig, lower(name)));SELECT
*
FROM
firms
WHERE
to_tsvector('simple'::regconfig, lower(name)) @@ to_tsquery('simple', 'rosa:*')
ORDER BY
lower(name) ~ ('^' || 'rosa') DESC
, lower(name)
LIMIT 10; 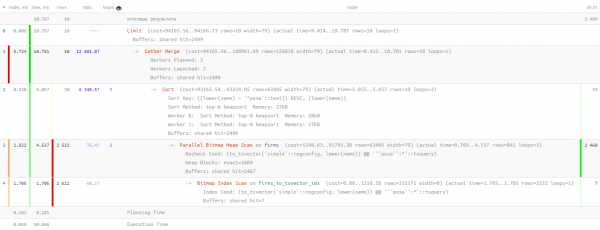
Her hjalp parallelisering af forespørgslen os lidt, hvilket halverede tiden til 11ms. Og vi måtte også læse 1,5 gange mindre — kun 20MB. Her gælder det, jo mindre desto bedre, for jo større volumen vi læser, desto større er chancerne for at få cache miss, og hver ekstra læst datablankside fra disken er potentielle "flaskehalse" for forespørgslen.
1.3: tilbage til LIKE?
Alle tidligere forespørgsler er gode, men hvis vi kalder den hundrede tusinde gange om dagen, så vil der allerede være 2TB læsning af data. I bedste fald fra hukommelsen, men hvis vi ikke er heldige, også fra disken. Så lad os prøve at gøre det lidt mindre.
Lad os huske, at brugeren ønsker at se først "som begynder med ...". Det er jo helt klart ved hjælp af text_pattern_ops! Og kun hvis vi "ikke har nok" op til 10 fundne poster, skal vi læse dem med FTS-søgning:
CREATE INDEX ON firms(lower(name) text_pattern_ops);SELECT
*
FROM
firms
WHERE
lower(name) LIKE ('rose' || '%')
LIMIT 10; 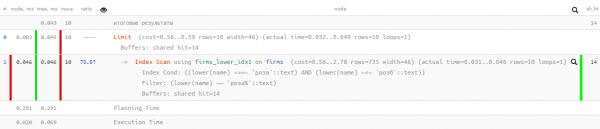
Fremragende resultater — kun 0.05ms og lidt over 100KB læst! Bare vi glemte sorteringen efter navn, så brugeren ikke bliver forvirret i resultaterne:
SELECT
  *
FROM
  firms
WHERE
  lower(name) LIKE ('rose' || '%')
ORDER BY
  lower(name)
LIMIT 10; 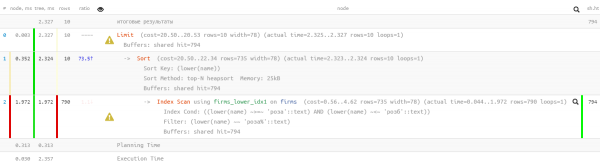
Åh, noget ser allerede ikke så pænt ud — tilsyneladende er der en indeks, men sorteringen springer over den ... Det er selvfølgelig allerede meget mere effektivt end den tidligere version, men ...
1.4: "forbedre med fil"
Men der er jo en indeks, der tillader både at søge i intervaler og samtidig bruge sortering korrekt — almindelig btree!
CREATE INDEX ON firms(lower(name));Bare forespørgslen til den skal "samles manuelt":
SELECT
  *
FROM
  firms
WHERE
  lower(name) >= 'rose' AND
  lower(name) <= ('rose' || chr(65535)) -- til UTF8, for enbyte-kodninger - chr(255)
ORDER BY
   lower(name)
LIMIT 10; 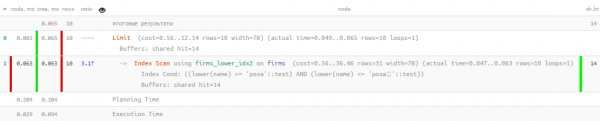
Fantastisk — både sorteringen fungerer, og ressourceforbruget forbliver "mikroskopisk", tusind gange mere effektivt end "ren" FTS! Det er kun tilbage at samle det i en samlet forespørgsel:
(
  SELECT
    *
  FROM
    firms
  WHERE
    lower(name) >= 'rose' AND
    lower(name) <= ('rose' || chr(65535)) -- til UTF8, for enbyte-kodninger - chr(255)
  ORDER BY
     lower(name)
  LIMIT 10
)
UNION ALL
(
  SELECT
    *
  FROM
    firms
  WHERE
    to_tsvector('simple'::regconfig, lower(name)) @@ to_tsquery('simple', 'rose:*') AND
    lower(name) NOT LIKE ('rose' || '%') -- "som starter med" har vi allerede fundet ovenfor
  ORDER BY
    lower(name) ~ ('^' || 'rose') DESC -- bruger den samme sortering for IKKE at gå gennem btree-indekset
  , lower(name)
  LIMIT 10
)
LIMIT 10;
Jeg bemærker, at den anden del-forspørgsel kun udføres hvis den første returnerede færre end forventet sidst LIMIT antal rækker. Jeg har allerede skrevet om denne metode til optimering af forespørgsler .
Ja, vi har nu samtidig btree og gin på tabellen, men statistisk er det blevet sådan, at mindre end 10% af forespørgslerne når at udføre den anden blok. Således, med sådanne forhåndsbestemte typiske begrænsninger for opgaven, har vi formået at reducere det samlede serverressourceforbrug næsten tusind gange!
1.5*: vi klarer os uden fil
Ovenfor LIKE vi forstyrrede vores brug af den forkerte sortering. Men det kan "føres tilbage på den rigtige vej" ved hjælp af USING-operatøren:
Som standard antages
ASC. Desuden kan navnet på en specifik sorteringsoperator angives i sætningenUSING. Sorteringsoperatoren skal være et medlem af "mindre end" eller "større end" en hvilken som helst familie af B-træ-operatører.ASCnormalt lig medUSING <ogDESCnormalt lig medUSING >.
I vores tilfælde er "mindre end" ~<~:
SELECT
  *
FROM
  firms
WHERE
  lower(name) LIKE ('rose' || '%')
ORDER BY
  lower(name) USING ~<~
LIMIT 10; 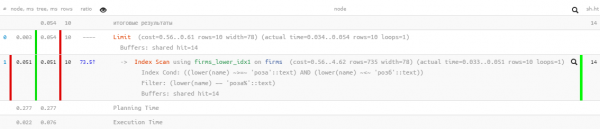
2: hvordan forespørgsler "grumser"
Nu lader vi vores forespørgsel "stege" i et halvt år til et år, og vi opdager med overraskelse, at den igen er "i toppen" med samlede daglige "opgraderinger" af hukommelsen (buffers shared hit) i 5.5TB — altså endnu mere end det var oprindeligt.
Nej, selvfølgelig, vores forretning er vokset, og belastningen er steget, men ikke så meget! Det betyder, at der er noget galt — lad os finde ud af det.
2.1: fødslen af paging
På et tidspunkt ønskede et andet udviklerteam at skabe muligheden for at "hoppe" fra den hurtige nedre søgning ind i registeret med de samme, men udvidede resultater. Og hvilket register uden sidenavigation? Lad os få det til at fungere!
( ... LIMIT  + 10)
UNION ALL
( ... LIMIT  + 10)
LIMIT 10 OFFSET ;
Nu kunne man ubesværet vise søgteresultaterne med "type-siden" indlæsning.
Selvfølgelig, i virkeligheden, for hver næste side data læses der mere og mere (alting fra sidste gang, som vi kasserer, plus den nødvendige "halebit") — det vil sige, dette er et tydeligt antipattern. Og det ville have været mere korrekt at starte søgningen på den næste iteration fra den gemte nøgle i grænsefladen, men det er en anden historie.
2.2: ønsker eksotisme
På et tidspunkt ønskede udvikleren at berige det resulterende udvalg med data fra en anden tabel, hvorfor hele den forrige forespørgsel blev sendt til CTE:
WITH q AS (
  ...
  LIMIT  + 10
)
SELECT
  *
, (SELECT ...) sub_query -- en eller anden forespørgsel til den relaterede tabel
FROM
  q
LIMIT 10 OFFSET ;
Og selv så — ikke dårligt, da den indlejrede forespørgsel kun beregnes for 10 returnerede poster, hvis det ikke var for …
2.3: DISTINCT meningsløs og ubarmhjertig
Et sted i processen med sådan en evolution gik tabt NOT LIKE betingelse. Det er klart, at efter dette UNION ALL begyndte at returnere nogle poster to gange — først fundet ved starten af strengen, og så igen — ved starten af det første ord i denne streng. I princippet kunne alle poster fra det 2. underforespørgsel matche posterne fra det første.
Hvad gør udvikleren i stedet for at finde årsagen?.. Ikke et spørgsmål!
- lad os fordoble størrelsen af de oprindelige udtag
- vi anvender DISTINCT, så der kun opnås unikke eksemplarer af hver række
WITH q AS (
  ( ... LIMIT  + 10)
  UNION ALL
  ( ... LIMIT  + 10)
  LIMIT  + 10
)
SELECT DISTINCT
  *
, (SELECT ...) sub_query
FROM
  q
LIMIT 10 OFFSET ;
Det er klart, at resultatet i sidste ende er præcis det samme, men chancen for at "glide forbi" i den 2. underforespørgsel CTE er blevet langt større, og uden det, læses åbenlyst mere.
Men det er ikke det værste. Da udvikleren bad om at udvælge DISTINCT ikke efter specifikke, men med det samme på alle felter poster, så kom feltet sub_query — resultatet af underforespørgslen automatisk med. Nu, for at udføre DISTINCT, måtte databasen allerede udføre ikke 10 underforespørgsler, men alle + 10!
2.4: samarbejde er alt!
Sådan levede udviklerne — uden bekymringer, for i registret at "dreje" til betydelige værdier N, havde brugeren åbenlyst ikke tålmodighed til den kroniske forsinkelse i at få hver næste "side".
Indtil udviklerne fra en anden afdeling kom til dem, og ønskede at bruge en så praktisk metode til iterativ søgning — det vil sige, vi tager et stykke fra et udvalg, filtrerer det på grundlag af ekstra betingelser, tegner resultatet, derefter det næste stykke (hvilket i vores tilfælde opnås ved at øge N), og så videre, indtil vi fylder skærmen.
Generelt, i den fangede instans N nåede næsten 17K, og i alt blev der udført "kædede" mindst 4K sådanne forespørgsler på en dag. Sidste af dem scannede allerede på 1GB hukommelse ved hver iteration…
I alt
Kilde: habr.com
