

Hej! Jeg hedder Alexey P'yankov, jeg er udvikler hos Sportmaster. I dette har jeg fortalt, hvordan arbejdet med Sportmaster-websitet startede i 2012, hvilke initiativer vi kunne "skubbe igennem" og omvendt, hvilke fejl vi samlede op.
I dag vil jeg dele mine tanker, der følger et andet plot – valget af cache-system til java-backend i adminpanelet på websitet. Dette plot har en særlig betydning for mig – selvom historien kun strakte sig over 2 måneder, arbejdede vi 12-16 timer om dagen uden en eneste fridag. Jeg havde aldrig før tænkt eller forestillet mig, at man kunne arbejde så meget.
Derfor opdeler jeg teksten i 2 dele, for ikke at overbelaste for meget. Omvendt vil den første del være meget let – en forberedelse, en introduktion, nogle overvejelser over, hvad caching er. Hvis du allerede er en erfaren udvikler eller har arbejdet med caches – vil der sandsynligvis ikke være noget nyt på det tekniske plan i denne artikel. Men for en junior kan en lille oversigt måske indikere, hvilken vej man skal se, hvis man befinder sig i en sådan situation.
Da den nye version af Sportmaster-websitet blev lanceret i produktion, blev dataene indhentet på en måde, vi må sige, var temmelig uhåndterlig. Grundlaget var tabeller, der var forberedt til den tidligere version af websitet (Bitrix), som skulle trækkes ind i ETL, tilpasses til den nye form og beriges med forskellige ekstra elementer fra et dusin systemer. For at et nyt billede eller en produktbeskrivelse kunne komme på websitet, måtte man vente til næste dag – opdateringer kun om natten, 1 gang om dagen.
I begyndelsen var der så mange bekymringer i de første uger efter lanceringen, at content manageres ulemper virkede ubetydelige. Men så snart det hele var faldet til ro, fortsatte projektets udvikling – i begyndelsen af 2015 begyndte vi aktivt at udvikle administrationspanelet. I 2015 og 2016 gik det godt, vi udgav regelmæssigt, administrationspanelet dækkede en stadig større del af dataforberedelsen, og vi forberedte os på, at vores team snart ville få ansvaret for det vigtigste og mest komplekse – produktkonturen (den fulde forberedelse og vedligeholdelse af data for alle produkter). Men om sommeren 2017, lige før lanceringen af produktkonturen, kom projektet i en meget vanskelig situation – netop på grund af problemer med caching. Om dette episode vil jeg gerne fortælle i den anden del af denne to-delte publikation.
Men i dette indlæg vil jeg starte fra begyndelsen og opsummere nogle tanker – ideer om caching, som det ville være en god idé at overveje på forhånd inden et stort projekt.
Når opgaven med caching opstår
Cache-opgaven opstår ikke bare sådan. Vi er udviklere, skriver softwareprodukter, og vi ønsker, at de skal være eftertragtede. Hvis produktet er eftertragtet og succesfuldt – kommer brugerne. Og endnu flere kommer, og så videre. Og pludselig er der rigtig mange brugere, og så bliver produktet højt belastet.
I de tidlige faser tænker vi ikke på optimering og kodeydelse. Det vigtigste er funktionalitet, hurtigt at få pilotversionen ud og teste hypoteser. Og hvis belastningen stiger – opgraderer vi hardwaren. Vi øger den med to til tre, fem, lad os sige ti gange. Her begynder økonomien dog at sætte grænser. Og hvor mange brugere kan vi forvente i fremtiden? Det vil ikke kun være 2-5-10, men i tilfælde af succes – fra 100 til 1000 og op til 100.000 gange. Sådan at på et tidspunkt må vi tage os af optimering.
Lad os antage, at en del af koden (lad os kalde den funktion) kører bemærkelsesværdigt langsomt, og vi ønsker at reducere eksekveringstiden. En funktion kan være adgang til en database eller udførelse af en kompleks logik – det vigtigste er, at den tager lang tid. Hvor meget kan eksekveringstiden reduceres? I teorien kan den reduceres til nul, ikke mindre. Men hvordan kan vi reducere eksekveringstiden til nul? Svaret er: ved slet ikke at udføre den. I stedet kan vi straks returnere resultatet. Hvordan kan vi finde resultatet? Svaret er: enten beregne det, eller kigge det op et sted. At beregne det tager tid. At kigge det op er, for eksempel, at huske det resultat, som funktionen gav sidste gang, da den blev kaldt med de samme parametre.
Det vil sige, implementeringen af funktionen er ikke så vigtig for os. Det er kun nødvendigt at vide, hvilke parametre resultatet afhænger af. Hvis vi så præsenterer værdierne for parametrene som et objekt, der kan bruges som en nøgle i et eller andet lager – kan vi gemme resultatet og ved næste anmodning hente det. Hvis disse opslag og hentninger går hurtigere end at udføre funktionen, så får vi en hastighedsfordel. Fordelen kan være op til 100, 1000 eller endda 100.000 gange (10^5 er næppe normen, men i tilfælde af en betydeligt langsom database er det helt muligt).
De grundlæggende krav til et cache-system
Det første, der kan blive et krav til et cache-system, er hurtig læsehastighed og i lidt mindre grad – skrivehastighed. Dette er korrekt, men kun indtil vi ruller systemet ud i produktion.
Lad os overveje et scenario.
Antag, at vi har sikret hardware til den nuværende belastning, og nu gradvist implementerer caching. Antallet af brugere stiger lidt, belastningen vokser – vi tilføjer lidt caching, tilslutter det her og der. Dette fortsætter i noget tid, og nu bliver de tunge funktioner næsten ikke kaldt – al den primære belastning ligger på cachen. Antallet af brugere er steget med N gange i denne periode.
Og hvis det oprindelige hardware-boost var 2-5 gange, så har vi med caching kunnet trække ydeevnen op til 10 gange eller, i bedste fald, 100 gange, og nogle steder endda 1000 gange. Det vil sige, på den samme hardware – behandler vi 100 gange flere forespørgsler. Fantastisk, vi har fortjent en belønning!
Men nu, i et pludseligt øjeblik, gik systemet i stå, og cachen kollapsede. Ikke noget særligt – for cache blev valgt efter kriteriet "høj læse- og skrivehastighed, resten er ikke vigtigt".
I forhold til den startbelastning havde vi en hardwaremargin på 2-5 gange, mens belastningen i mellemtiden var steget 10-100 gange. Ved hjælp af cachen undgik vi kald til tunge funktioner, og derfor fungerede alt gnidningsfrit. Men nu, uden cache – hvor meget vil vores system falde? Hvad vil der ske? Systemet vil gå ned.
Selv hvis vores cache ikke er kollapset, men kun er blevet tømt i et stykke tid – skal den varmes op, og det vil tage noget tid. Og i denne tid vil den primære belastning ligge på funktionaliteten.
Konklusion: højbelastede projekter i produktion kræver af systemet, at caching ikke kun har høj læse- og skrivehastighed, men også databevaring og modstandsdygtighed over for fejl.
Valgets kvaler
I projektet med administrationspanelet blev valgprocessen således: først installerede vi Hazelcast, da vi allerede var bekendt med dette produkt gennem erfaringen fra hovedwebsitet. Men her viste denne beslutning sig at være uheldig – under vores belastningsprofil arbejder Hazelcast ikke bare langsomt, men ekstremt langsomt. Og med de frister for at gå i produktion, havde vi allerede skrevet under på det.
Spoiler: hvordan omstændighederne udfoldede sig, så vi overså en sådan faldgrube og havnede i en akut og anspændt situation – vil jeg fortælle i del to — og hvordan vi endte, og hvordan vi kom ud af det. Men lige nu – vil jeg kun sige, at det var en stærk stress, og "at tænke – det er svært, vi ryster flasken". "Vi ryster flasken" – det er også en spoiler, om dette senere.
Hvad vi gjorde:
- Vi laver en liste over alle systemer, som Google og StackOverflow foreslår. Lidt over 30
- Vi skriver testcases med en belastning, der er karakteristisk for produktionen. Til dette har vi optaget data, der passerer gennem systemet i produktionsmiljøet – en slags sniffer for data ikke i netværket, men inde i systemet. I testene kørte vi netop disse data.
- Hele teamet, hver vælger det næste system fra listen, konfigurerer og kører testene. Bestandstest, der ikke klarer belastningen – kasserer vi og går videre til den næste i køen.
- Ved det 17. system blev det klart, at alt var håbløst. Nok med at "ryst flasken", tid til seriøs refleksion.
Men dette er et valg, når man skal vælge et system, der "kan klare sig hastighedsmæssigt" i de forberedte tests. Men hvad hvis der ikke findes sådanne tests, og man ønsker at vælge hurtigere?
Lad os modellere et sådant scenarie (det er svært at forestille sig, at en mid-level udvikler lever i et vakuum, og på tidspunktet for valget ikke har angivet præferencer for, hvilket produkt man ønsker at prøve først - derfor er de videre overvejelser mere teoretiske/filosofiske/om juniordevs).
Når kravene er fastlagt, begynder vi at vælge en out-of-the-box løsning. Der er ingen grund til at opfinde hjulet: vi vil tage et færdiglavet cache-system.
Hvis du lige er startet og vil google, så kan rækkefølgen være plus-minus, men generelt vil pejlemærkerne være sådanne. Først vil du støde på Redis, det er overalt. Så vil du finde ud af, at der er EhCache som det ældste og mest pålidelige system. Derefter vil Tarantool komme på tale - en indenlandsk udvikling med et unikt aspekt. Og selvfølgelig Ignite, fordi det lige nu er i høj popularitet og understøttes af SberTech. Til sidst vil Hazelcast også blive nævnt, for det dukker ofte op i enterprise-verdenen blandt store virksomheder.
Dette er ikke en udtømmende liste, der findes dusinvis af systemer. Men vi vil kun tage ét. Vi vil tage de valgte 5 systemer til en "skønhedskonkurrence" og lave en udvælgelse. Hvem vil være vinderen?
Redis
Lad os læse, hvad der står på den officielle hjemmeside.
– et open-source projekt. Tilbyder et in-memory datalager, mulighed for on-disk lagring, automatisk partitionering, høj tilgængelighed og genopretning efter netværksbrud.
Det ser ud til, at alt er i orden, man kan tage det og integrere det - alt hvad der er nødvendigt, gør det. Men lad os lige af ren nysgerrighed se på de andre kandidater.
EhCache
– "den mest udbredte cache til Java" (oversættelse af sloganet fra den officielle hjemmeside). Også open-source. Her forstår vi, at Redis ikke er til Java, men er generelt, og for at interagere med det kræves der et wrapper. EhCache vil være mere praktisk. Hvad mere lover systemet? Pålidelighed, afprøvethed, fuld funktionalitet. Og så er det det mest udbredte. Og det cacher terabytes af data.
Redis er glemt, jeg er klar til at vælge EhCache.
Men patriotismen får mig til at se på, hvad der er godt ved Tarantool.
Tarantool
— møder betegnelsen «Data Integrationsplatform i realtid». Det lyder meget kompliceret, så lad os læse siden grundigt og finde den stærke påstand: «Cache lagrer 100% af dataene i den primære hukommelse». Dette skal vække spørgsmål – for dataene kan være betydeligt mere end hukommelsen. Forklaringen er, at når data skal skrives til disken fra hukommelsen, bruger Tarantool ikke serialisering. I stedet bruger det lavniveau egenskaber i systemet, hvor hukommelsen blot kortlægges til filsystemet med meget gode I/O præstationer. Alt i alt, de har gjort det på en bemærkelsesværdig og smart måde.
Lad os se på implementeringerne: Mail.ru korporativet, Avito, Beeline, Megafon, Alfa-Bank, Gazprom…
Hvis der stadig er nogen tvivl om Tarantool, så nedkæmper implementeringscasen i Mastercard mig. Jeg vælger Tarantool.
Men alligevel…
Ignite
… er der også , præsenteret som «in-memory beregningsplatform… in-memory hastigheder på petabyte data». Her er der også mange fordele: distribueret in-memory cache, det hurtigste key-value lager og cache, horisontal skalerbarhed, høj tilgængelighed, strengt dataintegritet. Så viser det sig, at den hurtigste er Ignite.
Implementeringer: Sberbank, American Airlines, Yahoo! Japan. Og så finder jeg ud af, at Ignite ikke kun er implementeret i Sberbank, men at SberTech-teamet sender deres folk til Ignite-teamet for at udvikle produktet. Det overbeviser mig helt, og jeg er klar til at vælge Ignite.
Hele femte punkt er helt uforståeligt for mig.
Hazelcast
Jeg går ind på hjemmesiden , læser. Og det viser sig, at den hurtigste løsning til distribueret caching er Hazelcast. Det er mange gange hurtigere end alle andre løsninger og faktisk lederen inden for in-memory data grids. I lyset af dette ville det være en skam at vælge noget andet. Og det bruger også redundant datalagring for at sikre, at klyngen fungerer kontinuerligt uden datatab.
Det er det, jeg er klar til at vælge Hazelcast.
Sammenligning
Men hvis man ser efter, så er alle fem kandidater så beskrevet, at hver af dem er den bedste. Hvordan vælger man? Vi kan se, hvilken af dem der er mest populær, søge efter sammenligninger, så forsvinder hovedpinen.
Vi finder en sådan , vælger vores 5 systemer.
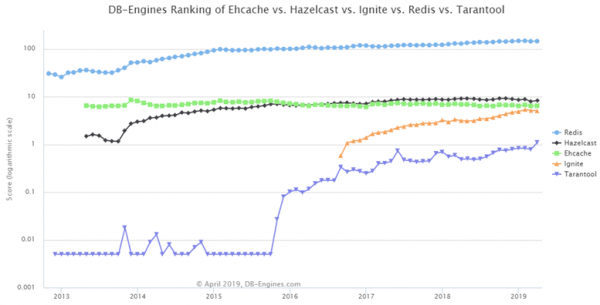
Her er de sorteret: øverst Redis, på andenpladsen — Hazelcast, Tarantool og Ignite vinder popularitet, mens EhCache forbliver den samme.
Men lad os se på : links til hjemmesider, generel interesse for systemet, jobtilbud — fantastisk! Så når mit system går ned, kan jeg sige: «Nej, det er jo pålideligt! Der er mange jobtilbud...». En så simpel sammenligning vil ikke holde.
Alle disse systemer er ikke bare caching-systemer. De har også mange funktioner, herunder - hvor ikke data sendes til klienten til behandling, men i stedet: koden, der skal køres på dataene, flyttes til serveren, hvor den udføres, og resultatet returneres. Som en separat caching-løsning bliver de ikke så ofte betragtet.
Okay, vi giver ikke op, lad os finde en direkte sammenligning af systemerne. Lad os tage de to bedste muligheder - Redis og Hazelcast. Vi interesserer os for hastigheden, så vi sammenligner dem ud fra dette parameter.
Hz vs Redis
Lad os finde sådan en :
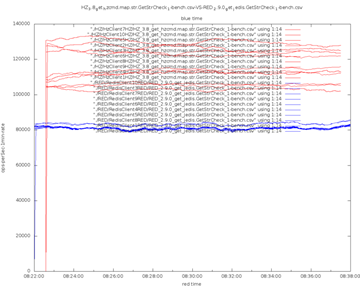
Blå er Redis, rød er Hazelcast. Hazelcast vinder overalt, og der er en grund til det: det er multitrådede, højt optimerede, hver tråd arbejder med sin partition, så der er ingen blokeringer. Redis er derimod entrådet og drager ikke fordel af moderne flerkernede CPU'er. Hazelcast bruger asynkront I/O, mens Redis-Jedis bruger blokerende sockets. I sidste ende bruger Hazelcast et binært protokol, mens Redis er tekstbaseret, hvilket gør det ineffektivt.
Til information vil vi se på endnu en kilde til sammenligning. Hvad vil den vise os?
Redis vs Hz
En anden :
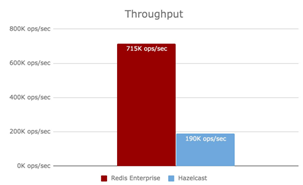
Her er det omvendt, rød er Redis. Det vil sige, Redis vinder i ydeevne over Hazelcast. I den første sammenligning vandt Hazelcast, i den anden vandt Redis. forklarede de meget præcist, hvorfor Hazelcast vandt i den tidligere sammenligning.
Det viser sig, at resultatet af den første faktisk var manipuleret: Redis blev taget i sin grundlæggende form, mens Hazelcast blev tilpasset til testtilfældet. Det betyder: for det første, man kan ikke stole på nogen, for det andet, når vi endelig vælger et system, skal vi også konfigurere det korrekt. Disse indstillinger omfatter dusinvis, næsten hundrede parametre.
Ryst flasken
Og hele den proces, vi netop har gennemgået, kan jeg forklare med den metafor «Ryst flasken». Det vil sige, lige nu kan man ikke programmere, det vigtigste er at kunne læse stackoverflow. Og jeg har en person på mit team, en professionel, der netop arbejder sådan i kritiske øjeblikke.
Hvad gør han? Han ser en defekt ting, ser stack trace, tager nogle af ordene derfra (hvilke præcist — det er hans ekspertise i programmet), søger på Google, finder Stack Overflow blandt svarene. Uden at læse grundigt, uden at overveje, blandt svarene vælger han noget, der ligner en sætning som "gør dette og andet" (det er hans talent at vælge sådan et svar, for det er ikke altid det svar, der har fået flest likes), anvender det, kigger: hvis noget har ændret sig, så er det fantastisk. Hvis der ikke er ændret noget — ruller vi tilbage. Og vi gentager kørsel-kontrol-søgning. Og på denne intuitive måde når han til, at koden efter noget tid virker. Han ved ikke hvorfor, han ved ikke hvad han har gjort, han kan ikke forklare det. Men! Det virker. Og "branden er slukket". Nu lad os finde ud af, hvad vi gjorde. Når programmet virker — er det meget lettere. Og sparer betydeligt tid.
Denne metode forklares meget godt med et sådant eksempel.
Engang var det meget populært at samle et skib i en flaske. Skibet er stort og skrøbeligt, og flaskehalsen er meget smal, det kan ikke presses indenfor. Hvordan samler man det?
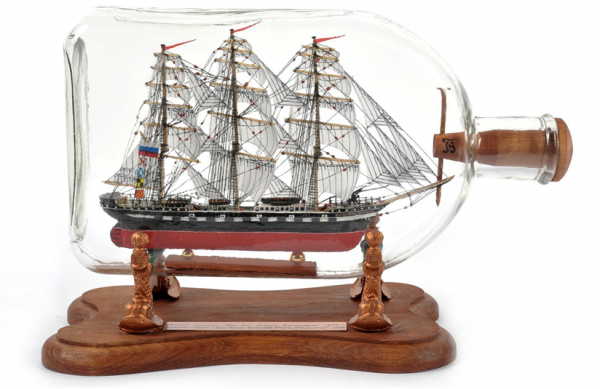
Der er en metode, meget hurtig og meget effektiv.
Skibet består af en masse småting: træstykker, reb, sejl, lim. Alt dette lægger vi i flasken.
Vi tager flasken med to hænder og begynder at ryste. Vi ryster den og ryster den. Og normalt — bliver det naturligvis noget skrammel. Men nogle gange. Nogle gange bliver det et skib! Mere præcist, noget der ligner et skib.
Vi viser dette noget til nogen: "Sergio, ser du!?". Og faktisk, fra afstand – ligner det et skib. Men længere skal det ikke sendes.
Der er en anden metode. De mere avancerede fyre bruger, sådanne hackere.
Jeg gav sådan en fyr en opgave, han gjorde alt og gik. Og man kigger – det ser ud til at være gjort. Men efter noget tid, når der skal arbejdes videre med koden — så begynder der sådan noget fra ham… Godt for ham, at han allerede har løbet langt væk. Det er sådanne fyre, der på eksemplet med flasken gør sådan: ser du, hvor bunden er – bøjer glasset. Og det er ikke helt klart, om det er klart eller ej. Så "hackere" saver bunden af, indsætter skibet indeni, bunden limes så tilbage, og det ser ud til, at det altid har været sådan.
Når det kommer til opgaveformuleringen, ser alt ud til at være korrekt. Men når vi ser på eksemplet med skibene: hvorfor overhovedet lave denne skib, og hvem har brug for det? Det har ingen funktionalitet. Normalt er sådanne skibe gaver til meget højtstående personer, der placerer det på en hylde over sig selv som en visuel symbolik. Og hvis en sådan person, en leder af en stor virksomhed eller en højtstående embedsmand, har en sådan amatørarbejde som flag, hvor halsen er skåret af? Det ville være bedre, hvis han aldrig fik nys om det. Så hvordan bliver disse skibe, der kan gives til en vigtig person, faktisk lavet?
Det eneste sted, der virkelig ikke kan ændres, er skroget. Og skroget passer netop gennem halsen. Skibet samles dog uden for flasken. Men det er ikke bare at samle skibet; det er et ægte håndværk. Der tilføjes specielle håndtag til de sammensatte dele, så de senere kan løftes. For eksempel foldes sejlene forsigtigt ind, og derefter bruges en pincet til meget præcist at trække og hæve dem. Resultatet bliver et kunstværk, som kan gives med god samvittighed og stolthed.
Og hvis vi vil, at projektet skal være succesfuldt, skal der være mindst én juveler på holdet. En, der bekymrer sig om produktkvaliteten og tager højde for alle aspekter uden at gå på kompromis, selv i stressede øjeblikke, hvor omstændighederne kræver hurtige beslutninger på bekostning af det vigtige. Alle succesfulde projekter, der er bæredygtige og har bestået tidens prøve, er bygget på dette princip. De har noget meget præcist og unikt, noget der udnytter alle tilgængelige muligheder. I eksemplet med skibet i flasken spilles der med det faktum, at skroget passer gennem halsen.
Når vi vender tilbage til opgaven med at vælge vores caching-server, hvordan kunne denne tilgang så anvendes? Jeg foreslår en metode, der ikke inkluderer at ryste flasken eller vælge, men snarere at se, hvad der i bund og grund er værd at bemærke ved valget af system.
Hvor skal man lede efter flaskehalse?
Lad os prøve ikke at ryste flasken, ikke gennemgå alt i rækkefølge, men se på, hvilke opgaver der opstår, hvis vi pludselig skal designe et sådant system selv. Vi vil selvfølgelig ikke samle cyklen, men vi vil bruge dette skema til at orientere os om, hvilke aspekter vi skal være opmærksomme på i produktbeskrivelserne. Lad os skitsere et sådant skema.
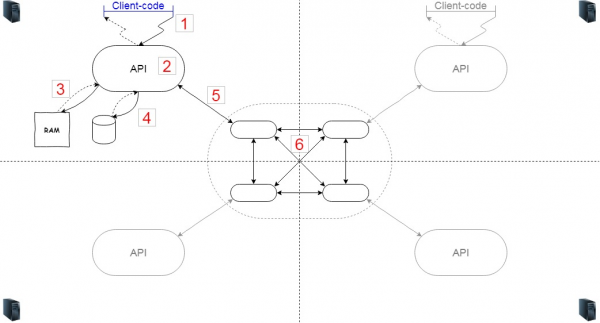
Hvis systemet er distribueret, så vil vi have flere servere (6). Lad os antage, at der er fire (praktisk at visualisere, men der kan selvfølgelig være så mange, man vil). Hvis serverne er på forskellige noder, så kører der noget kode på dem alle, der sørger for, at disse noder danner et cluster og i tilfælde af brud – kan forbinde og genkende hinanden.
Der kræves også kode-logik (2) specifikt til cache-håndtering. Denne kode interagerer med klienterne gennem et bestemt API. Klientkoden (1) kan være inden for den samme JVM eller kontakte den over netværket. Logikken, der implementeres internt, handler om, hvilke objekter der skal forblive i cachen, og hvilke der skal smides væk. Vi bruger hukommelse (3) til at opbevare cachen, men hvis det er nødvendigt, kan vi også gemme nogle data på disk (4).
Lad os se, hvilke dele der vil opleve belastning. Faktisk vil hver pil og hver node være belastet. For det første, mellem klientkoden og API'en, hvis det er en netværksinteraktion, kan der være en betydelig forsinkelse. For det andet, inden for selve API'en — hvis logikken bliver for kompleks, kan vi støde på CPU-begrænsninger. Og det ville være godt, hvis logikken ikke unødigt bruger hukommelse. Og der er også interaktionen med filsystemet – i en almindelig situation er det at serialisere / gendanne og skrive / læse.
Dernæst interaktionen med clustret. Det vil sandsynligvis være inden for dette samme system, men det kan også være separat. Her skal vi også tage højde for dataoverførslen til det, hastigheden for data-serialisering og interaktionen mellem clustret.
Nu kan vi dels forestille os, „hvilke tandhjul der vil dreje“ i cache-systemet ved behandlingen af forespørgsler fra vores kode, og på den anden side kan vi estimere, hvilke og hvor mange forespørgsler vores kode vil generere til dette system. Dette er tilstrækkeligt til at træffe et mere eller mindre rationelt valg – at vælge et system, der passer til vores brugssituation.
Hazelcast
Lad os se på, hvordan sådan en opdeling kan anvendes på vores liste. For eksempel, Hazelcast.
For at gemme/hente data fra Hazelcast henvender klientkode sig (1) til API'en. Hz gør det muligt at køre serveren som embedded, og i så fald er henvendelsen til API'en et metodekald inden for JVM, noget man kan betragte som gratis.
For at logikken fungerer i (2), baserer Hz sig på en hash af en byte-array af den serialiserede nøgle – det vil sige, at serialiseringen af nøglen vil ske uanset hvad. Dette er en uundgåelig overhead for Hz.
Eviction-strategierne er godt implementeret, men til særlige tilfælde kan man tilslutte sine egne. Man skal ikke bekymre sig om denne del.
Lagringen (4) kan tilsluttes. Fremragende. Interaktionen (5) for embedded kan betragtes som øjeblikkelig. Dataudvekslingen mellem noderne i klyngen (6) – ja, den findes. Det er et bidrag til fejltolerance på bekostning af hastigheden. Hertz-funktionaliteten Near-cache gør det muligt at reducere prisen – data, der er hentet fra andre noder i klyngen, vil blive cachet.
Hvad kan man gøre under sådanne betingelser for at øge hastigheden?
For eksempel, for at undgå at serialisere nøglen i (2) – tilføje endnu en cache oven på Hazelcast for de mest varme data. Hos Sportmaster valgte de Caffeine til dette formål.
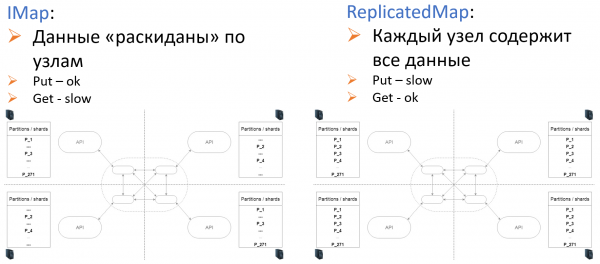
For at justere på niveau (6), tilbydes to typer lagring i Hz: IMap og ReplicatedMap.
Det er værd at nævne, hvordan Hazelcast kom ind i teknologi-stakken hos Sportmaster.
I 2012, da vi arbejdede på det allerførste pilotprojekt til den kommende hjemmeside, var det faktisk Hazelcast, der var det første link, som søgemaskinen viste. Bekendtskabet begyndte 'fra første gang' – vi blev charmeret over, at allerede to timer efter, at vi integrerede Hz i systemet, – så fungerede det. Og det virkede godt. Inden dagen var omme, havde vi skrevet nogle tests og blev glade. Og denne energi var nok til at overvinde de overraskelser, som Hz gav med tiden. Lige nu har Sportmaster-teamet ingen grunde til at opgive Hazelcast.
Men sådanne argumenter som 'første link i søgemaskinen' og 'hurtigt oprettet HelloWorld' – er selvfølgelig undtagelsen og et særligt øjeblik i valget. De virkelige udfordringer for det valgte system starter, når man går i produktion, og det er netop i denne fase, man skal lægge mærke til ved valget af ethvert system, inklusive cache. Egentlig kan man sige, at vi valgte Hazelcast ved en tilfældighed, men senere viste det sig, at vi valgte rigtigt.
For production, monitoring, handling failures on individual nodes, data replication, and the cost of scaling are much more important. That is, it's essential to pay attention to the challenges that will arise during system maintenance – when the load exceeds what was planned by dozens of times, when we unintentionally upload something inappropriate, when we need to roll out a new version of code, replace data, and do it without customers noticing.
For all these requirements, Hazelcast is certainly suitable.
To be continued
But Hazelcast is not a panacea. In 2017, we chose Hazelcast for caching in the admin, purely based on a positive impression from past experience. This played a key role in a very nasty joke that put us in a tough situation, from which we 'heroically' extricated ourselves for 60 days. But more about that in the next part.
For now… Happy New Code!
Kilde: habr.com
