

De interne mekanismers funktioner i PostgreSQL gør det muligt for den at være meget hurtig i visse situationer og "ikke så hurtig" i andre. I dag vil vi fokusere på et klassisk eksempel på konflikten mellem, hvordan en DBMS fungerer, og hvad udvikleren gør med den — UPDATE vs MVCC-principper.
Kort plot fra :
Når en række ændres med en UPDATE-kommando, udføres der faktisk to operationer: DELETE og INSERT. I den nuværende version af rækken eller ny version, sættes xmax til nummeret på den transaktion, der udførte UPDATE. Derefter oprettes der en ny version af den samme række; værdi xmax for den matcher xmax-værdien for den tidligere version.
Efter et stykke tid, når denne transaktion er afsluttet, vil den gamle eller nye version, afhængigt af COMMIT/ROLLBACK, blive anerkendt som "døde" (dead tuples) ved en gennemgang VACUUM af tabellen og oprydning.
Men det vil ikke ske med det samme, og problemer med "de døde" kan hurtigt opstå — ved gentagen eller i en stor tabel, og lidt senere støder man på situationen, hvor selv .
#1: I Like To Move It
Lad os sige, at din metode fungerer fint, og du pludselig finder ud af, at du skal opdatere felt X i en bestemt post:
UPDATE tbl SET X = WHERE pk = $1;Så, i løbet af eksekveringen, finder du ud af, at felt Y også skal opdateres:
UPDATE tbl SET Y = WHERE pk = $1;… og så Z — hvorfor ikke gå hele vejen?
UPDATE tbl SET Z = WHERE pk = $1;Hvor mange versioner af denne post har vi nu i databasen? Ah, 4 stykker! Heraf en aktuel, og de 3 skal du rydde op efter [auto]VACUUM.
Gør ikke sådan! Brug opdatering af alle felter i én forespørgsel — næsten altid kan logikken i metoden ændres sådan:
UPDATE tbl SET X = , Y = , Z = WHERE pk = $1;#2: Use IS DISTINCT FROM, Luke!
Så, hvis du stadig ønskede at (under anvendelse af et script eller konverter, for eksempel). Og scriptet indeholder noget som:
UPDATE tbl SET X = WHERE pk BETWEEN $1 AND $2;Eksemplet findes i denne form ret ofte, og næsten altid ikke for at udfylde et nyt tomt felt, men til at korrigere nogle fejl i data. I denne forbindelse tages selve korrektheden af allerede eksisterende data overhovedet ikke i betragtning — og det er en skam! Det vil sige, at posten skrives over, selvom det var præcis det, der skulle til — og hvorfor? Lad os justere:
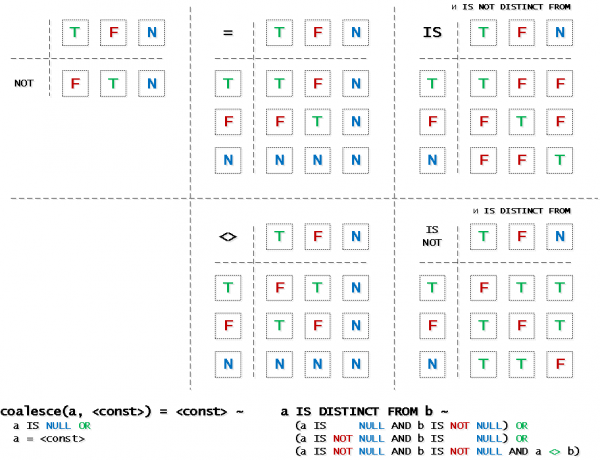
UPDATE tbl SET X = WHERE pk BETWEEN $1 AND $2 AND X IS DISTINCT FROM ; Mange er ikke klar over eksistensen af en så fantastisk operator, så her er en huskeseddel om IS DISTINCT FROM og andre logiske operatorer til hjælp:
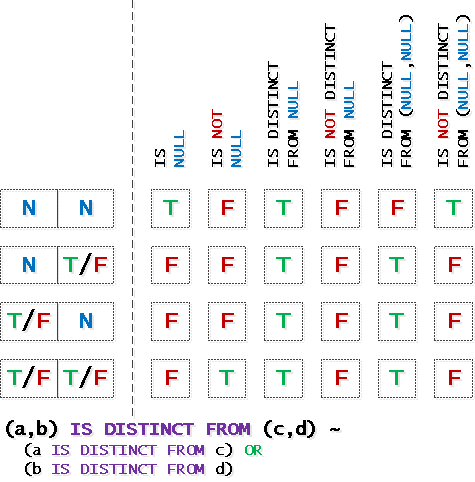
… og lidt om operationer med komplekse ROW()-udtryk:
#3: А я милого узнаю по… блокировке
To ens parallelle processer bliver startet , hver af dem forsøger at markere posten som "i gang":UPDATE tbl SET processing = TRUE WHERE pk = $1;
Selvom disse processer praktisk talt udfører uafhængige ting fra hinanden, vil den anden klient "låse sig" på denne forespørgsel, så længe den første transaktion ikke er afsluttet.Løsning #1
: opgaven er reduceret til den forrigeLad os blot tilføje
UPDATE tbl SET processing = TRUE WHERE pk = $1 AND processing IS DISTINCT FROM TRUE; IS DISTINCT FROM:
På denne måde vil den anden forespørgsel bare ikke ændre noget i databasen, da alt allerede er "som det skal være" - derfor vil der ikke opstå nogen blokering. Faktisk vil vi derefter håndtere det, at posten "ikke findes" i den applikationsalgoritme.Løsning #2
: advisory locksEt stort emne til en separat artikel, hvor man kan læse om
anvendelsesmetoder og "fælder" ved rådgivende låsninger .
: tåbelige kaldMen I er helt sikre på, at der skal ske
samtidig arbejde med den samme post Delta Chat 1.2 er nu tilgængelig til Android og iOS? Или вы все-таки накосячили с алгоритмами вызовов бизнес-логики со стороны клиента, например? А если подумать?..
Kilde: habr.com
