

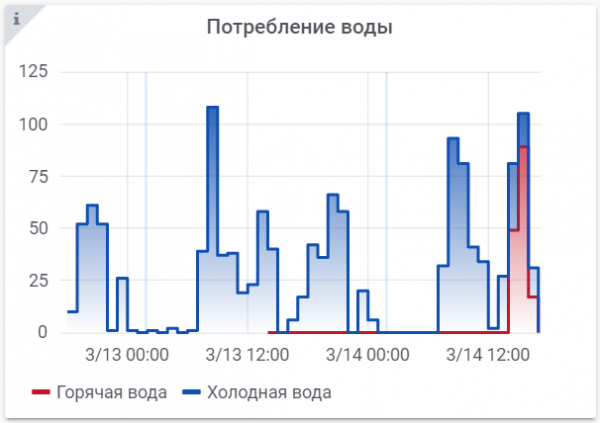
Hver gang jeg modtager regningen for elektricitet og vand, undrer jeg mig — forbruger min familie virkelig så meget? Ja, der er varmeunderlag og en varmtvandsbeholder i badeværelset, men de kører jo ikke hele tiden. Vi prøver også at spare på vandet (selvom vi også godt kan lide at tage karbad). For flere år siden og til mit smarte hjem, men så stoppede det ligesom der. Først nu er jeg kommet til at analysere forbruget, og det er, hvad denne artikel handler om.
For nylig skiftede jeg til Home Assistant som mit smarte hjem-system. En af grundene var netop muligheden for at organisere indsamlingen af mange data med muligheden for nemt at opbygge forskellige typer grafer.
Oplysningerne beskrevet i denne artikel er ikke nye, alle disse ting er allerede blevet beskrevet online i forskellige former. Men hver artikel beskriver som regel kun én tilgang eller aspekt. At sammenligne alle disse tilgange og vælge den mest passende måtte jeg gøre selv. Artiklen giver stadig ikke fyldestgørende information om indsamling af data, men fungerer som et slags resumé af, hvordan jeg gjorde det. Så konstruktiv kritik og forslag til forbedringer er velkomne.
Problemformulering
Så målet for dagens øvelse er at få flotte grafer over vand- og elforbrug:
- Timebaseret for 2 dage
- Dagligt for 2 uger
- (valgfrit) ugentligt og månedligt
Her står vi over for nogle udfordringer:
- Standardgrafkomponenter er som regel ret begrænsede. I bedste fald kan man lave en linjegraf baseret på punkter.
Hvis man søger godt, kan man finde tredjeparts komponenter, der udvider mulighederne for den standardgraf. For Home Assistant er der en ret god og pæn komponent , men den er også lidt begrænset:
- Det er svært at indstille parametre for søjlediagrammer over lange intervaller (søjlens bredde indstilles i timer, hvilket betyder, at intervaller længere end en time vil blive angivet med brøker)
- Man kan ikke tilføje forskellige enheder på én graf (for eksempel temperatur og luftfugtighed, eller kombinere et søjlediagram med en linje)
- Ikke blot bruger home assistant som standard den mest primitive database SQLite (og jeg, hænderne på ryggen, kunne ikke få installeret MySQL eller Postgres), men dataene gemmes heller ikke på den mest optimale måde. For eksempel, ved hver ændring af selv den mindste digitale parameter skrives der en enorm JSON på omkring et kilobyte til databasen.
{"entity_id": "sensor.water_cold_hourly", "old_state": {"entity_id": "sensor.water_cold_hourly", "state": "3", "attributes": {"source": "sensor.water_meter_cold", "status": "collecting", "last_period": "29", "last_reset": "2020-02-23T21:00:00.022246+02:00", "meter_period": "hourly", "unit_of_measurement": "l", "friendly_name": "water_cold_hourly", "icon": "mdi:counter"}, "last_changed": "2020-02-23T19:05:06.897604+00:00", "last_updated": "2020-02-23T19:05:06.897604+00:00", "context": {"id": "aafc8ca305ba4e49ad4c97f0eddd8893", "parent_id": null, "user_id": null}}, "new_state": {"entity_id": "sensor.water_cold_hourly", "state": "4", "attributes": {"source": "sensor.water_meter_cold", "status": "collecting", "last_period": "29", "last_reset": "2020-02-23T21:00:00.022246+02:00", "meter_period": "hourly", "unit_of_measurement": "l", "friendly_name": "water_cold_hourly", "icon": "mdi:counter"}, "last_changed": "2020-02-23T19:11:11.251545+00:00", "last_updated": "2020-02-23T19:11:11.251545+00:00", "context": {"id": "0de64b8af6f14bb9a419dcf3b200ef56", "parent_id": null, "user_id": null}}}Jeg har ret mange sensorer (temperaturmålere i hvert rum, vand- og elmålere), og nogle genererer desuden en del data. For eksempel genererer el-måleren SDM220 omkring ti værdier hvert 10-15. sekund, og jeg ville gerne installere omkring 8 af sådanne målere. Derudover er der en hel bunke parametre, der beregnes på baggrund af andre sensorer. Så alle disse værdier kan nemt få databasen til at vokse med 100-200 MB dagligt. Efter en uge vil systemet næsten være i stand til at fungere, og efter en måned vil USB-stikket svigte (i tilfælde af en typisk installation af home assistant på en Raspberry Pi), og der kan slet ikke være tale om at gemme data i et helt år.
- Hvis du er heldig, kan din måler selv holde styr på forbruget. Du kan til enhver tid henvende dig til måleren og spørge, hvilken time det akkumulerede forbrug er. Som regel giver alle elmålere med et digitalt interface (RS232/RS485/Modbus/Zigbee) denne mulighed.
Det er værre, hvis enheden blot kan måle en øjeblikkelig parameter (fx øjeblikkelig effekt eller strøm) eller blot generere impulser hver X watt-timer eller liter. Så skal man tænke over, hvordan og med hvilket udstyr det skal integreres, og hvor værdien skal opbevares. Der er en risiko for, at man går glip af en rapport af en eller anden grund, og systemets nøjagtighed i sin helhed rejser spørgsmål. Man kan selvfølgelig overlade alt dette til et smart home-system som home assistant, men punktet om antallet af poster i databasen er stadig relevant, og man kan ikke spørge sensorer oftere end en gang i sekundet (begrænsning i home assistant-arkitekturen).
Tilgang 1
Først ser vi på, hvad home assistant tilbyder ud af boksen. Mål for forbrug over en periode er en meget efterspurgt funktion. Naturligvis er den blevet implementeret for længst som en specialiseret komponent — utility_meter.
Essensen af komponenten er, at den internt opretter en variabel current_accumulated_value og nulstiller den efter udløbet af den angivne periode (time/uge/måned). Komponentet overvåger selv den indkommende variabel (værdien af en sensor) og abonnerer selv på ændringer i værdien — du får blot det færdige resultat. Denne ting beskrives blot med et par linjer i konfigurationsfilen.
utility_meter:
  water_cold_hour_um:
    source: sensor.water_meter_cold
    cycle: hourly
  water_cold_day_um:
    source: sensor.water_meter_cold
    cycle: daily
Her er sensor.water_meter_cold den aktuelle værdi af måleren i liter, som jeg modtager via mqtt. Strukturen opretter 2 nye sensorer, water_cold_hour_um og water_cold_day_um, som opsamler time- og dagsmålinger og nulstiller dem efter periodeens udløb. Her er grafen for det timebaserede opsamlingssystem over en halv dag.
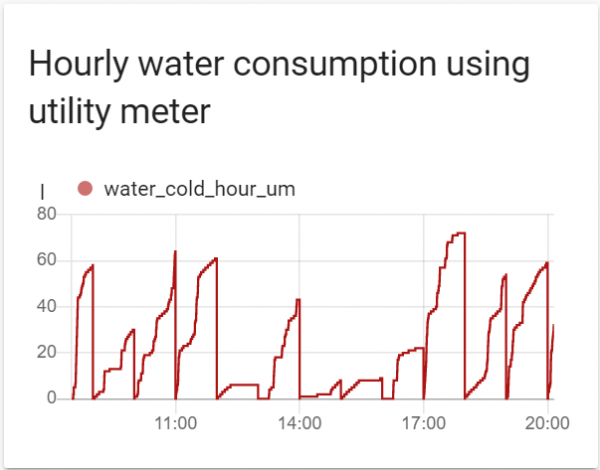
Koden til time- og dagsgraferne til lovelace-UI ser sådan ud:
      - type: history-graph
        title: 'Timeforbrug af vand ved brug af variabler'
        hours_to_show: 48
        entities:
          - sensor.water_hour

      - type: history-graph
        title: 'Dagsforbrug af vand ved brug af variabler'
        hours_to_show: 360
        entities:
          - sensor.water_day
Egentlig ligger problemet med denne tilgang i den algoritme. Som jeg nævnte, genereres der 1 kB optegnelse i databasen for hver indgående værdi (det nuværende måleraflæsning for hver efterfølgende liter). Hver utility meter genererer også en ny værdi, som også gemmes i databasen. Hvis jeg ønsker at samle time-/dag-/uge-/månedlige aflæsninger, ja, for flere vand-rør, og så tilføje en bunke elektricitetsmålere — så vil det blive utrolig mange data. Nærmere bestemt er der ikke meget data, men fordi home assistant skriver en masse unødvendig information til databasen, vil størrelsen på databasen vokse hastigt. Jeg frygter endda at overveje databasen for ugeskemaer og månedlige diagrammer.
Derudover løser utility meter i sig selv ikke det stillede problem. Grafen med værdierne, som utility meter leverer, er en monotont stigende funktion, der nulstilles til 0 hver time. Vi har brug for en brugervenlig graf over forbruget, hvor mange liter der er blevet brugt i perioden. Den standardkomponent, history-graph, kan ikke gøre det, men den eksterne komponent mini-graph-card kan hjælpe os.
Her er koden til kortet til lovelace-UI:
      - aggregate_func: max
        entities:
          - color: var(--primary-color)
            entity: sensor.water_cold_hour_um
        group_by: hour
        hours_to_show: 48
        name: "Timebaseret vandforbrug aggregeret af utility meter"
        points_per_hour: 1
        show:
          graph: bar
        type: 'custom:mini-graph-card'
Udover de standardindstillinger som sensorens navn, grafens type, farve (den standard orange kunne jeg ikke lide), er der tre vigtige indstillinger:
- group_by:hour — grafen vil blive genereret med justering af søjlerne ved timens begyndelse
- points_per_hour: 1 — en søjle for hver time
- Og det vigtigste, aggregate_func: max — tage den maksimale værdi inden for hver time. Netop denne parameter omdanner det såkaldte saggede diagram til søjler
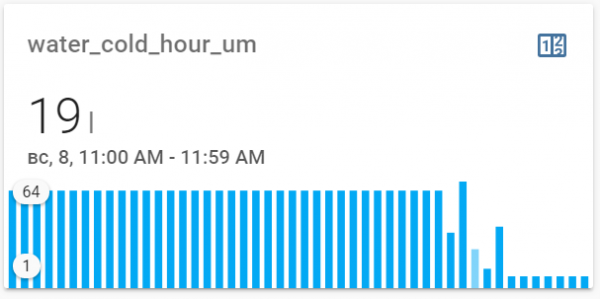
Ignore venstre kolonne af søjler — det er standardadfærden for komponenten, hvis der ikke er data. Og der var heller ikke data — jeg aktiverede først dataindsamlingen fra utility meter for bare et par timer siden kun til denne artikel (jeg vil fortælle om min nuværende tilgang lidt længere nede).
I wanted to show in this picture that sometimes the data display even works, and the bars actually reflect the correct values. However, not all of them. The highlighted bar for the period from 11 to 12 AM displays 19 liters, although the jagged graph slightly above shows a consumption of 62 liters for the same period from the same sensor. It's either a bug or someone's got a little something wrong. I'm still trying to figure out why the data is broken on the right — the consumption was normal, as can also be seen from the jagged graph.
Overall, I couldn’t achieve credibility with this approach — the graph almost always shows some nonsense.
An equivalent code for the daily sensor.
      - aggregate_func: max
        entities:
          - color: var(--primary-color)
            entity: sensor.water_cold_day_um
        group_by: interval
        hours_to_show: 360
        name: "Daily water consumption aggregated by utility meter"
        points_per_hour: 0.0416666666
        show:
          graph: bar
        type: 'custom:mini-graph-card'
Note that the group_by parameter is set to interval, and the points_per_hour parameter controls everything. This leads to another problem with this component — points_per_hour works well on graphs for one hour or less, but poorly on longer intervals. To get one bar for one day, I had to write the value 1/24=0.04166666. I’m not even talking about weekly and monthly graphs.
Approach 2
While still figuring out Home Assistant, I came across this video:
A friend collects consumption data from several types of Xiaomi sockets. His task is a bit simpler — just to display the consumption value for today, yesterday, and for the month. No graphs are required.
Let's put aside discussions about manually integrating instantaneous power values — I've already written about the 'accuracy' of this approach above. It's unclear why he didn’t use the accumulated consumption values that are already being gathered by the same socket. In my opinion, integrating the values inside the device will yield better results.
From the video, we will take the idea of manually calculating consumption for a period. The guy only counts the values for today and yesterday, but we will go further and try to draw a graph. The essence of the proposed method in my case is as follows.
We will create a variable initial_value_at_hour, which will store the current readings of the meter.
Ved timens slut, eller i begyndelsen af den næste, beregner vi forskellen mellem den nuværende aflæsning og den gemte aflæsning fra begyndelsen af timen. Denne forskel vil være forbruget for den aktuelle time — vi gemmer værdien i sensoren, og i fremtiden vil vi bygge et diagram baseret på denne værdi.
Vi skal også "nulstille" variablen værdi_i_begyndelsen_af_timen ved at skrive den nuværende værdi af tælleren ind.
Alt dette kan gøres gennem ... ved hjælp af selve Home Assistant.
Koden vil kræve lidt mere end i den tidligere tilgang. Først skal vi oprette disse "variabler". Der er ikke en "variabel"-enhed som standard, men vi kan bruge en MQTT-broker. Vi sender værdier derhen med flaget retain=true — dette vil gemme værdien i brokeren, og den kan til enhver tid hentes derfra, selv ved genstart af Home Assistant. Jeg lavede både timetællere og dagtællere.
- platform: mqtt
  state_topic: "test/water/hour"
  name: water_hour
  unit_of_measurement: l

- platform: mqtt
  state_topic: "test/water/hour_begin"
  name: water_hour_begin
  unit_of_measurement: l

- platform: mqtt
  state_topic: "test/water/day"
  name: water_day
  unit_of_measurement: l

- platform: mqtt
  state_topic: "test/water/day_begin"
  name: water_day_begin
  unit_of_measurement: l
Al sin magi sker i automatiseringen, som kører hvert time og hver nat.
- id: water_new_hour
  alias: water_new_hour
  initial_state: true
  trigger:
    - platform: time_pattern
      minutes: 0
  action:
    - service: mqtt.publish
      data:
        topic: "test/water/hour"
        payload_template: >
          {{ (states.sensor.water_meter_cold.state|int) - (states.sensor.water_hour_begin.state|int) }}
        retain: true
    - service: mqtt.publish
      data:
        topic: "test/water/hour_begin"
        payload_template: >
          {{ states.sensor.water_meter_cold.state }}
        retain: true

- id: water_new_day
  alias: water_new_day
  initial_state: true
  trigger:
    - platform: time
      at: "00:00:00"
  action:
    - service: mqtt.publish
      data:
        topic: "test/water/day"
        payload_template: >
          {{ (states.sensor.water_meter_cold.state|int) - (states.sensor.water_day_begin.state|int) }}
        retain: true
    - service: mqtt.publish
      data:
        topic: "test/water/day_begin"
        payload_template: >
          {{ states.sensor.water_meter_cold.state }}
        retain: true
Begge automatiseringer udfører 2 handlinger:
- Beregner værdien for intervallet som forskellen mellem start- og slutværdi
- Opdaterer basisværdien til det næste interval
Opbygningen af diagrammer løses i dette tilfælde med et almindeligt history-graph:
      - type: history-graph
        title: 'Timeforbrug af vand ved brug af variabler'
        hours_to_show: 48
        entities:
          - sensor.water_hour

      - type: history-graph
        title: 'Dagsforbrug af vand ved brug af variabler'
        hours_to_show: 360
        entities:
          - sensor.water_day
Sådan ser det ud:
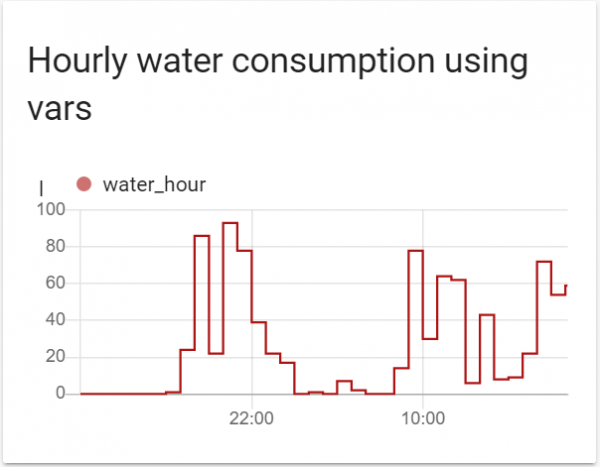
I princippet er det allerede, hvad der er nødvendigt. Fordelen ved denne metode er, at data genereres én gang pr. interval. Det vil sige i alt 24 poster per dag for timegrafen.
Desværre løser det stadig ikke det generelle problem med den voksende database. Hvis jeg ønsker en månedsvis forbrugsgraf, bliver jeg nødt til at gemme data i mindst et år. Og da home assistant kun tilbyder én indstilling for opbevaringsvarighed for hele databasen, betyder det, at ALLE data i systemet skal gemmes i et helt år. For eksempel forbruger jeg 200 kubikmeter vand om året, hvilket betyder 200000 poster i databasen. Og hvis man tager andre sensorer i betragtning, bliver tallet faktisk uhørt højt.
Tilgang 3
Heldigvis har kloge mennesker allerede løst dette problem ved at skrive databasen InfluxDB. Denne database er specielt optimeret til opbevaring af tidsbaserede data og er ideel til at gemme værdier fra forskellige sensorer. Systemet tilbyder også et SQL-lignende forespørgselssprog, som gør det muligt at udtrække værdier fra databasen og aggregere dem på forskellige måder. Endelig kan forskellige data gemmes i forskellige perioder. For eksempel kan ofte skiftende målinger såsom temperatur eller fugtighed opbevares i kun et par uger, mens daglige forbrugsoplysninger kan gemmes i et helt år.
Udover InfluxDB har kloge mennesker også opfundet Grafana - et system til at lave diagrammer baseret på data fra InfluxDB. Grafana kan tegne forskellige typer diagrammer, tilpasse dem i detaljer, og vigtigst af alt, disse diagrammer kan 'indsættes' i lovelace-UI i home assistant.
At lade sig inspirere og . Artiklerne beskriver detaljeret processen for installation og tilslutning af InfluxDB og Grafana til home assistant. Jeg vil dog fokusere på at løse min specifikke opgave.
Så, først og fremmest starter vi med at samle værdien fra tælleren i InfluxDB. Et stykke konfiguration til home assistant (i dette eksempel vil jeg have det sjovt med både koldt og varmt vand):
influxdb:
  host: localhost
  max_retries: 3
  default_measurement: state
  database: homeassistant
  include:
    entities:
      - sensor.water_meter_hot
      - sensor.water_meter_cold
Lad os deaktivere gemmingen af disse samme data i home assistants interne database, for ikke at blæse den op unødigt:
recorder:
  purge_keep_days: 10
  purge_interval: 1
  exclude:
    entities:
      - sensor.water_meter_hot
      - sensor.water_meter_cold
Lad os nu gå til InfluxDB-konsollen og konfigurere vores database. Især skal vi indstille, hvor lang tid de forskellige data skal opbevares. Dette reguleres af såkaldt retention policy - det ligner databaser inden for den primære database, og hver intern database har sine egne indstillinger. Som standard opbevares alle data i retention policy kaldet autogen, og disse data vil blive opbevaret i en uge. Jeg ønsker, at time-data opbevares i en måned, uge-data i et år, og månedlige data slet ikke skal slettes. Lad os oprette de relevante retention policies.
CREATE RETENTION POLICY "month" ON "homeassistant" DURATION 30d REPLICATION 1
CREATE RETENTION POLICY "year" ON "homeassistant" DURATION 52w REPLICATION 1
CREATE RETENTION POLICY "infinite" ON "homeassistant" DURATION INF REPLICATION 1
Nu kommer selve hovedtricket - dataaggregation ved hjælp af en kontinuerlig forespørgsel. Dette er en mekanisme, der automatisk kører en forespørgsel med bestemte intervaller, aggregerer dataene ud fra denne forespørgsel, og gemmer resultatet som en ny værdi. Lad os se på et eksempel (jeg skriver i kolonner for læsbarhed, men i virkeligheden måtte jeg indtaste denne kommando i en enkelt linje).
CREATE CONTINUOUS QUERY cq_water_hourly ON homeassistant
BEGIN
  SELECT max(value) AS value
  INTO homeassistant.month.water_meter_hour
  FROM homeassistant.autogen.l
  GROUP BY time(1h), entity_id fill(previous)
END
Denne kommando:
- Opretter en kontinuerlig forespørgsel med navnet cq_water_cold_hourly i databasen homeassistant.
- Forespørgslen vil blive kørt hver time (time(1h)).
- Forespørgslen vil indhente alle data fra measurement'en homeassistant.autogen.l (liter), inklusive målinger af koldt og varmt vand.
- De aggregerede data vil blive grupperet efter entity_id, hvilket skaber separate værdier for koldt og varmt vand.
- Da liter tælleren er en monoton stigende sekvens, er det nødvendigt at tage den maksimale værdi inden for hver time, så aggregation vil blive udført med funktionen max(value).
- Den nye værdi vil blive skrevet til homeassistant.month.water_meter_hour, hvor month er navnet på retention policy med en opbevaringsperiode på en måned. Dataene for koldt og varmt vand vil således være spredt over separate poster med de respektive entity_id og værdien i feltet value.
Om natten eller når der ikke er nogen hjemme, er der intet vandforbrug, og derfor er der heller ingen nye poster i homeassistant.autogen.l. For at forhindre manglende værdier i de almindelige forespørgsler kan man bruge fill(previous). Dette vil få InfluxDB til at anvende værdien fra den foregående time.
Desværre har den kontinuerlige forespørgsel en særlig egenskab: tricket fill(previous) fungerer ikke, og poster bliver simpelthen ikke oprettet. Faktisk er det et uovervindeligt problem, som . Vi vil tage os af dette problem senere, men lad fill(previous) i den kontinuerlige forespørgsel være — det skader ikke.
Lad os tjekke, hvad vi har fået (selvfølgelig skal vi vente et par timer):
> select * from homeassistant.month.water_meter_hour group by entity_id
...
navn: water_meter_hour
tags: entity_id=water_meter_cold
time                 værdi
----                 -----
...
2020-03-08T01:00:00Z 370511
2020-03-08T02:00:00Z 370513
2020-03-08T05:00:00Z 370527
2020-03-08T06:00:00Z 370605
2020-03-08T07:00:00Z 370635
2020-03-08T08:00:00Z 370699
2020-03-08T09:00:00Z 370761
2020-03-08T10:00:00Z 370767
2020-03-08T11:00:00Z 370810
2020-03-08T12:00:00Z 370818
2020-03-08T13:00:00Z 370827
2020-03-08T14:00:00Z 370849
2020-03-08T15:00:00Z 370921
Bemærk, at værdierne i databasen gemmes i UTC, så derfor adskiller de sig med 3 timer — værdierne for kl. 7 om morgenen i InfluxDB-outputtet svarer til værdierne kl. 10 om morgenen i de ovenstående grafer. Bemærk også, at der ingen poster er mellem kl. 2 og 5 om morgenen — det er den særlige egenskab ved den kontinuerlige forespørgsel.
Som du kan se, er den aggregerede værdi også en monoton stigende sekvens, bare med sjældnere poster — én gang i timen. Men det er ikke et problem — vi kan skrive en anden forespørgsel, der vil hente de korrekte data til grafen.
SELECT difference(max(value))
FROM homeassistant.month.water_meter_hour
WHERE entity_id='water_meter_cold' and time >= now() -24h
GROUP BY time(1h), entity_id
fill(previous)
Lad mig forklare:
- Vi henter data fra homeassistant.month.water_meter_hour for entity_id='water_meter_cold' i løbet af de seneste 24 timer (time >= now() -24h).
- Som jeg allerede har nævnt, kan der mangle nogle poster i rækken homeassistant.month.water_meter_hour. Disse data vil vi generere igen ved at køre forespørgslen med GROUP BY time(1h). Denne gang vil fill(previous) fungere som ønsket og generere de manglende data (funktionen vil tage den forrige værdi).
- Det vigtigste ved denne forespørgsel er funktionen difference, som vil beregne forskellen mellem de timemærker. Den fungerer ikke alene og kræver en aggregerende funktion. Lad os bruge max(), som tidligere.
Resultatet af udførelsen ser således ud:
navn: water_meter_hour
tags: entity_id=water_meter_cold
time                 difference
----                 ----------
...
2020-03-08T02:00:00Z 2
2020-03-08T03:00:00Z 0
2020-03-08T04:00:00Z 0
2020-03-08T05:00:00Z 14
2020-03-08T06:00:00Z 78
2020-03-08T07:00:00Z 30
2020-03-08T08:00:00Z 64
2020-03-08T09:00:00Z 62
2020-03-08T10:00:00Z 6
2020-03-08T11:00:00Z 43
2020-03-08T12:00:00Z 8
2020-03-08T13:00:00Z 9
2020-03-08T14:00:00Z 22
2020-03-08T15:00:00Z 72
Fra kl. 2 til 5 om morgenen (UTC) var der ikke noget forbrug. Alligevel vil forespørgslen returnere den samme værdi for forbruget takket være fill(previous), og funktionen difference trækker dette værdi fra sig selv, hvilket giver 0 i output, som det er meningen.
Nu mangler det kun at bygge grafen. For at gøre dette åbner vi Grafana, åbner et eksisterende (eller opretter et nyt) dashboard, og opretter et nyt panel. Indstillingerne for grafen vil være som følger.
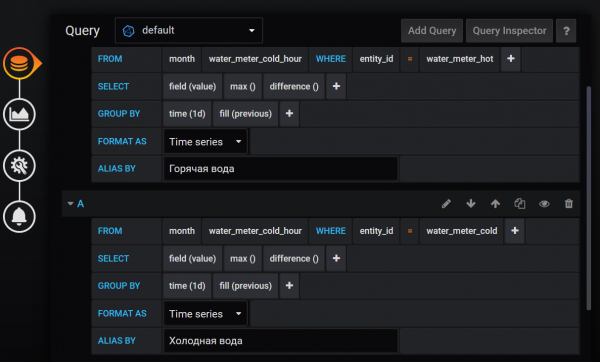
Jeg vil vise data for koldt og varmt vand på én graf. Forespørgslen er præcis den samme som jeg beskrev ovenfor.
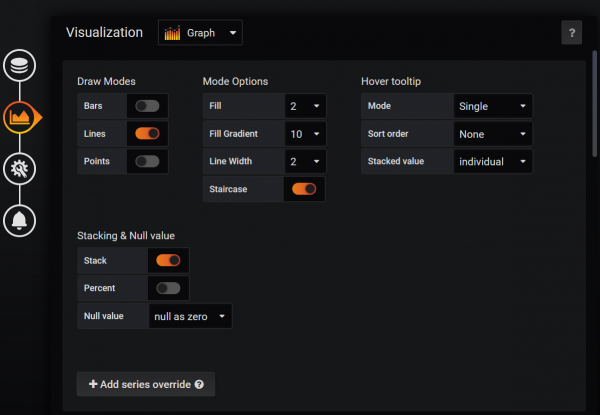
Visningsparametrene angives således. Jeg vil have en linjegraf (lines), som går i trin (stairs). Parameteren Stack vil jeg forklare lidt længere nede. Der er også nogle andre visningsparametre, men de er ikke så interessante.
For at tilføje den opnåede graf til Home Assistant skal du:
- forlade redigeringsmodus for grafen. Af en eller anden grund foreslås de korrekte delingsindstillinger for grafer kun fra dashboard-siden.
- Klik på trekanten ved siden af grafens navn, vælg del i menuen.
- I det åbnede vindue skal du gå til fanen embed.
- Fjern markeringen i current time range — tidsintervallet vil vi angive via URL.
- Vælg det ønskede tema. I mit tilfælde er det lys (light).
- Kopier den resulterende URL ind i lovelace-UI's indstillingskort.
      - type: iframe
        id: graf_water_hourly
        url: "http://192.168.10.200:3000/d-solo/rZARemQWk/water?orgId=1&panelId=2&from=now-2d&to=now&theme=light"
Bemærk, at tidsintervallet (de sidste 2 dage) angives netop her og ikke i dashboardets indstillinger.
Grafen ser sådan ud. Jeg har ikke brugt varmt vand de sidste 2 dage, så der vises kun grafen for koldt vand.
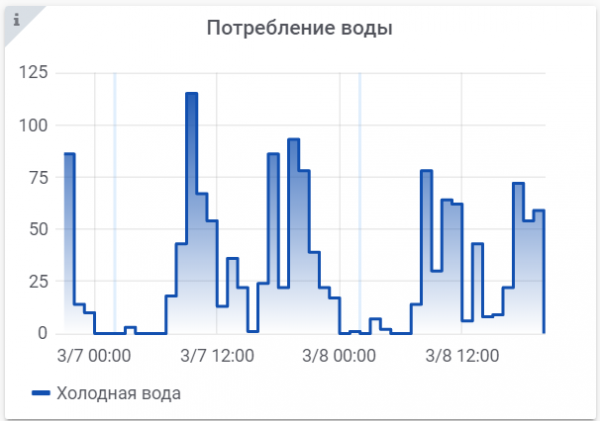
Jeg har faktisk ikke besluttet mig for, hvilken graf jeg bedst kan lide, linje-trin eller rigtige søjler. Derfor vil jeg bare vise et eksempel på en daglig graf for forbrug, men denne gang med søjler. Forespørgslerne opbygges på samme måde som beskrevet ovenfor. Visningsparametrene er:
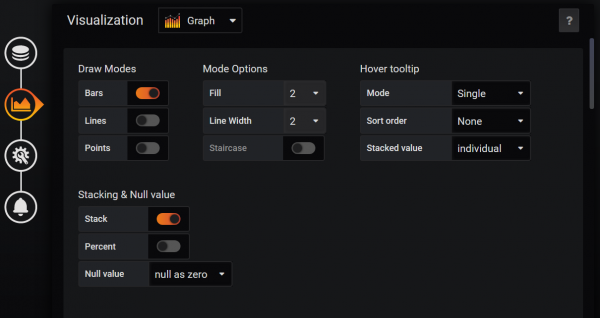
Denne graf ser sådan ud:
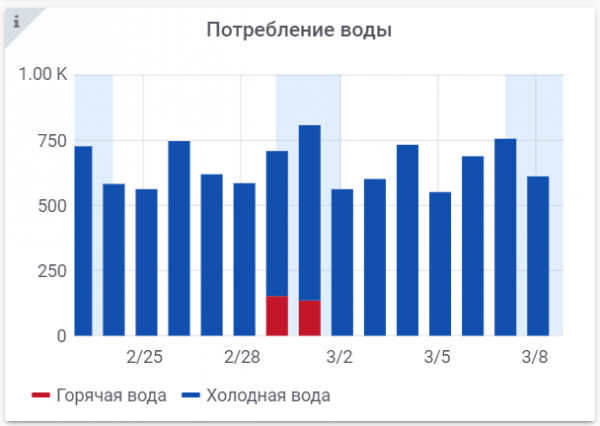
Så om parameteren Stack. I denne graf tegnes søjlen for koldt vand oven på søjlen for varmt vand. Den samlede højde svarer til det samlede forbrug af koldt og varmt vand i perioden.
Alle viste grafer er dynamiske. Du kan føre musen over et interessant punkt for at se detaljer og værdi på det specifikke punkt.
Desværre er der ikke gået en spand tjære forbi. På søjlediagrammet (i modsætning til trin-diagrammet) er midten af søjlen ikke i midten af døgnet, men kl. 00:00. Det vil sige, at den venstre halvdel af søjlen er tegnet på den foregående dags plads. Så diagrammerne for lørdag og søndag er tegnet lidt til venstre for den blå zone. Indtil videre har jeg ikke opfundet en løsning på dette.
Et andet problem er, at det er umuligt at arbejde korrekt med månedlige intervaller. Problemet er, at længden af en time/dag/uge er fast, mens længden af en måned hver gang er forskellig. InfluxDB kan kun arbejde med ensartede intervaller. Indtil videre har jeg haft mine kognitive evner til at angive et fast interval på 30 dage. Ja, diagrammet vil glide en smule over året, og søjlerne vil ikke præcist svare til månederne. Men da jeg blot er interesseret i det som en måler, er jeg okay med det.
Jeg ser mindst to løsninger:
- Ignorer månedlige diagrammer og begræns dig til ugentlige. 52 ugentlige søjler om året ser ret godt ud.
- Beregne det månedlige forbrug som metode nr. 2 og kun bruge Grafana til flotte diagrammer. Det vil blive en ret præcis løsning. Man kan endda overlappe diagrammerne fra sidste år til sammenligning — Grafana kan også det.
Konklusion
Jeg ved ikke hvorfor, men jeg elsker denne slags diagrammer. De viser, at livet koger, og alting ændrer sig. I går var der meget, i dag er der lidt, i morgen bliver det på en eller anden måde anderledes. Der er stadig noget arbejde tilbage med husstanden angående forbruget. Men selv med de nuværende appetitter bliver det blot en stor og uforståelig tal i regningen til en ret forståelig forbrugsoversigt.
På trods af næsten 20 års karriere som programmør har jeg næsten ikke arbejdet med databaser. Derfor virkede installationen af en ekstern database som noget mystisk og uforståeligt. Alt ændrede sig. — det viste sig, at tilslutning af det rigtige værktøj kan gøres med et par klik, og med et specialiseret værktøj bliver opgaven med at bygge diagrammer en smule lettere.
I oversætte jeg nævnte strømforbrug. Desværre kan jeg i øjeblikket ikke fremvise nogen grafer. En SDM120 måler er gået i stykker, og den anden glitcher ved kommunikation via Modbus. Men dette påvirker ikke emnet for denne artikel — graferne vil blive oprettet på samme måde som for vand.
I denne artikel har jeg præsenteret de metoder, jeg selv har afprøvet. Der er sikkert nogle andre måder at organisere indsamling og visualisering af data, som jeg ikke kender til. Fortæl mig gerne om det i kommentarerne, jeg vil være meget interesseret. Jeg ser frem til konstruktiv kritik og nye idéer. Jeg håber, at det præsenterede materiale også kan hjælpe nogen.
Kilde: habr.com
