

Jeg har lagt det ud på Github .
Dette er en simpel hash-tabel til GPU, der kan håndtere hundrede millioner indsættelser pr. sekund. På min bærbare computer med NVIDIA GTX 1060 indsætter koden 64 millioner tilfældigt genererede nøgle-værdi-par på cirka 210 ms og fjerner 32 millioner par på cirka 64 ms.
Det vil sige, at hastigheden på den bærbare computer er cirka 300 millioner indsættelser/s og 500 millioner fjernelser/s.
Tabellen er skrevet i CUDA, selvom den samme metode kan anvendes til HLSL eller GLSL. Implementeringen har flere begrænsninger, som sikrer høj ydeevne på grafikkortet:
- Kun 32-bit nøgler og værdier behandles.
- Hash-tabellen har en fast størrelse.
- Og denne størrelse skal være en potens af to.
For nøglerne og værdierne skal der reserveres en simpel adskillelsessymbol (i den angivne kode er det 0xffffffff).
Hash-tabel uden låse
I hash-tabellen anvendes åben adressering med , hvilket betyder, at det blot er et array af nøgle-værdi-par, der er gemt i hukommelsen og har fremragende cache-ydeevne. Det kan ikke siges om kædning (chaining), der indebærer at søge efter en peger i en kædet liste. Hash-tabellen er et simpelt array, der gemmer elementer. KeyValue:
struct KeyValue
{
    uint32_t key;
    uint32_t value;
};
Størrelsen på tabellen er en potens af to og ikke et primtal, fordi der til anvendelse af pow2/AND-maske kun kræves en hurtig instruktion, mens modulus-operatoren arbejder meget langsommere. Dette er vigtigt ved lineær søgning, da indekset for pladserne skal vikles ind i hver slot. Og i sidste ende tilføjes omkostningerne ved modulus-operationen i hver slot.
Tabellen gemmer kun nøglen og værdien for hvert element, ikke hash-værdien af nøglen. Da tabellen kun gemmer 32-bit nøgler, beregnes hash meget hurtigt. I den angivne kode anvendes Murmur3-hashen, som kun udfører nogle få skift, XOR'er og multiplikationer.
I hash-tabellen anvendes en blokeringsteknik, som ikke afhænger af rækkefølgen af placering i hukommelsen. Selv hvis nogle skriveoperationer bryder rækkefølgen af andre sådanne operationer, vil hash-tabellen stadig bevare en korrekt tilstand. Dette vil vi komme ind på nedenfor. Teknikken fungerer fremragende med grafikkort, hvor tusindvis af tråde kører konkurrencepræget.
Nøgler og værdier i hash-tabellen initialiseres som tomme.
Koden kan modificeres, så den kan håndtere både 64-bit nøgler og værdier. For nøgler kræves atomare operationer for læsning, skrivning og sammenligning med udveksling (compare-and-swap). Og for værdier er atomare operationer for læsning og skrivning nødvendige. Heldigvis er læse-skriv operationer for 32- og 64-bit værdier atomare i CUDA, så længe de er naturligt justerede (se. ), og moderne grafikkort understøtter 64-bit atomare compare-and-swap operationer. Naturligvis vil ydeevnen falde lidt ved overgangen til 64 bit.
Tilstanden af hash-tabellen
Hver nøgle-værdi par i hash-tabellen kan have en af fire tilstande:
- Nøglen og værdien er tomme. I denne tilstand initialiseres hash-tabellen.
- Nøglen er skrevet, men værdien er endnu ikke. Hvis en anden udførelsestråd læser data på dette tidspunkt, vil den derefter returnere en tom værdi. Dette er normalt; det samme ville være sket, hvis en anden udførelsestråd var blevet færdig lidt tidligere, og vi taler om en konkurrencepræget datastruktur.
- Både nøglen og værdien er skrevet.
- Værdien er tilgængelig for andre udførelsestråde, mens nøglen stadig ikke er. Dette kan ske, fordi programmeringsmodellen i CUDA antyder en svagt ordnet hukommelsesmodel. Det er normalt; under alle omstændigheder er nøglen stadig tom, selvom værdien ikke længere er.
Et vigtigt aspekt er, at så snart nøglen er skrevet til en slot, flyttes den ikke længere — selvom nøglen bliver slettet, vil vi tale om det nedenfor.
Koden til hash-tabellen fungerer selv med svagt ordnede hukommelsesmodeller, hvor rækkefølgen af læsninger og skrivninger i hukommelsen ikke er kendt. Når vi gennemgår indsættelse, søgning og sletning i hash-tabellen, skal du huske, at hvert nøgle-værdi par befinder sig i en af de fire ovenfor beskrevne tilstande.
Indsættelse i hash-tabellen
CUDA-funktionen, der indsætter nøgle-værdi-par i hash-tabellen, ser sådan ud:
void gpu_hashtable_insert(KeyValue* hashtable, uint32_t key, uint32_t value)
{
    uint32_t slot = hash(key);

    while (true)
    {
        uint32_t prev = atomicCAS(&hashtable[slot].key, kEmpty, key);
        if (prev == kEmpty || prev == key)
        {
            hashtable[slot].value = value;
            break;
        }
        slot = (slot + 1) & (kHashTableCapacity-1);
    }
}
For at indsætte en nøgle itererer koden over arrayet af hash-tabellen, startende fra hashen af den indsatte nøgle. I hver slot i arrayet udføres en atomar sammenligning og udveksling, hvor nøgle i denne slot sammenlignes med den tomme. Hvis der opdages en uoverensstemmelse, opdateres nøglen i slotten til den indsatte nøgle, og den originale nøgle i slotten returneres. Hvis denne originale nøgle var tom eller svarede til den indsatte nøgle, har koden fundet en passende slot til indsættelse og indfører den indsatte værdi i slotten.
Hvis der er flere elementer med den samme nøgle i et enkelt kernelopkald, kan enhver af deres værdier skrives til slotten for nøglen. Dette betragtes som normalt: en af skriveoperationerne for nøgle-værdi-parret under opkaldet vil være succesfuld, men da dette sker parallelt i flere eksekveringstråde, kan vi ikke forudsige, hvilken skriveoperation i hukommelsen der vil være den sidste. gpu_hashtable_insert() Søgning i hash-tabellen
Koden til at finde nøgler:
uint32_t gpu_hashtable_lookup(KeyValue* hashtable, uint32_t key) { uint32_t slot = hash(key);while (true) { if (hashtable[slot].key == key) { return hashtable[slot].value; } if (hashtable[slot].key == kEmpty) { return kEmpty; } slot = (slot + 1) & (kHashTableCapacity - 1); } }
For at finde værdien af en nøgle, der er gemt i tabellen, itererer vi over arrayet, startende fra hashen af den ønskede nøgle. I hver slot kontrollerer vi, om nøglen er den, vi leder efter, og hvis ja, returnerer vi dens værdi. Vi kontrollerer også, om nøglen er tom, og hvis ja, stopper vi søgningen.
Hvis vi ikke lykkes med at finde nøglen, returnerer koden en tom værdi.
Alle disse søgeoperationer kan udføres parallelt under indsættelser og sletninger. Hver par i tabellen vil have en af de fire ovenfor beskrevne tilstande for tråden.
Sletning i hash-tabellen
Koden til at slette nøgler:
Kode til fjernelse af nøgler:
void gpu_hashtable_delete(KeyValue* hashtable, uint32_t key, uint32_t value)
{
    uint32_t slot = hash(key);

    while (true)
    {
        if (hashtable[slot].key == key)
        {
            hashtable[slot].value = kEmpty;
            return;
        }
        if (hashtable[slot].key == kEmpty)
        {
            return;
        }
        slot = (slot + 1) & (kHashTableCapacity - 1);
    }
}
Sletning af en nøgle udføres usædvanligt: vi lader nøglen være i tabellen og markerer dens værdi (ikke selve nøglen) som tom. Denne kode ligner meget lookup(), bortset fra at den, når der findes et match on nøgle, gør dens værdi tom.
Som nævnt ovenfor, så snart nøglen er skrevet til en slot, flyttes den ikke. Selv ved sletning af et element fra tabellen forbliver nøglen på sin plads, blot bliver dens værdi tom. Det betyder, at vi ikke behøver at bruge en atomar operation til at skrive værdien af slotten, fordi det ikke er vigtigt, om den nuværende værdi er tom eller ej — den bliver alligevel tom.
Ændring af størrelsen på hash-tabellen
Størrelsen på hash-tabellen kan ændres ved at oprette en større tabel og indsætte de ikke-tomme elementer fra den gamle tabel i den. Jeg har ikke implementeret denne funktionalitet, fordi jeg ønskede at holde koden simpel. Desuden udføres hukommelsesallokering ofte i værtkoden, ikke i CUDA-kernen.
I artiklen beskriver, hvordan man ændrer en sådan datamodel, der er beskyttet mod blokering.
Konkurrence
I de ovenfor nævnte kodefragmenter håndterer funktionerne gpu_hashtable_insert(), _lookup() og _delete() én nøgle-værdi par ad gangen. Og nedenfor gpu_hashtable_insert(), _lookup() og _delete() behandler et array af par parallelt, hver par i en separat GPU-executionstrøm:
// CPU code to invoke the CUDA kernel on the GPU
uint32_t threadblocksize = 1024;
uint32_t gridsize = (numkvs + threadblocksize - 1) / threadblocksize;
gpu_hashtable_insert_kernel<<<gridsize, threadblocksize>>>(hashtable, kvs, numkvs);

// GPU code to process numkvs key/values in parallel
void gpu_hashtable_insert_kernel(KeyValue* hashtable, const KeyValue* kvs, unsigned int numkvs)
{
    unsigned int threadid = blockIdx.x*blockDim.x + threadIdx.x;
    if (threadid < numkvs)
    {
        gpu_hashtable_insert(hashtable, kvs[threadid].key, kvs[threadid].value);
    }
}
Hash-tabellen med blokering-modstand understøtter samtidige indsættelser, søgninger og sletninger. Da nøgle-værdi par altid er i en af fire tilstande, og nøglerne ikke flyttes, sikrer tabellen korrekthed, selv under samtidig brug af forskellige operationer.
Men hvis vi samtidig behandler en batch af indsættelser og sletninger, og hvis der findes duplikerede nøgler i det indgående array af par, så vil vi ikke kunne forudsige, hvilke par der "vinder" — vil blive skrevet til hash-tabellen sidst. Antag, at vi kaldte indsætningskoden med et indgående array af par A/0 B/1 A/2 C/3 A/4. Når koden er færdig, vil parene B/1 og C/3 garanteret være til stede i tabellen, men der vil også være et vilkårligt af parene A/0, A/2 eller A/4Dette kan være et problem, eller ikke, afhængigt af brugen. Du kan på forhånd vide, at der ikke er nogen dublerede nøgler i det indgående array, eller det kan være ligegyldigt, hvilket værdi der sidst blev skrevet.
Hvis det er et problem for dig, skal du adskille de dublerede par i forskellige systemiske CUDA-kald. I CUDA afsluttes enhver operation med kernel-opkald altid før det næste kernel-opkald (i det mindste inden for én tråd. I forskellige tråde kører kernerne parallelt). Hvis man i det ovenfor nævnte eksempel kalder én kerne med A/0 B/1 A/2 C/3, og en anden med A/4, så vil nøgle A få værdien 4.
Lad os nu tale om, hvorvidt funktioner lookup() og delete() skal bruge en simpel (plain) eller variabel (volatile) pekere til arrayet af par i hash-tabellen. angiver, at:
Kompatilatoren kan efter eget skøn optimere læse- og skriveoperationer til global eller delt hukommelse ... Disse optimeringer kan deaktiveres ved hjælp af nøgleordet
volatile: ... enhver reference til denne variabel kompileres til en reel hukommelseslæse- eller skriveinstruktion.
Korrekthedsovervejelser kræver ikke anvendelse volatile. Hvis udførelsestråden bruger en cached værdi fra en tidligere læseoperation, betyder det, at den vil bruge lidt gammelt information. Men stadig er det information fra en korrekt tilstand af hash-tabellen på et bestemt tidspunkt ved kernel-opkaldet. Hvis du har brug for at bruge den nyeste information, kan du bruge en pointer volatile, men det vil lidt sænke præstationen: ifølge mine tests faldt hastigheden ved sletning af 32 mio. elementer fra 500 mio. deletioner/sek til 450 mio. deletioner/sek.
Ydeevne
I testen med indsættelse af 64 mio. elementer og sletning af 32 mio. af dem, var konkurrencen mellem std::unordered_map og hash-tabellen til GPU faktisk ikke eksisterende:
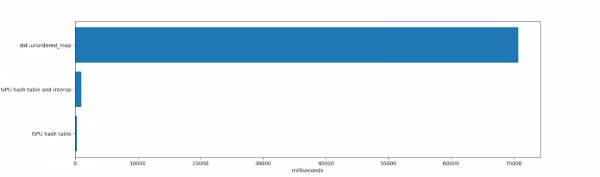
std::unordered_map det tog 70.691 ms at indsætte og slette elementer med efterfølgende frigivelse af unordered_map (frigørelse af millioner af elementer tager tid, fordi der udføres mange hukommelsestildelinger indeni). Ærligt talt, med unordered_map std:unordered_map std:unordered_map helt andre begrænsninger. Dette er en enkelt CPU-kørselstråd, der understøtter nøgle-værdi-par af enhver størrelse, fungerer godt ved høje anvendelsesgrader og viser stabil ydeevne efter mange sletninger.
Varigheden af hash-tabellen for GPU og interprogram kommunikation var 984 ms. Dette inkluderer tiden brugt på at placere tabellen i hukommelsen og dens sletning (engang tildeling af 1 GB hukommelse, som tager tid i CUDA), indsættelse og sletning af elementer samt iteration over dem. Alle kopier til og fra GPU-hukommelsen er også taget i betragtning.
Hash-tabelens egen drift tog 271 ms. Dette inkluderer tiden, GPU'en brugte til indsættelse og sletning af elementer, og inkluderer ikke tiden til at kopiere til hukommelsen eller iterere over den resulterende tabel. Hvis GPU-tabellen lever længe, eller hvis hash-tabellen holdes helt i GPU-hukommelsen (for eksempel til at skabe en hash-tabel, der vil blive brugt af anden GPU-kode, ikke CPU'en), er testresultatet relevant.
Hash-tabellen til grafikkortet viser høj ydeevne takket være den store båndbredde og aktiv parallellisering.
Ulemper
Hash-tabelarkitekturen har flere problemer, som man skal være opmærksom på:
- Klyngeproblemer påvirker lineær sondering, hvilket gør, at nøgler i tabellen ikke placeres optimalt.
- Nøgler slettes ikke ved hjælp af funktionen
sletog med tiden overfylder de tabellen.
Som et resultat kan ydeevnen for hash-tabellen gradvist falde, især hvis den eksisterer i lang tid og har mange indsættelser og sletninger. En måde at afhjælpe disse ulemper på er at rehash til en ny tabel med et tilstrækkeligt lavt udnyttelsesforhold og filtrere de slettede nøgler under rehashing.
For at illustrere de beskrevne problemer bruger jeg ovenstående kode til at oprette en tabel med 128 millioner elementer; jeg vil cyklisk indsætte 4 millioner elementer, indtil jeg fylder 124 millioner slots (udnyttelsesforhold omkring 0,96). Her er tabelresultaterne, hver række er et CUDA-kald med indsættelse af 4 millioner nye elementer i en hash-tabel:
Udnyttelsesforhold
Varigheden af indsatser på 4 194 304 elementer
0,00
11,608448 ms (361,314798 mio. nøgler/sek.)
0,03
11,751424 ms (356,918799 mio. nøgler/sek.)
0,06
11,942592 ms (351,205515 mio. nøgler/sek.)
0,09
12,081120 ms (347,178429 mio. nøgler/sek.)
0,12
12,242560 ms (342,600233 mio. nøgler/sek.)
0,16
12,396448 ms (338,347235 mio. nøgler/sek.)
0,19
12,533024 ms (334,660176 mio. nøgler/sek.)
0,22
12,703328 ms (330,173626 mio. nøgler/sek.)
0,25
12,884512 ms (325,530693 mio. nøgler/sek.)
0,28
13,033472 ms (321,810182 mio. nøgler/sek.)
0,31
13,239296 ms (316,807174 mio. nøgler/sek.)
0,34
13,392448 ms (313,184256 mio. nøgler/sek.)
0,37
13,624000 ms (307,861434 mio. nøgler/sek.)
0,41
13,875520 ms (302,280855 mio. nøgler/sek.)
0,44
14,126528 ms (296,909756 mio. nøgler/sek.)
0,47
14,399328 ms (291,284699 mio. nøgler/sek.)
0,50
14,690304 ms (285,515123 mio. nøgler/sek.)
0,53
15,039136 ms (278,892623 mio. nøgler/sek.)
0,56
15,478656 ms (270,973402 mio. nøgler/sek.)
0,59
15,985664 ms (262,379092 mio. nøgler/sek.)
0,62
16,668673 ms (251,627968 mio. nøgler/sek.)
0,66
17,587200 ms (238,486174 mio. nøgler/sek.)
0,69
18,690048 ms (224,413765 mio. nøgler/sek.)
0,72
20,278816 ms (206,831789 mio. nøgler/sek.)
0,75
22,545408 ms (186,038058 mio. nøgler/sek.)
0,78
26,053312 ms (160,989275 mio. nøgler/sek.)
0,81
31,895008 ms (131,503463 mio. nøgler/sek.)
0,84
42,103294 ms (99,619378 mio. nøgler/sek.)
0,87
61,849056 ms (67,815164 mio. nøgler/sek.)
0,90
105,695999 ms (39,682713 mio. nøgler/sek.)
0,94
240,204636 ms (17,461378 mio. nøgler/sek.)
Som udnyttelsesgraden stiger, falder ydelsen. Dette er uønsket i de fleste tilfælde. Hvis applikationen indsætter elementer i tabellen og derefter kasserer dem (for eksempel ved at tælle ord i en bog), er det ikke et problem. Men hvis applikationen bruger en langlivede hash-tabel (for eksempel i en billedredigerer til at gemme ikke-tomme dele af billeder, når brugeren ofte indsætter og sletter information), kan denne adfærd være besværlig.
Jeg målte dybden af probing af hash-tabellen efter 64 millioner indsatser (udnyttelsesgrad 0,5). Den gennemsnitlige dybde var 0,4774, så de fleste nøgler befandt sig enten i den bedste mulige slot eller i en slot fra den bedste position. Den maksimale dybde af probing var 60.
Derefter målte jeg dybden af probing i tabellen med 124 millioner indsatser (udnyttelsesgrad 0,97). Den gennemsnitlige dybde var allerede 10,1757, og den maksimale — 6474 (!!). Ydelsen ved lineær probing falder kraftigt ved høje udnyttelsesgrader.
Det er bedst at holde en lav udnyttelsesgrad i denne hash-tabel. Men det øger så ydeevnen på bekostning af hukommelsesforbruget. Heldigvis kan dette være berettiget i tilfælde med 32-bit nøgler og værdier. Hvis vi i eksemplet ovenfor opretholder en udnyttelsesgrad på 0,25 for en tabel med 128 millioner elementer, kan vi kun have 32 millioner elementer i den, mens resten af de 96 millioner pladser går tabt – 8 byte per par, 768 MB tabt hukommelse.
Bemærk, at dette handler om tab af GPU-hukommelse, som er en mere værdifuld ressource end systemhukommelse. Selvom de fleste moderne desktop-GPU'er, der understøtter CUDA, har mindst 4 GB hukommelse (da denne artikel blev skrevet, havde NVIDIA 2080 Ti 11 GB), vil det stadig ikke være det smartest valg at miste så store mængder.
Senere vil jeg gå mere i dybden med at oprette hash-tabeller til GPU'er, der ikke har problemer med søgdyp, samt metoder til at genbruge slettede pladser.
Søgdyp måling
For at bestemme dybden af nøglesøgning kan vi trække nøglehashen (dens ideelle indeks i tabellen) fra dens faktiske tabelindeks:
// get_key_index() -> index of key in hash table
uint32_t probelength = (get_key_index(key) - hash(key)) & (hashtablecapacity-1);
På grund af magien ved to binære tal i to’s komplement og det faktum, at kapaciteten af hash-tabellen er en kraft af to, vil denne tilgang også fungere, når nøgleindekset overføres til begyndelsen af tabellen. Lad os tage en nøgle, der hashes til 1, men indsættes i slot 3. Så for en tabel med en kapacitet på 4 får vi (3 - 1) & 3, hvilket svarer til 2.
Konklusion
Hvis du har spørgsmål eller kommentarer, kan du skrive til mig på eller åbne et nyt emne i.
Denne kode er skrevet under inspiration fra de vidunderlige artikler:
I fremtiden vil jeg fortsætte med at skrive om implementeringer af hash-tabeller til GPU'er og analysere deres ydeevne. Jeg planlægger at undersøge kædning, Robin Hood hashing og cuckoo hashing ved brug af atomare operationer i datastrukturer, der er velegnede til GPU'er.
Kilde: habr.com
