

Analyse-databasen ClickHouse håndterer mange forskellige strenge, hvilket forbruger ressourcer. For at forbedre systemets ydeevne tilføjes der konstant nye optimeringer. Udvikleren af ClickHouse, Nikolaj Kočetov, fortæller om datatypen for strenge, herunder den nye type, LowCardinality, og forklarer, hvordan man kan forbedre arbejdet med strenge.
— Lad os først finde ud af, hvordan man kan gemme strenge.
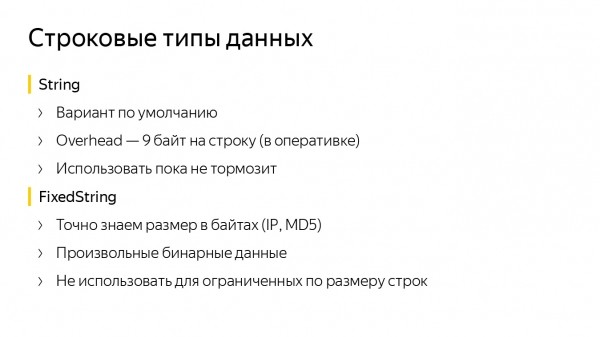
Vi har strenge datatyper. String er godt egnet som standard, og det bør næsten altid anvendes. Det har en lille overhead — 9 byte pr. streng. Hvis vi ønsker, at strængernes størrelse skal være fast og kendt på forhånd, er det bedre at bruge FixedString. I det kan vi angive det ønskede antal byte, det er praktisk til data som IP-adresser eller hash-funktioner.
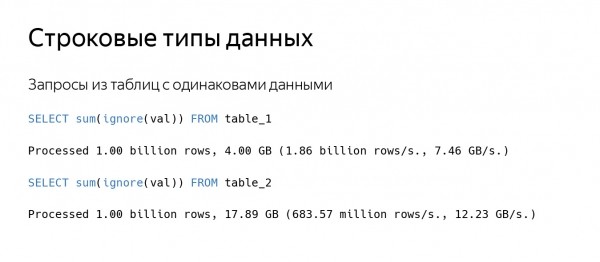
Selvfølgelig kan der nogle gange være flaskehalse. Antag, at du laver en forespørgsel til en tabel. ClickHouse læser et ret stort antal data, lad os sige med en hastighed på 100 GB/s, mens strenge behandles i små mængder. Vi har to tabeller, der opbevarer næsten de samme data. Fra den anden tabel læser ClickHouse data hurtigere, men der læses tre gange færre strenge pr. sekund.
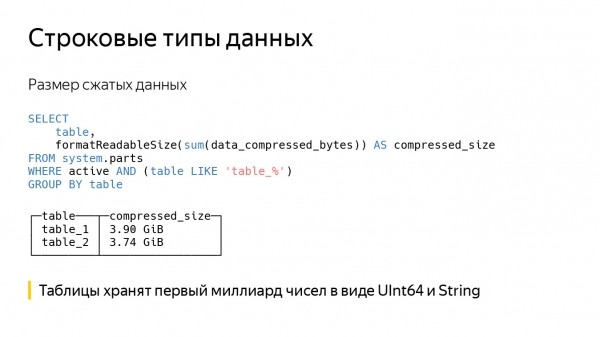
Hvis vi ser på størrelsen af de komprimerede data, vil den være næsten ens. Faktisk er det de samme data, der er optaget i tabellerne — den første milliard tal — forskellen er blot, at de første kolonne lagrer dem som UInt64, mens de anden kolonne lagrer dem som String. På grund af dette tager den anden forespørgsel længere tid at læse data fra disken og dekomprimere dem.
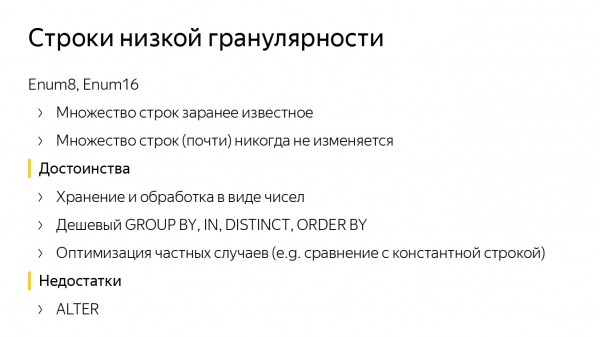
Her er et andet eksempel. Lad os antage, at der er et forudbestemt sæt af strenge, der er begrænset til en konstant på 1000 eller 10.000 og stort set aldrig ændres. I dette tilfælde passer datatypen Enum, i ClickHouse er der to — Enum8 og Enum16. Ved at gemme i Enum håndterer vi forespørgsler hurtigt.
I ClickHouse er der hastighedsforøgelser til GROUP BY, IN, DISTINCT og optimeringer til visse funktioner, for eksempel til sammenligning med en konstant streng. Selvfølgelig konverteres tal i strengen ikke, men snarere konverteres den konstante streng til en Enum-værdi. Derefter sammenlignes alt hurtigt.
Men der er også ulemper. Selv hvis vi kender det præcise sæt af strenge, skal det nogle gange opdateres. En ny streng er blevet tilføjet — vi skal foretage en ALTER.
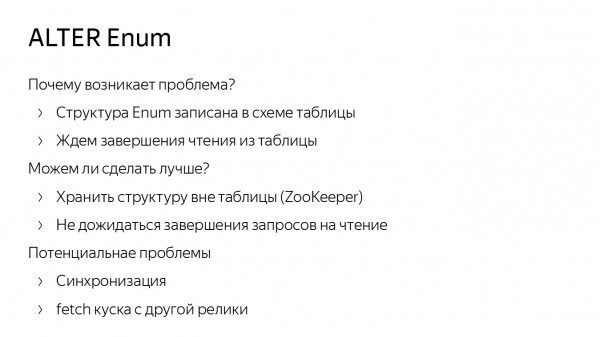
ALTER for Enum in ClickHouse is implemented optimally. We don’t rewrite data on disk, but ALTER might lag due to Enum structures being stored in the table schema. Therefore, we have to wait for read requests from the table, for example.
The question arises: can it be done better? Probably, yes. The Enum structure could be stored not in the table schema but in ZooKeeper. However, synchronization issues may arise. For example, one replica received the data while another did not, and if it has an old Enum, something might break. (In ClickHouse, we are almost finished with non-blocking ALTER requests. Once they are completely finished, we won’t need to wait for read requests.)
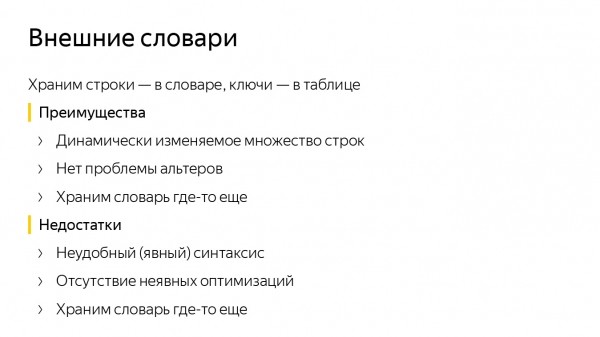
To avoid dealing with ALTER Enum, one can use external dictionaries in ClickHouse. Just to remind you, this is a key-value data structure within ClickHouse that allows you to retrieve data from external sources, such as MySQL tables.
In the ClickHouse dictionary, we store many different strings, while in the table, we store their identifiers as numbers. If you need to get a string, we call the dictGet function and work with it. After that, we don’t have to perform an ALTER. To add something to the Enum, we insert it into the same MySQL table.
However, other issues arise here. First, the syntax is inconvenient. If we want to retrieve a string, we must call dictGet. Second, some optimizations are lacking. A comparison with a constant string for dictionaries is not as fast.
There may also be issues with updating. Suppose we requested a string in the cache dictionary, but it didn’t make it to the cache. Then we have to wait for data to load from the external source.
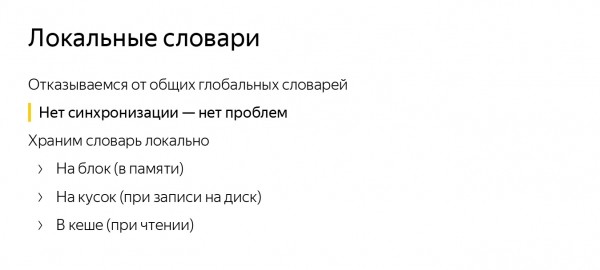
A general drawback of both methods is that we store all keys in one place and synchronize them. So why not store dictionaries locally? No synchronization means no problems. A dictionary can be stored locally on a disk chunk. This means we performed an Insert and recorded the dictionary. If we are working with data in memory, we can write the dictionary either in a data block, in a column chunk, or in some cache to speed up computations.
Dictionary encoding of strings
Thus, we arrived at creating a new data type in ClickHouse — LowCardinality. This is a data storage format: how they are written to disk and read, how they are represented in memory, and the schema of their processing.
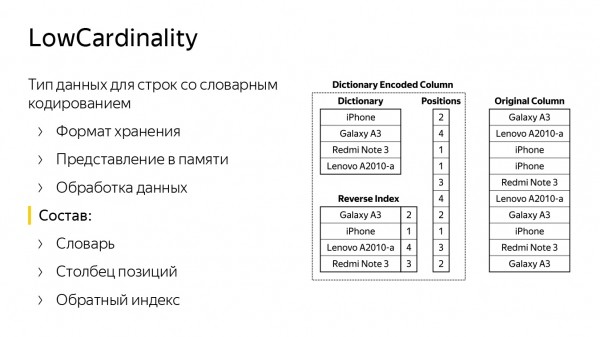
På diaset er der to kolonner. Til højre er rækkerne gemt standardmæssigt i typen String. Det er tydeligt, at dette er nogle modeller af mobiltelefoner. Til venstre er der en lignende kolonne, men i typen LowCardinality. Den består af et ordbog med mange forskellige strenge (strengene fra kolonnen til højre) og en liste af positioner (række numre).
Med disse to strukturer kan vi genskabe den oprindelige kolonne. Der er også en omvendt indeks — en hash-tabel, som hjælper med at finde positionen i ordbogen baseret på en streng. Den er nødvendig for at fremskynde visse forespørgsler. For eksempel, hvis vi ønsker at sammenligne, søge efter en streng i vores kolonne eller fusionere dem.
LowCardinality er en parameteriseret datatype. Den kan være enten et tal, eller noget, der gemmes som et tal, eller en streng, eller Nullable af dem.
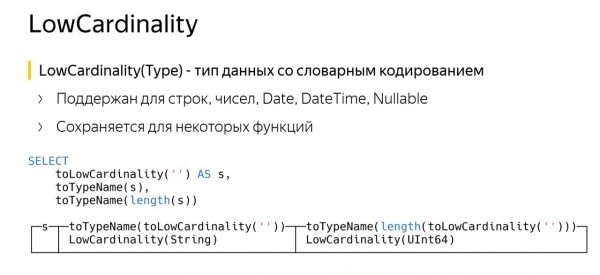
Særligheden ved LowCardinality er, at den kan gemmes til visse funktioner. På diaset ses et eksempel på en forespørgsel. I den første linje har jeg oprettet en kolonne af typen LowCardinality fra String, og kaldte den S. Derefter spurgte jeg om dens navn — ClickHouse sagde, at det er LowCardinality fra String. Alt korrekt.
Den tredje linje er næsten den samme, blot har vi kaldt funktionen length. I ClickHouse returnerer funktionen length datatypen UInt64. Men vi endte med LowCardinality fra UInt64. Hvad er meningen?
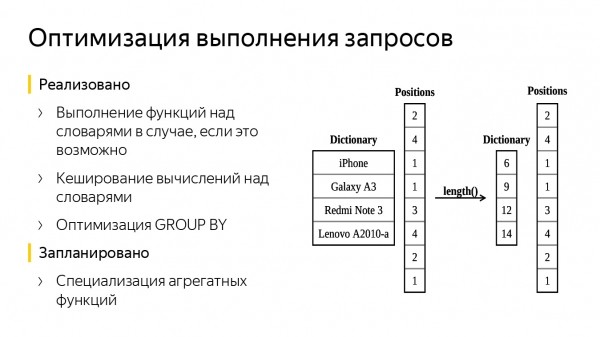
I ordbogen blev navne på mobiltelefoner gemt, vi anvendte funktionen length. Nu har vi en tilsvarende ordbog, der kun består af tal — det er længderne af strengene. Kolonnen med positioner er ikke ændret. I sidste ende behandlede vi færre data, og sparede tid på forespørgslen.
Der kan være andre optimeringer, for eksempel tilføjelse af en simpel cache. Ved beregning af funktionsværdien kan man huske den og lave en tilsvarende, uden at beregne den igen.
Der kan også laves en optimering til GROUP BY, fordi vores kolonne med ordbogen allerede er delvist aggregeret — det muligt hurtigere at beregne værdierne af hashfunktioner og omtrent finde den bucket, hvor man kan placere den næste række. Derudover kan man specialisere visse aggregatfunktioner, for eksempel uniq, da den kun kan modtage ordbogen, mens positionerne forbliver urørte — så vil alt fungere hurtigere. De første to optimeringer er allerede tilføjet i ClickHouse.
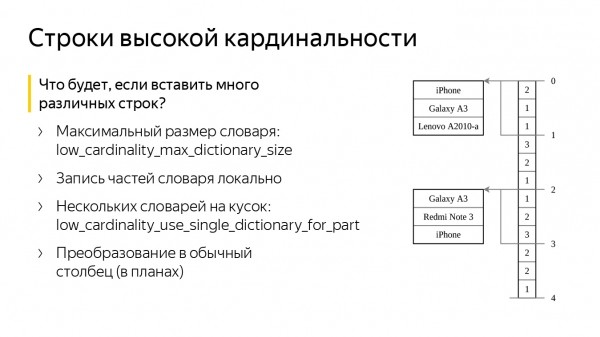
Hvad hvis vi opretter en kolonne med vores datatype og indsætter mange dårlige, forskellige strenge? Vil vores hukommelse ikke blive overfyldt? Nej, der er to specielle indstillinger i ClickHouse til dette. Den første er low_cardinality_max_dictionary_size. Det er den maksimale størrelse af ordbogen, der kan skrives til disk. Indsættelsen foregår på følgende måde: når vi indsætter data, modtager vi en strøm af strenge, og fra dem danner vi en stor samlet ordbog. Hvis ordbogen bliver større end værdien af indstillingen, skriver vi den nuværende ordbog til disk, og de øvrige strenge opbevares et sted 'ved siden af', tættere på indeksene. Resultatet er, at vi aldrig vil genberegne den store ordbog og får ikke hukommelsesproblemer.
Den anden indstilling hedder low_cardinality_use_single_dictionary_for_part. Forestil dig, at i det tidligere skema, når vi indsatte data, blev vores ordbog overfyldt, og vi skrev den til disk. Spørgsmålet opstår, hvorfor ikke danne endnu en præcis samme ordbog?
Når den er overfyldt, vil vi igen skrive den til disk og begynde at danne den tredje. Denne indstilling deaktiverer faktisk denne mulighed som standard.
Mange ordbøger kan faktisk være nyttige, hvis vi ønsker at indsætte et vis antal strenge, men tilfældigt indsatte 'skrald'. Lad os sige, at vi først indsatte dårlige strenge, og derefter indsatte gode. Så ville ordbogen blive delt op i mange små ordbøger. Nogle af dem vil have 'skrald', men de sidste vil have gode strenge. Og hvis vi læser, lad os sige, kun den seneste granule, vil alt stadig fungere hurtigt.
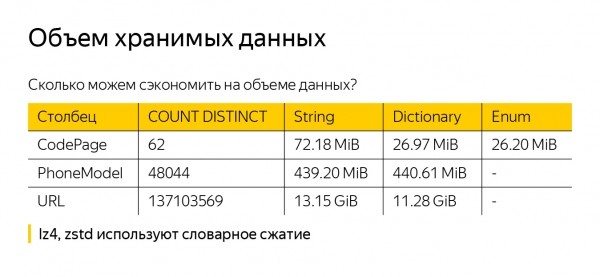
Før vi taler om fordelene ved LowCardinality, vil jeg straks sige, at vi næppe vil opnå en reduktion af dataene på disken (selv om det kan ske), fordi ClickHouse komprimerer dataene. Der er en standardmulighed - LZ4. Derudover kan man komprimere med ZSTD. Men begge algoritmer implementerer allerede ordbogscompression, så vores eksterne ordbog i ClickHouse vil ikke være særlig nyttig.
For the sake of argument, I took some data from the metrics — String, LowCardinality(String), and Enum — and saved them in different data types. This resulted in three columns containing one billion rows. In the first column, CodePage, there are only 62 values. It is clear that LowCardinality(String) has compressed them better. String is slightly worse, but this is likely due to the short strings we hold their lengths, which take up a lot of space and are poorly compressed.
If we take PhoneModel, there are 48,000 — already more, and the differences between String and LowCardinality(String) are almost negligible. For the URL, we also saved just 2 GB — I don’t think we should rely on this.
Performance Speed Assessment
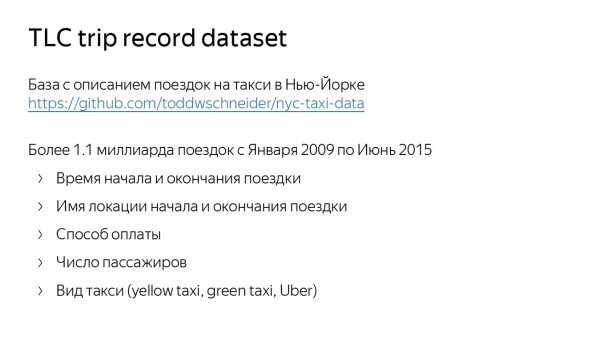
Now let's assess the performance speed. To evaluate this, I used a dataset describing taxi rides in New York. It is on GitHub. It contains just over one billion rides. It reflects location, start and end time of the ride, payment method, number of passengers, and even the type of taxi — green, yellow, and Uber.
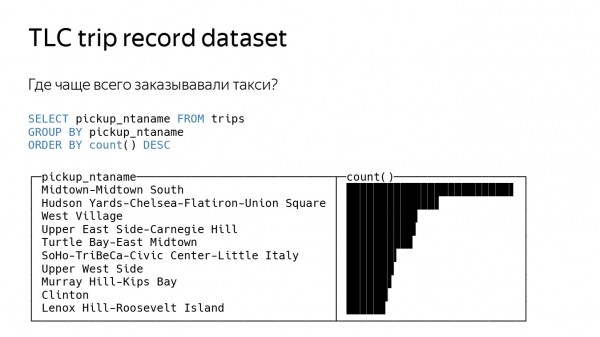
I made the first query quite simple — I asked where taxis are most frequently ordered from. To do this, we need to take the location from where the orders were placed, group it by that, and calculate the count function. Here’s what ClickHouse returns.
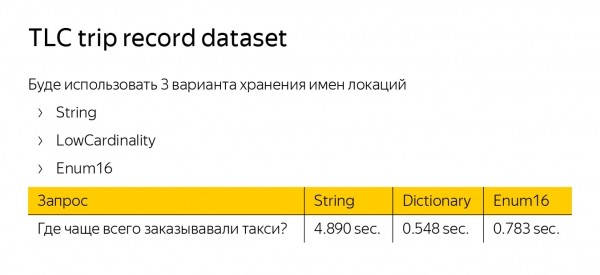
To measure the query processing speed, I created three tables with the same data, but used three different data types for our starting location — String, LowCardinality, and Enum. LowCardinality and Enum turned out to be five times faster than String. Enum is faster because it works with numbers. LowCardinality is faster due to its GROUP BY optimization.
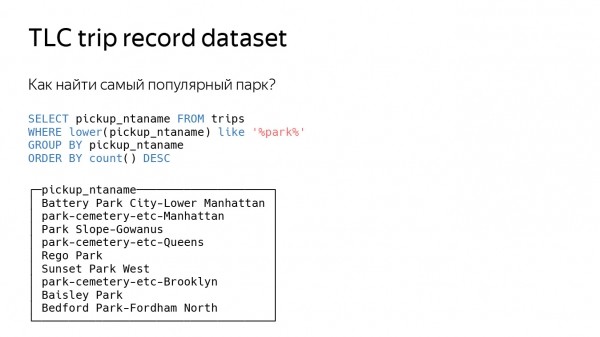
Let’s complicate the query further — let’s ask where the most popular park in New York is located. Again, we will measure this based on where taxis are most frequently ordered, but we will filter only those locations that contain the word 'park'. We will also add the like function.
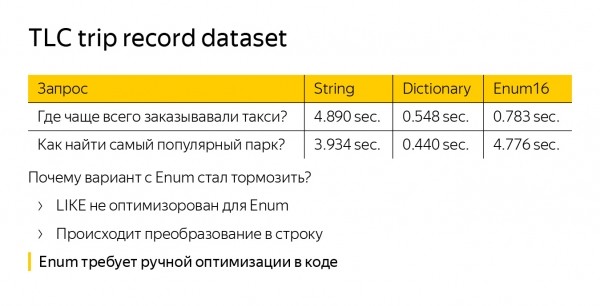
Looking at the time, we see that Enum suddenly started to slow down. In fact, it works even slower than the standard String data type. This is because the like function is not optimized for Enum at all. We have to convert our strings from Enum to regular strings — we are doing more work. LowCardinality(String) is also not optimized by default, but there, like operates on a dictionary, so the query is accelerated compared to String.
Når man arbejder med Enum er der et mere globalt problem. Hvis vi ønsker at optimere det, skal vi gøre det i hver eneste del af koden. Lad os antage, at vi har skrevet en ny funktion — man skal nødvendigvis finde en optimering for Enum. Men i LowCardinality er alt optimeret som standard.
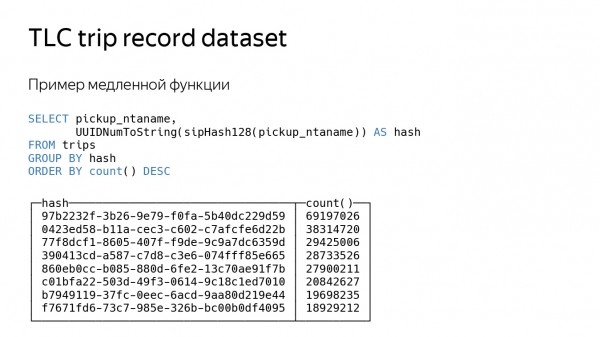
Lad os se på den seneste forespørgsel, som er mere kunstig. Vi vil blot beregne hash-funktionen for vores placering. Hash-funktionen er en ret langsom forespørgsel, da den tager tid, så alt vil blive tre gange langsommere.
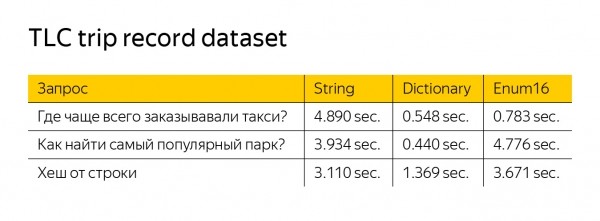
LowCardinality arbejder stadig hurtigere, selvom der ikke er filtrering. Dette skyldes, at vores funktioner kun arbejder over ordlisten. Hash-beregningsfunktionen har et argument — den kan behandle færre data og kan også returnere LowCardinality.
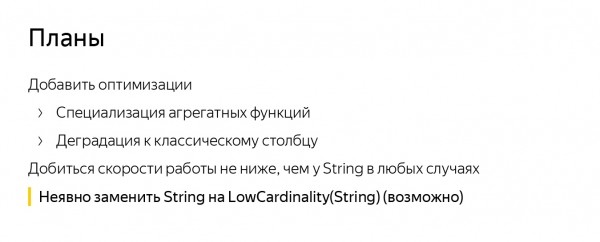
Vores globale plan er at opnå en driftshastighed, der ikke er lavere end String i alle tilfælde og bevare hastigheden. Og måske vil vi en dag erstatte String med LowCardinality, du opdaterer ClickHouse, og alt vil fungere lidt hurtigere.
Kilde: habr.com
