

Kanariefuglen er en lille fugl, der konstant synger. Disse fugle er følsomme over for metan og kulilte. Selv ved lave koncentrationer af skadelige gasser i luften mister de bevidstheden eller dør. Guldgravere og minearbejdere tog fuglene med i minerne: så længe kanariefuglene synger, kan man arbejde; hvis de holder op, er der gas i minen, og man skal forlade den. Minearbejderne ofrede de små fugle for at komme ud af minerne i live.
En lignende praksis findes også inden for IT. For eksempel i den standardopgave, der indebærer deployment af en ny version af en service eller applikation til produktion, med test forud for dette. Testmiljøet kan være for dyrt, automatiserede tests dækker ikke alt, hvad man kunne ønske, og at undlade at teste og ofre kvaliteten er risikabelt. I sådanne tilfælde hjælper tilgangen Canary Deployment, hvor en smule ægte produktionstrafik ledes til den nye version. Denne tilgang hjælper sikkert at teste den nye version i produktion, ved at ofre lidt for en stor mål. Mere om, hvordan tilgangen fungerer, hvad den er god for, og hvordan den implementeres, vil blive fortalt af Andrey Markelov (), med eksempler fra implementeringen i firmaet Infobip.
Andrey Markelov — førende softwareingeniør hos Infobip, har i 11 år arbejdet med udvikling af applikationer i Java inden for finans og telekommunikation. Han udvikler Open Source-produkter, deltager aktivt i Atlassian Community og skriver plugins til Atlassians produkter. Evangelist for Prometheus, Docker og Redis.
Om Infobip
Det er en global telekommunikationsplatform, der gør det muligt for banker, detailhandel, onlinebutikker og transportselskaber at sende beskeder til deres kunder via SMS, push-notifikationer, e-mails og telefonbeskeder. I sådan en branche er stabilitet og pålidelighed vigtigt, så kunderne timely modtager beskeder.
IT-infrastrukturen hos Infobip i tal:
- 15 datacenter over hele verden;
- 500 unikke tjenester i drift;
- 2500 instanser af tjenestene, hvilket er langt mere end antallet af teams;
- 4,5 TB månedlig trafik;
- 4,5 milliarder telefonnumre;
Virksomheden vokser, og dermed også antallet af udgivelser. Vi gennemfører omkring 60 udgivelser om dagen, fordi kunderne ønsker flere funktioner og kapaciteter. Men det er svært — der er mange tjenester, men få teams. Man må hurtigt skrive kode, der skal fungere i produktion uden fejl.
Udgivelser
En typisk udgivelse hos os foregår sådan. For eksempel, der er tjenester A, B, C, D og E, hver især udvikles af et separat team.
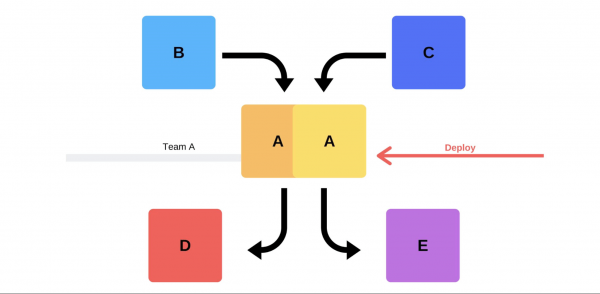
På et eller andet tidspunkt beslutter teamet for tjenesten A at udgive en ny version, men teamene for tjenesterne B, C, D og E kender ikke til dette. Der er to muligheder for, hvad teamet for tjenesten A kan gøre.
Udfører en inkrementel udgivelse: først opdaterer de én version, og så den anden.
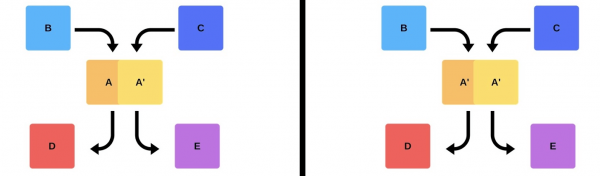
Men der er en anden mulighed: teamet finder ekstra ressourcer og maskiner, udgiver den nye version, og så skifter de routeren, og versionen begynder at køre i produktion.
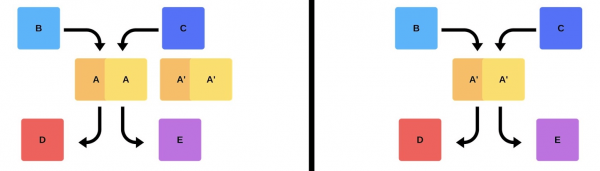
I begge tilfælde opstår der næsten altid problemer efter udgivelsen, selvom versionen er testet. Testning kan ske manuelt, automatisk eller slet ikke — problemerne vil opstå uanset. Den enkleste og mest korrekte måde at løse dem på er at rulle tilbage til den fungerende version. Derefter kan vi tage os af skaden, årsagerne og rette dem.
Så hvad ønsker vi?
Problemer ønsker vi ikke. Hvis kunderne opdager dem hurtigere end os, vil det ramme vores omdømme. Derfor skal vi finde problemer hurtigere end kunderne.. Ved at arbejde proaktivt minimerer vi skaden.
På samme tid ønsker vi at fremskynde udgivelsen, så det foregår hurtigt, nemt, naturligt og uden stress for teamet. Ingeniører, DevOps-ingeniører og programmører skal passes på — udgivelsen af en ny version er stressende. Teamet er ikke engangsressourcer; vi stræber efter rationelt at anvende menneskelige ressourcer..
Udgivelsesproblemer
Kundetrafikken er uforudsigelig.. Det er umuligt at forudsige, hvornår kundetrafikken vil være minimal. Vi ved ikke, hvor og hvornår kunderne vil starte deres kampagner — måske i aften i Indien og i morgen i Hongkong. I betragtning af den store tidsforskel garanterer en udgivelse selv kl. 2 om natten ikke, at kunderne ikke vil lide.
Providerproblemer.. Messenger- og serviceudbydere er vores partnere. Nogle gange oplever de nedbrud, der forårsager fejl under udgivelsen af nye versioner.
Fordelte teams.. Teams, der udvikler den klientbaserede del og backend, befinder sig i forskellige tidszoner. På grund af dette kan de ofte ikke nå til enighed.
Data centre kan ikke reproduceres på en staging.. I ét datacenter er der 200 racks — det kan slet ikke gengives i en sandkasse, selv ikke tæt på.
Downtimeser unacceptable! Vi har et acceptabelt tilgængelighedsniveau (Error Budget), når vi arbejder 99,99% af tiden, mens de resterende procenter er 'ret til fejl'. Det er umuligt at opnå 100% pålidelighed, men det er vigtigt konstant at overvåge nedbrud og stilstande.
Klassiske løsningsmuligheder
At skrive kode uden fejl. Da jeg var en ung udvikler, kom ledere til mig og bad om at gennemføre en release uden fejl, men det er ikke altid muligt.
At skrive tests. Tests fungerer, men nogle gange ikke på den måde, som virksomheden ønsker. At tjene penge er ikke testeams opgave.
At teste på staget. I mine 3,5 år hos Infobip har jeg aldrig set, at tilstanden på staget i det mindste delvist svarede til produktionen.
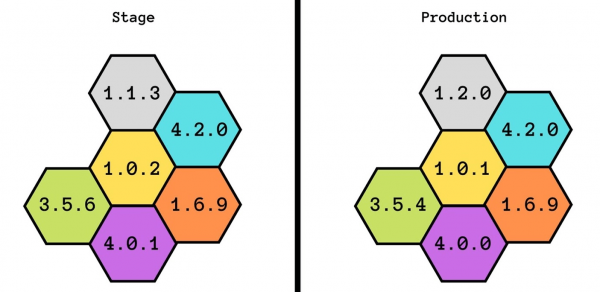
Vi forsøgte endda at udvikle denne idé: først havde vi et stage, derefter pre-production, og så pre-production af pre-production. Men det hjalp ikke — de matchede ikke engang i kapacitet. Med staget kan vi garantere basefunktionalitet, men vi ved ikke, hvordan det vil fungere under belastninger.
Releasen udføres af den, der har udviklet den. Det er en god praksis: selv hvis nogen ændrer navnet på en kommentar, skal den straks tilføjes til produktionen. Det hjælper med at udvikle ansvar og ikke glemme ændringerne.
Der er også yderligere komplikationer. For udvikleren er det stressende - at bruge meget tid på at kontrollere alt manuelt.
Aftalte releaser. Denne mulighed foreslår ledelsen normalt: 'Lad os aftale, at I tester og tilføjer nye versioner hver dag'. Dette fungerer ikke: der er altid et team, der venter på alle de andre, eller omvendt.
Smoke-tests
En anden måde at løse vores deploy-problemer på. Lad os se på, hvordan smoke-tests fungerer i det tidligere eksempel, hvor team A ønsker at deployere en ny version.
Først deployerer teamet en instans til produktionen. Meddelser i instansen fra mocks simulerer den reelle trafik, så den svarer til den normale daglige trafik. Hvis alt går godt, skifter teamet den nye version til brugertrafik.
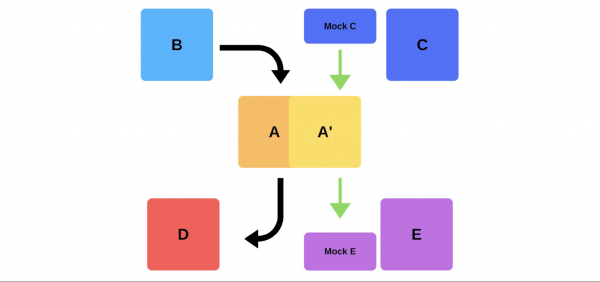
Den anden mulighed - at deployere med ekstra hardware. Teamet tester det i produktionen, og derefter skifter de, og alt fungerer.
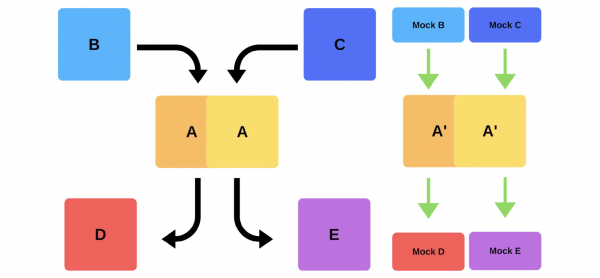
Ulemper ved smoke-tests:
- Test skal ikke være til at stole på. Hvor kan man få den samme trafik som på produktion? Man kan bruge trafik fra i går eller en uge siden, men det svarer ikke altid til den nuværende.
- Det er svært at vedligeholde. Man skal vedligeholde testkonti, konstant nulstille dem før hver deployment, når aktive poster sendes til lageret. Det er mere kompliceret end at skrive tests i eget sandkassemiljø.
Den eneste fordel her er - at man kan teste ydeevnen.
Canary-udgivelser
På grund af manglerne ved smoke-tests begyndte vi at bruge canary-udgivelser.
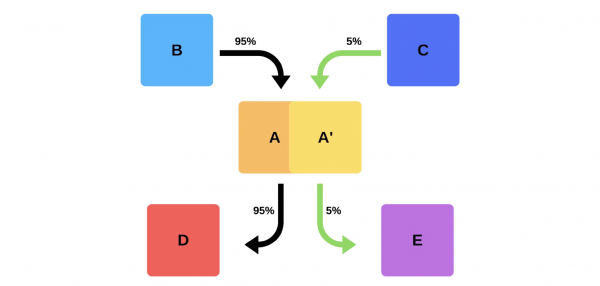
Praksis, der minder om, hvordan minearbejdere brugte kanariefugle til at indikere gasniveauer, har også fundet vej til IT. Vi sender en smule virkelig produktions trafik til den nye version, mens vi forsøger at overholde Service Level Agreement (SLA). SLA er vores "ret til at fejle", som vi kan bruge én gang om året (eller over et andet tidsrum). Hvis alt går godt, tilføjer vi mere trafik. Hvis ikke - går vi tilbage til tidligere versioner.
Implementering og detaljer
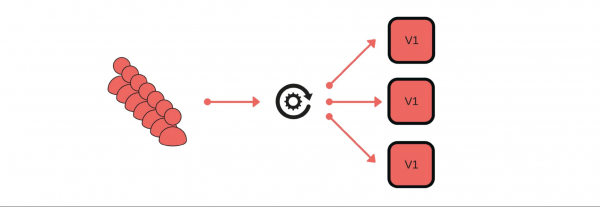
Hvordan implementerede vi canary-udgivelser? For eksempel sender en gruppe kunder meddelelser gennem vores service.
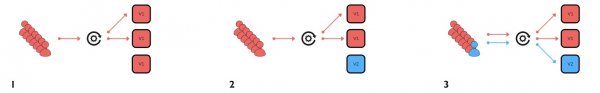
Deployment foregår således: vi fjerner en node fra load balancer (1), ændrer versionen (2) og sender separat en smule trafik (3).
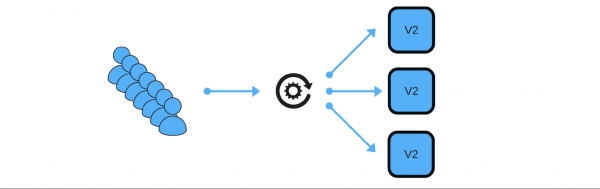
Generelt vil alle i gruppen være glade, selvom én bruger er utilfreds. Hvis alt er godt - ændrer vi alle versioner.
Jeg viser skematisk, hvordan det ser ud for mikrotjenester i de fleste tilfælde.
Der er Service Discovery og to andre tjenester: S1N1 og S2. Den første service (S1N1) informerer Service Discovery, når den starter, og Service Discovery husker den. Den anden service med to noder (S2N1 og S2N2) informerer også Service Discovery ved opstart.
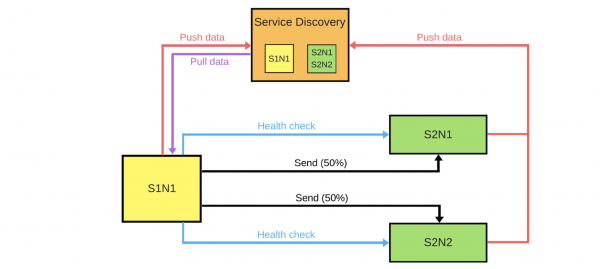
Den anden service fungerer som server for den første. Den første anmoder Service Discovery om oplysninger om sine servere, og når den modtager dem, søger og tjekker den dem ('health check'). Når den har tjekket, sender den dem meddelelser.
Når nogen ønsker at deployere en ny version af den anden service, informerer de Service Discovery om, at den anden node vil være en canary-node: den vil modtage mindre trafik, fordi der nu skal ske en deployment. Vi fjerner canary-noden fra load balancer, og den første service sender ikke trafik til den.
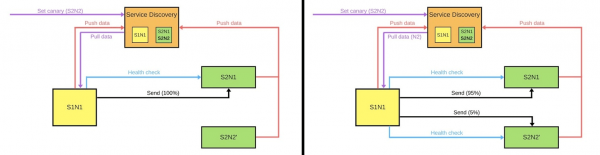
Vi ændrer version, og Service Discovery ved, at den anden node nu er en canary – den kan have en mindre belastning (5%). Hvis alt går godt, ændrer vi versionen, genopretter belastningen og fortsætter arbejdet.
For at få dette til at fungere, har vi brug for:
- load balancing;
- overvågning, da det er vigtigt at vide, hvad hver bruger forventer, og hvordan vores tjenester fungerer detaljeret;
- versionsanalyse, for at forstå, hvor godt den nye version vil fungere i produktion;
- automatisering – vi skriver rækkefølgen af implementering (deployment pipeline).
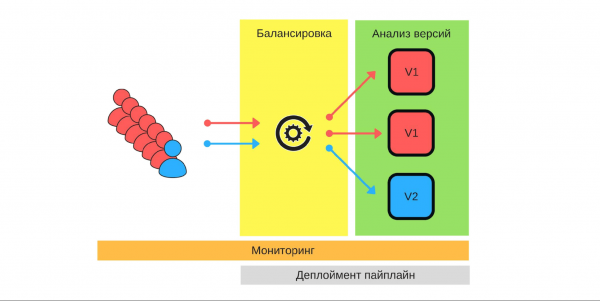
på L7 niveau
Dette er det første, vi skal overveje. Der er to strategier for load balancing.
Den simpleste variant, når én node altid er canary. Denne node modtager altid mindre trafik, og vi begynder deployment med den. Hvis der opstår problemer, sammenligner vi dens præstationer før og under deploymenten. For eksempel, hvis fejlene er blevet dobbelt så mange, så er skaden også steget med det samme.
Canary-noden defineres under deploymentprocessen. Når deploymenten er afsluttet, og vi fjerner dens status som canary-node, genoprettes trafikfordelingen. Med færre maskiner opnår vi en retfærdig fordeling.
Overvågning
Grundstenen i canary-udgivelser. Vi skal præcist forstå, hvorfor vi gør dette, og hvilke metrikker vi ønsker at indsamle.
Eksempler på metrikker, vi indsamler fra vores tjenester.
- Antallet af fejl, der skrives i logfilerne. Dette er et åbenlyst mål for, at alt fungerer som det skal. Generelt er det en god metrik.
- Tiden for udførelse af anmodninger (latency). Denne metrik overvåges af alle, fordi alle ønsker at arbejde hurtigt.
- Størrelsen af køen (throughput).
- Antallet af succesfulde svar pr. sekund.
- Tiden for udførelse af 95% af alle anmodninger.
- Forretningsmetrikker: hvor mange penge virksomheden tjener over en bestemt periode eller brugerafgang. Disse metrikker for vores nye version kan være vigtigere end dem, ingeniørerne tilføjer.
Eksempler på metrikker i de fleste populære overvågningssystemer.
Counter. Dette er et stigende tal, for eksempel antallet af fejl. Denne metrik er let at interpolere og studere grafen: i går var der 2 fejl, og i dag 500, så noget er gået galt.
Antallet af fejl pr. minut eller pr. sekund er en vigtig indikator, der kan beregnes ved hjælp af Counter. Disse data giver et klart billede af systemets præstation over tid. Lad os se på grafen over antallet af fejl pr. sekund for to versioner af produktionssystemet.
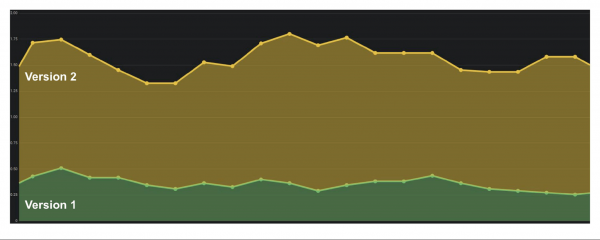
I den første version var der få fejl, muligvis fungerede auditsystemet ikke. I den anden version er alt meget værre. Det er sikkert, at der er problemer, så vi skal rulle denne version tilbage.
Gauge. Metrierne ligner Counter, men vi registrerer værdier, der både kan stige og falde. For eksempel svartid på forespørgsler eller størrelsen af køen.
På grafen er der et eksempel på svartid (latency). Grafen viser, at versionerne ligner hinanden, og de kan bruges. Men ved nærmere eftersyn kan man se, hvordan værdien ændrer sig. Hvis svartiden på forespørgsler stiger, når brugere tilføjes, er det klart, at der er problemer — sådan har det ikke været før.
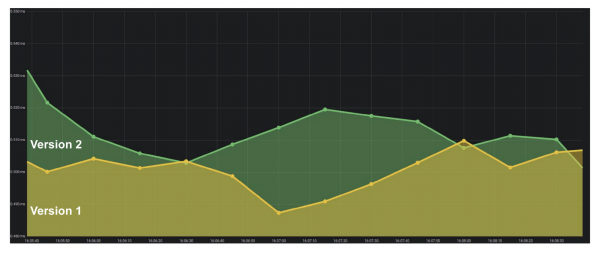
Summary. En af de vigtigste målinger for forretningen er percentiler. Metrikken viser, at i 95% af tilfældene fungerer vores system som ønsket. Vi kan acceptere, at der er problemer et sted, fordi vi forstår den overordnede tendens, hvor godt eller dårligt alt fungerer.
Værktøjer
ELK Stack. Canary kan implementeres ved hjælp af Elasticsearch - vi registrerer fejl i det, når der opstår hændelser. Med et enkelt API-kald kan vi få antal fejl på et givent tidspunkt og sammenligne med tidligere perioder: GET /applg/_cunt?q=level:errr.
Prometheus. Har vist sig godt i Infobip. Det giver mulighed for at implementere multidimensionelle metrikker, fordi der anvendes labels.
Vi kan bruge niveau, instance, service, kombinere dem i ét system. Med offset kan man se for eksempel værdien for en uge siden med kun én kommando GET /api/v1/query?query={query}, hvor {query}:
rate(logback_appender_total{
    level="error",
    instance=~"$instance"
}[5m] offset $offset_value)
Versionanalyse
Der er flere strategier til at analysere versioner.
Se kun på metrikkerne fra canary-noden. En af de enkleste muligheder: vi deployer den nye version og studerer kun den funktionelle del. Men hvis en ingeniør begynder at tjekke logs på det tidspunkt, konstant nervøst genindlæser siderne, så adskiller denne løsning sig ikke fra de andre.
Canary-noden sammenlignes med enhver anden node. Dette er en sammenligning med andre instanser, der arbejder på fuld trafik. For eksempel, hvis det går dårligere eller ikke bedre med lidt trafik end med de rigtige instanser, så er der noget galt.
Canary-noden sammenlignes med sig selv i fortiden. Noder tildelt til canary kan sammenlignes med historiske data. For eksempel, hvis alt var godt for en uge siden, kan vi bruge disse data til at forstå den aktuelle situation.
Automatisering
Vi ønsker at frigøre ingeniører fra manuel sammenligning, så det er vigtigt at implementere automatisering. Deploy-processen (deployment pipeline) ser normalt sådan ud:
- starter;
- fjerner noden fra balancereren;
- sætter canary-noden;
- aktiverer balancereren med en begrænset mængde trafik;
- sammenligner.
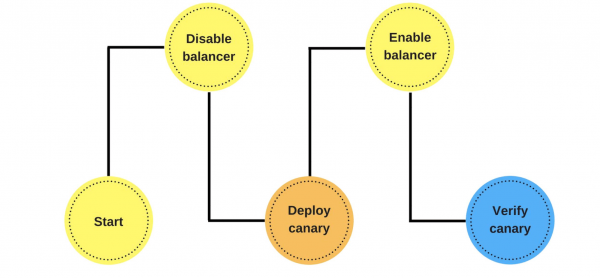
På dette trin implementerer vi automatisk sammenligning. Hvordan det kan se ud, og hvorfor det er bedre end kontrol efter deployment, ser vi på et eksempel fra Jenkins.
Dette er en pipeline til Groovy.
while (System.currentTimeMillis() < endCanaryTs) {
    def isOk = compare(srv, canary, time, base, offset, metrics)
    if (isOk) {
        sleep DEFAULT SLEEP
    }   else {
        echo "Canary mislykkedes, vi skal tilbageføre"
        return false
    }
}
Her i løkken opsætter vi, at vi vil sammenligne den nye node i en time. Hvis canary-processen stadig ikke er afsluttet, kalder vi funktionen. Den rapporterer, om alt er godt eller ej: def isOk = compare(srv, canary, time, base, offset, metrics).
Hvis alt er godt — sleep DEFAULT SLEEP, for eksempel i et sekund, og fortsætter. Hvis ikke, stopper vi — deploymenten har fejlet.
Beskrivelse af metric. Lad os se på, hvordan funktionen compare kan se ud med et eksempel fra DSL.
metric(
    'errorCounts',
    'rate(errorCounts{node=~"$canaryInst"}[5m] offset $offset)',
    {   baseValue, canaryValue ->
        if (canaryValue > baseValue * 1.3) return false
        return true
    }
)
Lad os antage, at vi sammenligner antallet af fejl og ønsker at vide antallet af fejl per sekund over de sidste 5 minutter.
Vi har to værdier: basen og canary-noden. Værdien for canary-noden er den aktuelle. Basen — baseValue — er værdien af enhver anden ikke-canary node. Vi sammenligner værdierne med formlen, vi opstiller baseret på vores erfaring og observationer. Hvis værdien canaryValue er dårlig, så fejlede deploymenten, og vi ruller tilbage.
Hvorfor er alt dette nødvendigt?
Et menneske kan ikke kontrollere hundreder og tusinder af metrics, endnu mindre hurtigt. Automatisk sammenligning hjælper med at kontrollere alle metrics og varsler hurtigt om problemer. Varslingstiden er kritisk: hvis noget skete for de sidste 2 sekunder, vil skaden ikke være så stor, som hvis det skete 15 minutter tidligere. Mens nogen bemærker et problem, skriver til support, og supporten for at rulle tilbage, kan man miste kunder.
Hvis processen er gået igennem, og alt er godt, deployer vi automatisk alle de andre noder. I mellemtiden laver ingeniørerne ikke noget. Først når de starter canary, beslutter de, hvilke målinger der skal tages, hvor længe der skal sammenlignes, og hvilken strategi der skal bruges.
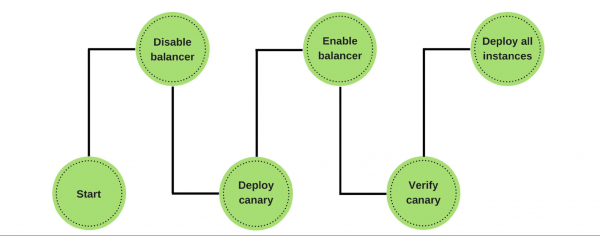
Hvis der opstår problemer — ruller vi automatisk canary-noden tilbage, arbejder med de tidligere versioner og retter de fejl, vi har fundet. Det er let at finde dem ved hjælp af målinger og se skaden fra den nye version.
Hindringer
At realisere dette er selvfølgelig ikke let. Først og fremmest er vi nødt til at have et overordnet overvågningssystem. Ingeniører har deres egne målinger, support og analytikere har andre, og erhvervslivet har tredje. Et fælles system er det fælles sprog, som erhvervslivet og udviklingen taler.
Vi skal teste i praksis stabiliteten af målingerne. Testen hjælper med at forstå, hvilket minimum af målinger der er nødvendige for at sikre kvalitet.
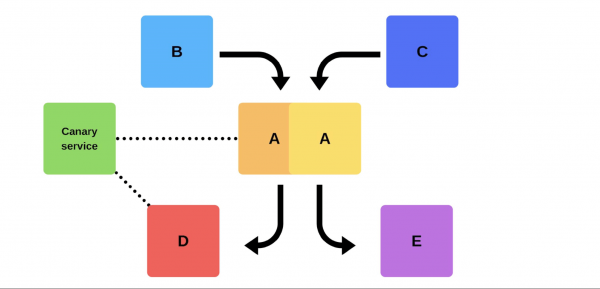
Hvordan kan vi opnå dette? Brug canary-tjenesten ikke under deploy. Vi tilføjer en eller anden tjeneste til den gamle version, der på ethvert tidspunkt kan tage en hvilken som helst dedikeret node og reducere trafikken uden deploy. Derefter sammenligner vi: vi analyserer fejl og søger den grænse, hvor vi opnår kvalitet.
Hvilken fordel har vi fået fra canary-udgivelser
Vi har minimeret procentdelen af skader fra bugs. De fleste deploy-fejl opstår på grund af usammenhængende data eller prioriteter. Sådanne fejl er blevet meget færre, fordi vi kan løse problemet inden for de første sekunder.
Vi har optimeret arbejdet for holdene. Nykommere har 'ret til fejl': de kan deploye til produktion uden frygt for at fejle, hvilket skaber ekstra initiative og incitament til at arbejde. Hvis de ødelægger noget, vil det ikke være kritisk, og den der fejlede, vil ikke blive fyret.
Vi har automatiseret deployen. Det er ikke længere en manuel proces som før, men en rigtig automatiseret proces. Men den tager længere tid.
Vi har identificeret vigtige målinger. Hele selskabet, fra erhvervslivet til ingeniører, forstår, hvad der virkelig er vigtigt i vores produkt, hvilke målinger der er, for eksempel brugerafgang og tiltrækning. Vi kontrollerer processen: tester målinger, introducerer nye, ser hvordan de gamle fungerer, for at skabe et system, der vil generere penge mere effektivt.
Vi har mange gode praksisser og systemer, der hjælper os. På trods af dette stræber vi efter at være professionelle og udføre vores arbejde af høj kvalitet, uanset om vi har et system, der kan hjælpe os eller ej.
Ingeniørmetoder og -praksisser — . Hvis du har opnået succes på din vej mod teknisk perfektion og er klar til at dele, hvad der har hjulpet dig, — .
Vi planlægger at afholde den 8. juni. Vi forstår, at det i øjeblikket er svært at træffe beslutninger om deltagelse i konferencer. Men samtidig mener vi, at karantæne ikke er en anledning til at stoppe det professionelle samvær og udvikling. Derfor vil vi på en eller anden måde finde en måde at diskutere tech lead-udfordringer og tilgange til deres løsninger — hvis det er nødvendigt, vil vi gå online og etablere netværk der!
Kilde: habr.com
