

Berkeley Packet Filters (BPF) er en Linux-kerne teknologi, der har været i de engelsksprogede tekniske publikationers overskrifter i flere år nu. Konferencer er fyldt med præsentationer om brug og udvikling af BPF. David Miller, vedligeholder af Linux' netværkssystem, kalder sit oplæg på Linux Plumbers 2018 (XDP er en af anvendelsesmulighederne for BPF). Brendan Gregg holder oplæg med titlen . Toke Høiland-Jørgensen , at kernen nu er en microkernel. Thomas Graf promoverer ideen om, at .
Der findes stadig ikke en systematisk beskrivelse af BPF på Habré, og derfor vil jeg i en serie artikler forsøge at fortælle om teknologiens historie, beskrive arkitekturen og udviklingsværktøjerne, skitsere anvendelsesområderne og praksis ved brug af BPF. I denne nulartikel i serien fortælles om historien og arkitekturen bag klassisk BPF, samt afsløres hemmelighederne bag princippet for dens funktion tcpdump, seccomp, strace, og meget mere.
Udviklingen af BPF styres af det Linux-baserede netværkssamfund. De vigtigste nuværende anvendelser af BPF er relateret til netværkene, og derfor, med tilladelse fra , har jeg kaldt serien "BPF for de meget små", til ære for den store serie .
En kort kursus i historien om BPF (c)
Den moderne teknologi BPF er en forbedret og udvidet version af den gamle teknologi med samme navn, som nu kaldes, for at undgå forvirring, klassisk BPF. På grundlag af klassisk BPF blev den velkendte værktøj tcpdump, mekanismen seccomp, samt den mindre kendte modul xt_bpf for iptables og klassifikatoren cls_bpf. I moderne Linux bliver klassiske BPF-programmer automatisk oversat til en ny form, men fra brugerens synspunkt er API'en forblevet den samme, og nye anvendelser af klassisk BPF, som vi vil se i denne artikel, eksisterer stadig. Af denne grund, samt fordi det at følge med i udviklingen af klassisk BPF i Linux vil gøre det klart hvordan og hvorfor den er udviklet til sin moderne form, besluttede jeg at starte med en artikel om klassisk BPF.
I slutningen af 1980'erne blev ingeniører fra det berømte Lawrence Berkeley Laboratory interesseret i, hvordan man korrekt filtrerer netværkspakker på det moderne udstyr fra slutningen af 1980'erne. Den grundlæggende idé bag filtreringen, som oprindeligt blev implementeret i CSPF-teknologien (CMU/Stanford Packet Filter), var at filtrere unødvendige pakker så tidligt som muligt, det vil sige i kernerummet, da dette gør det muligt at undgå at kopiere unødvendige data til brugerrummet. For at sikre sikker kørselstid for at køre brugerens kode i kernerummet, blev en virtuel maskine — sandkasse — anvendt.
Men de virtuelle maskiner for de eksisterende filtre var designet til at køre på maskiner med stakarkitektur og fungerede ikke så effektivt på de nye RISC-maskiner. Som et resultat af ingeniørernes indsats fra Berkeley Labs blev en ny teknologi, BPF (Berkeley Packet Filters), udviklet, hvis virtuelle maskinarkitektur var baseret på Motorola 6502-processoren — den arbejds-hest bag så kendte produkter som eller . Den nye virtuelle maskine øgede filteres ydeevne mange gange i forhold til de eksisterende løsninger.
BPF-maskinens arkitektur
Vi vil lære om arkitekturen i praksis ved at se på eksempler. Men først skal vi sige, at maskinen havde to brugbare 32-bit registre, en akkumulator A og et indeksregister X, 64 byte hukommelse (16 ord) tilgængelig for læsning og skrivning, samt et lille kommando-system til at arbejde med disse objekter. I programmerne var der også betingede hopinstruktioner til rådighed, men for at sikre rettidig afslutning af programmet kunne der kun hoppes fremad, det vil sige, det var forbudt at skabe løkker.
Den overordnede proces til at starte maskinen er som følger. Brugeren opretter et program til BPF-arkitekturen og ved hjælp af en form for kerne-mekanisme (f.eks. systemopkald), indlæser og knytter programmet til en eller anden begivenhedsgenerator i kernen (f.eks. en begivenhed — dette er ankomsten af en ny pakke til netværkskortet). Når der opstår en begivenhed, starter kernen programmet (f.eks. i fortolkeren), hvor maskinens hukommelse svarer til en eller anden kernelelements hukommelsesområde (for eksempel dataene i den modtagne pakke).
Det ovenstående er tilstrækkeligt til at begynde at analysere eksempler: vi vil blive bekendt med systemet og formatet af kommandoer om nødvendigt. Hvis du ønsker at studere systemet for virtuelle maskinkommandoer med det samme og lære om alle dens muligheder, kan du læse den originale artikel. og/eller den første halvdel af filen fra kernedokumentationen. Derudover kan du studere præsentationen , hvor McCanne, en af forfatterne til BPF, taler om historien bag udviklingen, libpcap.
Vi går videre med at overveje alle betydelige eksempler på anvendelse af klassisk BPF i Linux: tcpdump (libpcap), seccomp, xt_bpf, cls_bpf.
tcpdump
Udviklingen af BPF fandt sted parallelt med udviklingen af frontend til pakke filtrering – den velkendte værktøj. tcpdump. Og da dette er det ældste og mest kendte eksempel på brugen af klassisk BPF, tilgængelig på mange operativsystemer, vil vi starte vores studier af teknologien her.
(Alle eksempler i denne artikel blev kørt på Linux 5.6.0-rc6. Output af nogle kommandoer er redigeret for bedre læsbarhed.)
Eksempel: observerer IPv6 pakker
Antag, at vi ønsker at overvåge alle IPv6 pakker på interfacet eth0. For dette kan vi køre programmet tcpdump med den enkleste filter ip6:
$ sudo tcpdump -i eth0 ip6I dette tilfælde tcpdump vil kompilere filteret ip6 til BPF-arkitekturens bytekode og sende det til kernen (se detaljer i afsnittet ). Det indlæste filter vil blive kørt for hver pakke, der passerer gennem interfacet. eth0Hvis filteret returnerer en ikke-nul værdi n, så vil n bytes af pakken blive kopieret til brugerens rum, og vi vil se det i outputtet. tcpdump.
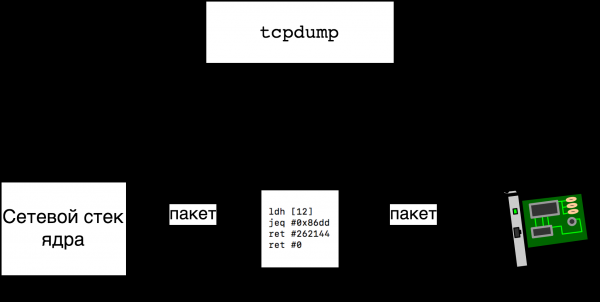
Det viser sig, at vi nemt kan finde ud af, hvilken bytekode der er sendt til kernen tcpdump ved hjælp af selve tcpdump, hvis vi kører det med indstillingen -d:
$ sudo tcpdump -i eth0 -d ip6
(000) ldh      [12]
(001) jeq      #0x86dd          jt 2    jf 3
(002) ret      #262144
(003) ret      #0
På den nulte linje kører vi kommandoen ldh [12], som decodes som 'læs ind i registeret A halvord (16 bits), der findes på adresse 12', og det eneste spørgsmål er, hvilken hukommelse vi adresserer? Svaret er, at ved adresse x begynder (x+1)- byte af den analyserede netværkspakke. Vi læser pakker fra Ethernet-interfacet eth0, hvilket betyder , at pakken ser således ud (for enkelhed antager vi, at der ikke er VLAN-tags i pakken):
       6              6          2
|Destination MAC|Source MAC|Ether Type|...|
Så efter at have udført kommandoen ldh [12] vil der være et felt A Ether Type — typen af pakken, der sendes i denne Ethernet-ramme. På linje 1 sammenligner vi indholdet af registreret (pakke type) med A 0x86dd og det er, hvilket betyder jt 2 jf 3 og — etiketter, som vi skal gå til ved en vellykket sammenligning ( A == 0x86dd) og ved en mislykket. Så i tilfælde af succes (IPv6) går vi til linje 2, men i tilfælde af fejl går vi til linje 3. På linje 3 afsluttes programmet med kode 0 (kopier ikke pakken), mens programmet afsluttes på linje 2 med kode 262144 (kopier mig maksimalt 256 kilobyte af pakken).Et mere komplekst eksempel: vi ser på TCP-pakker ved destinationsporten
Lad os se, hvordan filteret ser ud, som kopierer alle TCP-pakker med destinationsport 666. Vi kigger på tilfældet IPv4, da IPv6-tilfældet er enklere. Efter at have studeret dette eksempel, kan du som en øvelse selv studere filteret for IPv6 (
ip6 and tcp dst port 666) og filteret for den generelle sag (tcp dst port 666). Så det filter, vi er interesseret i, ser således ud:$ sudo tcpdump -i eth0 -d ip and tcp dst port 666 (000) ldh [12] (001) jeq #0x800 jt 2 jf 10 (002) ldb [23] (003) jeq #0x6 jt 4 jf 10 (004) ldh [20] (005) jset #0x1fff jt 10 jf 6 (006) ldxb 4*([14]&0xf) (007) ldh [x + 16] (008) jeq #0x29a jt 9 jf 10 (009) ret #262144 (010) ret #0
Hvad linjerne 0 og 1 gør, ved vi allerede. På linje 2 har vi allerede kontrolleret, at det er en IPv4-pakke (Ether Type =) og vi indlæser registreret 0x80024. byte af pakken. Vores pakke ser ud som A 14 8 1 1 |ethernet header|ip fields|ttl|protocol|...
hvilket betyder, at vi indlæser feltet Protocol fra IP-headeren, hvilket er logisk, da vi kun ønsker at kopiere TCP-pakker. Vi sammenligner Protocol medIPPROTO_TCP A ) på linje 3. 0x6 (jset
tjekker vi, om en af de tre flag — i masken, der er givet — i masken givet flag de tre øverste bits er ryddet. To ud af tre bits fortæller os, om pakken er en del af en fragmenteret IP-pakke, og hvis ja, om det er den sidste fragment. Den tredje bit er reserveret og skal være nul. Vi ønsker ikke at tjekke hverken ufuldstændige eller beskadigede pakker, så vi kontrollerer alle tre bits.
Linje 6 er den mest interessante i denne liste. Udtrykket ldxb 4*([14]&0xf) betyder, at vi indlæser i registret X de fire laveste bits af den femtende byte i pakken, ganget med 4. De fire laveste bits af den femtende byte er feltet i IPv4-headeren, som indeholder længden af overskriften i ord, derfor skal det derefter ganges med 4. Interessant nok er udtrykket 4*([14]&0xf) et tegn på en særlig adresseringsmetode, der kun kan bruges på denne måde og kun til registrering X, dvs. vi kan ikke sige hverken ldb 4*([14]&0xf) eller ldxb 5*([14]&0xf) (vi kan kun angive en anden offset, f.eks. ldxb 4*([16]&0xf)). Det er klart, at denne adresseringsmetode blev tilføjet i BPF netop for at få X (indeksregisteret) længden af IPv4-headeren.
Dermed forsøger vi på linje 7 at indlæse en halvord ved adressen (X+16). Huskende at 14 bytes udgør Ethernet-headeren, og X indeholder længden af IPv4-headeren, forstår vi, at i A indlæses TCP-destinationporten:
       14           X           2             2
|ethernet header|ip header|source port|destination port|
Endelig sammenligner vi på linje 8 destinationporten med den ønskede værdi, og på linje 9 eller 10 returnerer vi resultatet — om vi skal kopiere pakken eller ej.
Tcpdump: indlæsning
I de tidligere eksempler stoppede vi ikke specifikt for at se på, hvordan vi indlæser BPF bytecode i kernen for at filtrere pakker. Generelt set tcpdump er porteret til mange systemer og arbejder med filtre bruger biblioteket . Kort sagt, for at anvende en filter på et interface ved hjælp af libpcap, skal du gøre følgende:
- oprette en descriptor af typen
pcap_tfra navnet på interface: , - aktivere interfacet: ,
- kompilere filteret: ,
- tilknytte filteret: .
For at se, hvordan funktionen pcap_setfilter er implementeret i Linux, bruger vi strace (nogle linjer blev fjernet):
$ sudo strace -f -e trace=%network tcpdump -p -i eth0 ip
socket(AF_PACKET, SOCK_RAW, 768)        = 3
bind(3, {sa_family=AF_PACKET, sll_protocol=htons(ETH_P_ALL), sll_ifindex=if_nametoindex("eth0"), sll_hatype=ARPHRD_NETROM, sll_pkttype=PACKET_HOST, sll_halen=0}, 20) = 0
setsockopt(3, SOL_SOCKET, SO_ATTACH_FILTER, {len=4, filter=0xb00bb00bb00b}, 16) = 0
...
I de første to linjer af output opretter vi for at læse alle Ethernet-rammer og binder det til interfacet eth0. Fra ved vi, at filteret ip vil bestå af fire BPF instruktioner, og i den tredje linje ser vi, hvordan vi ved hjælp af indstillingen af systemopkaldet setsockopt Vi indlæser og tilslutter en filter med længde 4. Det er vores filter.
Det skal bemærkes, at i klassisk BPF sker indlæsningen og tilslutningen af filteret altid som en atomar handling, mens i den nye version af BPF er indlæsningen af programmet og tilknytningen til hændelsesgeneratoren adskilt i tid.
Den skjulte sandhed
En lidt mere fyldestgørende version af outputtet ser således ud:
$ sudo strace -f -e trace=%network tcpdump -p -i eth0 ip
socket(AF_PACKET, SOCK_RAW, 768)        = 3
bind(3, {sa_family=AF_PACKET, sll_protocol=htons(ETH_P_ALL), sll_ifindex=if_nametoindex("eth0"), sll_hatype=ARPHRD_NETROM, sll_pkttype=PACKET_HOST, sll_halen=0}, 20) = 0
setsockopt(3, SOL_SOCKET, SO_ATTACH_FILTER, {len=1, filter=0xbeefbeefbeef}, 16) = 0
recvfrom(3, 0x7ffcad394257, 1, MSG_TRUNC, NULL, NULL) = -1 EAGAIN (Resource temporarily unavailable)
setsockopt(3, SOL_SOCKET, SO_ATTACH_FILTER, {len=4, filter=0xb00bb00bb00b}, 16) = 0
...
Som nævnt tidligere indlæser og tilslutter vi vores filter til socket'en på linje 5, men hvad sker der på linjerne 3 og 4? Det viser sig, at det libpcap passer på os — for at sikre, at pakker, som ikke opfylder betingelserne, ikke kommer ind i outputtet fra vores filter, tilslutter biblioteket ret #0 (drop alle pakker), sætter socket'en i ikke-blokeringsmodus, og forsøger at læse alle pakker, der måtte være tilbage fra tidligere filtre. Samlet set for at filtrere pakker på Linux ved hjælp af klassisk BPF, er det nødvendigt at have et filter i form af en struktur af typen
struct sock_fprog og en åben socket, hvorefter filteret kan tilsluttes socket'en ved hjælp af systemopkaldet Det er interessant, at filteret kan tilsluttes enhver socket, ikke kun raw. Her er setsockopt.
et program, der skærer alt bort undtagen de første to bytes af alle indkommende UDP datagrammer. (Jeg har tilføjet kommentarer i koden for ikke at overbelaste artiklen.) For mere detaljeret information om brugen
til at tilslutte filtre, se i setsockopt socket(7) uden hjælp og en åben socket, hvorefter filteret kan tilsluttes socket'en ved hjælp af systemopkaldet vil vi tale om i sektionen tcpdump Programmering af BPF med egne hænder .
BPF blev inkluderet i Linux i 1997 og har i lang tid været en arbejdshest
uden betydelige ændringer (Linux-specifikke ændringer selvfølgelig, libpcap men de ændrede ikke det overordnede billede). De første alvorlige tegn på, at BPF ville udvikle sig, dukkede op i 2011, da Eric Dumazet foreslog x86_64 kode. JIT-kompilereren var den første i rækken af ændringer: i 2012 muligheden for at skrive filtre til
, ved hjælp af BPF blev introduceret i januar 2013. muligheden for at skrive filtre til , ved hjælp af BPF, i januar 2013 blev modul xt_bpf, der gør det muligt at skrive regler for iptables ved hjælp af BPF, og i oktober 2013 blev der endda en modul cls_bpf, der gør det muligt at skrive trafikklassifikatorer ved hjælp af BPF.
Vi vil snart se disse eksempler mere detaljeret, men først vil det være nyttigt for os at lære at skrive og kompilere vilkårlige programmer til BPF, da mulighederne, der tilbydes af biblioteket libpcap er begrænsede (et enkelt eksempel: en filter, der genereres libpcap kan kun returnere to værdier — 0 eller 0x40000) eller overhovedet, som i tilfældet med seccomp, ikke anvendelige.
Klassisk BPF og det 21. århundrede
Lad os lære den binære format for BPF-instruktioner, det er meget enkelt:
   16    8    8     32
| kode | jt | jf |  k  |
Hver instruktion optager 64 bit, hvor de første 16 bit er instruktionens kode, derefter følger to otte-bit indrykninger, jt og jf, og 32 bit til argumentet K, hvis formål varierer fra kommando til kommando. For eksempel har kommandoen ret, der afslutter programmets kørsel, koden 6, og den returnerede værdi tages fra konstanten K. På C-sprog repræsenteres en BPF-instruktion som en struktur
struct sock_filter {
        __u16   kode;
        __u8    jt;
        __u8    jf;
        __u32   k;
}
og et helt program — som en struktur
struct sock_fprog {
        unsigned short len;
        struct sock_filter *filter;
}
Dermed kan vi allerede skrive programmer (instruktionskoderne ved vi, lad os sige, fra ). Sådan vil filtreren se ud ip6 af :
struct sock_filter kode[] = {
        { 0x28, 0, 0, 0x0000000c },
        { 0x15, 0, 1, 0x000086dd },
        { 0x06, 0, 0, 0x00040000 },
        { 0x06, 0, 0, 0x00000000 },
};
struct sock_fprog prog = {
        .len = ARRAY_SIZE(kode),
        .filter = kode,
};
Programmet prog kan vi lovligt bruge i kaldet
setsockopt(sk, SOL_SOCKET, SO_ATTACH_FILTER, &prog, sizeof(prog))At skrive programmer som maskinkoder er ikke meget bekvemt, men nogle gange er det nødvendigt (for eksempel til debugging, oprettelse af unit-tests, skrivning af artikler på Habr og så videre). For at gøre det nemmere i filen <linux/filter.h> defineres hjælpe-makroer — det samme eksempel som ovenfor kunne skrives som
struct sock_filter kode[] = {
        BPF_STMT(BPF_LD|BPF_H|BPF_ABS, 12),
        BPF_JUMP(BPF_JMP|BPF_JEQ|BPF_K, ETH_P_IPV6, 0, 1),
        BPF_STMT(BPF_RET|BPF_K, 0x00040000),
        BPF_STMT(BPF_RET|BPF_K, 0),
}
Men selv denne mulighed er ikke særlig praktisk. Sådan tænkte også Linux-kernens programmører, og derfor kan man finde assembler og debugger til at arbejde med klassisk BPF i mappen af kernen.
Assembler-sproget ligner meget den debug-udgang tcpdump, men vi kan desuden angive symbolske labels. For eksempel, her er et program, der dropper alle pakker, undtagen TCP/IPv4:
$ cat /tmp/tcp-over-ipv4.bpf
ldh [12]
jne #0x800, drop
ldb [23]
jneq #6, drop
ret #-1
drop: ret #0
Sommer assembleren genererer kode i formatet , ,..., for vores eksempel med TCP får vi
$ tools/bpf/bpf_asm /tmp/tcp-over-ipv4.bpf
6,40 0 0 12,21 0 3 2048,48 0 0 23,21 0 1 6,6 0 0 4294967295,6 0 0 0,
For at lette C-udvikleres arbejde kan en anden outputformat bruges:
$ tools/bpf/bpf_asm -c /tmp/tcp-over-ipv4.bpf
{ 0x28, 0, 0, 0x0000000c },
{ 0x15, 0, 3, 0x00000800 },
{ 0x30, 0, 0, 0x00000017 },
{ 0x15, 0, 1, 0x00000006 },
{ 0x06, 0, 0, 0xffffffff },
{ 0x06, 0, 0, 0000000000 },
Denne tekst kan kopieres ind i definitionen af strukturen af typen struct sock_filter, ligesom vi gjorde i begyndelsen af dette afsnit.
Linux-udvidelser og netsniff-ng
Udover de standard BPF-instruktioner understøtter Linux og tools/bpf/bpf_asm også . Generelt tjener instruktionerne til at få adgang til felterne i strukturen struct sk_buff, der beskriver et netværkspakke i kernen. Der er dog også hjælpeinstruktioner af en anden art, for eksempel ldw cpu vil indlæse i registreren A resultatet af kernen raw_smp_processor_id(). (I den nye version af BPF er disse ikke-standardudvidelser blevet udvidet til at give programmer et sæt kernel helpers til adgang til hukommelse, strukturer og generering af hændelser.) Her er et interessant eksempel på en filter, hvor vi kopierer til brugerrummet kun headerne af pakkerne ved hjælp af udvidelsen poff, payload offset:
ld poff
ret a
BPF-udvidelser kan ikke bruges i tcpdump, men det er en god anledning til at stifte bekendtskab med pakken af værktøjer , som, udover alt andet, indeholder et avanceret program netsniff-ng, som udover filtrering ved hjælp af BPF også indeholder en effektiv trafikgenerator og en mere avanceret BPF-assembler kaldet tools/bpf/bpf_asmbpfc . Pakken indeholder ret detaljeret dokumentation, se også linksene i slutningen af artiklen.Så vi kan allerede skrive BPF-programmer af vilkårlig kompleksitet og er klar til at se på nye eksempler, hvoraf den første er teknologien seccomp, der gør det muligt at administrere mange og sæt af argumenter for systemopkald ved hjælp af BPF-filtre, der er tilgængelige for denne proces og dens efterkommere.
seccomp
Den første version af seccomp blev tilføjet til kernen i 2005 og blev ikke særlig populær, da den kun gav én mulighed - at begrænse mængden af systemopkald, der var tilgængelige for processen til følgende:
read write, write, sigreturn og , og en proces, der overtræder reglerne, blev dræbtved hjælp af SIGKILL. Men i 2012 blev der i seccomp tilføjet mulighed for at bruge BPF-filtre, der gør det muligt at definere mange tilladte systemopkald og endda udføre kontroller af deres argumenter. (Det er interessant, at en af de første brugere af denne funktionalitet var Chrome, og i øjeblikket udvikler folk fra Chrome en KRSI-mekanisme baseret på den nye version af BPF, der gør det muligt at tilpasse Linux Security Modules.) Links til yderligere dokumentation kan findes i slutningen af artiklen.
Det skal bemærkes, at der allerede har været artikler om brugen af seccomp på Habr, så måske nogen ønsker at læse dem før (eller i stedet for) at læse de følgende underafsnit. I artiklen gives der eksempler på brugen af seccomp, både i versionen fra 2007 og i versionen med BPF (filtrene genereres ved hjælp af libseccomp), der fortælles om sammenhængen mellem seccomp og Docker, samt der er mange nyttige links. I artiklen diskuteres blandt andet, hvordan man tilføjer sorte eller hvide lister over systemopkald for dæmoner, der kører under systemd.
Herefter vil vi se på, hvordan man skriver og indlæser filtre for seccomp i rå C samt ved hjælp af bibliotekerne libseccomp og hvilke fordele og ulemper hver variant har, og til sidst vil vi se på, hvordan seccomp bruges af programmet strace.
Skriver og indlæser filtre for seccomp
Vi kan allerede skrive BPF-programmer, så vi ser først på det programmeringsinterface, der findes i seccomp. En filter kan sættes på procesniveau, og alle underliggende processer vil arve begrænsningerne. Dette gøres ved hjælp af systemopkaldet :
seccomp(SECCOMP_SET_MODE_FILTER, flags, &filter)hvor &filter — det er en peger til den struktur, vi allerede kender og en åben socket, hvorefter filteret kan tilsluttes socket'en ved hjælp af systemopkaldet, dvs. BPF-programmet.
Hvordan adskiller programmerne for seccomp sig fra programmerne for sockets? Ved den kontekst, der bliver givet. I tilfælde af sockets blev der givet et hukommelsesområde, der indeholdt pakken, mens der i tilfælde af seccomp bliver der givet en struktur af typen
struct seccomp_data {
    int   nr;
    __u32 arch;
    __u64 instruction_pointer;
    __u64 args[6];
};
Her nr — det er nummeret på det systemopkald, der køres, arch — den nuværende arkitektur (mere om dette senere), args — op til seks argumenter for systemopkaldet, og instruction_pointer — er en peger til en brugerpladsinstruktion, der udførte dette systemopkald. For eksempel, for at sætte systemopkaldets nummer ind i registret A må vi sige
ldw [0]For seccomp-programmer er der andre specifikationer, for eksempel kan adgang til konteksten kun ske med 32-bit justering, og det er ikke tilladt at indlæse halve ord eller bytes — ved forsøg på at indlæse filteret ldh [0] systemopkaldet seccomp vil returnere EINVAL. Kontrollen af de indlæste filtre udføres af funktionen i kernen. (Sjovt nok, i den originale commit, der tilføjede seccomp-funktionalitet, glemte de at tillade brug af instruktionen mod (rest af divisionen) og nu er den ikke tilgængelig for seccomp BPF-programmer, da dens tilføjelse ABI.)
I princippet ved vi allerede alt for at skrive og læse seccomp-programmer. Normalt er programmets logik struktureret som et hvidt eller sort systemopkaldsfortegnelse, for eksempel programmet
ld [0]
jeq #304, bad
jeq #176, bad
jeq #239, bad
jeq #279, bad
good: ret #0x7fff0000 /* SECCOMP_RET_ALLOW */
bad: ret #0
tjekker et sort liste over fire systemopkald med numrene 304, 176, 239, 279. Hvad er disse systemopkald? Vi kan ikke sige det præcist, da vi ikke ved, til hvilken arkitektur programmet er skrevet. Derfor foreslår forfatterne af seccomp i strukturen arch struct seccomp_data ). Med arkitekturkontrol ville begyndelsen af eksemplet se ud som:ld [4] jne #0xc000003e, bad_arch ; SCMP_ARCH_X86_64
og så ville vores systemopkaldsnumre få bestemte værdier.Vi skriver og indlæser filtre til seccomp ved hjælp af
At skrive filtre i maskinkoder eller for BPF assembler giver fuld kontrol over resultatet, men nogle gange kan det være at foretrække at have bærbar og/eller læsbar kode. Biblioteket libseccomp
, som giver en standard grænseflade til at skrive sorte eller hvide filtre, hjælper os med dette. Lad os for eksempel skrive et program, der kører en binær fil efter brugerens valg, efter først at have etableret en sort liste over systemopkald fra
den ovennævnte artikel I starten definerer vi en array ):
#include <seccomp.h>
#include <unistd.h>
#include <err.h>

static int sys_numbers[] = {
        __NR_mount,
        __NR_umount2,
       // ... еще 40 системных вызовов ...
        __NR_vmsplice,
        __NR_perf_event_open,
};

int main(int argc, char **argv)
{
        scmp_filter_ctx ctx = seccomp_init(SCMP_ACT_ALLOW);

        for (size_t i = 0; i < sizeof(sys_numbers)/sizeof(sys_numbers[0]); i++)
                seccomp_rule_add(ctx, SCMP_ACT_TRAP, sys_numbers[i], 0);

        seccomp_load(ctx);

        execvp(argv[1], &argv[1]);
        err(1, "execlp: %s", argv[1]);
}
sys_numbers system_numre fra 40+ systemopkald for blokkering. Derefter initialiserer vi konteksten ctx og fortæller biblioteket, at vi vil tillade (SCMP_ACT_ALLOW) alle systemopkald som standard (det er lettere at opbygge sortlister). Derefter tilføjer vi et efter et alle systemopkald fra sortlisten. Som reaktion på et systemopkald fra listen anmoder vi SCMP_ACT_TRAP, i dette tilfælde sender seccomp et signal til processen SIGSYS med besked om, hvilket systemopkald der har overtrådt reglerne. Til sidst indlæser vi programmet i kernen ved hjælp af seccomp_load, som kompilerer programmet og tilslutter det til processen ved hjælp af systemopkaldet seccomp(2).
For at kompilere programmet korrekt skal det linkes med biblioteket libseccomp, for eksempel:
cc -std=c17 -Wall -Wextra -c -o seccomp_lib.o seccomp_lib.c
cc -o seccomp_lib seccomp_lib.o -lseccomp
Eksempel på en vellykket kørsel:
$ .\/seccomp_lib echo ok
ok
Eksempel på et blokeret systemopkald:
$ sudo .\/seccomp_lib mount -t bpf bpf \/tmp
Bad system call
Vi bruger strace, for at finde detaljerne:
$ sudo strace -e seccomp .\/seccomp_lib mount -t bpf bpf \/tmp
seccomp(SECCOMP_SET_MODE_FILTER, 0, {len=50, filter=0x55d8e78428e0}) = 0
--- SIGSYS {si_signo=SIGSYS, si_code=SYS_SECCOMP, si_call_addr=0xboobdeadbeef, si_syscall=__NR_mount, si_arch=AUDIT_ARCH_X86_64} ---
+++ dræbt af SIGSYS (core dumped) +++
Bad system call
hvorfra vi kan se, at programmet blev afsluttet på grund af brugen af et forbudt systemopkald mount(2).
Så i alt har vi skrevet en filter ved hjælp af biblioteket libseccomp, hvor vi har pakket ikke-triviel kode ind i fire linjer. I ovenstående eksempel kan udførelsestiden bemærkelsesværdigt falde med mange systemopkald, da kontrol blot er en liste af sammenligninger. For at optimere dette er der for nylig i libseccomp blevet , der tilføjer støtte til filterattributten SCMP_FLTATR_CTL_OPTIMIZE. Hvis denne attribut sættes til 2, vil filteret blive omdannet til et binærsøgeprogram.
Hvis du vil se, hvordan filtre med binærsøg fungerer, kan du kigge på , der genererer sådanne programmer i BPF-assembler ud fra et sæt systemopkaldsnumre, for eksempel:
$ echo 1 3 6 8 13 | .\/generate_bin_search_bpf.py
ld [0]
jeq #6, bad
jgt #6, check8
jeq #1, bad
jeq #3, bad
ret #0x7fff0000
check8:
jeq #8, bad
jeq #13, bad
ret #0x7fff0000
bad: ret #0
Det vil ikke kunne laves hurtigere, da BPF-programmer ikke kan lave spring baseret på indrykning (vi kan ikke f.eks. lave jmp A eller jmp [label+X]) og derfor er alle spring statiske.
seccomp og strace
Alle kender værktøjet strace — et uundgåeligt værktøj i undersøgelsen af processernes adfærd på Linux. Mange har dog også hørt om ved brug af dette værktøj. Årsagen er, at strace det er implementeret ved hjælp af ptrace(2), og i denne mekanisme kan vi ikke angive, på hvilket sæt systemopkald vi skal stoppe processen, dvs. eksempelvis kommandoerne
$ time strace du /usr/share/ > /dev/null 2>&1

real    0m3.081s
user    0m0.531s
sys     0m2.073s
og
$ time strace -e open du /usr/share/ > /dev/null 2>&1

real    0m2.404s
user    0m0.193s
sys     0m1.800s
kører på omtrent samme tid, selvom vi i det andet tilfælde ønsker at trace kun ét systemopkald.
Den nye mulighed --seccomp-bpf, tilføjet i strace version 5.3, gør det muligt at fremskynde processen mange gange, og tiden det tager at starte under tracing af ét systemopkald er allerede sammenlignelig med tiden for en almindelig opstart:
$ time strace --seccomp-bpf -e open du /usr/share/ > /dev/null 2>&1

real    0m0.148s
user    0m0.017s
sys     0m0.131s

$ time du /usr/share/ > /dev/null 2>&1

real    0m0.140s
user    0m0.024s
sys     0m0.116s
(Her er der selvfølgelig en lille tilsvarende, idet vi tracer ikke det primære systemopkald for denne kommando. Hvis vi havde traced, for eksempel, newfsstat, så strace ville det bremse ligeså meget som uden --seccomp-bpf.)
Hvordan fungerer denne mulighed? Uden den strace forbindes til processen og starter den ved hjælp af PTRACE_SYSCALL. Når den kontrollerede proces starter (et hvilket som helst) systemopkald, overgår kontrollen strace, som ser på argumenterne for systemopkaldet og starter det ved hjælp af PTRACE_SYSCALL. Efter noget tid afslutter processen systemopkaldet, og ved afslutning af det gives kontrollen tilbage strace, som ser på returværdierne og starter processen ved hjælp af PTRACE_SYSCALL, osv.
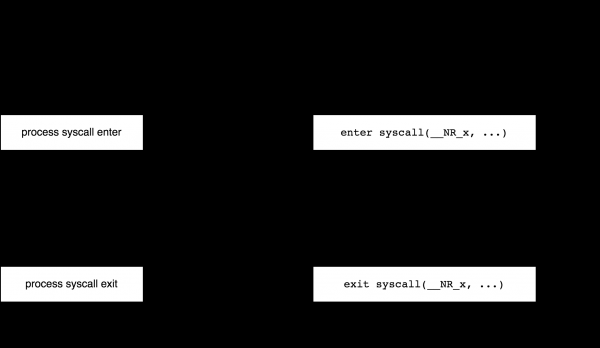
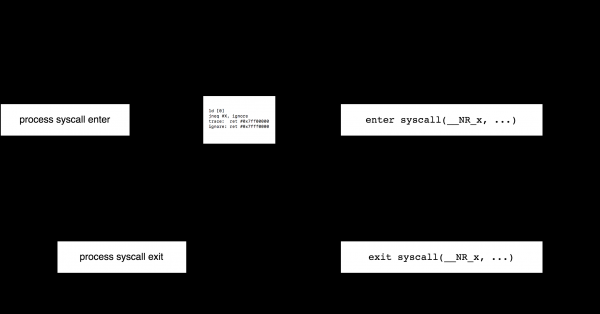
Ved hjælp af seccomp kan denne proces dog optimeres præcist, som vi gerne vil. Hvis vi kun vil se på systemopkaldet X, kan vi skrive en BPF-filter, der for X returnerer værdien SECCOMP_RET_TRACE, og for opkald, der ikke interesserer os — SECCOMP_RET_ALLOW:
ld [0]
jneq #X, ignore
trace: ret #0x7ff00000
ignore: ret #0x7fff0000
I dette tilfælde strace starter oprindeligt processen som PTRACE_CONT, for hvert systemopkald udføres vores filter, hvis systemopkaldet ikke X, så fortsætter processen, men hvis det er X, så overfører seccomp kontrollen strace, som ser på argumenterne og starter processen som PTRACE_SYSCALL (da der seccomp ikke har mulighed for at køre et program, når systemopkaldet afsluttes). Når systemopkaldet returneres, strace genstarter processen ved hjælp af PTRACE_CONT og vil vente på nye meddelelser fra seccomp.
Når der bruges indstillingen --seccomp-bpf er der to begrænsninger. For det første kan du ikke tilslutte dig en allerede eksisterende proces (indstillingen -p programmer strace), da dette ikke understøttes af seccomp. For det andet er der ikke mulighed for ikke at se på børneprocesser, da seccomp-filtre arves af alle børneprocesser uden mulighed for at deaktivere dette.
Lidt flere detaljer om hvordan præcist strace arbejder med seccomp kan findes i . For os er den mest interessante kendsgerning, at klassisk BPF i skikkelse af seccomp fortsat anvendes.
xt_bpf
Lad os nu vende tilbage til verdenen af netværk.
Baggrund: for længe siden, i 2007, blev der tilføjet modul xt_u32 til netfilter. Den blev skrevet i lighed med den endnu ældre trafikklassifikator cls_u32 og tillod at skrive vilkårlige binære regler for iptables ved hjælp af følgende enkle operationer: at indlæse 32 bit fra pakken og udføre et sæt aritmetiske operationer. For eksempel,
sudo iptables -A INPUT -m u32 --u32 "6&0xFF=1" -j LOG --log-prefix "seen-by-xt_u32"Indlæser 32 bit fra IP-headeren, startende med en offset på 6, og anvender en maske 0xFF (tager den laveste byte). Dette er feltet protocol i IP-headeren, og vi sammenligner det med 1 (ICMP). I en regel kan man kombinere mange kontroller, og man kan også udføre operationen @ — gå til X byte til højre. For eksempel tjekker reglen
iptables -m u32 --u32 "6&0xFF=0x6 && 0>>22&0x3C@4=0x29"om TCP Sequence Number ikke er lig med 0x29. Jeg vil ikke gå videre i dybden, da det allerede er klart, at det ikke er særlig praktisk at skrive sådanne regler manuelt. I artiklen , er der nogle link til eksempler på brug og generering af regler for xt_u32. Se også linksene i slutningen af denne artikel.
Siden 2013 har det været muligt at bruge et BPF-baseret modul i stedet for modulet xt_u32 . Alle der har læst hertil, bør nu have en klar forståelse af, hvordan det fungerer: at køre BPF bytecode som iptables regler. Et nyt regel kan oprettes på for eksempel følgende måde: xt_bpfiptables -A INPUT -m bpf --bytecode -j LOG
iptables -A INPUT -m bpf --bytecode -j LOGher — det er koden i assembler-outputformatet bpf_asm som standard, for eksempel, $ cat /tmp/test.bpf ldb [9] jneq #17, ignore ret #1 ignore: ret #0$ bpf_asm /tmp/test.bpf 4,48 0 0 9,21 0 1 17,6 0 0 1,6 0 0 0,# iptables -A INPUT -m bpf --bytecode "$(bpf_asm /tmp/test.bpf)" -j LOG
$ cat /tmp/test.bpf
ldb [9]
jneq #17, ignore
ret #1
ignore: ret #0

$ bpf_asm /tmp/test.bpf
4,48 0 0 9,21 0 1 17,6 0 0 1,6 0 0 0,

# iptables -A INPUT -m bpf --bytecode "$(bpf_asm /tmp/test.bpf)" -j LOG
I dette eksempel filtrerer vi alle UDP-pakker. Konteksten for BPF-programmet i modulet xt_bpf, peger selvfølgelig på datapakken, i tilfælde af iptables — på starten af IPv4-headeren. Returneringsværdien fra BPF-programmet , hvor false betyder, at pakken ikke matchede.
Det er klart, at modulet xt_bpf understøtter mere komplekse filtre end i det ovennævnte eksempel. Lad os se på rigtige eksempler fra Cloudflare. Indtil for nylig brugte de modulet xt_bpf til beskyttelse mod DDoS-angreb. I artiklen fortæller de, hvordan (og hvorfor) de genererer BPF-filtre og offentliggør links til et sæt værktøjer til at oprette sådanne filtre. For eksempel kan man med værktøjet bpfgen oprette et BPF-program, der matcher DNS-forespørgselen til navnet habr.com:
$ ./bpfgen --assembly dns -- habr.com
ldx 4*([0]&0xf)
ld #20
add x
tax

lb_0:
    ld [x + 0]
    jneq #0x04686162, lb_1
    ld [x + 4]
    jneq #0x7203636f, lb_1
    ldh [x + 8]
    jneq #0x6d00, lb_1
    ret #65535

lb_1:
    ret #0
I programmet indlæser vi først X adressen på begyndelsen af strengen x04habrx03comx00 inden i UDP-datagrammet og tjekker derefter forespørgslen: 0x04686162 <-> "x04hab" osv.
Lidt senere offentliggjorde Cloudflare koden til kompileringsprogrammet p0f -> BPF. I artiklen forklarer de, hvad p0f er, og hvordan man konverterer p0f-signaturer til BPF:
$ ./bpfgen p0f -- 4:64:0:0:*,0::ack+:0
39,0 0 0 0,48 0 0 8,37 35 0 64,37 0 34 29,48 0 0 0,
84 0 0 15,21 0 31 5,48 0 0 9,21 0 29 6,40 0 0 6,
...
I øjeblikket bruger Cloudflare ikke længere xt_bpf, da de er flyttet til XDP — en af mulighederne for at bruge den nye version af BPF, se. .
cls_bpf
Den sidste af eksemplerne på brugen af klassisk BPF i kernen er en klassificerer cls_bpf til trafikstyringsundersystemet i Linux, tilføjet til Linux i slutningen af 2013 og konceptuelt erstattet den gamle cls_u32.
Vi vil dog ikke beskrive funktionaliteten nu, cls_bpfda det ikke vil give os noget i forhold til viden om klassisk BPF — vi har allerede lært hele funktionaliteten. Desuden vil vi i de efterfølgende artikler, der beskriver Extended BPF, ofte møde denne klassificerer.
En anden grund til ikke at tale om brugen af klassisk BPF c cls_bpf er, at i forhold til Extended BPF er anvendelsesområdet radikalt indsnævret: klassiske programmer kan ikke ændre indholdet af pakker og kan ikke bevare tilstand mellem opkald.
Så det er tid til at tage afsked med klassisk BPF og kigge ind i fremtiden.
Farvel til klassisk BPF
Vi har set på, hvordan BPF-teknologien, der blev udviklet i begyndelsen af 90'erne, har overlevet et kvart århundrede og fortsat har fundet nye anvendelser. Men ligesom overgangen fra stakmaskiner til RISC, der var drivkraften bag udviklingen af klassisk BPF, skete der i 2000'erne en overgang fra 32-bit til 64-bit maskiner, og klassisk BPF begyndte at blive forældet. Desuden er mulighederne for klassisk BPF stærkt begrænsede, og udover den forældede arkitektur - har vi ikke mulighed for at gemme tilstand mellem opkald af BPF-programmer, ingen mulighed for direkte interaktion med brugeren, og ingen mulighed for interaktion med kernerne, bortset fra at læse et begrænset antal felter i strukturen. sk_buff og køre de enkleste hjælpesfunktioner, kan ikke ændre indholdet af pakker og omdirigere dem.
Faktisk er der i øjeblikket kun API-grænsefladen fra klassisk BPF tilbage i Linux, og inden i kernen bliver alle klassiske programmer, hvad enten det er socket-filtre eller seccomp-filtre, automatisk oversat til det nye format, Extended BPF. (Vi vil forklare, hvordan dette præcist foregår i den næste artikel.)
Overgangen til den nye arkitektur begyndte i 2013, da Aleksey Starovoitov foreslog en opdateringsplan for BPF. I 2014 begyndte de relevante patches i kernen. Så vidt jeg forstår, var det oprindeligt kun planlagt at optimere arkitekturen og JIT-kompilatoren for en mere effektiv drift på 64-bit maskiner, men i stedet lagde disse optimeringer grundlaget for et nyt kapitel i udviklingen af Linux.
De følgende artikler i denne serie vil fortælle om arkitekturen og anvendelserne af den nye teknologi, oprindeligt kendt som internal BPF, derefter extended BPF, og nu bare BPF.
Links
- Steven McCanne og Van Jacobson, "The BSD Packet Filter: A New Architecture for User-level Packet Capture",
https://www.tcpdump.org/papers/bpf-usenix93.pdf - Steven McCanne, "libpcap: An Architecture and Optimization Methodology for Packet Capture",
https://sharkfestus.wireshark.org/sharkfest.11/presentations/McCanne-Sharkfest'11_Keynote_Address.pdf tcpdump,libpcap:- .
- BPF — den glemte bytekode:
https://blog.cloudflare.com/bpf-the-forgotten-bytecode/ - Introduktion til BPF-værktøjet:
https://blog.cloudflare.com/introducing-the-bpf-tools/ bpf_cls:http://man7.org/linux/man-pages/man8/tc-bpf.8.html- En oversigt over seccomp:
https://lwn.net/Articles/656307/ https://github.com/torvalds/linux/blob/master/Documentation/userspace-api/seccomp_filter.rst- Paul Chaignon, "strace — seccomp-bpf: et kig under motorhjelmen",
https://fosdem.org/2020/schedule/event/debugging_strace_bpf/ netsniff-ng:http://netsniff-ng.org/
Kilde: habr.com
