

En af de typiske scenarier i alle de velkendte applikationer er at søge data baseret på bestemte kriterier og vise dem i en letlæselig form. Her kan der også være ekstra muligheder for sortering, gruppering og paginering. Opgaven er, i teorien, triviel, men mange udviklere begår en række fejl i løsningen af den, hvilket påvirker ydeevnen. Lad os se på forskellige løsninger på denne opgave og formulere anbefalinger til valg af den mest effektive implementation.
Paginering #1
Den enkleste mulighed, der falder en ind, er at vise søgeresultaterne side-for-side i den mest klassiske form.
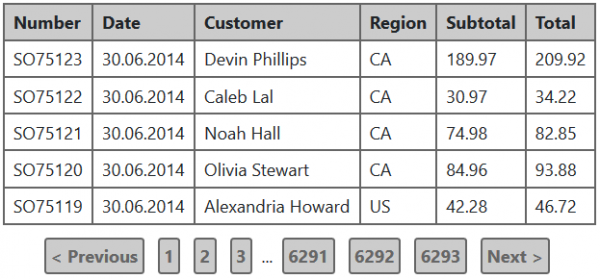
Lad os antage, at der anvendes en relationel database i applikationen. I så fald skal der udføres to SQL-forespørgsler for at vise informationen i denne form:
- Hente rækkerne til den aktuelle side.
- Tælle det samlede antal rækker, der opfylder søgekriterierne — dette er nødvendigt for at vise siderne.
Lad os se på den første forespørgsel ved hjælp af en test MS SQL database til server 2016. Til dette formål vil vi anvende tabellen Sales.SalesOrderHeader:
SELECT * FROM Sales.SalesOrderHeader
ORDER BY OrderDate DESC
OFFSET 0 ROWS
FETCH NEXT 50 ROWS ONLY
Den ovenstående forespørgsel vil returnere de første 50 ordrer fra listen, sorteret efter faldende tilføjelsesdato, med andre ord — de 50 seneste ordrer.
Den kører hurtigt på testdatabasen, men lad os se på udførelsesplanen og input-output statistikkerne:
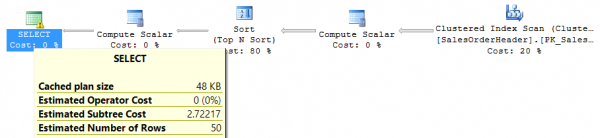
Tabel 'SalesOrderHeader'. Scan count 1, logical reads 698, physical reads 0, read-ahead reads 0, lob logical reads 0, lob physical reads 0, lob read-ahead reads 0.For at få input/output statistikker for hver forespørgsel kan man udføre kommandoen SET STATISTICS IO ON i spørringsudførelsesmiljøet.
Som det fremgår af udførelsesplanen, er den mest ressourcekrævende del sorteringen af alle rækkerne i den originale tabel efter tilføjelsesdato. Problemet er, at jo flere rækker der kommer i tabellen, jo 'tungere' vil sorteringen blive. I praksis bør sådanne situationer undgås, så lad os tilføje et indeks på tilføjelsesdatoen og se, om ressourceforbruget ændrer sig:
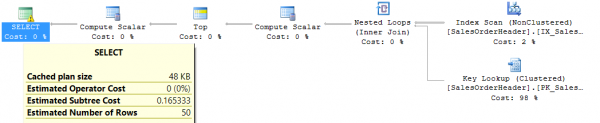
Tabel 'SalesOrderHeader'. Scan count 1, logical reads 165, physical reads 0, read-ahead reads 5, lob logical reads 0, lob physical reads 0, lob read-ahead reads 0.
Det er tydeligt, at det er blevet meget bedre. Men er alle problemer løst? Lad os ændre forespørgslen til at søge efter ordrer, hvor den samlede vareværdi overstiger 100 dollars:
SELECT * FROM Sales.SalesOrderHeader
WHERE SubTotal > 100
ORDER BY OrderDate DESC
OFFSET 0 ROWS
FETCH NEXT 50 ROWS ONLY
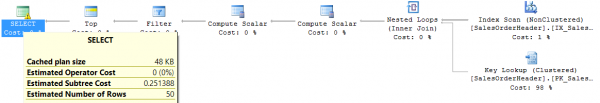
Tabel 'SalesOrderHeader'. Scan tælling 1, logiske læsninger 1081, fysiske læsninger 0, læsninger på forhånd 0, lob logiske læsninger 0, lob fysiske læsninger 0, lob læsninger på forhånd 0.Vi har en sjov situation: forespørgslen er ikke meget dårligere end den tidligere, men det faktiske antal logiske læsninger er næsten det dobbelte af, hvad det ville være ved en fuld scanning af tabellen. Der er en løsning — hvis vi laver et sammensat indeks ud fra det eksisterende indeks og tilføjer den samlede pris på varer som det andet felt, får vi igen 165 logiske læsninger:
CREATE INDEX IX_SalesOrderHeader_OrderDate_SubTotal on Sales.SalesOrderHeader(OrderDate, SubTotal);
Denne serie af eksempler kan fortsætte meget længere, men der er to hovedpunkter, som jeg gerne vil uddybe her:
- Tilføjelsen af ethvert nyt kriterium eller sorteringsrækkefølge til forespørgslen kan have en betydelig indflydelse på hastigheden af dens udførelse.
- Men hvis vi kun har brug for at trække en del af dataene, snarere end alle resultater, der opfylder søgekriterierne — er der mange måder at optimere en sådan forespørgsel på.
Lad os nu gå videre til den anden forespørgsel, der blev nævnt i starten — den, der tæller antallet af poster, der opfylder søgekriteriet. Lad os tage det samme eksempel — at søge efter ordrer, der er dyrere end 100 dollars:
SELECT COUNT(1) FROM Sales.SalesOrderHeader
WHERE SubTotal > 100
Med det sammensatte indeks nævnt ovenfor, får vi:
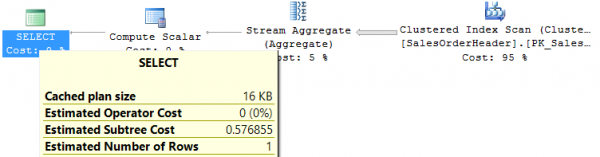
Tabel 'SalesOrderHeader'. Scan count 1, logical reads 698, physical reads 0, read-ahead reads 0, lob logical reads 0, lob physical reads 0, lob read-ahead reads 0.At forespørgslen går igennem hele indekset er ikke overraskende, da feltet SubTotal ikke står i første position, så forespørgslen kan ikke drage fordel af det. Problemet løses ved at tilføje et endnu et indeks på feltet SubTotal, som endelig giver os kun 48 logiske læsninger.
Man kan give flere eksempler på forespørgsler til optælling, men essensen forbliver den samme: at få en portion data og tælle det samlede antal — det er to grundlæggende forskellige forespørgsler, og hver kræver sine egne foranstaltninger til optimering. Generelt set vil det ikke være muligt at finde en kombination af indekser, der fungerer lige godt for begge forespørgsler.
Derfor er et af de vigtige krav, der skal afklares ved udviklingen af en sådan søgeløsning, om det faktisk er vigtigt for virksomheden at se det samlede antal fundne objekter. Ofte er det ikke tilfældet. Og navigation ved hjælp af specifikke sidetal er, efter min mening, et meget snævert anvendelsesområde, da de fleste scenarier med paging ser ud som "gå til næste side".
Paging mulighed #2
Antag, at brugerne ikke er interesseret i at vide det samlede antal fundne objekter. Lad os prøve at forenkle søgesiden:
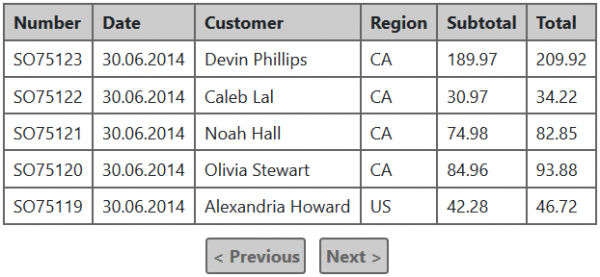
I realiteten er der kun ændret det, at der ikke er mulighed for at navigere til specifikke sidetal, og nu behøver denne tabel for visning ikke at vide, hvor mange sider der kan være i alt. Men spørgsmålet opstår — hvordan finder tabellen ud af, om der er data til den næste side (for korrekt at vise "Næste" linket)?
Svaret er meget simpelt: Man kan læse fra databasen en række mere, end nødvendigt for visning, og eksistensen af denne "ekstra" post vil vise, om der er en næste portion. På denne måde vil det kun kræve én forespørgsel for at få en post data, hvilket væsentligt forbedrer ydelsen og letter vedligeholdelsen af sådan funktionalitet. Jeg har i praksis haft en situation, hvor fraværet af at tælle det samlede antal poster accelererede resultatudgivelsen med 4-5 gange.
For denne tilgang er der flere muligheder for brugergrænsefladen: "tilbage" og "frem" knapper, som i eksemplet ovenfor, en "indlæs flere" knap, der simpelthen tilføjer en ny portion til de viste resultater, "uendelig rulle", som fungerer efter princippet om "indlæs flere", men signalet for at hente den næste portion er, at brugeren ruller til bunden af alle viste resultater. Uanset hvad den visuelle løsning er, forbliver princippet for dataudtagning det samme.
Nuancer ved implementering af paging
I alle de tidligere nævnte forespørgsler anvendes metoden "offset + antal", hvor der i selve forespørgslen angives, hvilken rækkefølge række resultatet skal starte fra og hvor mange rækker der skal returneres. Først vil vi se på, hvordan man bedst organiserer overførslen af parametre i dette tilfælde. I praksis har jeg set flere metoder:
- Den sekventielle nummer for den forespurgte side (pageIndex), side størrelse (pageSize).
- Den sekventielle nummer for den første post, der skal returneres (startIndex), det maksimale antal poster i resultatet (count).
- Den sekventielle nummer for den første post, der skal returneres (startIndex), den sekventielle nummer for den sidste post, der skal returneres (endIndex).
Ved første øjekast kan det virke så elementært, at der ikke er nogen forskel. Men det er ikke tilfældet — det mest bekvemme og alsidige valg er det andet (startIndex, count). Der er flere grunde til dette:
- For den tilgang med at trække +1 post, som nævnt ovenfor, er den første mulighed med pageIndex og pageSize ekstremt ubelejlig. For eksempel ønsker vi at vise 50 poster på en side. Ifølge den tidligere nævnte algoritme skal vi hente en post mere end nødvendigt. Hvis denne "+1" ikke er indregnet på serveren, skal vi for den første side anmode om poster fra 1 til 51, for den anden fra 51 til 101 osv. Hvis vi angiver side størrelsen til 51 og øger pageIndex, vil den anden side returnere fra 52 til 102 osv. Derfor er den eneste måde at implementere en knap til at gå til næste side ordentligt i første mulighed, at indregne en "overskydende" post på serveren, hvilket vil være en meget utydelig detalje.
- Den tredje mulighed giver overhovedet ikke mening, da der for at udføre forespørgsler i de fleste databaser stadig skal videregives antallet og ikke indekset for den sidste post. Lad os sige, at det at trække startIndex fra endIndex og en grundlæggende aritmetisk operation er simpelthen, men det er unødvendigt her.
Nu bør vi beskrive ulemperne ved at implementere paging via "offset + antal":
- At hente hver næste side vil være dyrere og langsommere end den forrige, fordi databasen stadig skal gå gennem alle poster "fra begyndelsen" i henhold til søge- og sorteringskriterierne, hvorefter den stopper ved det nødvendige segment.
- Ikke alle DBMS kan støtte denne tilgang.
Der er alternativer, men de er heller ikke perfekte. Den første af disse tilgange kaldes "keyset paging" eller "seek method" og går ud på følgende: efter at have modtaget et parti kan man huske værdierne for felterne i den sidste post på siden og derefter bruge dem til at få næste parti. For eksempel udførte vi en sådan forespørgsel:
SELECT * FROM Sales.SalesOrderHeader
ORDER BY OrderDate DESC
OFFSET 0 ROWS
FETCH NEXT 50 ROWS ONLY
Og i den seneste post fik vi værdien for bestillingsdatoen '2014-06-29'. Så for at hente den næste side kan vi prøve at udføre følgende:
SELECT * FROM Sales.SalesOrderHeader
WHERE OrderDate < '2014-06-29'
ORDER BY OrderDate DESC
OFFSET 0 ROWS
FETCH NEXT 50 ROWS ONLY
Problemet er, at OrderDate ikke er et unikt felt, og betingelsen angivet ovenfor vil sandsynligvis udelade mange nødvendige rækker. For at tilføje entydighed til denne forespørgsel skal der tilføjes et unikt felt til betingelsen (antag at 75074 er den sidste værdi af den primære nøgle fra den første batch):
SELECT * FROM Sales.SalesOrderHeader
WHERE (OrderDate = '2014-06-29' AND SalesOrderID < 75074)
   OR (OrderDate < '2014-06-29')
ORDER BY OrderDate DESC, SalesOrderID DESC
OFFSET 0 ROWS
FETCH NEXT 50 ROWS ONLY
Denne variant vil fungere korrekt, men generelt set vil det være svært at optimere den, da betingelsen indeholder operatoren OR. Hvis værdien af den primære nøgle stiger i takt med OrderDate, kan betingelsen forenkles ved kun at bevare filteret for SalesOrderID. Men hvis der ikke er en streng korrelation mellem værdierne af den primære nøgle og feltet, som resultaterne er sorteret efter, vil det ikke være muligt at undgå denne OR i de fleste DBMS. Et kendt undtagelse er PostgreSQL, hvor sammenligning af tuples understøttes fuldt ud, og den angivne betingelse kan skrives som "WHERE (OrderDate, SalesOrderID) < ('2014-06-29', 75074)". Med en sammensat nøgle med disse to felter bør en sådan forespørgsel være rimeligt let.
En anden alternativ tilgang kan ses for eksempel i eller — når forespørgslen udover data returnerer en særlig identifikator, som kan bruges til at hente den næste batch af data. Hvis denne identifikator har en ubegribelig levetid (som i Cosmos DB), så er det en fremragende måde at implementere paging med sekventiel overgang mellem sider (den nævnte variant #2 ovenfor). Dens mulige ulemper: understøttes ikke i alle DBMS; den opnåede identifikator for den næste batch kan have en begrænset levetid, hvilket generelt set ikke passer til implementeringen af brugerinteraktion (som f.eks. ElasticSearch scroll API).
Svær filtrering
Lad os komplicere opgaven yderligere. Antag, at der er krav om at implementere det såkaldte facetterede søgning, som mange er bekendt med fra internetbutikker. De tidligere nævnte eksempler baseret på bestillingstabellen er ikke særlig illustrative i dette tilfælde, så lad os skifte til Product-tabellen fra AdventureWorks-databasen:
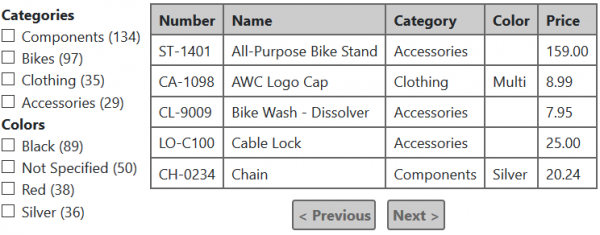
Hvad er ideen bag facetteret søgning? Det er, at for hver filterelement vises antallet af poster, der opfylder dette kriterium. under hensyntagen til de valgte filtre i alle andre kategorier..
For eksempel, hvis vi vælger kategorien Bikes og farven Black i dette eksempel, vil tabellen kun vise cykler i sort, men samtidig:
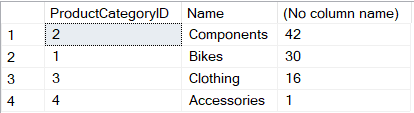
- For hver kriterie i gruppen 'Categories' vises antallet af produkter i denne kategori i sort.
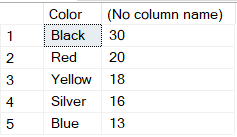
- For hver kriterie i gruppen 'Colors' vises antallet af cykler i denne farve.
Her er et eksempel på resultatet for sådanne betingelser:
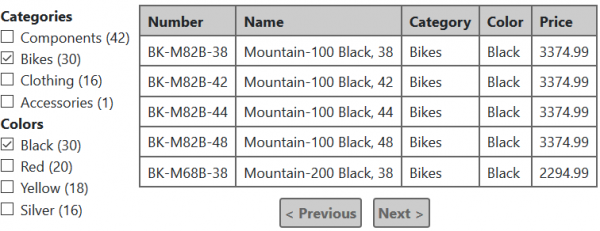
Hvis vi yderligere markerer kategorien 'Clothing', vil tabellen også vise tøj i sort, der er tilgængeligt. Antallet af produkter i sort i sektionen 'Color' vil også blive genberegnet i henhold til de nye betingelser, mens der ikke vil ske nogen ændringer i sektionen 'Categories'... Jeg håber, at disse eksempler er tilstrækkelige til at forstå den velkendte algoritme bag facetteret søgning.
Lad os nu forestille os, hvordan dette kan implementeres i en relationel database. Hver kriteriegruppe, såsom Category og Color, vil kræve en separat forespørgsel:
SELECT pc.ProductCategoryID, pc.Name, COUNT(1) FROM Production.Product p
  INNER JOIN Production.ProductSubcategory ps ON p.ProductSubcategoryID = ps.ProductSubcategoryID
  INNER JOIN Production.ProductCategory pc ON ps.ProductCategoryID = pc.ProductCategoryID
WHERE p.Color = 'Black'
GROUP BY pc.ProductCategoryID, pc.Name
ORDER BY COUNT(1) DESC
SELECT Color, COUNT(1) FROM Production.Product p
  INNER JOIN Production.ProductSubcategory ps ON p.ProductSubcategoryID = ps.ProductSubcategoryID
WHERE ps.ProductCategoryID = 1 --Bikes
GROUP BY Color
ORDER BY COUNT(1) DESC
Hvad er galt med denne løsning? Det er meget simpelt — den skalerer dårligt. Hver filtersektion kræver en separat forespørgsel for at tælle mængderne, og disse forespørgsler er ikke de letteste. I internetbutikker kan der i nogle kategorier være flere dusin filtersektioner, hvilket kan vise sig at være et seriøst problem for ydeevnen.
Normalt efter disse udsagn bliver jeg præsenteret for nogle løsninger, nemlig:
- Flet alle antalberegninger i én forespørgsel. Teknisk set er dette muligt ved hjælp af nøgleordet UNION, men det vil ikke gøre meget for ydeevnen – databasen skal stadig udføre hver af fragmenterne "fra bunden".
- Cache antal. Dette bliver i det væsentlige foreslået hver gang, jeg beskriver problemet. Det er dog generelt set umuligt. Antag, at vi har 10 "facetter", hvor hver har 5 værdier. Dette er en meget "beskedne" situation i forhold til, hvad man kan se i de samme webshops. Valget af et enkelt facettelement påvirker antallet i de 9 andre; med andre ord kan antallet variere for hver kombination af kriterier. I vores eksempel er der i alt 50 kriterier, som brugeren kan vælge, hvilket fører til 250 mulige kombinationer. At udfylde et sådant datastørrelse vil ikke være muligt med hverken hukommelse eller tid. Man kunne indvende, at ikke alle kombinationer er realistiske, og brugeren vælger sjældent mere end 5-10 kriterier. Ja, man kan implementere lazy loading og cachen antal kun for det, der nogensinde er blevet valgt, men jo flere valgmuligheder der er, desto mindre effektiv vil den cache være, og jo mere udtalte problemer med responstider vil der være (især hvis datasættet ændres regelmæssigt).
Heldigvis har denne type opgave længe haft tilstrækkeligt effektive løsninger, der fungerer forudsigeligt på store datamængder. For hver af disse muligheder giver det mening at opdele genberegning af facetter og hentning af resultatsiden i to parallelle anmodninger til serveren og organisere brugergrænsefladen på en måde, så datalæsning af facetter "ikke forstyrrer" visningen af søgeresultaterne.
- Kald for en fuld genberegning af "facetter" så sjældent som muligt. For eksempel, genberegn ikke alt ved hver ændring af søgekriterier, men find i stedet det samlede antal resultater, der stemmer overens med de nuværende betingelser, og tilbyd brugeren at vise dem — "1425 poster fundet, vise?" Brugeren kan enten fortsætte med at ændre søgebetingelserne eller trykke på knappen "vis". Kun i det andet tilfælde vil alle forespørgsler til at hente resultater og genberegning af antal på alle "facetter" blive udført. Det er ikke svært at bemærke, at man skal håndtere forespørgslen om at få det samlede antal resultater og optimere det. Denne metode kan ses i mange små webshops. Det er tydeligt, at det ikke er en universalløsning på dette problem, men i simple tilfælde kan det være et rimeligt kompromis.
- Brug en søgemaskine til at finde resultater og tælle facetter, såsom Solr, ElasticSearch, Sphinx og andre. Alle disse er designet til at opbygge "facetter" og gør det ret effektivt på grund af det inverterede indeks. Hvordan søgemaskiner fungerer, hvorfor de i sådanne tilfælde er mere effektive end generiske databaser, hvilke praksisser og faldgruber der findes — det er emnet for en separat artikel. Her vil jeg dog påpege, at en søgemaskine ikke kan erstatte det primære datalager, men bruges som et supplement: alle ændringer i den primære database, som er relevante for søgningen, synkroniseres i søgeindekset; søgemekanismen interagerer normalt kun med søgemaskinen og henvender sig ikke til den primære database. Et af de vigtigste punkter her er, hvordan man organiserer denne synkronisering pålideligt. Det hele afhænger af kravene til "reaktionstid". Hvis tiden mellem ændringen i den primære database og dens "manifestation" i søgningen ikke er kritisk, kan man lave en service, der hver par minutter søger efter nyligt ændrede poster og indekserer dem. Hvis den mindst mulige reaktionstid er nødvendig, kan man implementere noget som til at sende opdateringer til søgetjenesten.
Konklusioner
- Implementeringen af paging på serversiden er en alvorlig kompleksitet, og det giver kun mening at anvende det for hurtigt voksende eller bare store datamængder. Hvordan man vurderer, hvad der er "stort" eller "hurtigt voksende" — der er ingen absolut præcis opskrift, men jeg ville følge denne tilgang:
- Hvis det at hente den fulde datakollektion under hensyntagen til serverens behandlingstid og netværksoverførsel normalt holder sig inden for ydeevnekravene, giver det ikke mening at implementere paging på serversiden.
- Der kan være situationer, hvor der i den nærmeste fremtid ikke er forventet problemer med ydeevnen, da der er få data, men datakollektionen vokser konstant. Hvis en bestemt datamængde i perspektiv potentielt kan stoppe med at opfylde det forrige punkt — er det bedre at inkludere paging fra starten.
- Hvis der fra forretningens side ikke er et strengt krav til at vise det samlede antal resultater eller til at vise sidetallene, og samtidig er der ikke en søgemaskine i dit system — er det bedre ikke at implementere disse ting og overveje mulighed #2.
- Hvis der er et klart krav om faceteret søgning, har du to muligheder for ikke at gå på kompromis med ydeevnen:
- Ikke at genberegne alle antal ved hver ændring af søgekriterierne.
- Brug søgemaskiner som Solr, ElasticSearch, Sphinx og andre. Men det skal forstås, at det ikke kan erstatte den primære database og skal bruges som et supplement til det primære lager til at løse søgeopgaver.
- Desuden giver det også mening i tilfælde af faceteret søgning at opdele modtagelsen af resultatsiden og antalsberegningen i to parallelle forespørgsler. Antalsberegningen kan tage længere tid end at hente resultaterne, mens resultaterne er vigtigere for brugeren.
- Hvis du bruger en SQL-database til søgning, skal enhver kodeændring relateret til denne del testes grundigt med hensyn til ydeevne på det relevante datavolumen (der overstiger volumen i den "live" database). Det anbefales også at bruge overvågning af forespørgslernes behandlingstid på alle databaser, og især — på den "live". Selv hvis alt var godt i udviklingsfasen med forespørgselsplanerne, kan situationen ændre sig mærkbart med stigende datavolumen.
Kilde: habr.com
