

I dag vil jeg tale om en interessant teknologi, der er implementeret i lagersystemet Unity/Unity XT - FAST VP. Hvis du hører om Unity for første gang, kan du finde oplysninger om systemets specifikationer i linket i slutningen af artiklen. I projektteamet hos Dell EMC arbejdede jeg med FAST VP i mere end et år. I dag vil jeg gerne fortælle mere om denne teknologi og afsløre nogle detaljer om dens implementering. Selvfølgelig kun de, der må offentliggøres. Hvis du er interesseret i effektive datalagring eller bare ikke helt har forstået dokumentationen, vil denne artikel helt sikkert være nyttig og interessant.
Jeg vil starte med at sige, hvad der ikke vil være i materialet. Der vil ikke være nogen søgning på konkurrenter og sammenligning med dem. Jeg planlægger heller ikke at fortælle om lignende teknologier fra open source, fordi den nysgerrige læser allerede ved om dem. Og selvfølgelig har jeg ikke tænkt mig at reklamere for noget.
Storage Tiering. Mål og opgaver for FAST VP
FAST VP står for Fully Automated Storage Tiering for Virtual Pool. Kompliceret? Intet problem, vi skal nok finde ud af det. Tiering er en måde at organisere datalagring på, hvor der er flere niveauer (tiers), hvor disse data gemmes. Hvert niveau har sine egne egenskaber. De vigtigste er: ydeevne, kapacitet og pris for opbevaring af én enhed information. Selvfølgelig er der en sammenhæng mellem dem.
En vigtig egenskab ved tiering er, at adgangen til dataene er ensartet, uanset hvilket niveau af opbevaring de befinder sig på, og størrelsen på puljen svarer til summen af størrelserne af de ressourcer, der indgår i den. Her ligger forskellene fra cachen: størrelsen på cachen tilføjes ikke til den samlede størrelse af ressourcen (puljen i dette tilfælde), og dataene i cachen dublere et fragment af data fra det primære medie (eller vil dublere, hvis dataene fra cachen endnu ikke er skrevet). Desuden er fordelingen af data på niveauer skjult for brugeren. Det vil sige, at han ikke kan se, hvilke specifikke data der er placeret på hvert niveau, selvom han kan påvirke dette indirekte ved at angive politikker (om dem senere).
Lad os nu se på, hvordan storage tiering er implementeret i Unity. I Unity er der 3 niveauer, eller tier,:
- Extreme performance (SSDs)
- Performance (SAS HDD 10k/15k RPM)
- Capacity (NL-SAS HDD 7200 RPM)
De præsenteres i rækkefølge efter faldende ydeevne og pris. I Extreme performance indgår udelukkende solid state-drev (SSD). I de to andre tiers – drev med magnetiske plader, der adskiller sig ved rotationshastighed og dermed ydeevne.
Lagringsmedier af samme niveau og størrelse samles i et RAID-array, der danner en RAID-gruppe (RAID group, kort sagt – RG); om de tilgængelige og anbefalede RAID-niveauer kan du læse i den officielle dokumentation. Fra RAID-grupper af et eller flere niveauer dannes lagringspuljer (Storage pool), hvorfra den ledige plads derefter fordeles. Fra puljen tildeles plads til filsystemer og LUN’er.
Hvorfor har jeg brug for tiering?
Hvis jeg skal gøre det kort og abstrakt: for at opnå et bedre resultat med minimum ressourcer. Hvis vi ser mere konkret på det, så forstås resultatet normalt som en kombination af karakteristika for lagringssystemet – hastighed og adgangstid, omkostninger til opbevaring og så videre. Minimum ressourcer refererer til de laveste udgifter: penge, energi osv. FAST VP implementerer netop mekanismer til omfordeling af data på forskellige niveauer i Unity/Unity XT lagringssystemet. Hvis du stoler på mig, kan du springe næste afsnit over. For resten vil jeg forklare lidt mere.
Korrekt fordeling af data på lagringsniveauer kan reducere de samlede omkostninger til lagringssystemet ved at ofre adganghastigheden til noget sjældent anvendt information og forbedre ydeevnen ved at flytte ofte anvendte data til hurtigere medie. Nogen kunne indvende, at en normal administrator også kender til at placere data korrekt uden tiering, hvilke karakteristika der er ønskelige for sit lagringssystem m.m. Det er uden tvivl sandt, men manuel datafordeling har sine ulemper:
- det kræver tid og opmærksomhed fra administratoren;
- det er ikke altid muligt at 'omskære' ressourcerne i lagringssystemet til ændrede betingelser;
- et vigtigt fordel forsvinder: en ensartet adgang til ressourcer, der findes på forskellige lagringsniveauer.
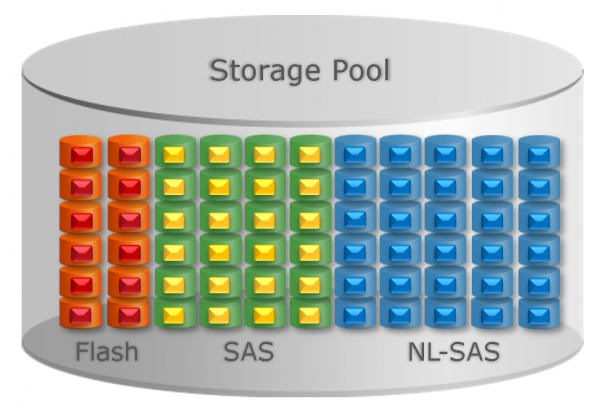
For storage admins to worry less about job security, I should add that proper resource planning is also necessary here. Now that the tiering tasks have been briefly outlined, let's look at what can be expected from FAST VP. This is the perfect time to return to the definition. The first two words – Fully Automated – literally translate to "fuldt automatiseret" and mean that tiering occurs automatically. Virtual Pool refers to a pool of data that includes resources from different storage tiers. Here’s how it looks:
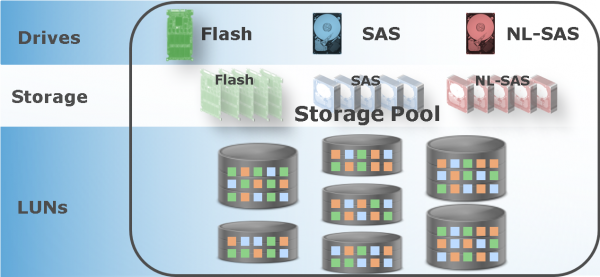
To get ahead of myself, I’ll say that FAST VP moves data only within one pool, not between multiple pools.
Tasks addressed by FAST VP
Let’s start abstractly. We have a pool and some mechanism that can redistribute data within this pool. Keeping in mind that our goal is to achieve maximum performance, let’s ask ourselves: what methods can achieve this? There may be several, and FAST VP has much to offer the user, as the technology is more than just storage tiering. Here are the ways FAST VP can enhance the performance of the pool:
- Distributing data across different types of disks and tiers
- Distributing data among disks of the same type
- Distributing data during pool expansion
Before addressing how these tasks are solved, we need to know some necessary facts about the operation of FAST VP. FAST VP operates on blocks of a certain size – 256 megabytes. This is the minimum continuous "piece" of data that can be moved. In the documentation, it is referred to as a slice. From FAST VP’s perspective, all RAID groups are made up of such "pieces." Accordingly, all input-output statistics are accumulated for these data blocks. Why is this particular block size chosen, and will it be reduced? The block is quite large, but this is a compromise between data granularity (a smaller block size leads to more precise distribution) and available computing resources: given the current strict limits on RAM and the large number of blocks, the data statistics can take up too much space, and the number of calculations will increase proportionally.
How FAST VP places data in the pool. Policies
For managing data placement in a pool with FAST VP enabled, there are the following policies:
- Højeste tilgængelige niveau
- Auto-Tier
- Start høj og derefter Auto-Tier (standard)
- Laveste tilgængelige niveau
De påvirker både den oprindelige placering af blokken (dataene er først blevet skrevet) og den efterfølgende omfordeling. Når dataene allerede er placeret på diske, vil omfordelingen blive initieret efter en tidsplan eller manuelt.
Højeste tilgængelige niveau forsøger at placere en ny blok på det mest præsterende niveau. Hvis der ikke er plads til det, placeres den på det næste niveau efter præstation, men dataene kan derefter flyttes til et mere præsterende niveau (hvis der er plads eller ved at skubbe andre data væk). Auto-Tier placerer nye data på forskellige niveauer afhængigt af størrelsen på det tilgængelige plads, og de omfordeles baseret på efterspørgslen og den ledige plads. Start høj og derefter Auto-Tier – er standardpolitikken og også den anbefalede. Ved den oprindelige placering fungerer den som Højeste tilgængelige niveau, hvorefter data flyttes afhængigt af deres brugsstatistik. Politikken Laveste tilgængelige niveau stræber efter at placere data på det mindst præsterende niveau.
Dataflytning sker med lav prioritet for ikke at forstyrre det nyttige arbejde i SAN, men der er en indstilling "Data relocation rate", som ændrer prioriteten. Her er der en særlig egenskab: ikke alle datablokke har samme rækkefølge til omfordeling. For eksempel vil blokke, der er markeret som metadata, blive flyttet til et hurtigere niveau først. Metadata er, for at sige det mildt, "data om data", en slags supplerende information, der ikke er brugerdata, men opbevarer deres beskrivelse. For eksempel information i filsystemet om, hvilken blok en specifik fil er i. Det betyder, at adgangen til data afhænger af adgangen til metadata. Da metadata normalt er meget mindre i størrelse, forventes gevinsten ved at flytte dem til mere præsterende diske at være større.
Kriterierne, som Fast VP bruger i sit arbejde
Hovedkriteriet for hver blok, groft sagt, er karakteristikken af "efterspørgslen" efter data, som afhænger af antallet af læse- og skriveoperationer af datablokken. Denne karakteristik kalder vi "Temperatur". Der er efterspurgte (hot) data, som er "varmere" end uefterspurgte. Den beregnes periodisk, som standard med et interval på en time.
Funktionen til beregning af temperatur har følgende egenskaber:
- I mangel af input/output aftager data over tid.
- Ved nogenlunde ensartet belastning over tid stiger temperaturen først og stabiliseres derefter inden for et bestemt interval.
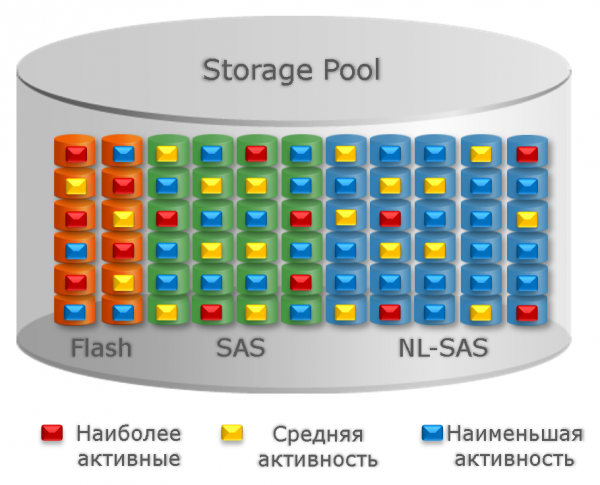
Dernæst tages de politikker, der er beskrevet ovenfor, samt den ledige plads på hver tier i betragtning. For illustrationen vil jeg bringe et billede fra dokumentationen. Her er blokke med høj, middel og lav temperatur markeret med rød, gul og blå farve henholdsvis.
Men lad os vende tilbage til opgaverne. Så, vi kan begynde at analysere, hvad der gøres for at løse FAST VP-opgaverne.
A. Fordeling af data på forskellige typer diske, niveauer
Dette er faktisk hovedopgaven i FAST VP. De andre opgaver er i nogen grad afledte af denne. Afhængigt af den valgte politik fordeles dataene på forskellige lagringsniveauer. Først tages politikken for placering i betragtning, derefter temperaturen på blokkene og størrelsen/hastigheden af RAID-grupperne.
For politikkerne Højeste/ laveste tilgængelige tier er det ret enkelt. For de to andre er situationen sådan. Data distribueres på de forskellige niveauer under hensyntagen til størrelsen og ydeevnen af RAID-grupperne: således at forholdet mellem den samlede "temperatur" af blokkene og den "betingede maksimale ydeevne" af hver RAID-gruppe er nogenlunde det samme. På den måde fordeles belastningen mere eller mindre jævnt. Mere efterspurgte data flyttes til hurtigere medier, sjældent anvendte – til langsommere. Ideelt set bør fordelingen være cirka sådan her:
B. Fordeling af data blandt diske af samme type
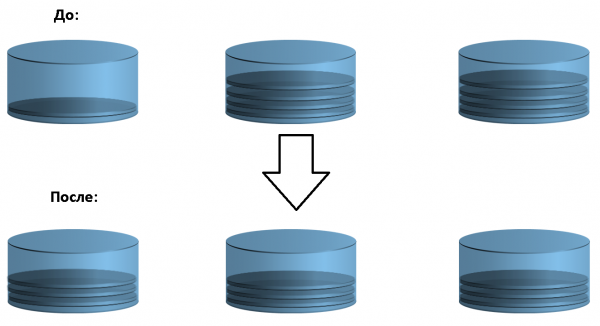
Husk, i starten skrev jeg, at informationsmedierne fra én eller flere Hvordan kombineres niveauerne til én pulje? For et enkelt niveau er der også arbejde for FAST VP. For at yde maksimal præstation for et niveau er det ønskeligt at fordele dataene jævnt mellem drevene. Dette vil i teorien give det maksimale antal IOPS. Dataene inden for RAID-gruppen kan betragtes som fordelt jævnt over drevene, mens det ikke nødvendigvis gælder mellem RAID-grupperne. I tilfælde af ubalance vil FAST VP flytte data mellem RAID-grupperne i forhold til deres størrelse og "betingede præstation" (i numeriske udtryk). For tydelighed vil jeg vise et rebalance-diagram blandt tre RAID-grupper:
B. Datafordeling ved udvidelse af puljen
Denne opgave er et specialtilfælde af den foregående og udføres, når der tilføjes en RAID-gruppe til puljen. For at den nytilføjede RAID-gruppe ikke skal stå ubenyttet, vil en del af dataene blive flyttet til den, hvilket betyder, at belastningen på alle RAID-grupper vil blive omfordelt.
SSD-slidudjævning
Ved hjælp af slidudjævning kan FAST VP forlænge levetiden for SSD'er, selvom denne funktion ikke direkte relaterer til Storage Tiering. Da temperaturdata allerede er tilgængelige, tages der også hensyn til antallet af skriveoperationer, vi kan flytte datablokke, så det ville være logisk for FAST VP at løse denne opgave.
Hvis antallet af skrivninger til én RAID-gruppe er betydeligt højere end antallet af skrivninger til en anden, vil FAST VP omfordele dataene i overensstemmelse med antallet af skriveoperationer. På den ene side aflaster det nogle drev og bevarer ressourcen, mens det på den anden side øger "arbejdet" for de mindre belastede og forbedrer den samlede ydeevne.
Derfor tager FAST VP traditionelt ansvar for Storage Tiering-opgaver og gør lidt mere end det. Alt dette muliggør en ret effektiv datalagring i Unity-familien af storage-systemer.
Flere tips
- Forsøm ikke at læse dokumentationen. Der er best practices, og de fungerer ganske godt. Hvis man følger dem, opstår der typisk ikke alvorlige problemer. De øvrige råd gentager eller supplerer dem hovedsageligt.
- Hvis du har konfigureret og aktiveret FAST VP, er det bedst at lade det være tændt. Lad det fordele data i det afsatte tidsrum og gradvist, frem for en gang om året, hvilket vil have en alvorlig indvirkning på ydeevnen af andre opgaver. I sådanne tilfælde kan omfordelingen af data tage lang tid.
- Vær omhyggelig med valget af vinduet for relokering. Selvom det er åbenlyst, så prøv at vælge et tidspunkt med den mindste belastning på Unity og afsæt tilstrækkelig tid.
- Planlæg udvidelsen af SAN’en, gør det i tide. Dette er en generel anbefaling, som også er vigtig for FAST VP. Hvis mængden af ledig plads er meget lille, vil flytningen af data blive langsommere eller umulig. Især hvis du har negligeret punkt 2.
- Når du udvider puljen med FAST VP aktiveret, bør du ikke starte med de langsomste diske. Det vil sige, at vi enten tilføjer alle planlagte RAID-grupper på én gang, eller først tilføjer de hurtigste diske. I dette tilfælde vil omfordelingen af data til de nye 'hurtige' diske øge den samlede hastighed af puljen. Ellers, hvis du begynder med 'langsomme' diske, kan du få en meget ubehagelig situation. Først vil dataene blive overført til de nye, relativt langsomme diske, og derefter, når hurtigere diske tilføjes, vil det gå i modsat retning. Der er nuancer relateret til forskellige politikker for FAST VP, men generelt er en sådan situation mulig.
Hvis du overvejer dette produkt, kan du prøve Unity gratis ved at downloade Unity VSA virtual appliance.
Afslutningsvis deler jeg nogle nyttige links:
- Side
- – en kort beskrivelse af funktionen
- , pdf-format
Konklusion
Jeg har lyst til at skrive om meget, men jeg forstår, at ikke alle detaljer vil interessere læseren. For eksempel kan man skrive mere om de kriterier, som FAST VP baserer sine beslutninger om dataflytning på, samt om processerne for at analysere input-output statistik. Emnet om interaktion med , som kunne have en egen artikel. Man kan endda spekulere på udviklingen af denne teknologi. Jeg håber, det ikke var kedeligt, og jeg ikke har trættet dig. Vi ses næste gang!
Kilde: habr.com
