

Forklarende ord fra oversætteren
Materialet interesserede mig først og fremmest på grund af tabellen nedenfor:
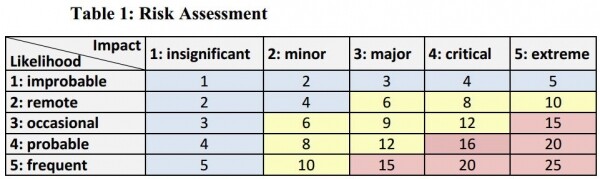
Når man tager i betragtning, at statistikere (og russiske, på genetisk niveau) mildt sagt ikke bryder sig om alt, hvad der afviger fra en lineær afhængighed, har disse fyre formået at implementere brugen af en aktiveringsfunktion i parabolisk form til at bestemme graden af risiko ved at anvende Big Data i officiel statistik. Dygtigt. Selvfølgelig tilføjede statistikerne deres bemærkning til dette arbejde - «1 Enhver fejl og udeladelse er forfatternes enekompetence. De meninger, der udtrykkes i dette dokument, er personlige og afspejler ikke nødvendigvis den officielle holdning fra Den Europæiske Kommission». Men arbejdet blev offentliggjort. Jeg mener, at det er nok for nu, og de (forfatterne) har ikke forbudt nogen at finde deres skalaer inden for disse aspekter.
I arbejdet er det ret struktureret muligt at dele, hvor og hvordan statistiske metoder adskiller sig fra forskningsmetoder for Big Data. Efter min mening vil den største fordel ved dette arbejde komme i samtalen med kunden og til at tilbagevise hans udsagn som:
— Jamen, vi indsamler selv statistikken, hvad mere vil du undersøge?
— Og få nu præsenteret jeres resultater, så vi kan sammenligne dem med vores statistik. I denne henseende siger forfatterne, at det vil være godt at læse arbejdet (3 )
I dette arbejde har forfatterne angivet deres syn på risikoniveauet. Denne parameter er angivet i parentes, og skal ikke blandes sammen med kildehenvisninger.
En anden observation. Forfatterne bruger termen BDS – det er et alternativ til begrebet Big Data. (tilsyneladende en henvisning til officiel statistik).
Forfatternes forklaring
Et voksende antal statistikadministrationer undersøger muligheden for at anvende store datakilder til at forberede officiel statistik. På nuværende tidspunkt er der kun få eksempler på, at disse kilder er blevet fuldt integreret i den faktiske statistiske produktion. Derfor er den fulde grad af konsekvenserne ved deres integration endnu ikke klart defineret. I mellemtiden er der taget de første skridt til at analysere betingelserne og virkningen af store data på forskellige aspekter af statistisk produktion, såsom kvalitet eller metodologi. For nylig har en arbejdsgruppe udviklet et kvalitetsgrundlag for forberedelse af statistiske data baseret på store data i konteksten af et stort data-projekt under Den Europæiske Økonomiske Kommission for De Forenede Nationer (UNECE). I henhold til den europæiske statistiske kodeks for god praksis er det en hovedopgave for statistikadministrationer at levere høj kvalitet statistisk information. Da risiko defineres som indflydelse af usikkerhed på mål (f.eks. den internationale standardiseringsorganisation ISO 31000), fandt vi det hensigtsmæssigt at kategorisere risici i henhold til de kvalitetsdimensioner, de påvirker.
Den foreslåede struktur for kvaliteten af statistiske data, der stammer fra store datakilder, giver en struktureret fremstilling af kvaliteten i forbindelse med alle faser af den statistiske forretningsproces og kan således danne grundlag for en omfattende vurdering og styring af risici relateret til disse nye datakilder. Den introducerer nye kvalitetsdimensioner, der er specifikke for eller (af høj betydning når) brugen af store data til officiel statistik, såsom den institutionelle/forretningsmæssige kontekst eller kompleksitet. Ved at bruge disse nye kvalitetsdimensioner kan man mere systematisk identificere de risici, der er forbundet med brugen af store datakilder i officiel statistik.
I dette arbejde stræber vi efter at identificere de risici, der opstår ved brugen af big data i konteksten af officiel statistik. Vi følger en systematisk tilgang til at definere risici inden for den foreslåede kvalitetsramme. Ved at fokusere på de nyligt foreslåede målinger af kvalitet kan vi beskrive risici, der i øjeblikket er fraværende eller ikke påvirker produktionen af officiel statistik. Samtidig kan vi identificere nuværende risici, der vil blive vurderet helt anderledes ved brugen af big data til at generere statistik. Derefter går vi videre i risikostyringscyklussen og giver en vurdering af sandsynligheden for og virkningen af disse risici. Da risikovurdering indebærer subjektivitet i deres attribution af sandsynlighed og indflydelse på forskellige risici, måler vi enigheden blandt dusinvis af forskellige interessenter, der leveres uafhængigt. Derefter foreslår vi muligheder for at reducere disse risici i overensstemmelse med fire primære kategorier: undgåelse, reduktion, deling og fastholdelse. Ifølge ISO bør et af principperne for risikostyring være værdiskabelse, dvs. ressourcer til at reducere risici skal være lavere end ved at lade være. I overensstemmelse med dette princip vil vi endelig foretage en vurdering af den mulige indflydelse af nogle risikoreduktionsforanstaltninger på kvaliteten af de endelige resultater for at komme til en mere omfattende vurdering af brugen af Big Data til officiel statistik.
1. Introduktion
1.1. Baggrund
Udviklingen af "big data" blev karakteriseret af Kenneth Neil Cukier og Viktor Mayer-Schönberger i deres artikel "Væksten af big data" (2. ) termen "datafication". Datafication beskrives som en proces med at "tage alle aspekter af livet og omdanne dem til data". For eksempel. Facebook tilbyder personlige netværk, sensorer til alle slags miljøforhold, smartphones til personlig kommunikation og bevægelse, bærbare data til personlige forhold. Dette fører til næsten universel indsamling og tilgængelighed af data.
Som i mange andre sektorer er officiel statistik først for nylig begyndt at diskutere problematikken omkring big data på et strategisk niveau. Der findes endnu ikke en fælles og bredt accepteret forståelse af vejen fremad, hvad enten det drejer sig om udfordringer eller muligheder, uanset om de er små eller store, osv. Inden for den Højniveaugruppe, der arbejder med modernisering af statistisk produktion og tjenester (3 How big is Big Data? Exploring the role of Big Data in Official Statistics: ), en Første SWOT-analyse, ledsaget af en grov risikovalgeringsanalyse/fordelsanalyse, er blevet gennemført. Det blev bemærket, at "en grundlæggende risikoanalyse også vil omfatte aspekter som sandsynlighed og indflydelse, og måske også vil blive udvidet til at definere strategier til at reducere og håndtere risici."
Selvom dette dokument stadig er langt fra en fuldstændig risikoanalyse, sigter det imod at forbedre situationen ved at skabe det første strukturerede overblik. Vi vil gerne understrege, at dette overblik bør betragtes som et udgangspunkt for at stimulere en generel diskussion inden for det Officielle statistiske samfund (OSC).
1.2. Område
Denne artikel er udelukkende dedikeret til risici, idet den udelader såvel fordele som styrker og svagheder, muligheder og trusler. Dette betyder, at "risiciene ved inaktivitet" (for eksempel risikoen for, at OSC kan blive ikke-konkurrencedygtig i forhold til andre aktører, hvis ikke den moderniseres) ikke indgår i afsnittet; det er snarere trusler. I stedet forsøger vi at fremhæve risici, der kan opstå (a) hvis OSC udnytter de muligheder, som big data tilbyder, og begynder at udvikle eller forbedre et specifikt "officielt statistisk produkt baseret på big data" (BOSP); (b) risici for den nye "almindelige forretning", det vil sige risici for officiel statistik, der er baseret på "big data" produktion. (Da al produktion af officiel statistik indebærer risici, begrænser vi os til (b) risici, der er specifikke for "big data risici", dvs. risici, der ikke eksisterer eller er ubetydelige i en "traditionel" proces for indsamling af officiel statistik.)
1.3. Struktur
I afsnit 2 præsenterer vi de grundlæggende principper relateret til denne opgave, begyndende med den åbenlyse nødvendighed af risikostyring og risikohåndtering (afsnit 2.1). Vi præsenterer også en foreløbig struktur for kvaliteten af statistiske data opnået på baggrund af big data (afsnit 2.2), da sammenkædning af kvalitetsstrukturen med risici opfylder to formål:
- Det skaber konteksten for at definere risici. Bestemte kvalitetsindikatorer sammen med de betragtede karakteristika udtrykker værdierne for objektet, som anses for vigtige og afgørende for at levere tjenester til kunder og brugere.
- Det giver mulighed for at tildele specifikke risici til kvalitetsmålinger, der er indlejret i de overordnede hyperrum og knyttet til bestemte faser i produktionen af statistiske produkter.
I afsnit 3, 4, 5 og 6 præsenterer vi de risici, der er blevet identificeret indtil nu i forskellige kontekster (4 Business case-dokumenterne fra ESS (https://www.europeansocialsurvey.org/about/structure_and_governance.html) Big Data-projektet samt hos Big Data ESSnets indeholder en liste over risici, der delvist er relateret til projektet og delvist til brugen af big data kilder til statistiske formål. Dokumentet „En foreslået ramme for kvaliteten af big data“ nævner nogle risici relateret til kvalitetsdimensioner./ Business case-dokumenterne fra ESS Big Data-projektet samt i ESS Big Data-netværkene indeholder en liste over risici, der delvist er relateret til projektet og delvist til brugen af store datakilder til statistiske formål. Dokumentet „Foreslået struktur for kvaliteten af big data“ nævner nogle risici, der er relateret til kvalitetsindikatorer.). Her bruger vi klassifikation af datatilgængelighed, det juridiske miljø, databeskyttelse og datasikkerhed, samt færdigheder; reorganisering i henhold til den kvalitetsstruktur for statistikker opnået fra big data (afsnit 2.2) skal overvejes, så snart denne struktur når en mere fuldendt status. For hver identificeret risiko giver vi (i) en vurdering af sandsynlighed samt påvirkning (i henhold til afsnit 2.1.3) og (ii) foreslår strategier til risikoreduktion og -håndtering (se afsnit 2.1.4).
Til sidst vil vi diskutere vores konklusioner og skitsere nogle næste skridt i afsnit 7.
2. Grundlæggende
2.1. Risici og risikostyring
Ifølge ISO 31000: 20095 defineres risiko som «indflydelsen fra usikkerhed på fastsatte mål». Det betyder, at målene skal defineres eller være kendte, før risiko kan bestemmes. Disse mål defineres typisk med hensyn til den institutionelle kontekst af den relevante organisation. Endvidere er en vigtig overvejelse, at risici bærer præget af usikkerhed, hvilket vil sige, at det er uklart, om den beskrevne hændelse vil finde sted. Derfor måles risici ud fra sandsynligheden for hændelsen og dens konsekvenser, dvs. indflydelsen af denne begivenhed på opnåelsen af de fastsatte mål. Risikovurdering skal give mere objektiv information, som i sidste ende vil muliggøre en passende balance mellem implementering af indtjeningsmuligheder og minimering af negative konsekvenser. Risikostyring er en uundgåelig del af ledelsespraksis og en vigtig komponent i god virksomhedspraksis (6 Statistics Canada: 2014-2015 report on Plans and Priorities, ). Det er en iterativ proces, som ideelt set muliggør en kontinuerlig forbedring af beslutningstagningen og bidrager til vedvarende forbedring af ydeevnen.
Risici er også knyttet til kvalitet. Implementeringen af et kvalitetssystem skal muliggøre udnyttelsen af mulighederne givet af forskellige kilder og metoder til at opnå et resultat af et bestemt kvalitetsniveau i den forstand, at dette resultat opfylder brugernes behov. Ligesom risici kan kvalitetsniveauer opnås fra det institutionelle miljø og målene for specifikke institutioner. I denne sammenhæng definerer det institutionelle miljø det overordnede niveau af risiko, som organisationen er villig til at påtage sig for at nå sine mål.
Processen med risikovurdering og risikostyring kan opdeles i forskellige faser, der inkluderer etablering af kontekst, definition af risici, analyse af risici med henblik på sandsynlighed og indvirkning, vurdering af risici og endelig behandling af risici.
2.1.1. Institutionel kontekst
Det første skridt er at etablere den strategiske, organisatoriske kontekst og risikostyringskonteksten, hvori resten af processen skal finde sted. Dette inkluderer fastlæggelse af kriterierne for risikovurdering og definerer analysestrukturen.
2.1.2. Risikogenkendelse
I det andet trin skal der identificeres hændelser, der kan påvirke opnåelsen af de fastsatte mål. Identifikationen skal inkludere spørgsmål relateret til risikotypen, hændelsestidspunktet, stedet eller hvordan hændelser kan forhindre, forværre, forsinke eller forbedre opnåelsen af målene.
2.1.3. Risikovurdering
Næste skridt består i at definere eksisterende kontrolforanstaltninger og analysere risici med hensyn til sandsynlighed såvel som de potentielle konsekvenser. I denne artikels kontekst anvendes en skala fra 1 (meget usandsynlig) til 5 (meget sandsynlig) for at vurdere sandsynligheden for risici. Indflydelsen af hændelser måles på en skala fra 1 (uvæsentlig) til 5 (ekstrem). Som vist i tabel 1, er produktet af sandsynlighed og indvirkning "risikoniveauet" i intervallet 1 til 25.
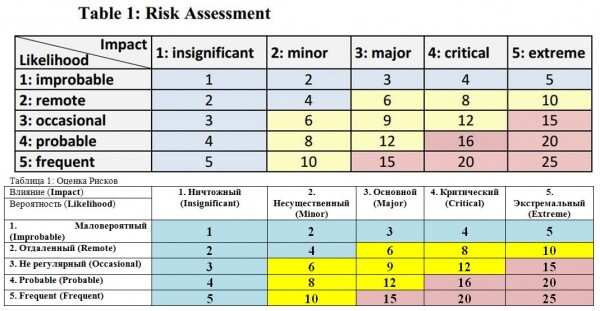
De vurderede risikoniveauer kan sammenlignes med forhåndsdefinerede kriterier for at etablere balancen mellem potentielle fordele og uheldige resultater. Dette muliggør vurderinger af prioritering af styring.
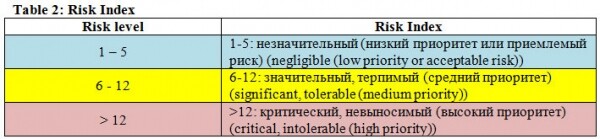
Prioritet for handling skal gives til kritiske risici (se tabel 2), det vil sige dem, der kan opstå og har alvorlige eller ekstreme konsekvenser for organisationens mål.
2.1.4. Reaktion på risici
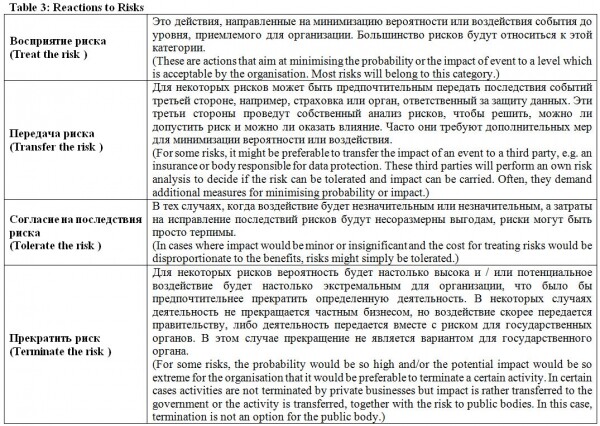
Det sidste skridt indebærer beslutninger om, hvordan man reagerer på risici. Nogle risici, der ligger under et forudbestemt risikoniveau, kan ignoreres eller tolereres. For andre kan omkostningerne ved at neutralisere risici være så høje, at de overstiger de potentielle fordele. I sådanne tilfælde kan organisationen beslutte at opgive den relevante aktivitet. Risici kan også overføres til tredjeparter, såsom forsikring, der kompensaterer for pådragne omkostninger. Den sidste mulighed er at tage højde for risici, når man definerer strategier og handlinger, der balancerer omkostningerne med de potentielle fordele. På denne måde træffer organisationen beslutninger om at implementere strategier for at maksimere fordelene og minimere de potentielle omkostninger.
2.2. Kvalitetssystemer
En målgruppe bestående af repræsentanter fra nationale og internationale statistiske organisationer udviklede i 2014 en foreløbig kvalitetstruktur for statistikker udvundet fra big data. Målgruppen arbejdede under projektet UNECE/HLG "Rollen af big data i moderniseringen af statistisk produktion". Den udvidede eksisterende kvalitetssystemer, der var udviklet til vurdering af statistikker baseret på administrative datakilder, med kvalitetsindikatorer, der blev anset for relevante for store datakilder.
Inden for dette system skelnes der mellem tre faser af forretningsprocessen: indtastning, produktivitet og output. Indtastningsfasen svarer til faserne "design" og "indsamling" i GSBP, produktivitet svarer til faserne "proces" og "analyse", mens output svarer til fasen "distribution".
Strukturen anvender en hierarkisk opbygning, som er taget fra den administrative datamodel udviklet af Statistisk Kontor i Holland (7 Daas, P., S. Ossen, R. Vis-Visschers, og J. Arends-Toth, (2009), Tjekliste for kvalitetsvurdering af administrative datakilder. Statistisk Kontor, Haag/Heerlen). Kvalitetsmålinger er indlejret i en hierarkisk struktur kaldet hyperskaber. De tre specifikke hyperskaber er "kilde", "metadata" og "data". Kvalitetsmålinger indlægges i disse hyperskaber og tildeles hver af produktionsfaserne. Der foreslås yderligere aspekter for indgangsfasen: "fortrolighed og privatliv", "kompleksitet" (i forhold til datastukturen), "fuldstændighed" af metadata og "sammenhæng" (muligheden for at knytte data til andre data) for at supplere standard kvalitetsmodellen. For hver kvalitetsindikator foreslås faktorer, der vedrører deres beskrivelse, samt mulige målinger.
I konteksten af denne artikel kan risici udelukkes fra disse faktorer. For eksempel, de faktorer, der skal overvejes for at måle kvaliteten af "institutionelt / forretningsmiljø", er dataudbyderens bæredygtighed. Den tilknyttede risiko kan være, at data ikke vil være tilgængelige hos dataudbyderen i fremtiden. Et andet eksempel relaterer sig til det nyligt foreslåede kvalitetsaspekt, privatliv og sikkerhed. En af de vigtige faktorer er "opfattelse", hvilket betyder den mulige negative opfattelse af den påtænkte brug af specifikke datakilder af forskellige interessenter.
3. Risici relateret til dataadgang
3.1. Manglende adgang til data
3.1.1. Beskrivelse
Denne risiko indebærer, at projektet relateret til udviklingen af BOSP, ikke får adgang til den nødvendige kilde af store data (BDS).
Indtil nu har OSC lært den hårde vej, at selv at komme fra startblokkene og få denne adgang, nogle gange er et uovervindeligt hinder. Nogle gange er det let at få adgang til en bestemt kilde - såsom dataoptegnelser for opkald (CDR) - til test- eller forskningsformål, men meget sværere (af juridiske eller kommercielle årsager) at få adgang til det til produktionsformål.
3.1.2. Sandsynlighed
Sandsynligheden afhænger i høj grad af karakteristikaene ved BDS. Hvis det drejer sig om store administrative data, kan de udgøre så lidt som 1, især hvis der ikke er problemer med beskyttelse af personlige data (som i tilfældet med trafikloopdata, undersøgt af Daas et al. 8 Daas, P., M. Puts, B. Buelens og P. van den Hurk. 2015. „Big Data som kilde til officielle statistikker“. Journal of Official Statistics 31 (2). (Forventes offentliggjort i juni 2015.)). Hvis BDS-tilfældet tilhører en privatperson, især hvis det er sensitivt (for eksempel med hensyn til databeskyttelse) eller værdifuldt (kommercielt set), kan sandsynligheden være meget høj (5).
3.1.3. Indflydelse
Indflydelsen afhænger af BOSP og måden, BDS bruges på. Hvis BDS er i centrum, kan indflydelsen være meget høj (4 = det er næsten umuligt at producere BOSP), mens den kan være lavere, hvis det stadig er muligt at producere BOSP (om end med lavere kvalitet) ved at stole på andre URB, hvilket resulterer i en indflydelse mellem 2-3.
3.1.4. Forebyggelse
For at reducere risikoen for mangel på adgang bør der etableres indledende kontakter med dataudbyderen og indgås en langsigtet aftale om adgang til data. Der bør desuden gennemføres en omfattende juridisk analyse vedrørende den specifikke kombination af BDS og BOSP. Mulighederne for dataadgang bør også vurderes i lyset af gældende eller fremtidig lovgivning.
3.1.5. Formildning
Hvis der er alternative BDS, der kan bruges til BOSP, kan de overvejes i stedet. Hvis der ikke er nogen måde at producere BOSP uden BDS, og hvis det ikke er muligt at overvinde mangel på adgang, bør bestræbelserne stoppes, og en ny BOSP vil ikke blive realiseret.
3.2. Tab af adgang til data
3.2.1. Beskrivelse
Denne risiko består i, at det statistiske forvaltning mister BDS, der ligger til grund for BOSP.
3.2.2. Sandsynlighed
Hvis BOSP allerede er i produktion, er der som regel en vis stabilitet, og i nogle tilfælde kan risikoen være meget lav (1). Dog, i tilfælde af private aktører, hvor der er indgået utilstrækkelige aftaler, forhindrer intet for eksempel. en ny ledelse i at ændre dataudleveringspolitikken, hvilket kan føre til en moderat risiko for brud (3). Desuden, hvis BDS er knyttet til ustabil aktivitet, er der altid risiko for, at udbyderen simpelthen går konkurs, og risikoen kan endda være højere (4).
3.2.3. Indflydelse
Da en eksisterende BOSP kan være umulig at producere, finder der ofte en meget stærk påvirkning sted (5). I andre tilfælde, hvor BDS har en subsidiær karakter, kan påvirkningen snarere være et kvalitetsnedfald med en påvirkning i intervallet 2-3.
3.2.4. Prævention
Præventionsstrategien ligner strategien for mangel på adgang til data, men med et øget fokus på vedvarende årvågenhed, også under produktionsforhold.
Ikke at lægge alle æg i én kurv (dvs. at have flere BDS, der understøtter hver BSOP) kan også være en strategi, men det kan være både upraktisk og for kostbart.
3.2.5. Afbødning
Hvis BDS er et resultat af ustabil aktivitet, kan en ny BDS, der afspejler samme sociale fænomen, gradvist blive tilgængelig. Men det ville være for sent at begynde "markedsundersøgelsen", når BSOP'et fejler; der kræves en vedvarende årvågenhed — hvilket kan være svært at opnå.
4. Risikoen forbundet med det juridiske miljø
4.1. Manglende overholdelse af relevant lovgivning
4.1.1. Beskrivelse
Denne risiko består af et projekt relateret til udviklingen af BOSP, hvor den relevante lovgivning ikke tages i betragtning, hvilket gør BOSP'en ikke i overensstemmelse med den angivne lovgivning. Dette kan vedrøre databeskyttelseslovgivning, reguleringer vedrørende reaktionsbyrden osv.
4.1.2. Sandsynlighed
I betragtning af OSC's manglende viden om store data, er det ikke usandsynligt, at tilfældigt (3) manglende overholdelse kan finde sted. Sandsynligheden er generelt relateret til BDS, da jo mindre "følsom" kilden er, jo mindre sandsynligt er det, at der opstår en overtrædelse.
4.1.3. Indflydelse
Indvirkningen er typisk kritisk (4) i den forstand, at ikke-overholdelse vil kræve stoppet af BOSP (eller, hvis det endnu ikke er nået implementeringsfasen, at udviklingen skal ophøre). Dette kan være ekstremt (5), da de omdømmemæssige risici der opstår fra ikke-overholdende ('ulovlig') officiel statistik, kan have konsekvenser.
4.1.4. Forebyggelse
For ethvert BOSP er det nødvendigt at udføre en grundig juridisk analyse — og dette sker i flere faser (det, der er acceptabelt i udviklings-/udforskningsfasen, kan være det modsatte i implementerings-/produktionsfasen). Dette kan i sin tur føre til reengineering af BOSP for at gøre det kompatibelt.
4.1.5. Afhjælpning
Afhængigt af alvorligheden af ikke-overholdelsen kan det første skridt være at bringe BOSP offline.
Reengineering af BOSP for at gøre det kompatibelt kan være en mulighed, men hvorvidt BOSP kan 'redes' på denne måde afhænger stærkt af karakteren af ikke-overholdelsen.
4.2. Ufordelagtige ændringer i det juridiske miljø
4.2.1. Beskrivelse
Der kan indføres ny lovgivning, der relaterer til det udviklede BOSP, hvilket faktisk gør BOSP incompatibelt.
4.2.2. Sandsynlighed
Det er ikke udelukket, at fortalere for strengere databeskyttelse kan indføre nye krav, der direkte eller indirekte påvirker muligheden for at udvikle specifikke BOSP. Sandsynligheden i intervallet 2-3 synes at være en realistisk vurdering.
4.2.3. Indvirkning
Indvirkningen er typisk kritisk (4), idet ikke-overholdende produktion vil kræve stoppet af BOSP.
4.2.4. Forebyggelse
Specifik forretningsinformation skal løbende indsamles for at overvåge udviklingen i lovgivningen — muligvis også for at påvirke den ved at argumentere for officiel statistik på relevante (f.eks. rådgivende) fora.
4.2.5. Afhjælpning
Forudsat at der er blevet udført proaktiv overvågning, kan der være tid til at reengineering BOSP for at bringe det i overensstemmelse med ny lovgivning fra dag ét af dens ikrafttræden.
Hvis overvågning derimod ikke er blevet udført, så det nye lovgivning er blevet en "overraskelse" - eller hvis lovgivningen er så radikal, at der ikke er nogen måde at gøre BOSP uforenelig på - kan den eneste mulighed være at deaktivere BOSP.
5. Risici relateret til fortrolighed og datasikkerhed
5.1. Databrud
5.1.1. Beskrivelse
Denne risiko vedrører uautoriseret adgang til data, der opbevares i statistiske kontroller. Tredjeparter kan få adgang til data, der er under embargo, for eksempel på grund af offentliggørelsen af en tidsplan (9 For enhver BOSP, der er helt baseret på en enkelt BDS, er det uundgåeligt, at dataene vil blive uofficielt kendt af den oprindelige data ejer, og hvis metodologien er transparent, vil den afledte statistik også være kendt. Denne situation behandles ikke her, men snarere under risikoen for misbrug af magten fra ejerne.) (10 Desuden kan disse data også indebære en risiko for overtrædelse af fortroligheden. Denne risiko vil blive behandlet særskilt.). Dette kan for eksempel være data, som investorer venter på på aktiemarkedet.
5.1.2. Sandsynlighed
Hvad angår de tekniske aspekter af beskyttelsen af IT-miljøet i den statistiske afdeling, er risikoen den samme for BDS'er som for traditionelle kilder. Der er dog to yderligere aspekter, der skal tages i betragtning.
For det første er den samlede risiko let højere med nogle BDS'er, fordi datasikkerheden for den oprindelige ejer kan være truet. Dette kan være relateret til for eksempel industriel spionage eller hacking.
For det andet, så snart potentielt værdifulde data begynder at blive opbevaret på kontoret, vil risikoen for tiltrækning af ondsindede intentioner stige. Hvis de opbevarede data har en meget høj værdi for virksomheden, skal man være forberedt på en meget høj sandsynlighed for angreb rettet mod IT-infrastrukturen, så sandsynligheden for indbrud kan være potentielt højere (4).
Hvis de opbevarede data ikke betragtes som værdifulde, fremstår den samlede sandsynlighed ikke som særlig høj - fra (1) til (3) afhængigt af datakilden.
5.1.3. Indvirkning
Den potentielle skade på omdømmet kan være stor (5). Det vigtige i tilfælde af BDS er, at hvis der opstår en sikkerhedsbrist hos den oprindelige ejer, forventes påvirkningen på omdømmet af det statistiske bureau at være lavere, end hvis bristen opstod med data, der var under deres opbevaring.
På den anden side kan et brud i det statistiske bureau have negative konsekvenser for den oprindelige ejer. I dette tilfælde er det igen muligt, at der opstår en stærk negativ indvirkning på grund af den skade, der opstår, set fra et tillidspunkt mellem leverandøren og det statistiske bureau (5).
5.1.4. Forebyggelse
Karakteristisk for BDS-tilfælde er, at sikkerhedsprocedurerne hos den oprindelige ejer kan være relevante. Det er usandsynligt, at de statistiske bureauer vil få revisionskompetence til at overvåge dette. Ejere, hvis data bruges til at udarbejde optegnelser med fortrolige offentlige publikationer, bør informeres om konsekvenserne for den officielle statistik ved en potentiel sikkerhedsbrist i deres lokaler og skal have en officiel garanti for, at passende sikkerhedsprocedurer anvendes.
En direkte metode til at forhindre, at en sikkerhedsbrist i ejerens lokaler har en alvorlig indvirkning på det statistiske bureau, er at sikre brugen af flere kilder til det samme produkt, så en enkelt kompromitteret kilde ikke er tilstrækkelig til at opnå det endelige tal. Fordelen ved denne tilgang er, at der er større kontrol i hænderne på det statistiske bureau.
Metoden til at forhindre negative konsekvenser af sikkerhedsbrud i det statistiske kontor for den oprindelige dataejer består i at finde en arbejdsmetode, der ikke indebærer overførsel af data, som potentielt er følsomme fra ejerens synspunkt, til det statistiske forvaltning. I rå form. En mulig forebyggende tilgang er brugen af aggregerede data. Det skal dog huskes, at visse former for aggregering, for eksempel dem, der har til formål at forhindre identifikation af enkeltpersoner i populationen, måske ikke er egnede i dette tilfælde. En af årsagerne til dette kan være, at risikoen for ejeren er knyttet til den kommercielle værdi af dataene, som kan være betydelig, selv efter anonymisation.
5.1.5. Afbødning
I tilfælde af brud på data, der er under statistisk forvaltning, vil afbødningsforanstaltningerne være de samme som for traditionelle kilder, medmindre der er sket en negativ indvirkning på den oprindelige ejer.
I tilfælde af negative konsekvenser for den oprindelige ejer skal det statistiske forvaltning revurdere og styrke sine sikkerhedsprocedurer og klart kommunikere og demonstrere sit engagement i dette.
Hvis bruddet fandt sted i lokalerne for den oprindelige ejer, skal den relevante statistiske tjeneste klart informere om situationen og insistere på forbedring af ejerens sikkerhedsprocedurer. Alternativ leverandør kan søges om nødvendigt.
5.2. Brud på datasikkerhed
5.2.1. Beskrivelse
Dette er risikoen for, at fortroligheden for én eller flere personer inden for den statistiske population bliver krænket. Dette kan være relateret til angreb på IT-infrastrukturen som følge af pres fra andre offentlige enheder eller som følge af utilstrækkelige kontrolforanstaltninger for offentliggørelse af statistiske data.
5.2.2. Sandsynlighed
Som i tilfælde af risikoen for databrud ændrer de tekniske betingelser for opbevaring af mikrodata sig ikke meget ved tilføjelse af BDS. Men der er også her forbehold.
Mikrodata fra visse datakilder kan have høj kommerciel værdi, så opbevaringen af disse vil øge sandsynligheden for angreb.
Desuden kan nogle mikrodata potentielt være meget nyttige for andre offentlige institutioner, såsom retshåndhævelse, skatteopkrævning eller sundhedspleje. Under visse omstændigheder kan forpligtelsen til princippet om statistisk fortrolighed blive sat under stort pres.
Når det kommer til fejl i kontrol af offentliggørelse af statistisk information, eksisterer der nu allerede etablerede praksisser. BDS kan gøre det muligt at generere statistik for små undergrupper af befolkningen eller give mulighed for at koble aggregerede data fra forskellige BDS, hvilket kan øge risikoen. Desuden vil nye kilder dog kræve nye metodologiske udviklinger, så den reelle fare ligger i, at metodologien for kontrol af offentliggørelse ikke opdateres korrekt.
Generelt kan sandsynligheden opretholdes på rimelige niveauer med fornuftige forebyggende foranstaltninger, men da der er mange forskellige og varierende faktorer, synes den relevante vurdering her at være, at sandsynligheden er høj (4).
5.2.3. Indflydelse
Den potentielle skade på omdømmet kan være stor (5). Ligesom ved risikoen for brud på datasikkerhed kan en overtrædelse i statistisk forvaltning have negative konsekvenser for den oprindelige ejer. Her kan indflydelsen af en sådan hændelse potentielt være endnu større, især hvis de nuværende tendenser i offentlighedens mening fortsætter. Skader i forholdet mellem dataudbyderen og den statistiske forvaltning forventes også at være meget store.
5.2.4. Forebyggelse
Den fejlfrie måde at forhindre en sådan risiko på er generelt at undgå at have mikrodata fra BDS (selvom opbevaring af andre mikrodata stadig involverer en vis risiko, men med en anden sandsynlighed og indflydelse). Denne tilgang, ligesom i tilfælde af risikoen for brud på datasikkerheden, medfører behovet for at udvikle andre måder at bruge data til statistiske formål. Derudover vil den forskellige natur af kilder betyde, at det vil være nødvendigt at udvikle nye metoder med konkurrerende mål om at udvinde så meget nyttig information som muligt og beskytte privatlivet mod fare.
I tilfælde af opbevaring af mikrodata skal IT-sikkerhedsforanstaltninger og adgangskontrol være på det nødvendige niveau og konstant overvåges. Der skal lægges særlig vægt på at sikre de nye metoder til dataindsamling. Ironisk nok kan en sådan ny metode være den fysiske transport af lagringsenheder (f.eks. harddiske). Hvis denne metode anvendes, skal transporten være fysisk beskyttet, og der bør anvendes kryptering.
5.2.5. Formildring
Formildrende foranstaltninger her er principielt de samme som ved brud på datasikkerheden. Hvis årsagen til bruddet er pres fra en anden offentlig myndighed, bør man udnytte muligheden for at styrke uafhængigheden af forvaltningen, så sådanne brud bliver endnu sværere i fremtiden.
5.3. Manipulation med datakilden
5.3.1. Beskrivelse
Tredjepartsdataleverandører, såsom sociale mediers data eller frivilligt leverede data, er udsat for risiko for manipulation. Dette kan gøres enten af dataleverandøren selv eller af tredjeparter. For eksempel kan mange falske oplysninger på sociale medier være genereret for at påvirke den statistiske indeks, der er baseret på disse data, på en eller anden måde, hvis det er kendt, at indekset beregnes på grundlag af sådanne data.
For frivilligt leverede data kan der være tilfælde, hvor frivillige repræsenterer en bestemt interessegruppe med en bestemt dagsorden.
5.3.2. Sandsynlighed
For data that can be advantageous to manipulate, the likelihood is higher. This may include data for which statistics are interesting, such as the stock market. In light of recent scandals related to LIBOR and Forex, it can be assumed that as long as there is an incentive, attempts to manipulate data will be likely.
For statistics based on voluntarily provided data, one only needs to look at recent PR practices involving hiring people to feign certain opinions and paying them for public expression (for example, on internet forums) to conclude that the likelihood is not low. Overall, a figure of 3 to 4 seems adequate.
5.3.3. Influence
A major issue with manipulations is that they can persist for a long time without detection. If manipulations continue for an extended period, the impact on quality can become significant. Additionally, the damage to public trust in official statistics can also be considerable, especially if the role of statistical agencies as providers of quality data is publicly emphasized. On the other hand, if manipulations are detected in time and publicized, this can actually improve public perception. Except in extremely poor cases, a maximum impact (3) can be envisioned.
5.3.4. Prevention
Conducting regular control exercises with alternative sources is one possible preventive approach. These alternative sources can be traditional or other. Using statistics based on a combination of sources can mitigate significant impacts of manipulations. In cases where there are concerns about manipulations initiated by the provider, legal agreements can also be one way to prevent such practices.
5.3.5. Mitigation
In terms of the damage to public relations, the mitigating measures that should be taken here are not significantly different from those addressing any crisis.
From the perspective of data quality, it would be beneficial if past data could be corrected so that even with a significant delay, the correct series could be achieved.
Produceren. For dette kan regelmæssig benchmarking være nyttigt. Vær opmærksom på, at formålet med sammenligningsanalysen i dette tilfælde er lidt anderledes end formålet med forebyggelse. For forebyggelse er det vigtigt hurtigt at opdage og undersøge mistænkelige uoverensstemmelser mellem benchmark-testdata og BDS. For at afbøde konsekvenserne er gamle nyttige data altid værdifulde.
Derudover bør der tages skridt til at forhindre sådanne manipulationer i fremtiden - i særligt følsomme tilfælde kan dette betyde at indhente potentielt overflødige data fra flere leverandører til sammenligningsanalyse.
5.4. Negativ offentlig opfattelse af brugen af big data af officielle statistiske myndigheder
5.4.1. Beskrivelse
Medierne og den brede offentlighed er meget følsomme over for spørgsmål om fortrolighed og brugen af personlige data fra store datakilder, især i forbindelse med sekundær brug af data af offentlige myndigheder, der træffer administrative eller juridiske foranstaltninger i forhold til borgere. Negativt opfattet brug kan være positioneringen af hastighedskontrol baseret på analyse af navigationsdata (11 Se ).
Det konkrete tilfælde med TomTom Netherlands førte til et betydeligt fald i efterspørgslen efter TomTom-enheder og førte til virksomhedens beslutning om at begrænse adgangen til data. I dette specifikke tilfælde vedrørte dataene individuelle personer, men til hastighedsniveauer på vejstrækninger.
Der kan dog være applikationer med big data, som offentligheden opfatter positivt. Et eksempel kunne være applikationer, der forhindrer forbrydelser som indbrud baseret på metoder inden for big data.
Både positiv og negativ offentlig mening kan have en stærk indflydelse på brugen af BDS i forbindelse med produktionen af officielle statistikker.
En konsekvens af negativ offentlig opfattelse kan være, at:
- BDS ikke længere vil være tilgængelig for statistiske kontorer, enten på grund af beslutninger fra dataleverandøren eller regeringens beslutning om ikke at bruge data, eller
- brugen af data vil være begrænset, hvilket kan hindre produktionen, hvis visse BOSP.
5.4.2. Sandsynlighed
Faktorer, der kan påvirke sandsynligheden for en hændelse eller dens indvirkning på produktionen af statistik:
- databeskyttelse, dvs. hvor let det er at identificere personer;
- mængden af information, som data afslører om enkeltpersoner, f.eks. ved at kombinere data fra forskellige kilder;
- typen af data, f.eks. finansielle transaktioner opfattes som mere følsomme end andre data;
- typen af potentiel handling, der kan udføres over for borgere, f.eks. at bøde folk for hastighedsovertrædelser;
- en uklar retlig ramme, hvori dataleverandører og brugere arbejder, eller når de juridiske betingelser er i konflikt med offentlige etiske normer;
- graden af afhængighed af en bestemt datakilde for at opnå statistik; i indledende faser kan denne faktor have lidt betydning. Men dette kan have stor indflydelse på indsamling af statistik i senere faser og bør derfor også overvejes i indledende faser. Et af problemerne kan være, at den endelige mængde brug af data først er ukendt, da datakilder potentielt kan betjene mere end et statistisk område.
Vurdering af tidspunkter for uønskede begivenheder er umulig, da mobilisering af offentligheden ofte initieres ved dækning af begivenheder, der har en negativ indvirkning på borgere. Ikke desto mindre, med en stigende brug af big data af regeringer og private virksomheder, og især med aktiv markedsføring af data til andre formål end dem, der førte til deres oprindelige indsamling, er det mere sandsynligt, at sådanne begivenheder vil finde sted.
Begivenheder, der har en stærk indvirkning på den offentlige opfattelse, er ikke hyppige, men snarere tilfældige og fjerne. Med stigende brug af store datakilder vil sandsynligheden også stige.
5.4.3. Indflydelse
Effekten af en begivenhed afhænger i høj grad af de faktorer, der er blevet diskuteret tidligere. Generelt er indflydelsen mere alvorlig for allerede etablerede produktioner af statistiske data, da handlingen muligvis skal standses. Indflydelsen afhænger også af tilgængeligheden af alternative datakilder, selvom det kan ske, at offentligheden ikke skelner mellem forskellige datakilder i tilfælde af, at begivenheden materialiseres. I den nuværende brug af big data synes det, at disse kilder ikke helt kan erstatte traditionelle datakilder, men snarere supplere den eksisterende statistik. Dette vil mindske virkningen af begivenheder. Derfor betragtes indflydelsen af begivenheden at være i spannet fra 2 (uanselig) til 3 (væsentlig). I produktionsstadiet kan indflydelsen stige til 4 (kritisk niveau).
5.4.4. Forebyggelse
Forebyggende foranstaltninger kan inkludere fastlæggelse af etiske principper for big data i officiel statistik. De etiske retningslinjer bør baseres på sådanne principper som en praksiskode for europæisk statistik eller grundlæggende principper for officiel statistik (12 ). Næste foranstaltning vil være at definere en kommunikationsstrategi, der vil offentliggøre resultaterne af de etiske retningslinjer for offentligheden og kan bruges til at informere interessenter om den etiske brug af BDS til BOSP.
En særskilt risikovurdering for den specifikke BDS kan udføres for at identificere risici og foreslå forebyggende eller afbødende foranstaltninger baseret på de etiske principper. En særskilt risikovurdering kan også involvere interessenter som databeskyttelsesagenturer for at sikre identificeringen af alle risici og berettigelsen af foranstaltningerne.
5.4.5. Afbødning
Kommunikationsstrategien skal også omfatte foranstaltninger i tilfælde af voksende negativ offentlighed. En separat risikovurdering bør indsamle positive eksempler på brug af data og foranstaltninger til at forhindre misbrug af data, som kan være nødvendige at implementere på politisk niveau, og det statistiske samfund kan mangle evnen til effektivt at påvirke dem.
5.5. Tab af tillid — opnået ikke gennem observation
5.5.1. Beskrivelse
Brugere af officiel statistik har normalt høj tillid til nøjagtigheden og pålideligheden af statistiske data. Dette er baseret på det faktum, at produktionen af statistiske data er indarbejdet i en robust og offentligt tilgængelig metodologisk ramme samt dokumentation om kvaliteten af det statistiske produkt. Derudover er de fleste statistiske data baseret på observationer, dvs. indsamlet fra undersøgelser eller folketællinger, som etablerer en let forståelig forbindelse mellem observationen og de statistiske data. Brug af BDS, der ikke er indsamlet til det primære formål med statistik, medfører risiko for, at disse forbindelser går tabt, og at brugerne mister tilliden til de officielle statistiske data. Et eksempel fra den seneste runde (2010) af folketællingen handler om, at statistiske data i nogle lande blev indsamlet ved hjælp af flere kilder og statistiske modeller. I flere tilfælde har interessenter udfordret de statistiske data.
5.5.2. Sandsynlighed
Sandsynligheden for, at en risiko opstår, afhænger af faktorer såsom kompleksiteten af den statistiske / metodologiske model, pålideligheden af forholdet mellem BSD og BOSP eller overensstemmelsen med andre statistiske data. Sandsynligheden skal ligge i intervallet fra 3 (tilfældige) til 4 (sandsynlige), hvilket betyder, at det kan ske flere gange eller ofte.
5.5.3. Indvirkning
Indflydelsen af opståede risici vil i høj grad afhænge af, om NSO'er kan bevise nøjagtigheden og troværdigheden af statistiske data. Hvis dette ikke kan opnås, kan virkningen af tab af tillid også berøre andre statistiske områder, hvilket betyder, at troværdigheden ikke kun for nogle statistiske data, men også selve organisationen kan komme i tvivl. NSO'er ville miste et konkurrencemæssigt forspring i forhold til andre private organisationer, der opererer inden for dette område.
5.5.4. Forebyggelse
Forebyggende tiltag vil bestå i udviklingen og offentliggørelsen af en videnskabeligt funderet metodologi, der anerkendes af det videnskabelige samfund, berige data med metadata om kvalitet, sikre konsistens mellem BOSP og ikke-BOSP, samt udføre streng kvalitetskontrol.
Før der påbegyndes statistisk produktion, kunne BOSP offentliggøres som eksperimentelt, og interessenter ville blive anbefalet at anfægte BOSP for at bekræfte eller forbedre BOSP.
5.5.5. Afbødning
Der er to tilfælde at skelne imellem. Hvis statistikken anfægtes, men har høj / tilstrækkelig kvalitet (korrekt / præcis), ville det være tilstrækkeligt at forklare og kommunikere statistikken til offentligheden ved at give letforståelige eksempler.
6. Risici forbundet med færdigheder
6.1. Mangel på specialister
6.1.1. Beskrivelse
Analyse af de digitale spor efterladt af mennesker under deres aktivitet kræver bestemte dataanalyseværktøjer, som i øjeblikket ikke er de mest udbredte i officiel statistik. For det første kræver brugen af indirekte data om menneskers aktiviteter i stedet for direkte interviews i undersøgelser brug af statistiske modeller og derfor færdigheder inden for ræsonnering og maskinlæring. For det andet består disse digitale optegnelser af data, som ofte ikke har et almindeligt tabelformat, der er typisk for resultaterne af undersøgelser, med rækker, der svarer til den statistiske enhed, og kolonner med specifikke karakteristika for disse statistiske enheder. Digitale spor fremvises også som tekst, lyd, billeder og video. At udtrække relevant statistisk information fra disse datatyper kræver færdigheder inden for naturlig sprogbehandling, lydsignalbehandling og billedebehandling. For det tredje har disse datakilder tendens til at levere enorme datasæt, hvis behandling kræver en god forståelse af metoderne til distribueret computing.
Risikoen for mangel på eksperter ligger i at få data fra en af disse nye store datakilder, da statistisk forvaltning ikke har mulighed for at behandle og analysere det korrekt, fordi deres personale ikke har de nødvendige færdigheder.
6.1.2. Sandsynlighed
Sandsynligheden for denne risiko vil afhænge af tre faktorer: 1) de specifikke typer færdigheder, der er nødvendige for hver type kilde til store data, og sandsynligheden for, at statistisk forvaltning finder en mulighed for at undersøge en sådan kilde; 2) den nuværende tilgængelighed af de nødvendige færdigheder i statistisk forvaltning; og 3) den organisatoriske kultur i statistisk forvaltning.
Når det kommer til de typer færdigheder, der måtte være nødvendige, skal det bemærkes, at ikke alle kilder kræver alle de nævnte færdigheder. Nogle (for eksempel Google Trends-data) kræver ikke distribuerede beregninger, da de allerede er forbehandlet af dataejeren eller har signalbehandlingsfærdigheder, og de vil primært kræve statistisk modelleringsfærdigheder. Der er dog et stort udvalg af big data-kilder, hvoraf de fleste kræver færdigheder inden for distribuerede beregninger, signalbehandling og maskinlæring. Samtidig vil en korrekt analyse af disse digitale spor kræve behandling af flere kilder. Derfor er der en høj sandsynlighed for, at store datakilder, der bliver tilgængelige for statistisk forvaltning, vil kræve disse usædvanlige færdigheder, og sandsynligheden for denne risiko er meget høj (5).
Når det kommer til den nuværende tilgængelighed af de nødvendige færdigheder, vil det afhænge af den specifikke statistiske forvaltning. Selvom metoden til undersøgelse er mindre udbredt end undersøgelsesmetoden, anvendes den også i officiel statistik inden for bestemte områder. Så selvom det kan kræve en vis omfordeling af menneskelige ressourcer, kan statistiske forvaltninger finde løsninger selv. Når det gælder færdigheder inden for distribuerede beregninger, der primært er relateret til IT, vil de afhænge af, hvordan IT-infrastrukturen forvaltes i organisationen. Afhængigt af hvorvidt IT-afdelingen er sideløbende, kan løsninger findes i konteksten af eksisterende aftaler. Ikke desto mindre findes der typisk ikke færdigheder inden for signalbehandling og maskinlæring i de fleste officielle statistiske forvaltninger, og anvendelsen af disse færdigheder kan ikke outsources, da de skal anvendes af eksperter inden for statistik. Derfor synes sandsynligheden for denne risiko også at være meget høj (5).
Organisationskulturen vil også påvirke sandsynligheden for denne risiko. Eksistensen af personale, der er villige til at erhverve de nødvendige færdigheder gennem selvstudier, kan give organisationen mulighed for at reagere på en situation med en ny datakilde, der kræver færdigheder, der adskiller sig fra de sædvanlige. Dette vil afhænge af organisationskulturen for statistisk ledelse, nemlig om den opmuntrer medarbejderne til at tilegne sig nye færdigheder og giver dem tid til selvstudie.
Sandsynligheden for, at den statistiske ledelse ikke vil kunne behandle og analysere nye datakilder på grund af mangel på færdigheder hos sine medarbejdere, vil derfor være mellem sandsynlig (4) og hyppig (5) afhængig af organisationens kultur for selvstudier.
6.1.3. Indflydelse
Statistisk ledelse, der er ude af stand til at behandle og analysere store datakilder på grund af manglen på færdigheder hos sine medarbejdere, kan have to mulige negative konsekvenser: 1) datakilden vil ikke blive undersøgt, i det mindste ikke fuldt ud; 2) kilden vil blive misbrugt.
Manglen på mulighed for fuldt ud at udforske potentialet i en værdifuld kilde til store data vil have en mindre betydning (2) på kort sigt, da statistiske ledelser faktisk har de statistiske værktøjer til at imødekomme de nuværende behov. Imidlertid, på lang sigt (og muligvis endda på mellemlang sigt) vil konsekvenserne af at miste denne mulighed have en afgørende betydning (4), da statistiske ledelser i stigende grad står over for konkurrence fra private leverandører, der ikke har den samme institutionelle struktur, som gør det muligt for dem at garantere samfundet uafhængighed af statistiske data.
Men uprettet brug af kilden vil have yderst negative konsekvenser for statistiske myndigheder, da den officielle statistik i høj grad er afhængig af sit ry i forbindelse med udførelsen af sin mission. Vi kan imidlertid hævde, at den mest vigtige kompetence, der, hvis den overses, kan føre til fejlagtige resultater, er statistisk ræsonnering, særligt modelbaseret ræsonnering, som også har en mindre sandsynlighed for at mangle. Derfor vil den forventede indvirkning sandsynligvis være kritisk (4) snarere end ekstrem.
6.1.4. Forebyggelse
Statistiske tjenester kan aktivt forebygge denne risiko på to måder: 1) uddannelse; og 2) rekruttering.
Statistiske myndigheder kan give deres medarbejdere de nødvendige færdigheder ved grundigt at definere de færdigheder, der kræves for at anvende store datakilder i statistisk produktion, udarbejde en liste over medarbejdernes nuværende færdigheder, identificere uddannelsesbehovene og derefter organisere kurser.
Statistiske myndigheder kan også rekruttere nye medarbejdere med de nødvendige færdigheder. Dette synes at have alvorlige begrænsninger, da statistiske myndigheder ikke vil være i stand til at rekruttere en kritisk masse af personale til en situation, hvor brugen af store datakilder breder sig i afdelingen, og nye medarbejdere stadig vil have brug for flere år for at nå et erfaringsniveau svarende til eksisterende medarbejdere. Dog kan nogle af de nye medarbejdere, der rekrutteres som led i almindeligere personaleopdateringer, have færdigheder relateret til big data.
6.1.5. Afbødning
Udfordret med en situation, hvor nye kilder til store data er tilgængelige uden medarbejdere med de nødvendige færdigheder, kan statistiske myndigheder afbøde de negative konsekvenser på to måder: 1) underleverandør; og 2) samarbejde.
Statistiske myndigheder kan indgå aftaler om databehandling og analyse af nye kilder til big data med andre organisationer, der leverer disse slags tjenester. Det ser ud til at være en levedygtig løsning, da der opstår en ny sektor af virksomheder, der specialiserer sig i behandling af denne type data. Denne løsning medfører dog visse risici, da den statistiske myndighed vil have mindre kontrol over produktionen af potentielt følsomme statistiske produkter. Denne løsning har også den ulempe, at den ikke giver medarbejderne i den statistiske myndighed mulighed for at lære og opnå de nødvendige færdigheder.
Samarbejde med andre organisationer, hvor der er medarbejdere med de nødvendige færdigheder, og som også er interesserede i at udforske kilden til big data, virker som en mere lovende løsning. Dette samarbejde kan tage form af fælles projekter mellem medarbejdere fra den statistiske myndighed og medarbejdere fra andre organisationer på lige fod, hvor de deler deres viden. Dette ville ikke kun reducere risikoen for mangel på færdigheder, men også give medarbejderne i den statistiske myndighed mulighed for at tilegne sig disse færdigheder.
6.2. Ekspertlækage til andre organisationer
6.2.1. Beskrivelse
Denne risiko består i, at de statistiske myndigheder mister deres personale til andre organisationer, efter at de har erhvervet sig færdigheder relateret til big data.
6.2.2. Sandsynlighed
Sandsynligheden for denne risiko vil afhænge af to faktorer: 1) eksisterende attraktive muligheder i organisationer uden for den officielle statistik; 2) arbejdsforholdene i de statistiske myndigheder.
Når det kommer til muligheder i organisationer uden for officiel statistik, synes sandsynligheden for denne risiko at være reel (4). Der er en høj efterspørgsel efter personer med færdigheder inden for store data i den private sektor samt i andre offentlige organisationer. Efter at have tilegnet sig færdigheder til at arbejde med store data vil officielle statistikker have en komparativ fordel ved at være erfarne specialister inden for statistik. Udover de specifikke færdigheder til arbejde med store data kræver andre organisationer data-specialister, der har mere traditionelle færdigheder som vurdering af brugernes behov og udvikling af nøglepræstationsindikatorer (KPI'er), som er almindelige for officielle statistikere. Derudover forventes det, at medarbejdere, der er mere tilbøjelige til at tilegne sig nye færdigheder, også vil være dem, der vil være mere åbne for karriereskift og forlader statistikforvaltningen.
Når det gælder arbejdsforholdene i statistikforvaltningerne, vil det tydeligvis afhænge hovedsageligt af det enkelte kontor. Ikke desto mindre tilbyder statistikforvaltningerne generelt stadig attraktive karrieremuligheder for personer med kvantitativ baggrund. Statistikforvaltningerne tilbyder det største udvalg af mulige domæner at arbejde i og det største udvalg af data at arbejde med. Dette vil på en eller anden måde mindske sandsynligheden for, at statistikforvaltninger mister deres personale på grund af uventede omstændigheder (3).
6.2.3. Indflydelse
Indflydelsen af denne risiko vil være den samme som risikoen for mangel på personale med de relevante færdigheder i første omgang. Derfor vil indflydelsen være kritisk (4), som nævnt ovenfor.
6.2.4. Forebyggelse
Det ser ud til, at den eneste mulighed for statistiske myndigheder for at forhindre denne risiko er at sørge for attraktive arbejdsforhold for deres medarbejdere. Dette gælder generelt for hele personalet. Men i det specifikke tilfælde, hvor medarbejderne er åbne for at lære nye færdigheder, nemlig færdigheder i arbejdet med big data, kan arbejdsforholdene forbedres ved at give dem muligheder for læring, hvor de kan udvikle deres professionelle interesser. Statistiske myndigheder kan også fokusere særligt på at være åbne for nye innovative projekter og ideer, der er relateret til nye kilder til big data, der kommer fra statistikere, der arbejder inden for forskellige områder af statistik. Endelig vil forebyggelsen af personalets tab til andre organisationer, på grund af deres færdigheder inden for big data, afhænge af en god identifikation af personale, der er i stand og villige til at arbejde med sådanne data, samt at tilbyde gode muligheder for deres professionelle udvikling.
6.2.5. Afbødning
Reduktionen af denne risiko vil ske med hensyn til risikoen for mangel på personale med de relevante færdigheder: 1) underleverandør; og 2) samarbejde.
7. Diskussion
Fra denne første gennemgang er det tydeligt, at det er umuligt at fastsætte en enkelt sandsynlighed eller indflydelse for denne "big data-risiko" — generelt afhænger begge målinger i høj grad af kilden til big data samt af "officiel statistik baseret på big data".
produkt ".
På denne baggrund konkluderer vi, at et logisk næste skridt i denne retning er at vedtage en række mulige pilotprojekter (hver især omfatter en kombination af en eller flere BDS'er og en eller flere BDOS'er) som udgangspunkt og - for hver sådan pilot - at stræbe efter at vurdere sandsynligheden og påvirkningen af hver risiko.
Til dette formål er vi på nippet til at igangsætte en undersøgelse af interessenter for at forsøge at vurdere OSC's vurdering af sandsynlighed, påvirkning (og mulige handlinger til forebyggelse / afbødning) i forhold til en række mulige pilotprojekter - samt anmode om OSC's forslag til risici, som vi ikke har inkluderet i dette dokument.
8. REFERENCERUNECE (2014), „Et foreslået ramme for kvaliteten af Big Data“, Leverancer fra UNECE Big Data Quality Task Team,
a%20Quality%20Framework%20-%20final-%20Jan08-2015.pdf?version=1&modificationDate=1420725063663&api=v2
UNECE (2014), „Hvor stort er Big Data? At udforske rollen af Big Data i officielle statistikker“,
Daas, P., S. Ossen, R. Vis-Visschers og J. Arends-Toth, (2009), Tjekliste til kvalitetsvurdering af administrative datakilder, Statistisk Danmark, Haag/Heerlen
Dorfman, Mark S. (2007), Introduktion til risikostyring (e. udg.), Cambridge, UK, Woodhead-Faulkner, s. 18, ISBN 0-85941-332-22)
Eurostat (2014), „Akkrediteringsprocedure for statistiske data fra ikke-officielle kilder“ i Analyse af metodologier til brug af internettet til indsamling af information og andre statistikker,
Reimsbach-Kounatze, C. (2015), “Proliferationen af „Big Data“ og konsekvenser for officielle statistikker og statistiske agenturer: En indledende analyse”, OECD Digital Economy Papers, nr. 245, OECD Publishing.
Reis, F., Ferreira, P., Perduca, V. (2014) „Brugen af webaktivitetsbeviser til at øge aktualiteten af officielle statistiske indikatorer“, præsentation ved IAOS 2014 konference,
Selv hvis der ikke specifikt nævnes risici, nærmer dette dokument sig faktisk de mange risici forbundet med brugen af webaktivitetsdata til officielle statistikker. Eurostat (2007), Håndbog om metoder og værktøjer til vurdering af datakvalitet,
Kilde: habr.com
